香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


一台美国服务器上运行多个数据库实例时,CPU 与内存争用往往不是因为“实例数量太多”,而是因为各实例的峰值同时出现,却共用一套未划清边界的主机资源。要先判断业务是否真的需要多个独立实例,再为需要独立运行的实例分别确定连接入口、内存预算和 CPU 调度边界;如果这些边界仍无法满足高峰需求,就应把负载拆到不同服务器,而不是继续提高单机限制。
隔离也不等于给每个进程设置相同的上限。在线交易库可能需要稳定的响应时间,报表库则可能在短时间内消耗大量 CPU 和查询内存。合理部署应让前者在后者运行时仍有资源可用,同时保留操作系统、备份和维护任务所需的余量。美国机房的位置影响应用到数据库的访问链路,却不会改变同机实例争用 CPU、内存和磁盘的基本机制。
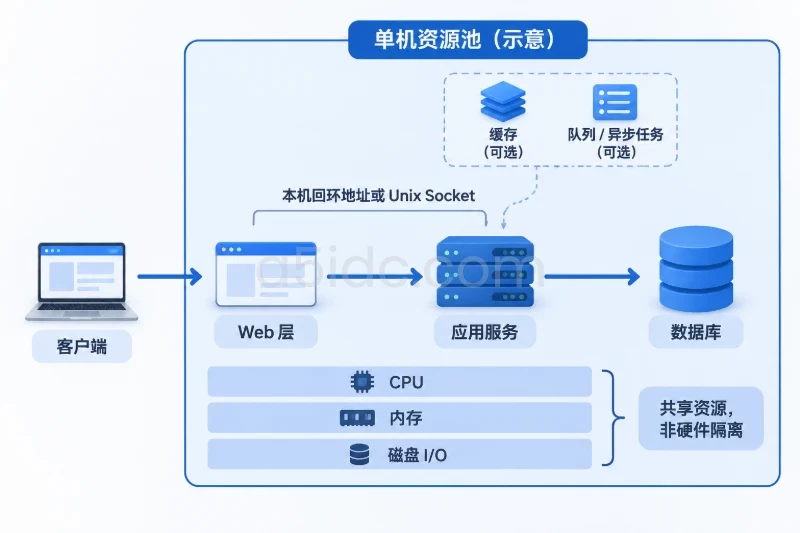
典型请求从 Web 入口进入应用服务,应用通过连接池访问数据库,数据库再使用自身缓存、工作内存和磁盘完成查询。一次页面变慢,表面上发生在 Web 层,实际可能是报表实例占用了 CPU,使交易实例的查询排队;也可能是两个实例都扩大缓存,主机开始回收内存或使用交换空间。
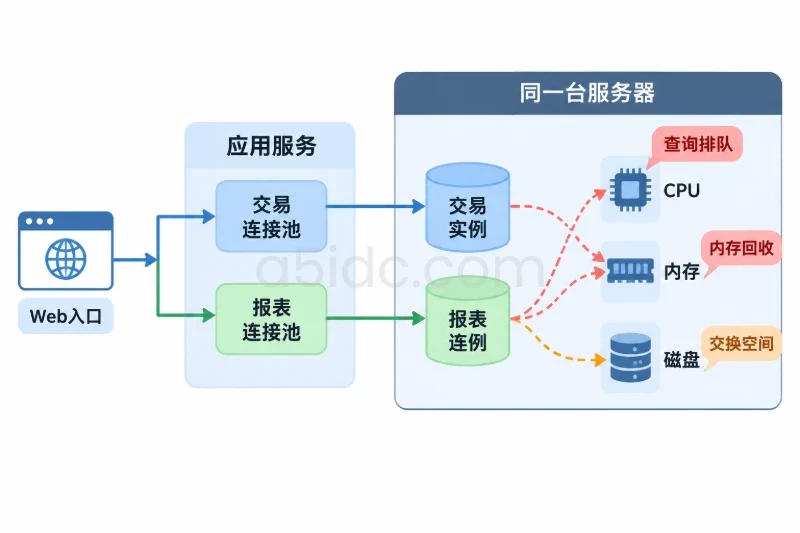
先把每个实例对应到业务链路,而不是按数据库名称平均分配资源。需要厘清三个问题:哪些请求必须同步读写数据库,哪些任务可以延后执行,哪些查询会在固定时段集中出现。例如,订单写入需要在请求链路内完成;日报生成如果允许延迟,则可以交由后台任务处理。后者错峰运行,通常比单纯限制其 CPU 更能减少对在线交易的影响。
还要区分“多个数据库”和“多个数据库实例”。同一数据库进程内建立多个数据库或模式,便于管理对象和权限,但仍共享进程级缓存、连接容量及部分后台工作。独立进程或容器才便于按实例设置主机资源边界;即便如此,它们仍共享同一台机器的磁盘、内核和故障域。逻辑隔离、资源隔离与故障隔离是三个不同目标,不能用其中一种代替另外两种。
Web 层负责接入请求和返回结果,应用层负责业务逻辑、连接池及请求并发控制。对数据库隔离而言,应用层有一项关键职责:把不同业务的连接导向正确实例,并限制每类请求能够同时发起多少查询。如果应用允许报表请求无限并发,数据库即使设置了 CPU 上限,报表也可能因排队而变慢,交易请求仍可能受到共享磁盘压力影响。
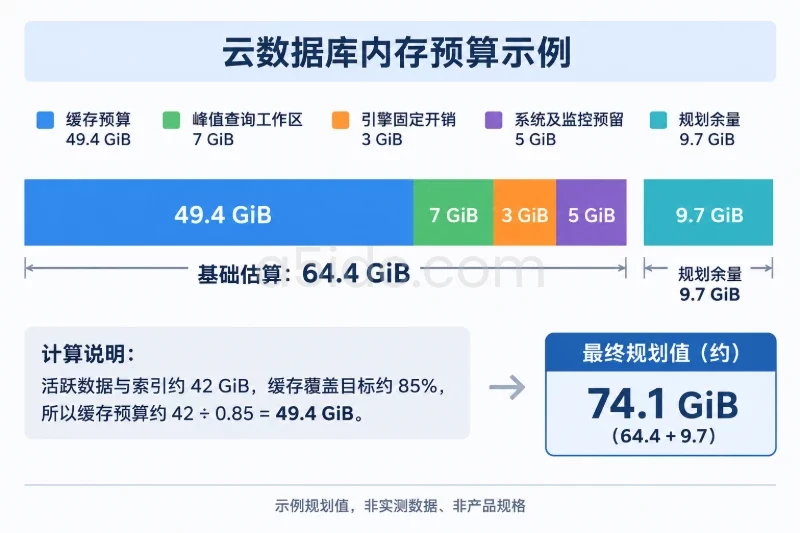
数据库实例承担数据读写、事务、索引访问和自身的后台任务。内存不能只按“缓存大小”计算:MySQL 的 InnoDB 缓冲池之外还有其他内存用途;PostgreSQL 的 work_mem 则是查询操作的内存基数,一条复杂查询及多个并发会话可能同时使用多份。容量规划必须同时考虑固定占用和并发波动,不能把主机内存全部分给各实例的缓存。
缓存组件只在存在可复用读取、且业务能接受相应的一致性处理时才值得独立部署。它可以减少数据库读请求,但自身也要占用内存;把缓存与多个数据库实例放在同一台内存紧张的服务器上,可能只是转移争用。队列适合承接可异步执行的报表、通知或批处理,不应把必须立即确认的事务写入简单改为异步。没有这类需求,就不必为了“架构完整”增加组件。
资源边界应从应用入口延伸到数据库进程。假如交易与报表分别使用独立实例,应用需要使用不同连接池,并分别设定并发上限;数据库侧再为各实例分配内存预算和 CPU 调度策略。只在数据库侧限制资源、不约束上游并发,会把过量请求变成更长的队列,不能保证响应时间。
以一台 16 vCPU、64 GiB 内存的服务器为例,可以先用峰值预算检验同机部署是否可行:交易实例最多规划 30 GiB,报表实例最多 16 GiB,系统及必要服务预留 8 GiB,再留 10 GiB 用于缓存波动和维护期间的余量,合计 64 GiB。CPU 方面,可先评估交易实例最多使用约 8 vCPU、报表实例最多使用约 4 vCPU,其余调度能力不预先分满。这里的数字是容量推演起点,不是应照搬的配置;应以业务高峰时的实际占用和延迟修正。
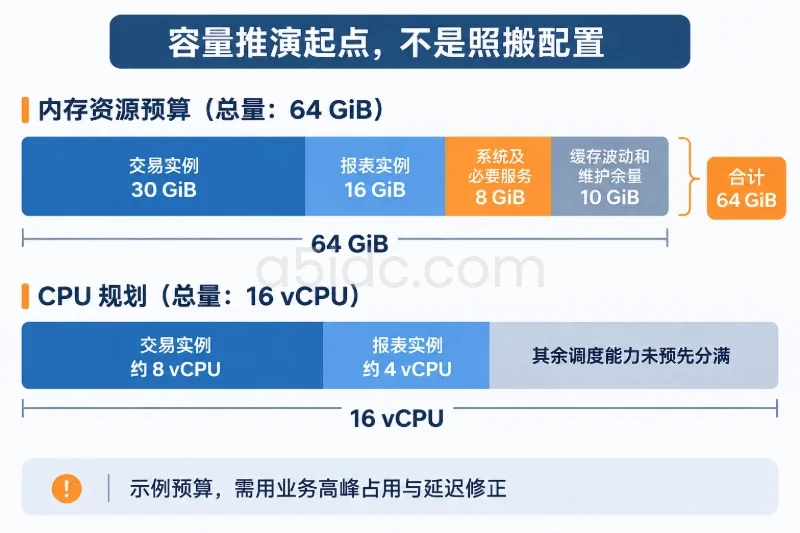
其中“30 GiB”也不能直接等同于数据库缓存设置。若某 PostgreSQL 实例允许 20 个活跃会话,每个会话中的查询同时执行两个可使用 16 MiB work_mem 的操作,仅这部分就可能达到 20 × 2 × 16 MiB=640 MiB,尚未计入共享缓存、其他进程内存及哈希操作的额外需求。连接池大小、查询形态和实例上限必须一起检查。
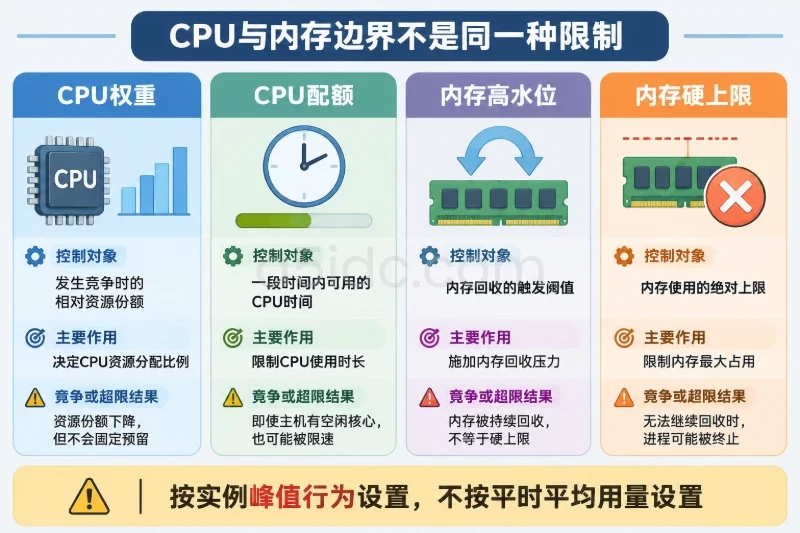
在 Linux 上,可通过独立的服务资源组或容器,为每个实例设置 CPU 权重、配额和内存边界,但这些参数含义不同。CPU 权重主要决定发生竞争时的相对份额,不是固定预留;CPU 配额限制一段时间内可用的 CPU 时间,设得过低会使实例在主机尚有空闲核心时仍被限速。内存高水位侧重施加回收压力,硬上限则可能在无法继续回收时导致该资源组内进程被终止。应结合实例的峰值行为选用,而不是把上限设为平时平均用量。
A5idc数据提供美国物理服务器,涵盖常规 Xeon、AMD EPYC 等平台,可为多个数据库实例的部署提供不同层次的 CPU、内存与 NVMe 存储资源。部分 AMD 方案配有 64GB DDR5 内存和 960GB NVMe,另有更高内存及双盘配置,可用于承载数据库缓存、查询处理与业务数据。美国服务器还提供 CN2 GIA 线路方案,适用于面向美国用户的数据库及业务服务部署。
| 部署结构 | 适用条件 | 能隔离什么 | 仍需接受什么 |
|---|---|---|---|
| 单实例内划分数据库或模式 | 负载接近、维护窗口一致,主要需要对象和权限区分 | 数据组织与访问权限 | 进程级 CPU、内存和故障仍高度共享 |
| 单机运行独立实例 | 业务需要独立配置或维护,高峰错开,主机仍有余量 | 可分别控制进程资源、连接及实例配置 | 磁盘、主机故障和部分系统资源仍共享 |
| 数据库实例分布在不同服务器 | 峰值持续重叠,或一个业务不能承受另一个业务的维护与争用 | 主机级 CPU、内存及故障域 | 增加服务器成本和跨机访问、备份管理工作 |
| 主从或多节点部署 | 还需要读扩展或故障接管能力 | 可将特定读负载移至其他节点,并降低单机故障影响 | 需要处理复制延迟、切换和容量规划;并非自动消除写入瓶颈 |
这张表的选择顺序是:先判断是否需要独立实例,再判断是否需要独立主机,最后判断是否需要多节点能力。交易库和报表库偶尔发生短时冲突、总峰值仍在单机预算内时,可以先保留同机独立实例,限制报表并发并错开批任务。若报表长期占用高 CPU、两个实例都需要较大的常驻内存,或者维护其中一个业务不能影响另一个业务,分机通常比不断收紧限额更合适。
分机前还要看数据访问方式。如果应用在一次请求中频繁跨两个实例取数,拆到不同服务器会增加网络往返及调用复杂度。美国服务器上的应用和数据库若面向同一主要业务,应优先核对两者之间的网络延迟与链路稳定性;不要仅因“用户在美国”就默认可以把应用与数据库任意分散。若业务依赖跨实例事务或大量关联查询,也应先处理数据边界和调用方式,再决定物理拆分。
多节点主要回答可用性与读负载问题,不是给单个实例设置 CPU 上限的替代方案。只读节点可以承接允许一定数据延迟的查询;异步复制可能使读取结果滞后,故障切换也需要单独设计和演练。把两个节点放在同一台物理服务器上,同样不能解决整机故障。
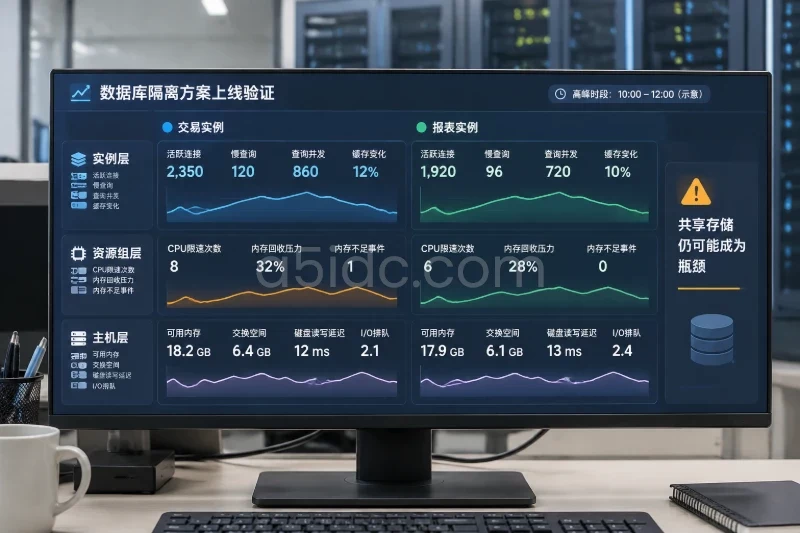
隔离方案需要在两个实例同时达到代表性高峰时验证,而不是分别测试后把结果相加。重点比较交易请求的响应时间、数据库查询等待时间,以及报表任务完成时间:如果交易延迟稳定、报表只是可接受地延长,边界可能有效;如果两者一起变慢,就要继续检查共享资源。
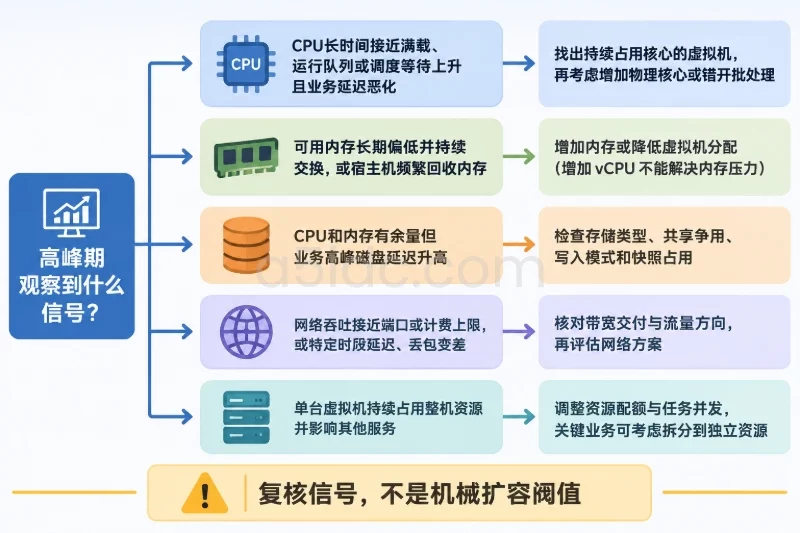
监控应同时覆盖实例与主机两个层面。实例侧看活跃连接、慢查询、查询并发和缓存变化;资源组侧看 CPU 限速次数、内存回收压力及内存不足事件;主机侧看可用内存、交换空间、磁盘读写延迟和 I/O 排队。即使 CPU 与内存各自有边界,共用存储仍可能让一个实例的大量扫描或备份拖慢另一个实例。仅把数据目录放在不同路径、底层仍是同一块存储,并不构成磁盘性能隔离。
调整限制前,应确认当前配置可恢复、备份可用,并明确变更作用于哪个实例。尤其不要把正在运行的数据库实例直接压到低于其正常峰值的内存硬上限;若出现频繁回收、实例终止或延迟恶化,应按预先记录的配置恢复,并重新评估容量,而不是继续提高上游并发。
因此,下一步最有价值的工作不是先选一组固定的 CPU 和内存参数,而是记录各实例在同一业务高峰中的峰值占用、延迟和磁盘等待。如果同机总预算有余量,就用独立实例加明确的并发与资源边界验证;如果峰值长期重叠、共享磁盘成为瓶颈,或故障与维护必须相互独立,就应转向分机部署,并按实际需要另外评估多节点。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8727.html