香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


很多人看到 Pod 配置中的 resources.limits,就认为它等同于 Kubernetes 资源配额,进而把“单个容器不能超过多少”和“整个命名空间最多使用多少”混为一谈。实际上,前者通常由 LimitRange 约束,后者由 ResourceQuota 约束,两者都可能检查 CPU、内存,却处在不同的范围。
ResourceQuota 限制的是命名空间内一组对象的累计资源或对象数量;LimitRange 限制的是单个容器、Pod 或 PVC 的资源边界,并且可以为缺少资源声明的容器补默认值。一个 Pod 能否创建,需要同时满足这两类规则,之后还要通过调度器的节点容量检查和运行时的资源控制。
ResourceQuota 是命名空间级别的资源配额对象。它可以限制:
StorageClass 的存储申请;例如,命名空间设置:
requests.cpu: "4"
limits.cpu: "8"
含义不是“每个 Pod 最多使用 4 核”或“每个容器最多使用 8 核”,而是该命名空间内所有相关 Pod 的 CPU 请求总和不能超过 4 核,CPU 限制总和不能超过 8 核。
如果现有对象已经占用:
requests.cpu: 3500m
limits.cpu: 7000m
那么新 Pod 即使只申请 requests.cpu: 600m,也会因为请求总量达到 4100m 而被拒绝。此时节点上可能仍有空闲 CPU,但命名空间配额已经不足。
常见的资源配额字段包括:
| 字段 | 约束对象 | 典型含义 |
|---|---|---|
requests.cpu | Pod 的 CPU 请求总和 | 用于调度和配额统计 |
requests.memory | Pod 的内存请求总和 | 用于调度和配额统计 |
limits.cpu | Pod 的 CPU 限制总和 | 用于限制声明和配额统计 |
limits.memory | Pod 的内存限制总和 | 用于限制声明和配额统计 |
pods | Pod 对象数量 | 限制命名空间中的 Pod 数量 |
persistentvolumeclaims | PVC 数量 | 限制 PVC 对象个数 |
requests.storage | PVC 存储申请总量 | 限制 PVC 的容量申请总和 |
count/deployments.apps | Deployment 对象数量 | 限制 Deployment 个数 |
在常见 Kubernetes 资源配额写法中,直接使用 cpu 或 memory 时,通常按对应的 limits.cpu 或 limits.memory 处理。为了避免阅读歧义,生产配置更适合显式写出 requests.<em> 和 limits.</em>。
LimitRange 同样作用于命名空间,但它关注的是单个资源对象的边界,常见用途包括:
requests;limits;limits 与 requests 之间的比例;例如,下面的规则表示单个容器至少请求 100m CPU 和 256Mi 内存,最多设置为 2 个 CPU 和 4Gi 内存:
apiVersion: v1
kind: LimitRange
meta
  name: container-defaults
  namespace: team-a
spec:
  limits:
    - type: Container
      min:
        cpu: 100m
        memory: 128Mi
      max:
        cpu: "2"
        memory: 4Gi
      default:
        cpu: 400m
        memory: 512Mi
      defaultRequest:
        cpu: 100m
        memory: 256Mi
      maxLimitRequestRatio:
        cpu: "4"
        memory: "2"
这份配置的效果可以拆成四类:
requests 时,使用 defaultRequest;limits 时,使用 default;min、高于 max 时,创建或更新被拒绝;limit/request 不能超过 4,内存的 limit/request 不能超过 2。如果一个容器设置:
requests:
  cpu: 100m
limits:
  cpu: "2500m"
它会超过单容器 CPU 上限 2 核,即使命名空间的 ResourceQuota 还有大量剩余,也无法通过 LimitRange 校验。
| 对比项 | ResourceQuota | LimitRange |
|---|---|---|
| 作用范围 | 命名空间内多个对象的累计值 | 单个容器、Pod 或 PVC |
| 主要目的 | 控制团队或租户的总资源预算 | 统一单体资源边界和默认值 |
| 是否补默认值 | 否 | 是,可以补 requests 和 limits |
| 是否统计总量 | 是 | 否 |
| 是否限制单个容器最大值 | 通常不直接限制 | 是 |
| 是否限制对象数量 | 是 | 通常不负责 |
| 是否依赖实际监控用量 | 计算资源配额通常不依赖 | 不依赖 |
| 是否影响调度 | 通过请求量限制对象创建,间接影响 | 通过资源声明影响最终 Pod 配置 |
| 是否会主动驱逐已有 Pod | 通常不会 | 不会 |
因此,可以用一句话判断:
想限制“整个命名空间加起来有多少”,看ResourceQuota;想限制“一个容器或 Pod 能声明多少,以及没写时采用什么值”,看LimitRange。
CPU 和内存配额主要依据 Pod 规格中声明的 requests 和 limits 统计,而不是实时监控中的实际使用量。
以普通 Pod 为例:
命名空间 requests.cpu =
  所有相关 Pod 的 CPU requests 之和

命名空间 limits.memory =
  所有相关 Pod 的内存 limits 之和
一个 Pod 的两个容器分别声明:
resources:
  requests:
    cpu: 200m
    memory: 256Mi
  limits:
    cpu: 500m
    memory: 512Mi
那么这个 Pod 对命名空间配额的常规贡献就是:
requests.cpu: 200m
requests.memory: 256Mi
limits.cpu: 500m
limits.memory: 512Mi
如果容器实际只用了 50m CPU,配额统计通常不会因此减少;如果实际使用接近或达到限制,也不会因为实际用量变化而增加配额使用量。配额关注的是“允许提交多少资源声明”,不是监控系统中的实时曲线。
当 Pod 没有完整填写资源字段时,LimitRange 可以在 API Server 的准入阶段补上默认值。例如,容器没有写任何 resources,但命名空间存在前面的规则,最终保存到 API Server 的 Pod 对象可能包含:
resources:
  requests:
    cpu: 100m
    memory: 256Mi
  limits:
    cpu: 400m
    memory: 512Mi
这些默认值会影响后续几个环节:
ResourceQuota 可能按补全后的请求和限制统计;requests 选择节点;limits 进行 CPU、内存控制;实际集群中还可能存在其他 Mutating Webhook,例如注入监控容器或代理容器。注入后的容器也可能改变 Pod 的总资源声明。因此,不能只看应用团队提交的原始 YAML,还要查看 API Server 最终保存的 Pod 规格。
当新建或更新资源时,ResourceQuota admission controller 会检查操作完成后是否超过配额。例如配额如下:
spec:
  hard:
    requests.cpu: "4"
    requests.memory: 8Gi
    limits.cpu: "8"
    limits.memory: 16Gi
    pods: "20"
已有 Pod 占用:
requests.cpu: 3500m
requests.memory: 6Gi
limits.cpu: 7000m
limits.memory: 12Gi
pods: 8
新 Pod 申请:
requests.cpu: 500m
requests.memory: 1Gi
limits.cpu: 1000m
limits.memory: 2Gi
加入后将变成:
requests.cpu: 4000m
requests.memory: 7Gi
limits.cpu: 8000m
limits.memory: 14Gi
pods: 9
这个请求正好没有超过示例配额,因此从 ResourceQuota 角度可以通过。但这不等于 Pod 一定能运行,还需要满足节点可调度容量、污点容忍、亲和性、镜像拉取和存储挂载等条件。
反过来,如果新 Pod 只申请:
requests.cpu: 600m
则请求总量会达到 4100m,ResourceQuota 会拒绝这次创建。
ResourceQuota 和 LimitRange 不替代节点调度与容器运行时控制。
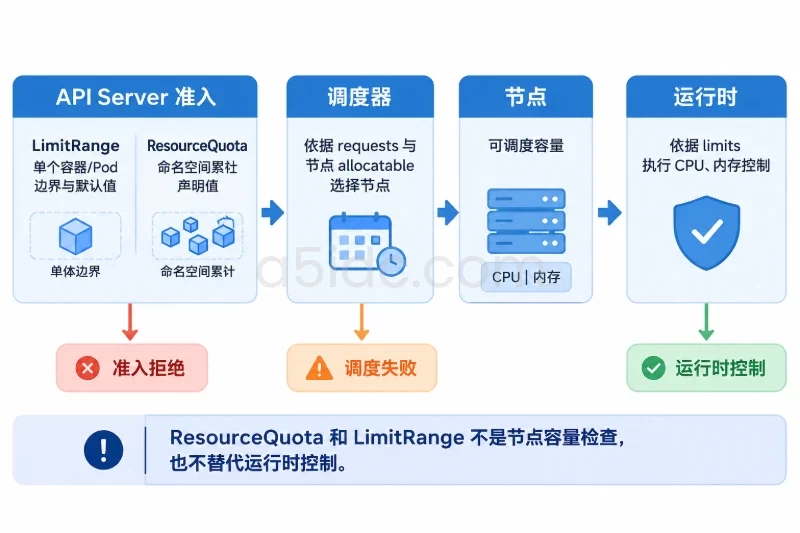
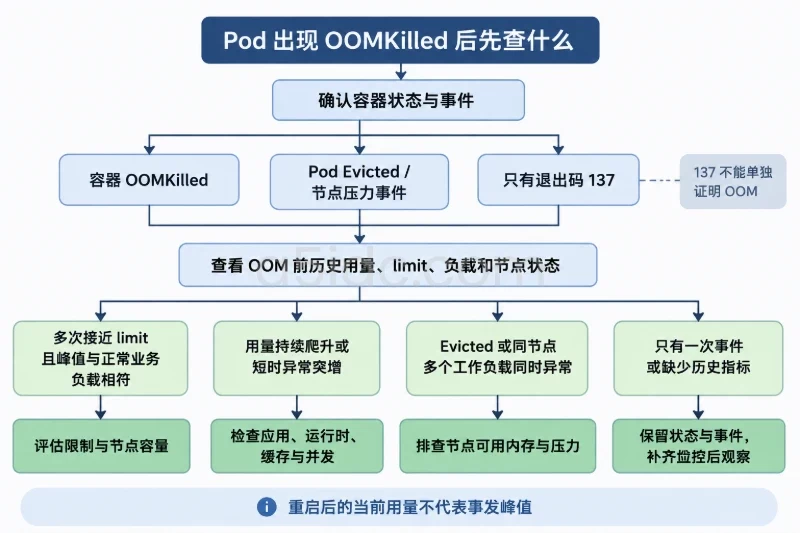
requests 是调度和资源预留的重要依据,通常影响 Pod 能否放入某个节点;limits.cpu 通常形成 CPU 使用上限,超过后可能被限制或节流;limits.memory 是内存上限,容器超过可用内存时可能被终止并出现 OOMKilled;allocatable 容量决定 Pod 是否真的有地方运行;这解释了一个常见现象:命名空间配额还有余量,但 Pod 仍然处于 Pending。此时应继续检查调度事件,而不是只查看 ResourceQuota。
很多配额问题源于只看了一个字段。下面三种配置的含义不同:
resources:
  requests:
    cpu: 500m
  limits:
    cpu: "1"
它会同时消耗 requests.cpu 和 limits.cpu 两类配额。
resources:
  requests:
    cpu: 500m
它只明确声明 CPU 请求,是否能创建还取决于命名空间是否要求 limits.cpu,以及 LimitRange 是否会补上限制值。
resources:
  limits:
    cpu: "1"
如果没有请求值,调度行为和配额统计可能受 LimitRange 默认规则影响。在某些命名空间中,配额要求所有容器必须填写请求或限制,缺少字段会直接收到准入错误。
因此,配置了 requests.cpu 配额时,应确保每个相关容器都有可被识别的 CPU 请求;配置了 limits.memory 配额时,也应确保每个相关容器都有内存限制。使用 LimitRange 提供默认值可以减少遗漏,但不能替代对最终对象的检查。
LimitRange 使用 type: Container 时,通常是逐容器检查。例如单容器最大 CPU 为 2 核,一个包含两个容器、每个容器设置 2 核的 Pod,可能通过容器级别的最大值检查,但整个 Pod 仍会向命名空间配额贡献 4 核 CPU 限制。
这正是两类对象不能互相替代的原因:
LimitRange 可以阻止一个容器过大;ResourceQuota 可以阻止整个命名空间累计过大;Pod 还可能包含初始化容器、临时容器或由 Webhook 注入的容器。初始化容器的资源声明可能影响调度所需资源计算,注入容器则会增加最终 Pod 的资源总量。遇到“YAML里写得不大,配额却被占满”的情况,应检查最终 Pod 对象和控制器生成的 Pod,而不是只看 Deployment 模板。
如果使用了 BestEffort、NotBestEffort 等配额范围,资源默认值就可能改变 Pod 是否属于该范围。
例如,一个没有任何请求和限制的 Pod 可能属于 BestEffort;如果 LimitRange 自动为它补充 CPU 或内存请求,它通常会变成 Burstable。此时该 Pod 可能不再计入只针对 BestEffort 的配额。
使用这类 scope 或 scopeSelector 时,需要同时核对:
requests 和 limits;PriorityClass;同一命名空间存在多个配额对象时,一次创建通常需要同时满足相关配额。除非有明确的分组目的,否则不建议随意设置重叠的配额规则,否则排查时容易出现“单个配额看起来有余量,但创建仍失败”的情况。
配额限制的是实际对象和资源声明,不是工作负载控制器的期望副本数本身。
Deployment 滚动更新时,如果设置了 maxSurge,旧 Pod 尚未删除时可能先创建新 Pod。此时新旧 Pod 会同时占用配额。Job、CronJob 批量启动时,也可能在短时间内创建大量 Pod。
例如:
此时可能看到 Deployment 对象已经创建成功,但 ReplicaSet 创建 Pod 失败。应检查 ReplicaSet、Deployment 事件和 Pod 事件,而不是只检查 Deployment 对象是否存在。
requests.storage 统计 PVC 的容量申请,不等于节点实际使用的磁盘空间,也不等于后端存储系统已经写入的数据量。
例如:
spec:
  hard:
    persistentvolumeclaims: "10"
    requests.storage: 100Gi
它分别限制 PVC 数量和 PVC 申请容量总和。一个 PVC 申请 50Gi,另一个申请 60Gi,即使当前实际只写入少量数据,也可能超过 100Gi 的申请配额。
此外,PVC 是否能成功绑定还受 StorageClass、可用 PV、动态供应器和存储后端容量影响。ResourceQuota 通过后,PVC 仍可能处于 Pending。
下面是一组用于演示的命名空间级配置。示例值仅用于说明计算关系,实际环境应根据节点可分配资源和业务峰值调整。
apiVersion: v1
kind: ResourceQuota
meta
  name: team-a-quota
  namespace: team-a
spec:
  hard:
    pods: "20"
    requests.cpu: "4"
    requests.memory: 8Gi
    limits.cpu: "8"
    limits.memory: 16Gi
    persistentvolumeclaims: "10"
    requests.storage: 100Gi
应用后,可以查看配额的目标值和当前使用值:
kubectl get resourcequota -n team-a
kubectl describe resourcequota team-a-quota -n team-a
describe 输出通常会列出类似以下信息:
Resource            Used     Hard
--------            ----     ----
limits.cpu          2500m    8
limits.memory       6Gi      16Gi
persistentvolumeclaims 2     10
pods                6        20
requests.cpu        1500m    4
requests.memory     3Gi      8Gi
requests.storage    40Gi     100Gi
其中 Used 是配额统计值,不是 kubectl top 展示的实时实际用量。
apiVersion: v1
kind: LimitRange
meta
  name: team-a-container-defaults
  namespace: team-a
spec:
  limits:
    - type: Container
      min:
        cpu: 100m
        memory: 128Mi
      max:
        cpu: "2"
        memory: 4Gi
      default:
        cpu: 400m
        memory: 512Mi
      defaultRequest:
        cpu: 100m
        memory: 256Mi
      maxLimitRequestRatio:
        cpu: "4"
        memory: "2"
查看规则:
kubectl get limitrange -n team-a
kubectl describe limitrange team-a-container-defaults -n team-a
使用明确填写资源的 Pod 进行验证:
apiVersion: v1
kind: Pod
meta
  name: quota-check-pod
  namespace: team-a
spec:
  containers:
    - name: app
      image: nginx:1.27
      resources:
        requests:
          cpu: 200m
          memory: 256Mi
        limits:
          cpu: 800m
          memory: 1Gi
应用后查看最终对象:
kubectl apply -f quota-check-pod.yaml
kubectl get pod quota-check-pod -n team-a -o yaml
kubectl describe pod quota-check-pod -n team-a
检查时重点关注:
spec.containers[*].resources 是否包含预期的请求和限制;Running,还是停留在 Pending;describe 的 Events 中是配额错误、LimitRange 错误,还是调度错误。如果想验证默认值,可以提交一个不写 resources 的测试 Pod,并使用服务端演练模式:
kubectl apply \
  --dry-run=server \
  -f pod-without-resources.yaml \
  -n team-a \
  -o yaml
在支持服务端演练和准入变更的集群中,输出结果可以帮助查看默认值注入后的对象。若结果中仍没有资源字段,说明需要检查命名空间是否存在有效的 LimitRange,以及集群准入配置是否启用了对应插件。
可以准备一个超过单容器上限的测试 Pod:
apiVersion: v1
kind: Pod
meta
  name: limitrange-fail-check
  namespace: team-a
spec:
  containers:
    - name: app
      image: nginx:1.27
      resources:
        requests:
          cpu: 500m
          memory: 256Mi
        limits:
          cpu: "2500m"
          memory: 1Gi
使用服务端演练,不实际创建对象:
kubectl apply \
  --dry-run=server \
  -f limitrange-fail-check.yaml \
  -n team-a
如果只超过了单容器最大 CPU,通常会看到与 LimitRange、最大限制或资源比例有关的错误。
验证 ResourceQuota 时,应先查看当前 Used,再计算新对象加入后的累计值。典型判断公式是:
新累计值 = 当前 Used + 新对象预计占用值
当新累计值大于 Hard 时,常见错误会包含:
exceeded quota
此时应重点核对:
requests.cpu 超限,还是 limits.cpu 超限;如果 Pod 已经成功创建,但无法调度,再检查:
kubectl describe pod <pod-name> -n team-a
kubectl get events -n team-a --sort-by=.lastTimestamp
这一步可以把“配额拒绝”和“节点没有可用容量”区分开。
实际运行量则需要单独查看监控或指标:
kubectl top pod -n team-a
kubectl top node
kubectl top 需要集群中存在可用的指标采集组件,并且它展示的是实际使用量,不会替代 ResourceQuota 的 Used 字段。
ResourceQuota 的边界是命名空间。它不会自动限制其他命名空间,也不会自动把整个集群的 CPU、内存平均分给各个命名空间。多个命名空间的配额总和还可能高于集群实际可调度容量,因此配额通过不代表资源一定可用。
LimitRange 的边界是单个资源对象。它可以阻止一个容器申请过大的资源,也可以统一默认值,但不能阻止同一命名空间创建很多个都符合单体上限的 Pod。需要控制总量时,仍然必须配置 ResourceQuota。
两者通常都属于 API Server 的准入控制范围。仅仅创建了一个 ResourceQuota 或 LimitRange 对象,并不等于所有集群组件都按预期执行了规则。托管 Kubernetes 环境通常已经提供默认配置;自建集群则应由管理员核对准入插件、控制器和 API 版本。可先查看资源结构:
kubectl explain resourcequota.spec.hard
kubectl explain limitrange.spec.limits
kubectl version -o yaml
还需要注意以下边界:
实际排查时,可以按这个顺序判断:
LimitRange 和 ResourceQuota;ResourceQuota.status.used 与 status.hard;只要把“单体边界”“命名空间总量”“节点可调度容量”和“容器运行时限制”分开判断,ResourceQuota 与 LimitRange 的职责就不会再混淆。
面向 Kubernetes 工作负载的底层部署,A5idc数据提供香港、美国、日本等地区的物理服务器租用,涵盖 Xeon Gold、AMD EPYC 等平台,并有不同内存与 SSD、NVMe 存储配置,可为业务后台、数据库及多任务计算提供硬件资源基础。香港和美国还提供 GPU 服务器,适用于 AI 推理等计算场景;多地区产品也可配合不同业务的部署位置与网络需求。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8565.html