香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


看到美国洛杉矶服务器配置中写着“CPU基频 3.0GHz、睿频 4.8GHz”,并不代表处理器会在持续运行时一直保持4.8GHz。睿频通常是特定条件下、少量核心或短时间内可以达到的上限;基频则是处理器在规定功耗和散热条件下运行多核心负载时的设计参考值,也不是CPU始终不会低于的最低频率。
如果业务属于编译、视频转码、批量计算、渲染或持续数据处理等长时间CPU密集型任务,判断重点应放在全核心持续运行时的实际频率、功耗、温度、是否降频,以及实际业务吞吐量。只在参数表中二选一时,基频更适合作为保守参考;真正用于选型的指标,应优先看持续负载下的实测性能,而不是只看睿频数字。
基频通常是处理器规格中的一个标称运行频率。它对应的是特定功耗、散热和平台条件下,处理器执行规定工作负载时的设计基准。
这并不意味着CPU在任何时候都至少运行在基频:
因此,“基频3.0GHz”不能简单理解成“CPU最低就是3.0GHz”。
睿频、Boost或Turbo,通常表示处理器在温度、功耗、电流和任务并行度允许时,可以临时提高工作频率。
睿频是否能达到标称值,通常取决于以下条件:
处理器规格中标注的4.8GHz,很多时候对应的是少数核心、特定温度和短时负载条件。全核心同时运行时,实际频率可能明显低于这个数值。即使某一时刻达到4.8GHz,也不等于经过长时间运行后仍能保持该频率。
GHz只表示时钟频率,不直接等于每秒完成的工作量。不同处理器的架构、每周期可执行指令数量、缓存设计、内存控制器和指令集支持可能不同。
例如,两款处理器都以3.5GHz运行:
所以,频率应当与CPU型号、核心线程数、架构和实际业务基准一起判断。
现代服务器CPU通常不是简单地以固定频率工作,而是根据实时状态调整每个核心的频率和电压。
可以把CPU的运行条件理解为一个有限的功耗预算:
这就是为什么单线程测试经常能看到较高的睿频,而多线程长时间测试得到的平均频率要低一些。
CPU负载启动后,频率变化通常可以分为几个阶段:
因此,几秒钟的监控结果不能代表连续数小时的运行状态。判断持续负载,至少应观察负载稳定后的数据,而不是只看启动瞬间的最高频率。
同一颗CPU在不同核心数量下,可能对应不同的有效频率:
| 负载方式 | 常见表现 | 适合参考的指标 |
|---|---|---|
| 单线程或少数线程 | 可能接近标称睿频 | 单核响应时间、单线程性能 |
| 一半核心持续负载 | 频率通常低于少核睿频 | 实际吞吐量、平均有效频率 |
| 全核心长时间负载 | 更受功耗和散热约束 | 全核心持续频率、功耗、温度 |
| 受内存或I/O限制的任务 | CPU可能没有满负载 | 等待时间、内存带宽、磁盘和网络性能 |
| 虚拟机或云主机负载 | 可能受到宿主机调度影响 | steal time、配额、实际业务性能 |
表中的“常见表现”不是固定规则。不同CPU型号、主板固件、散热器和云平台策略,可能产生不同结果。
“洛杉矶服务器”描述的是机房位置,主要影响网络延迟、访问路径和数据合规等因素,不会因为地理位置本身改变CPU的基频或睿频。
同一型号处理器部署在洛杉矶、纽约或其他地区,理论上的频率机制基本相同。但不同机房和服务商的以下条件可能不同:
因此,不能只根据“洛杉矶”三个字推断持续性能。应进一步确认是独立物理服务器、独享型云主机,还是共享宿主机上的虚拟CPU。
持续负载下的CPU表现,也与处理器、内存和存储等资源配置有关。A5idc数据提供美国物理服务器方案,涵盖常规Xeon与AMD EPYC平台,并有搭配DDR5内存和NVMe存储的配置,可用于美国用户网站、数据库、容器及计算任务。不同方案将CPU资源与网络、存储组合,适配从常规业务到多任务运行等不同负载需求。
在独立物理服务器上,CPU频率主要受硬件散热、固件策略和自身功耗限制影响。只要没有其他任务抢占CPU,测试结果通常更容易重复。
在虚拟化环境中,还要关注宿主机调度:
Linux中可以通过mpstat观察是否存在较高的steal时间。steal表示虚拟机需要CPU时,部分时间被宿主机或其他虚拟机占用。
即使两台洛杉矶服务器使用相同CPU型号,以下设置也可能造成不同的持续频率:
需要注意,TDP通常是散热和设计参考值,不等于CPU在所有任务中的实际功耗,也不一定等于平台允许的长期功耗上限。判断持续负载时,应同时看CPU封装功耗、温度和是否出现热限制、功耗限制。
如果业务可以构造出接近生产环境的测试任务,实际吞吐量通常比频率更有参考价值。例如:
频率只是性能形成过程中的一个因素。最终需要确认的是,同样的任务在长时间运行后能否保持稳定速度。
如果暂时没有业务基准测试,至少应观察全核心负载稳定后的实际频率。
这里要区分三个概念:
对持续CPU密集型业务,第三项通常比前两项更有价值。比如一颗CPU标注基频3.0GHz、最高睿频4.8GHz,经过10分钟全核心负载后,如果实际频率稳定在3.4GHz左右且没有持续降频,这个3.4GHz附近的状态比4.8GHz更接近长期运行能力。
只观察频率仍然不够。需要同时判断该频率是否处于健康稳定状态:
一个持续运行在3.5GHz、温度稳定、吞吐量稳定的服务器,通常比一开始达到4.5GHz、随后不断降到2.8GHz的服务器更适合长时间CPU负载。
| 业务类型 | 主要关注指标 | 基频与睿频的使用方式 |
|---|---|---|
| API、网站、控制面板 | 单请求延迟、少量并发下的响应速度 | 更关注单核睿频和低延迟,不应忽略突发后的稳定性 |
| 编译、批处理、转码 | 长时间多线程吞吐量 | 关注全核心持续频率、核心数、功耗和散热 |
| 渲染、科学计算 | 固定任务完成时间 | 以长时间基准测试结果为主,频率作为辅助解释 |
| 数据库 | 查询延迟、锁等待、内存和磁盘性能 | 不能只看CPU频率,应同时检查内存、存储和并发模型 |
| 虚拟机承载 | vCPU性能、调度等待、宿主机资源 | 关注steal time、CPU配额和持续吞吐量 |
| 文件压缩或加密 | 指令集支持、核心数、持续频率 | 需要使用接近实际算法的数据集进行测试 |
先确认服务器实际分配到的CPU型号、核心数和线程数,不要只依据销售页面的概略描述。
lscpu
重点记录以下信息:
如果是云服务器,还应向服务商确认vCPU是否独享、是否存在CPU配额,以及套餐说明中的频率是基频、最高睿频还是平台宣传值。
可以先查看系统当前的CPU调频驱动和频率策略:
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_driver
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_governor
再使用系统监控观察CPU利用率和虚拟化等待:
mpstat -P ALL 1 10
输出中的常见字段包括:
%usr:用户态消耗;%sys:内核态消耗;%iowait:等待I/O的时间;%idle:空闲时间;%steal:虚拟机被宿主机抢占的时间。如果CPU利用率不高,但%steal持续偏高,问题可能是虚拟化调度,而不是CPU基频或睿频不足。如果%iowait较高,则业务可能主要在等待磁盘或网络,单纯提高CPU频率未必有效。
测试应至少分为两段:
可以使用已经安装的压力测试工具进行示例测试:
stress-ng --cpu 8 --timeout 10m --metrics-brief
这里的8只是示例,应根据实际测试目标调整线程数。测试前要确认服务器处于维护窗口,避免影响线上业务;如果是共享云主机,还应确认服务商允许进行高负载测试。该命令会持续占用CPU,不能直接在生产高峰期运行。
对CPU密集型业务,更推荐使用接近真实任务的基准。例如编译同一份代码、处理同一组视频、运行同一批计算数据,并记录:
在Linux环境中,可以使用系统已安装的硬件监控工具观察频率和功耗。以支持该工具的环境为例:
sudo turbostat --interval 1
不同处理器和系统版本显示的字段可能不同,常见字段包括:
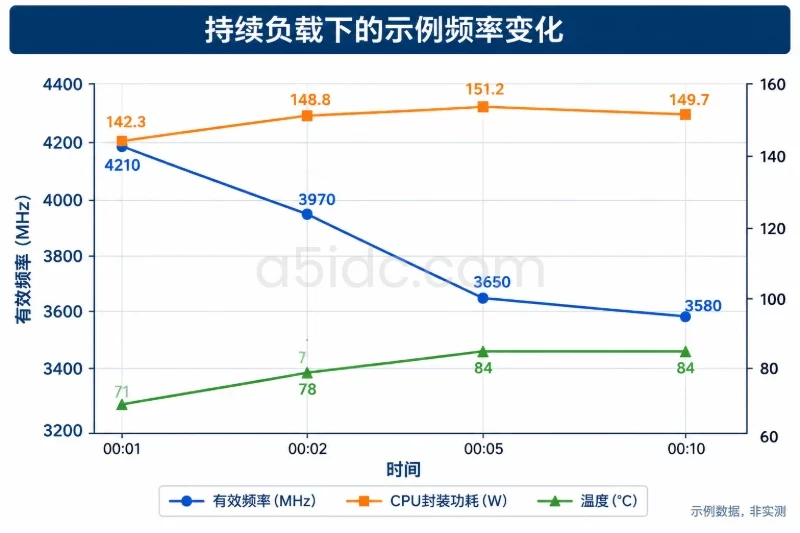
Busy%:处理器处于忙碌状态的比例;Bzy_MHz:忙碌期间的有效频率;TSC_MHz:参考时钟相关频率;PkgWatt:CPU封装功耗;Bzy_MHz与温度、功耗的变化关系。下面是一组用于说明判断方法的示例输出,并非某台洛杉矶服务器的实测结果:
Time    Busy%   Bzy_MHz   PkgWatt   Temp
00:01   98.7    4210      142.3     71
00:02   99.1    3970      148.8     78
00:05   99.0    3650      151.2     84
00:10   98.9    3580      149.7     84
这组数据说明,负载刚开始时有效频率约为4.21GHz,随后随着温度和功耗上升,稳定在约3.58GHz。若吞吐量在3.58GHz阶段保持稳定,则3.58GHz附近才是该条件下更有意义的持续参考值,而不是启动阶段的4.21GHz。
如果没有硬件级工具,也可以读取系统提供的频率信息,但需要谨慎解释:
watch -n 1 "grep -m1 'cpu MHz' /proc/cpuinfo"
/proc/cpuinfo中的频率可能是采样值、估算值或虚拟化层提供的值,不一定代表所有核心的实际有效频率。它适合快速观察趋势,不适合作为精确验收依据。
可以把测试过程分为开始、稳定运行和结束三个阶段,比较以下数据:
| 观察项目 | 开始阶段 | 稳定阶段 | 判断意义 |
|---|---|---|---|
| 有效频率 | 可能较高 | 通常回落 | 回落后是否保持稳定 |
| CPU温度 | 较低 | 逐步升高 | 是否接近热限制 |
| CPU功耗 | 快速上升 | 进入平台范围 | 是否长期触碰功耗限制 |
| 业务吞吐量 | 较高或波动 | 趋于稳定 | 能否保持长期处理速度 |
| steal time | 视平台而定 | 持续观察 | 是否存在宿主机调度影响 |
如果稳定阶段的频率和吞吐量没有继续下降,说明系统进入了相对可预期的工作状态。如果频率每隔一段时间继续下降,或者温度、功耗限制反复触发,应优先检查散热、功耗策略和虚拟化资源,而不是简单认为睿频参数不真实。
对于网站接口、后台任务或交互式应用,很多请求并不会持续占满全部核心。此时少数核心的高频运行可能改善响应时间,基频无法完整反映短时和单线程体验。
但这类场景也不能只看最高睿频。如果并发上升后CPU长时间满载,仍然需要检查全核心稳定性能和调度等待。
如果服务器主要运行转码、渲染、批量压缩或长时间计算,最高睿频往往只是启动阶段或少数核心条件下的表现。此时应把最高睿频当作“短时能力上限”参考,不能当作长期交付能力。
当服务商只提供“最高4.8GHz”而不提供CPU型号、核心数、功耗策略或持续测试条件时,无法据此推导出全核心持续频率。可以要求补充以下信息:
如果测试中CPU使用率只有40%,但磁盘延迟高、网络等待明显或内存频繁换页,那么提高CPU频率通常不会带来等比例收益。
同样,数据库查询可能受索引、锁、缓存命中率和存储延迟影响;虚拟化业务可能受NUMA布局和宿主机调度影响。此时应先确定瓶颈类型,再决定是否需要更高基频、更多核心或更强的存储和内存配置。
对需要长期运行的CPU密集型任务,可以按照以下顺序判断:
因此,针对美国洛杉矶服务器的持续负载,不要把基频或睿频单独当成最终答案。基频可以作为没有测试数据时的保守参考,睿频可以帮助判断短时单核或少核性能,而真正应优先确认的是全核心稳定运行状态和实际业务吞吐量。只有当测试条件、CPU资源和业务负载都对应时,频率参数才具有可比性。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8475.html