香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


判断马来西亚服务器上的 Linux 进程是否异常,不能只看 ps 或 top 的一列:先用 ps 确认进程当前状态、父子关系和资源占用,再用 top 观察 CPU、内存和状态是否在连续采样中变化。单次看到进程处于 R、D 或 Z,不一定代表故障;应结合状态持续时间、资源趋势、进程用途以及系统整体负载判断。
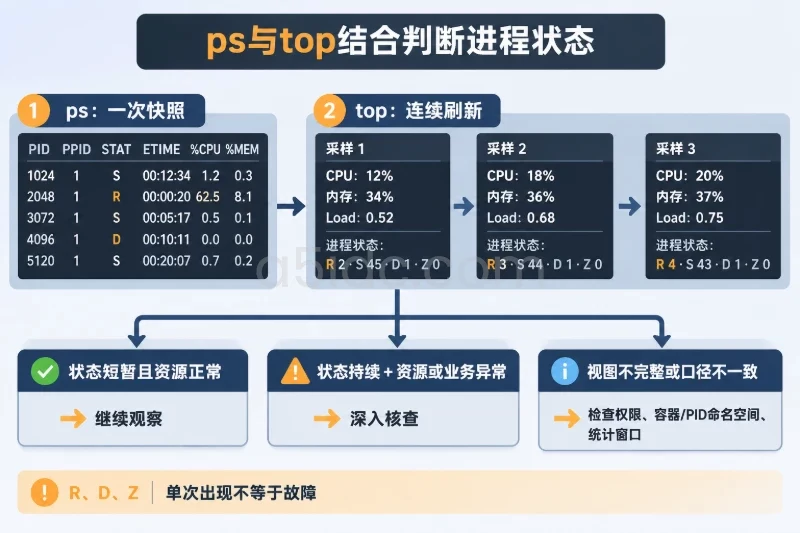
适合快速核对的组合是:用 ps 查看全量进程的状态和关键字段,用 top 观察动态变化。若进程持续处于 D 且对应任务无进展,重点核查存储或其他不可中断等待;若进程长期占用 CPU,观察其 CPU 使用率是否持续偏高以及是否影响业务;若出现 Z,检查父进程是否回收了子进程。马来西亚服务器不会改变这些 Linux 状态码的含义,但时区、容器环境和进程权限会影响排查时的上下文。
Linux 进程状态描述的是进程在采样时刻所处的运行或等待状态,不是对进程健康程度的直接评级。常见状态包括:
| 状态 | 含义 | 初步判断 |
|---|---|---|
R | 正在运行,或等待 CPU 调度 | 短暂出现很常见;持续高 CPU 时再核对业务影响 |
S | 可中断睡眠,等待事件或资源 | 大量进程处于 S 通常是正常现象 |
D | 不可中断睡眠,常见于等待 I/O | 持续不变且任务无进展时,需要进一步检查等待原因 |
T | 已停止,通常由信号或作业控制暂停 | 确认是否为人工暂停或调试操作 |
t | 正在被跟踪或调试 | 常见于调试场景,需结合调试器操作判断 |
Z | 僵尸进程,子进程已结束但尚未被父进程回收 | 进程本身不再执行,重点检查父进程和数量变化 |
I | 空闲内核线程状态 | 常见于内核线程,不应仅凭此状态判断异常 |
ps 的 STAT 还可能带有附加字符,例如 R<、Ss 或 Sl。第一个字符表示主要状态;后续字符提供优先级、会话、线程等附加信息。不要把附加字符误读成另一种主要状态。
top 的 S 列通常显示进程状态;不同 procps-ng 版本和视图设置可能略有差异,遇到字段含义不清时,可以用 top 的帮助信息确认。状态只能说明采样当时进程在做什么,必须配合 CPU、内存、运行时间、等待情况及重复采样判断它是否持续异常。
以下命令适用于常见 Linux 发行版中提供 ps、top 的 procps 或 procps-ng 环境。命令只读取进程信息,不会终止进程或修改系统配置。若系统使用精简容器镜像、裁剪过的工具集或不同实现,选项支持可能不同,可先运行 ps --version、top -v 查看版本。
先查看进程列表:
ps -eo pid,ppid,user,stat,etime,%cpu,%mem,rss,vsz,comm --sort=-%cpu | head -n 20
这里按 ps 报告的 CPU 使用率排序,展示前 20 个进程。常用字段含义如下:
PID、PPID:进程号和父进程号,可用于追踪进程关系。USER:进程所属用户;权限不足时,某些进程信息可能不可见。STAT:当前状态及附加标记。ETIME:进程已运行的时间。%CPU、%MEM:CPU 和内存使用率。不同工具的计算与显示口径不同,不能只靠两个数字直接横向比较。RSS:常驻物理内存,通常以 KiB 显示;VSZ:虚拟地址空间大小,也通常以 KiB 显示。COMM:进程名称,不一定包含完整命令行参数。再打开动态视图:
top
在 top 中,先关注进程的 PID、USER、S、%CPU、%MEM、TIME+、COMMAND 等列,同时查看屏幕顶部的 CPU、内存和 load average 汇总。默认情况下,top 会周期刷新;观察几轮刷新比截取单帧更有价值。按 q 退出即可。
如果需要固定采样次数并保存文本,可使用批处理模式:
top -b -d 2 -n 5
这会以约 2 秒间隔采集 5 次。输出可能较长,实际使用时可在终端中筛选或重定向到受控位置;不要把含有敏感进程参数的信息随意公开。top 与 ps 都可能展示进程命令行或用户名,公开日志前应检查是否包含凭据、令牌或业务信息。
马来西亚服务器上还应确认排查对象所在的环境:如果服务运行在容器、虚拟化环境或独立的 PID 命名空间中,宿主机与容器内看到的 PID、进程数量和资源视图可能不同。应在与业务进程相同的命名空间内核对,并明确是查看宿主机还是容器视角。
围绕马来西亚业务部署,A5idc数据提供吉隆坡物理服务器方案,涵盖不同CPU、存储配置及优化或国际线路,可为网站、业务后台和数据库等Linux服务提供运行资源。服务器的计算、内存与存储资源共同影响进程负载表现,也为结合 ps 和 top 观察业务进程状态与资源变化提供部署基础。
R:区分正常调度与持续 CPU 压力R 表示进程正在运行,或已经具备运行条件并等待 CPU 调度。短时间内看到 R 是正常的,例如处理请求、运行批处理任务或执行短暂的后台任务。真正需要关注的是该进程是否在多次采样中持续占用较多 CPU,以及系统是否因此出现业务延迟或其他进程排队。
ps 中的 %CPU 通常反映进程在其生命周期内的 CPU 使用情况,不能简单当成最近一两秒的即时值;top 更适合观察相邻刷新间隔内的变化。两者数值短时间不一致并不必然表示工具异常,可能是统计窗口不同,也可能是进程刚启动、采样间隔不同或进程结束造成的。
可以针对某个 PID 查看详细信息:
ps -p 2480 -o pid,ppid,user,stat,etime,%cpu,%mem,rss,vsz,comm
示例中的 2480 是占位 PID,需替换为实际进程号。若该进程在连续采样中保持较高 CPU 使用率,同时服务响应变慢,应继续确认它是否属于预期任务,并查看同一时间段的系统 CPU 汇总、业务指标和应用日志。单个进程 R 或 CPU 数值偏高,不足以证明服务器整体 CPU 已饱和;还要考虑 CPU 核数、其他进程负载以及 top 中的 idle、iowait 等统计。
top 的进程 CPU 百分比还可能受显示模式影响。常见 procps-ng 的 Irix 模式下,多线程进程可能累计显示超过 100%;切换到 Solaris 模式后,数值会按 CPU 核数折算。若要比较不同服务器或不同视图中的数字,先确认显示模式与 CPU 核数,不要把超过 100% 直接判为异常。
D:关注持续时间和等待进展D 是不可中断睡眠状态,表示进程正在等待某类内核操作完成。存储 I/O 是常见原因之一,但不能仅凭 D 就断定磁盘故障;网络文件系统、设备驱动或其他内核等待也可能造成类似现象。进程短暂进入 D 后恢复,可能只是正常等待。若同一进程长时间维持 D,相关任务没有进展,或多个业务进程同时进入该状态,才更值得深入调查。
判断时可将 STAT、ETIME、进程数量变化与系统 I/O 指标、应用日志结合起来。ETIME 是进程运行时长,不等于它处于 D 状态的时长;要确认状态是否持续,应重复采样。ps 和 top 主要告诉你“看到了什么”,并不直接给出进程等待的内核原因。若需要进一步定位,可在有权限且符合运维规范的前提下使用系统已有的 I/O 监控工具;不要为了确认原因直接重启服务或杀死进程,因为处于 D 的任务未必能立即响应信号,强制处理还可能影响业务或数据一致性。
Z:检查父进程及数量趋势Z 表示进程已经退出,但父进程尚未读取其退出状态并回收相应记录。僵尸进程通常不再执行,也不会像正常运行进程那样持续消耗 CPU;它仍占用进程表中的一个记录。少量、短暂的 Z 可能会很快消失。若同一服务不断产生僵尸进程,且数量持续增加,则应检查其父进程的子进程管理逻辑或父进程是否卡住。
先查询僵尸进程及父进程号:
ps -eo pid,ppid,stat,etime,comm | awk '$3 ~ /^Z/ {print}'
再按实际父进程号查看父进程:
ps -p 2400 -o pid,ppid,user,stat,etime,comm
这里的 2400 同样只是示例。处理重点通常是调查并修复父进程的回收逻辑,而不是把僵尸进程本身当作仍在运行的任务去终止。父进程号显示为 1 时,是否由容器内 PID 1 或宿主机 init 接管,要结合命名空间确认。
S、T 与 I:不要把等待或暂停直接当故障S 是可中断睡眠,服务进程等待请求、定时器或事件时经常处于此状态。大量 S 进程本身不说明资源耗尽;应查看它们是否为预期服务、是否能正常响应请求,以及系统是否出现其他资源瓶颈。
T 通常表示进程被暂停或停止。若进程是由调试、作业控制或管理操作暂停,可能属于预期状态;若业务进程意外长期处于 T,应通过父子关系、启动方式和运维记录核实原因。I 常见于空闲内核线程,通常不应按普通业务进程的判断标准解读。
%MEM 与 RSS 反映常驻内存相关信息,但共享内存页可能被多个进程共同映射,逐个进程的 RSS 相加不等于服务器实际使用的唯一物理内存。VSZ 是虚拟地址空间,可能包括尚未实际驻留在物理内存中的映射,因此不能把较大的 VSZ 直接等同于内存泄漏。判断内存压力时,应同时看系统可用内存、缓存、交换空间使用情况和应用自身的变化趋势。
top 顶部的 load average 是一段时间内处于可运行状态及不可中断等待状态的任务负载指标,不是 CPU 利用率百分比。若 load average 长期明显高于可用 CPU 核数,且 CPU 空闲率低,可能存在 CPU 调度压力;如果 CPU 空闲率仍较高,同时有较多 D 进程,则负载可能更多来自等待任务。该比较是定位线索,不是单独的故障判定标准。
马来西亚服务器常按当地业务安排查看日志和监控,但进程运行时长、采样间隔与系统时区不是同一概念。若进程启动时间或日志时间对不上,先核对系统时间与时区设置;不要因为时区差异把正常的运行时长或采样先后关系误判为进程异常。
ps 是一次性快照,适合确认进程是谁、处于什么状态以及与谁关联;top 是动态观察工具,适合判断指标是否在变化。二者都不能单独证明应用逻辑错误、磁盘损坏、网络故障或某项服务已经失效。
以下情况尤其需要谨慎解释:
排查时可按以下标准收敛结论:
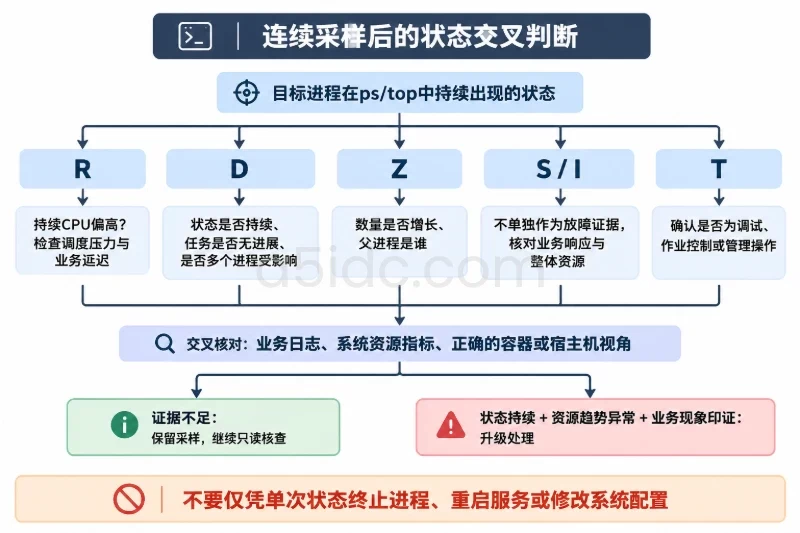
ps 记录目标进程的 PID、PPID、STAT、运行时长和资源占用,再用 top 连续观察至少数个刷新周期。R 重点看 CPU 是否持续偏高,以及系统是否同时出现调度压力;D 重点看状态是否持续、相关任务是否停滞及是否有多个进程受影响;Z 重点看数量是否持续增长及父进程是谁。S、I 不单独作为故障证据;T 则核实是否为有意暂停或调试。本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8392.html