香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


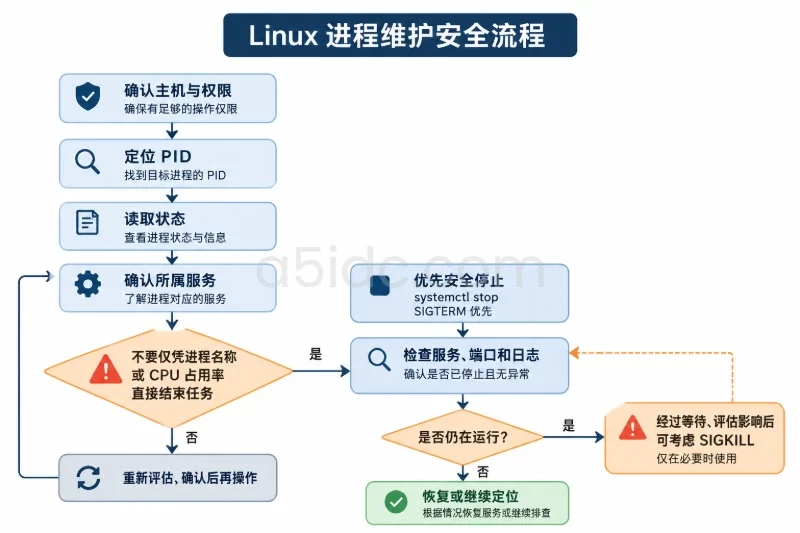
美国洛杉矶服务器上的Linux进程管理,核心不是单纯执行kill,而是先确认进程身份、所属服务和当前状态,再选择适合的停止方式。日常查看可使用ps、top、pgrep;由systemd管理的服务优先使用systemctl status和systemctl stop;必须直接操作进程时,先发送SIGTERM,确认进程没有正常退出后,再评估是否使用SIGKILL。
洛杉矶所在地区不会改变Linux进程命令,但远程SSH维护时要特别确认连接的主机、登录用户和时间基准。建议按照“确认主机与权限→定位PID→读取状态→安全停止→检查服务和端口→必要时恢复”的顺序操作,不要只根据进程名称或CPU占用率直接结束任务。
A5idc数据提供美国及香港、日本、韩国、新加坡等地区的物理服务器,可承载Linux网站、业务后台、数据库、容器和计算任务。美国服务器覆盖Xeon、AMD EPYC、GPU及多IP方案,并配有不同线路、带宽、内存和NVMe存储组合,便于为长期运行的服务进程、网络连接及多任务负载提供相应的硬件与网络资源基础。
在已有环境中执行维护命令前,先确认当前会话确实连接到了目标服务器。多台服务器同时维护时,误连主机比命令本身出错更难发现。
hostname
whoami
date -Is
cat /etc/os-release
重点查看以下信息:
hostname:确认主机名;whoami:确认当前用户是否具有所需权限;date -Is:确认服务器使用的时间和时区;/etc/os-release:确认是Ubuntu、Debian、Rocky Linux、AlmaLinux还是其他发行版。洛杉矶服务器不一定默认使用美国太平洋时间,很多生产环境统一使用UTC。ps输出中的启动时间、日志时间和监控系统时间可能因此不同。判断进程是否刚刚重启时,应先确认时间基准,不要仅凭显示时间下结论。
再确认常用工具是否存在,以及服务是否由systemd管理:
ps --version
command -v systemctl
systemctl --version
大多数采用systemd的Ubuntu、Debian、Rocky Linux和AlmaLinux环境都可以使用systemctl。如果系统是精简镜像、容器或BusyBox环境,部分参数可能不同,应先执行命令的帮助信息:
ps --help all
kill --help
一个服务通常包含多个不同角色:
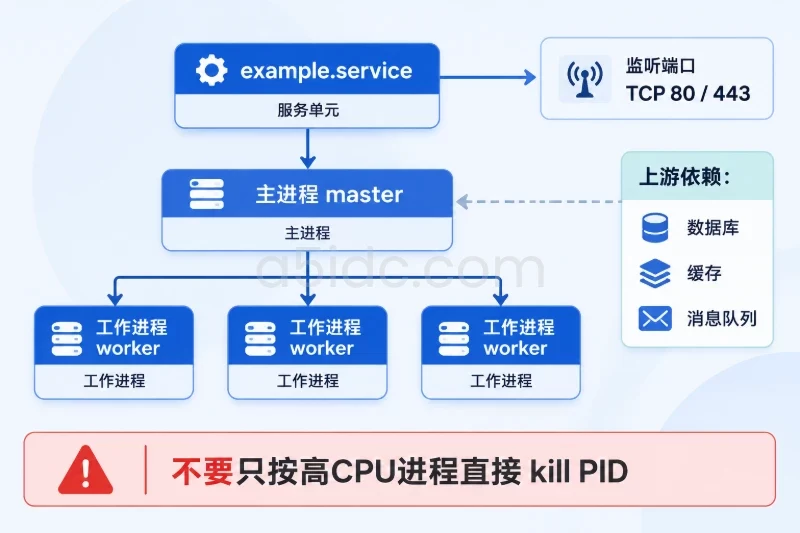
nginx.service;因此,看到一个高CPU进程后,不能马上执行kill PID。先确认它是否属于目标服务、是否为主进程,以及停止后是否会被systemd自动拉起。
常见进程字段可以这样理解:
| 字段 | 含义 | 判断用途 |
|---|---|---|
| PID | 进程编号 | 后续查询或发送信号的目标 |
| PPID | 父进程编号 | 判断进程由谁启动或管理 |
| USER | 所属用户 | 判断权限边界和业务归属 |
| STAT | 当前状态 | 区分运行、休眠、僵尸或不可中断状态 |
| %CPU | CPU占用比例 | 判断是否存在计算压力 |
| %MEM | 内存占用比例 | 判断是否存在内存压力 |
| ETIME | 已运行时间 | 判断是否刚启动或长期运行 |
| CMD | 启动命令和参数 | 确认进程用途,但注意可能包含敏感参数 |
CMD可能展示密码、令牌、连接字符串等敏感内容。命令输出不应直接粘贴到公开工单、聊天群或网页中,必要时应先脱敏。
先从全局资源和进程列表开始,不要一上来就筛选某个名称。
uptime
free -h
ps -eo pid,ppid,user,stat,%cpu,%mem,etime,cmd --sort=-%cpu | head -n 21
这些命令分别用于:
uptime:查看系统运行时间、登录用户数和平均负载;free -h:查看内存和Swap使用情况;ps ... --sort=-%cpu:按CPU占用从高到低列出进程。平均负载需要结合CPU核心数判断。比如一台4核服务器,负载长期接近4,通常表示CPU或不可中断任务已经接近并行处理能力;如果负载明显高于CPU核心数,还要继续区分是计算压力、磁盘I/O等待还是其他内核任务。不能只看到负载升高就结束某个进程。
实时观察可以使用:
top
在top界面中,常见重点包括:
%Cpu(s):区分用户态、系统态、空闲和I/O等待;load average:查看1分钟、5分钟和15分钟平均负载;PID:记录需要进一步检查的进程编号;%CPU:确认高占用是否持续,而不是瞬时峰值;%MEM和RES:判断内存消耗。单个多线程进程的CPU占用可能超过100%,这不一定表示数据错误,而是多个CPU核心同时参与计算。观察到高占用后,至少连续观察几个采样周期,再决定是否处理。
已知程序名称时,可以先用pgrep定位,但应尽量使用精确匹配。
pgrep -a -x nginx
pgrep -a -x php-fpm
pgrep -a -x mysqld
-x表示完整匹配进程名称,-a同时显示启动命令。若需要查看完整命令行,可以使用:
pgrep -a -f '/opt/example/bin/worker'
-f会匹配完整命令行,匹配范围更大,可能命中启动脚本、参数或其他相似命令。使用前应把结果逐行确认,不建议对pgrep -f的结果直接批量发送终止信号。
进一步查看某个PID:
pid=2486
ps -p "$pid" -o pid,ppid,user,stat,%cpu,%mem,lstart,etime,cmd
示例输出可能类似:
    PID    PPID USER     STAT %CPU %MEM                  STARTED     ELAPSED CMD
   2486       1 app      S     1.2  3.8 Mon Mar 18 08:20:11 2024  02:14:32 /opt/example/bin/worker --config /etc/example/worker.yml
判断时重点看:
PPID=1不一定表示异常,服务由systemd接管时很常见;STAT=S通常表示可中断睡眠,不代表进程停止;STAT=R表示正在运行;STAT=D表示处于不可中断睡眠,常与磁盘、网络存储或内核I/O有关;STAT=Z表示僵尸进程,进程主体已经退出,但父进程尚未回收;ETIME可以帮助判断PID是否是刚刚重启后重新分配的。进程树适合判断某个任务是由服务管理器、脚本还是SSH会话启动的。
ps -eo pid,ppid,pgid,sid,user,stat,cmd --forest
如果系统安装了pstree,也可以使用:
pstree -aps 2486
pstree不一定默认安装,缺少该命令时不应为了查看进程而临时修改生产环境软件源。使用ps --forest通常已经足够。
查看父进程时要关注以下情况:
systemd:优先通过服务单元管理;如果知道服务名,优先使用服务管理器查看:
systemctl status nginx --no-pager
systemctl is-active nginx
systemctl show nginx -p ActiveState,SubState,MainPID,ExecMainStatus
关键输出含义如下:
ActiveState=active:服务单元处于活动状态;SubState=running:主进程通常正在运行;MainPID:systemd记录的主进程PID;ExecMainStatus=0:最近一次主进程退出状态通常为成功;failed:服务启动或运行过程中出现失败,需要结合日志判断。如果只知道进程名称而不知道服务名,可以先列出运行中的服务:
systemctl list-units --type=service --state=running --no-pager
然后再查看具体服务的配置和重启策略:
systemctl cat example.service
systemctl show example.service -p Restart,RestartUSec,TimeoutStopUSec
不要把systemctl restart当作普通的进程结束命令。重启会先停止服务,再立即启动服务,可能造成短暂不可用;若服务正在处理写入、迁移或长连接,影响范围会更大。
需要确认进程是否持有文件、日志或端口时,可以使用:
ls -l /proc/2486/fd
tr '\0' '\n' < /proc/2486/cmdline
tr '\0' '\n' < /proc/2486/environ
读取/proc/2486/environ可能暴露数据库密码、令牌等环境变量,生产环境中不应随意执行或分享输出。
如果系统安装了lsof,可以查询进程的文件和网络连接:
lsof -p 2486
lsof -nP -iTCP:8080 -sTCP:LISTEN
确认监听端口时,也可以使用系统常见的ss:
ss -lntup
ss -lntp | grep ':8080'
ss -lntup中的常见参数是:
-l:只看监听状态;-n:不进行名称解析;-t:TCP;-u:UDP;-p:显示关联进程,通常需要更高权限。直接操作PID前,先保存目标PID并再次确认:
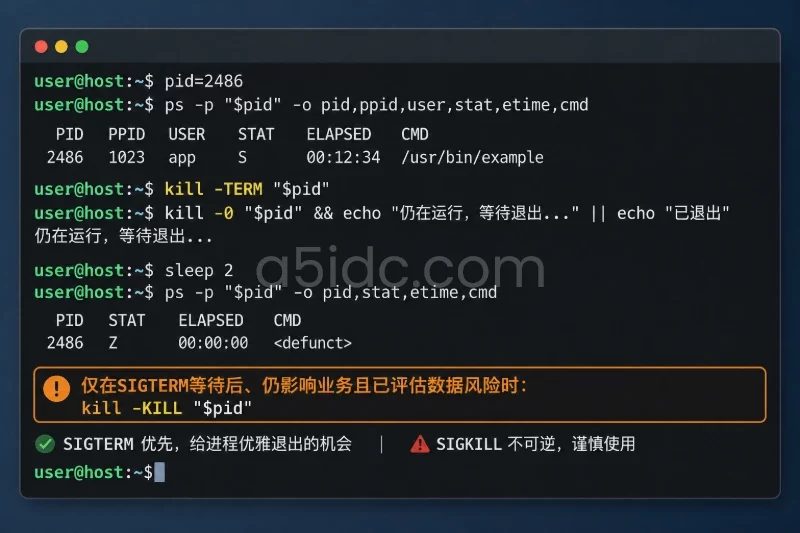
pid=2486
ps -p "$pid" -o pid,ppid,user,stat,etime,cmd
确认无误后,先发送可处理的终止信号:
kill -TERM "$pid"
SIGTERM的编号通常是15,应用可以捕获该信号并执行清理动作,例如关闭监听端口、提交或回滚事务、刷新日志、释放临时文件。发送后等待一段时间,再检查进程是否退出:
for i in {1..15}; do
    if ! kill -0 "$pid" 2>/dev/null; then
        echo "process stopped"
        break
    fi

    ps -p "$pid" -o pid,stat,etime,cmd
    sleep 1
done
kill -0不会真正结束进程,只用于检查PID是否存在以及当前用户是否有权访问。若进程变为Z,不能简单认为已经正常清理,还要检查父进程是否回收了僵尸进程。
只有在以下条件同时满足时,才考虑发送SIGKILL:
SIGTERM并等待合理时间;命令如下:
kill -KILL "$pid"
SIGKILL无法被应用捕获,程序没有机会执行清理逻辑。它可能导致未写入的数据丢失、临时文件残留、锁未释放或数据库恢复时间增加。不要把kill -KILL作为第一选择,也不要对PID 1、内核线程、SSH主会话或不明父子进程关系的进程随意使用。
如果进程属于systemd服务,优先执行:
sudo systemctl stop example.service
sudo systemctl status example.service --no-pager
停止后确认:
systemctl is-active example.service
systemctl show example.service -p ActiveState,SubState,MainPID
这种方式通常比直接结束主进程更完整,因为服务管理器可以按服务定义执行停止流程,并同步更新服务状态。停止服务的影响是该服务暂时不可用,依赖它的请求可能失败。涉及数据库、队列、订单写入或文件处理时,应先确认应用自身支持的停机方式和当前是否有未完成任务。
如果服务停止后又自动出现,说明可能存在自动重启策略、外部守护程序或容器编排。此时不应反复执行kill,应先查看日志和服务配置。
发送SIGTERM或SIGKILL后,不要只依据终端没有报错就认为操作成功。重新查询PID:
ps -p 2486 -o pid,ppid,user,stat,etime,cmd
如果没有输出,通常表示该PID已经不存在。若仍有输出,需要结合状态判断:
S或R:进程仍然存在;D:进程可能卡在不可中断I/O,信号不会立即产生可见效果;Z:进程主体已结束,但父进程尚未回收;还可以再次按名称查询:
pgrep -a -x worker
不要仅因原PID消失就判断服务停止。服务可能已经使用新PID重新启动,因此还要检查服务状态和监听端口。
对于systemd服务,执行:
systemctl is-active example.service
systemctl status example.service --no-pager
journalctl -u example.service -n 50 --no-pager
重点查看:
active、inactive还是failed;如果目标是停止服务,应确认端口已经释放:
ss -lntup
如果目标是重启服务,应确认端口重新监听,并使用应用自身的健康检查命令或业务探针验证。仅看到端口处于LISTEN,不能证明应用已经能够正常处理请求。
以HTTP服务为例,可以在服务器本机执行已有的健康检查地址:
curl -fsS --max-time 5 http://127.0.0.1:8080/health
其中端口和路径必须以实际应用配置为准,不能直接套用示例地址。
进程停止或服务恢复后,再查看系统资源:
uptime
free -h
vmstat 1 5
ps -eo pid,user,stat,%cpu,%mem,etime,cmd --sort=-%mem | head -n 15
观察重点包括:
如果服务由多个工作进程组成,停止一个worker后资源可能暂时下降,但主服务仍处于异常状态。应以服务级状态、端口和健康检查作为验收依据,而不是只看单个PID。
执行kill时出现“No such process”,常见原因有:
重新执行以下命令确认:
systemctl show example.service -p MainPID,ActiveState,SubState
pgrep -a -x worker
ps -eo pid,ppid,user,stat,etime,cmd | grep '[w]orker'
不要继续使用旧PID。Linux会在进程退出后回收PID,长时间间隔下旧PID可能被其他程序重新使用。
如果普通用户无法查看完整信息或发送信号,先确认目标进程属于哪个用户:
ps -p 2486 -o pid,user,group,stat,cmd
必要时使用具有授权的账号执行:
sudo -v
sudo ps -p 2486 -o pid,ppid,user,stat,cmd
sudo kill -TERM 2486
使用sudo前必须再次确认主机、PID和命令。权限提升只解决访问控制问题,不会降低误杀风险。生产环境中不建议直接授予对所有进程执行kill -KILL的长期权限。
D表示不可中断睡眠,通常与磁盘、网络文件系统、块设备或内核I/O等待有关。此时即使发送SIGKILL,进程也可能不会立即消失。
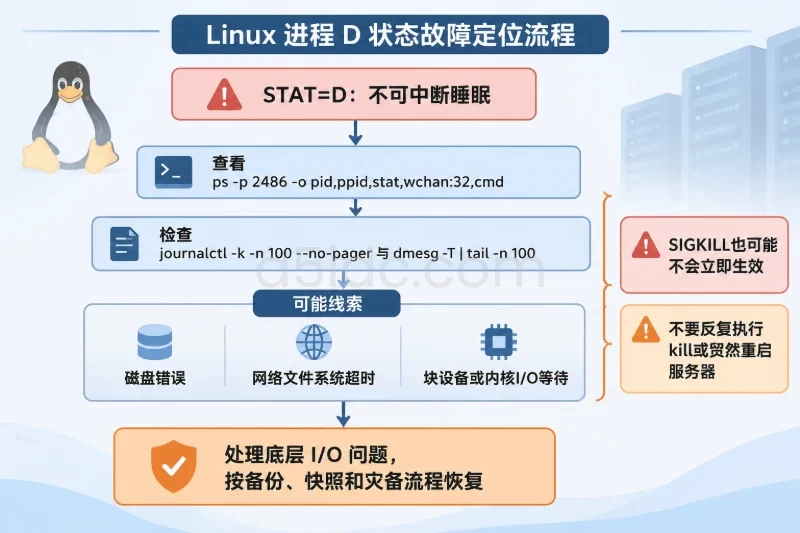
先查看进程和内核日志:
ps -p 2486 -o pid,ppid,stat,wchan:32,cmd
journalctl -k -n 100 --no-pager
dmesg -T | tail -n 100
如果发现磁盘错误、网络存储超时或设备故障,应先处理底层I/O问题。反复执行kill无法修复内核等待,强制重启服务器还可能扩大文件系统或业务数据风险。涉及存储故障时,应按照已有的备份、快照和灾备流程操作。
僵尸进程本身已经结束,不能通过再次发送SIGTERM或SIGKILL清除。重点是找到其父进程:
ps -p 2486 -o pid,ppid,stat,cmd
ps -p 1900 -o pid,ppid,stat,cmd
如果父进程是应用自身,说明应用可能没有正确调用等待子进程的逻辑。可以先查看应用日志和服务状态;在确认服务支持平滑重启后,通过服务管理器重启父进程:
sudo systemctl restart example.service
重启前要评估业务影响。若僵尸进程数量持续增加,根因通常在父进程的子进程管理,而不是僵尸进程本身。
如果执行停止后,进程又以新PID出现,可能是以下机制在工作:
Restart=always或Restart=on-failure;-容器的重启策略;
先查看:
systemctl show example.service -p Restart,RestartUSec,MainPID
journalctl -u example.service -n 100 --no-pager
如果进程运行在容器中,应通过容器或编排层管理,而不是在宿主机上反复结束单个PID。宿主机PID可能只是容器内部进程的映射,直接操作还可能绕过应用的停止流程。
高CPU不一定意味着进程失控,可能是编译、压缩、备份或批量计算任务。先查看线程级占用:
ps -L -p 2486 -o pid,tid,stat,%cpu,%mem,comm
确认是短时任务还是持续异常后,再决定是限速、调整优先级、平滑停止还是终止。临时调整优先级也会改变调度行为,不能替代原因分析:
sudo renice 10 -p 2486
内存压力下,不要为了快速释放内存而直接结束数据库或写入型服务。先查看日志、Swap、OOM记录和服务自身状态:
journalctl -k --no-pager | grep -Ei 'oom|out of memory|killed process'
free -h
数据库、消息队列和文件处理程序应优先使用其官方停机或暂停机制,避免在写入过程中直接强制结束。
如果只是临时停止一个由systemd管理的服务,确认维护动作完成后可以启动:
sudo systemctl start example.service
sudo systemctl is-active example.service
sudo systemctl status example.service --no-pager
然后检查:
ss -lntup
journalctl -u example.service -n 50 --no-pager
恢复成功至少应同时满足:
使用SIGKILL后不能假设应用可以立即无损恢复。应按应用类型采取不同动作:
如果配置文件在维护过程中被修改,先保存当前版本,再使用已验证的备份恢复,不要用空文件覆盖原配置:
cp -a /etc/example/example.conf "/etc/example/example.conf.after-$(date +%Y%m%d%H%M%S)"
恢复备份前应先比较内容:
diff -u /etc/example/example.conf /path/to/backup/example.conf
确认备份来源和版本无误后再替换,并在替换后执行应用提供的配置检查命令。如果应用不支持配置校验,不要用猜测的参数启动服务,应先查看服务日志和配置说明。
如果进程原本由人工Shell启动,恢复时不要只执行一个不清晰的后台命令。应确认启动目录、用户、配置文件、日志路径和环境变量。可以先查看历史记录或已有服务脚本:
history | tail -n 30
find /etc/systemd/system /usr/lib/systemd/system -maxdepth 1 -type f -name '*.service' 2>/dev/null
若任务本来就应长期运行,建议纳入已有的服务管理方式,而不是长期依赖手工nohup。如果临时使用终端启动,SSH断开、会话超时或Shell退出都可能影响任务生命周期。
完成进程维护后,按实际对象逐项核对:
STAT、CPU、内存、运行时长和父子关系;systemctl stop或应用自身的停机方式;SIGTERM,并等待应用执行清理;SIGKILL前已评估数据、日志、锁和临时文件影响;本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/8339.html