香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


在马来西亚服务器上,守护进程反复退出时,systemctl status 只能说明服务何时失败、是否被自动重启,真正的原因通常要结合 journalctl、端口监听、运行用户、依赖服务和内核日志判断。先确认进程是“启动后主动退出”,还是被系统杀死、端口冲突阻止启动,排查方向会完全不同。
较稳妥的顺序是:先固定故障时间线,再检查服务管理器和应用日志,随后确认端口与外部依赖,最后才处理权限、资源限制和安全策略。不要在原因未明时连续执行 restart,否则可能触发 systemd 的启动频率限制,也会让原始日志被新一轮失败信息淹没。
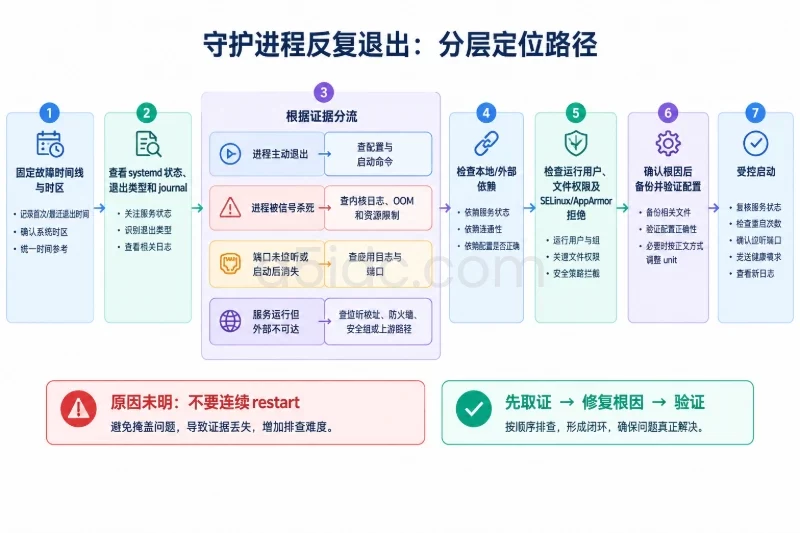
以下命令以使用 systemd 的 Linux 服务器为例,适用于常见的 Ubuntu、Debian、Rocky Linux、AlmaLinux 等发行版。示例服务名使用 example-app.service,实际操作时替换为真实服务名。
先确认服务器确实由 systemd 管理该进程:
systemctl --version
ps -p 1 -o pid,comm,args
如果 PID 1 显示为 systemd,可以继续使用 systemctl 和 journalctl。如果服务运行在 Docker、Podman、Supervisor 或其他进程管理器中,则应使用对应管理器查看状态,不要把容器内的服务和宿主机上的同名服务混为一谈。
建议先记录当前时间、服务状态和服务是否设置为开机启动:
date -Is
timedatectl
sudo systemctl is-enabled example-app.service
sudo systemctl status example-app.service --no-pager -l
马来西亚服务器的系统时区可能设置为 UTC,也可能设置为 Asia/Kuala_Lumpur。时区不同不会直接导致守护进程退出,但会影响你对日志时间的判断。排障时应以日志中带时区的时间为准,不要为了“看起来一致”而临时修改系统时钟或时区。
如果服务承载生产流量,先确认是否有维护窗口。状态查询、日志读取和端口查看通常不会影响业务;编辑配置、重启服务、修改权限或调整防火墙则可能造成短暂中断,应提前准备回滚方式。
执行:
sudo systemctl status example-app.service --no-pager -l
重点关注以下字段:
Active:服务当前是 active (running)、failed 还是处于 activating。Main PID:主进程是否真正创建。Process:是否出现 code=exited、status=1/FAILURE、signal=KILL 等信息。Restart:systemd 是否正在自动重启。Start request repeated too quickly:短时间内失败次数过多,已触发启动频率限制。为了获取更适合判断的数据,可以查看服务的退出状态和重启次数:
sudo systemctl show example-app.service \
  -p ActiveState \
  -p SubState \
  -p Result \
  -p ExecMainCode \
  -p ExecMainStatus \
  -p NRestarts \
  -p RestartUSec \
  -p ActiveEnterTimestamp \
  -p ExecMainStartTimestamp
这些字段的含义可以这样理解:
ExecMainCode=exited:进程自行退出,通常要查配置、参数、依赖或应用逻辑。ExecMainCode=killed:进程收到信号,可能是 OOM、管理员停止、systemd 超时或其他进程发送信号。ExecMainStatus=1:应用返回了通用失败码,单凭这个数字无法确定原因。ExecMainStatus=126:常见于文件不可执行或权限不足。ExecMainStatus=127:常见于启动命令或依赖的可执行文件不存在。ExecMainStatus=137:通常对应 SIGKILL,需要重点检查内存不足或外部强制终止。ExecMainStatus=139:常见于段错误,可能涉及程序缺陷、动态库或二进制兼容性。NRestarts 持续增长:服务管理器确实在反复拉起进程,但不代表每次都成功运行。这些退出码只是判断线索,不是最终结论。例如,配置错误可能返回 1,内存不足也可能因为应用来不及记录错误而只在内核日志中留下痕迹。
先读取本次启动期间最近的日志:
sudo journalctl -u example-app.service -b -n 200 --no-pager -o short-iso-precise
如果故障发生在最近 30 分钟,可以缩小范围:
sudo journalctl -u example-app.service \
  --since "30 minutes ago" \
  --no-pager \
  -o short-iso-precise
如果服务日志中只有 systemd 的统一错误,例如“启动失败”“进程退出”,却看不到应用自己的报错,通常有几种可能:
ExecStart 指向的命令不存在或无法执行。服务单元的定义可以帮助确认启动命令、运行用户、工作目录和环境文件:
sudo systemctl cat example-app.service

sudo systemctl show example-app.service \
  -p FragmentPath \
  -p DropInPaths \
  -p User \
  -p Group \
  -p WorkingDirectory \
  -p ExecStart \
  -p EnvironmentFiles
Environment 可能包含数据库密码、令牌或其他敏感值,不要把完整输出直接贴到公开工单或聊天窗口。优先查看 EnvironmentFiles 路径和 ExecStart 是否指向预期文件。
如果修改过 unit 文件或 drop-in 配置,可先验证语法:
sudo systemd-analyze verify /etc/systemd/system/example-app.service
路径必须替换为上一步 FragmentPath 显示的实际路径。如果服务使用的是 /usr/lib/systemd/system/ 下的文件,也应以实际路径为准。验证命令没有报错,只能说明 unit 语法基本可解析,不能证明应用配置一定正确。
服务“不断退出”和“服务启动了但外部访问不到”是两类问题。先确认进程是否在本机监听预期端口。
查看所有 TCP 监听端口:
sudo ss -lntp
如果已知服务端口,例如 8080,可以缩小输出:
sudo ss -lntp | grep ':8080'
如果应用使用 UDP 或 Unix Socket,还要分别查看:
sudo ss -lnup
sudo ss -lxnp
常见结果及含义如下:
| 观察结果 | 可能含义 | 下一步 |
|---|---|---|
| 没有预期端口 | 进程尚未完成初始化、已退出或配置使用了其他端口 | 查服务日志和 ExecStart 参数 |
| 端口被其他 PID 占用 | 端口冲突,应用可能启动后立即退出 | 用 PID 识别所属服务,不要直接杀进程 |
监听在 127.0.0.1 | 只能本机访问 | 检查应用绑定地址和反向代理拓扑 |
监听在 0.0.0.0 或服务器地址 | 已监听 IPv4 地址 | 再检查主机防火墙、云平台安全策略和外部路径 |
仅监听在 ::1 或 [::] | 可能只支持 IPv6,或 IPv4 映射行为与预期不同 | 分别测试 IPv4 和 IPv6 |
| 端口短暂出现后消失 | 应用初始化阶段失败或被系统终止 | 对照端口出现时间和服务日志时间 |
发现端口被占用时,先查看对应进程:
sudo ss -lntp | grep ':8080'
ps -fp <PID>
sudo systemctl status <占用端口的服务名> --no-pager -l
不要看到陌生 PID 就执行 kill -9。它可能是数据库、反向代理或其他生产服务。正确处理方式是确认端口规划:要么让其中一个服务改用其他端口,要么在维护窗口内停止冲突服务。停止或终止进程前,应确认影响范围,并记录原配置以便恢复。
如果服务显示为运行中,可以从本机发起基础检查:
curl -v --connect-timeout 3 --max-time 5 http://127.0.0.1:8080/
本机访问成功,说明进程和本机监听大致正常,外部访问失败时应转向监听地址、主机防火墙、云平台安全组或上游负载均衡。若本机访问也失败,则继续查应用日志和健康检查路径,不要先扩大公网放行范围。
配置文件错误是守护进程启动后立即退出的常见原因。优先使用软件自身提供的校验命令,而不是直接重启观察。
例如,Nginx 配置可以使用:
sudo nginx -t
其他软件的校验参数可能是 --check-config、--configtest 或独立的验证子命令,但不同版本并不统一。应先查看当前二进制支持的帮助信息:
command -v example-app
example-app --help
不要把不确定的参数直接加到生产启动命令中。有些程序的“检查配置”命令会连接数据库、执行迁移或创建目录,必须先确认它是只读检查。
如果 ExecStart 使用的是脚本或自定义路径,分别验证文件是否存在、解释器是否可用:
sudo systemctl show example-app.service -p ExecStart
command -v bash
ls -l /path/to/start-script
head -n 1 /path/to/start-script
对于 ELF 二进制,还可以检查动态库是否缺失:
ldd /path/to/example-app | grep 'not found'
如果输出了 not found,说明运行环境缺少动态库或库搜索路径不完整;如果没有输出,只能说明 ldd 没发现明显缺失,不能排除版本不兼容。
查看 unit 的依赖关系和失败项:
sudo systemctl list-dependencies example-app.service
sudo systemctl list-dependencies --failed example-app.service
sudo systemctl show example-app.service \
  -p Requires \
  -p Wants \
  -p After \
  -p ConditionResult \
  -p AssertResult
如果依赖服务没有启动,例如本地数据库、缓存或挂载点失败,先修复依赖,再处理主服务。After= 只表示启动顺序,不代表依赖一定可用;真正的强依赖通常还需要 Requires= 或应用自身的连接检查。
外部依赖则需要从应用日志中寻找连接超时、拒绝连接、认证失败、DNS 解析失败等信息。可以做不改变数据的基础连通性检查:
getent hosts db.example.internal
nc -vz -w 3 db.example.internal 5432
如果系统没有 nc,先检查:
command -v nc
DNS 能解析不代表端口可用,端口可用也不代表账号密码正确。数据库认证不要把密码直接放在命令行中,因为命令可能出现在进程列表或 shell 历史记录里。
马来西亚机房中的服务如果依赖其他地区的数据库、对象存储、授权接口或消息队列,还要考虑跨区域连接延迟、出站访问策略和证书校验时间。但如果应用日志明确显示“配置文件语法错误”,就不应把注意力转向网络延迟。
服务手工执行正常、systemd 启动失败时,最常见的差异是运行身份不同。先确认 unit 使用的用户和组:
sudo systemctl show example-app.service -p User -p Group
id appuser
然后以该用户检查关键文件是否可读、目录是否可进入、日志目录是否可写:
sudo -u appuser test -r /etc/example-app/app.conf \
  && echo "config readable" \
  || echo "config not readable"

sudo -u appuser test -w /var/log/example-app \
  && echo "log directory writable" \
  || echo "log directory not writable"

namei -l /etc/example-app/app.conf
namei -l /var/log/example-app
namei -l 能逐级显示路径权限。即使配置文件本身是 644,只要上级目录缺少执行权限,服务用户仍然无法访问。
如果确认是权限问题,不要使用 chmod -R 777 或把整个目录递归改成服务用户。应只修改应用需要访问的文件和目录,并先记录原状态:
sudo stat -c '%U %G %a %n' /etc/example-app/app.conf /var/log/example-app
之后根据应用要求进行最小范围调整。下面只是形式示例,用户、组和权限必须替换为实际值:
sudo chown appuser:appgroup /etc/example-app/app.conf
sudo chmod 640 /etc/example-app/app.conf
权限变更会影响服务读取配置或写入日志,执行前应记录旧的用户、组和模式;如果结果不符合预期,按记录恢复,而不是继续扩大权限。
在启用 SELinux 的系统上,Unix 权限正确也可能被安全策略拒绝:
getenforce
sudo ausearch -m AVC -ts recent
在使用 AppArmor 的系统上,可以查看内核日志中的拒绝信息:
sudo journalctl -k --since "30 minutes ago" | grep -i apparmor
不要为了验证而长期关闭 SELinux 或 AppArmor。应根据拒绝日志补充精确策略,测试完成后保持原有安全控制。如果近期刚迁移目录、修改服务用户或更换二进制文件,安全策略拒绝的可能性会明显增加。
应用被系统杀死时,服务日志可能没有任何异常,需要查看内核日志:
sudo journalctl -k -b --no-pager | grep -Ei 'out of memory|oom|killed process|memory cgroup'
同时检查内存、磁盘空间和 inode:
free -h
df -h
df -ih
典型判断方式如下:
Out of memory 或 Killed process:优先处理 OOM。systemd 的资源限制需要从服务本身查看,不能只看当前 SSH 会话的 ulimit:
sudo systemctl show example-app.service \
  -p MemoryMax \
  -p TasksMax \
  -p LimitNOFILE \
  -p LimitNPROC \
  -p TimeoutStartUSec
如果日志提示 Too many open files,应先确认程序是否异常创建连接或未关闭文件,再评估是否需要调整 LimitNOFILE。单纯提高限制可能掩盖程序泄漏。
清理磁盘时不要直接删除正在使用的日志、数据库文件或应用目录。先确定占用来源:
sudo du -xhd1 /var | sort -h
sudo journalctl --disk-usage
如果确实需要压缩或清理日志,应遵守现有日志轮转策略,并确认保留周期、审计要求和回滚条件。数据库目录、队列目录和应用数据目录不能按照普通日志处理。
围绕马来西亚服务器上长期运行的守护进程,A5idc数据提供吉隆坡物理服务器,涵盖不同CPU、内存、存储及线路配置,可为应用运行、日志写入和数据读写提供计算、磁盘与网络资源基础。对于依赖其他地区业务系统的部署,品牌在新加坡、中国香港等地也提供物理服务器,支持按业务分布组织多地服务资源。
下面的分支用于把观察结果和处理动作对应起来:
| 主要证据 | 更可能的原因 | 处理方向 |
|---|---|---|
日志出现 unknown option、解析错误、配置行号 | 配置语法或参数不兼容 | 备份配置,修正后执行原生配置校验 |
ExecStart 指向的文件不存在,或出现 status=127 | 命令路径、环境变量或软件包缺失 | 核对绝对路径、PATH 和安装状态 |
status=126、Permission denied | 文件不可执行、运行用户权限不足或安全策略拒绝 | 检查文件权限、目录权限及 SELinux/AppArmor |
| 预期端口已被其他 PID 占用 | 端口冲突 | 识别占用服务,调整端口或安排有计划的停止 |
| 应用日志显示数据库连接失败、DNS 失败、超时 | 外部或本地依赖不可用 | 检查解析、路由、依赖服务、凭据和访问策略 |
内核日志出现 OOM、Killed process | 内存或 cgroup 限制不足 | 降低负载、修复内存增长,再评估资源配置 |
Start request repeated too quickly | 连续失败触发 systemd 限制 | 先修复根因,最后再清除失败状态并启动 |
| 服务显示运行但本机端口不通 | 应用未绑定预期端口、初始化未完成或健康检查路径错误 | 查监听地址、应用日志和实际配置 |
| 本机访问正常、外部访问失败 | 防火墙、安全组、监听地址或上游网络问题 | 分层检查,不要先开放全部端口 |
修改配置前,先保存带时间戳的副本。下面示例适用于普通文本配置,路径需要替换:
sudo cp -a /etc/example-app/app.conf \
  "/etc/example-app/app.conf.bak.$(date +%Y%m%d-%H%M%S)"
备份文件可能包含密码或密钥,应保留原有访问权限,不要复制到公共目录。修改完成后先运行软件提供的配置校验,再重启服务。校验失败时恢复备份:
sudo cp -a /etc/example-app/app.conf.bak.YYYYMMDD-HHMMSS \
  /etc/example-app/app.conf
恢复后仍应重新执行配置校验,确认恢复文件没有因为路径、软链接或权限问题而失效。
如果需要调整 User、WorkingDirectory、环境变量或资源限制,不建议直接编辑发行版提供的 /usr/lib/systemd/system/ 或 /lib/systemd/system/ 文件。可以查看当前配置后使用:
sudo systemctl edit example-app.service
保存后重新加载 unit:
sudo systemctl daemon-reload
如果只修改了服务配置文件而没有修改 unit,则不需要执行 daemon-reload。unit 修改后可以使用以下方式检查:
sudo systemd-analyze verify /etc/systemd/system/example-app.service.d/override.conf
路径以实际生成的 drop-in 文件为准。若确认修改方向错误,可以先保存当前内容,再使用:
sudo systemctl revert example-app.service
sudo systemctl daemon-reload
revert 会移除该服务的本地覆盖配置,可能影响此前所有 drop-in 设置,执行前应确认该服务是否还有其他人工调整。
确认根因已经处理后,再进行一次受控启动。若只是配置文件变化而服务当前仍在失败状态,通常使用 start;如果服务已经运行但需要载入新配置,才考虑 restart。
sudo systemctl start example-app.service
sudo systemctl status example-app.service --no-pager -l
先确认 systemd 视角的状态:
sudo systemctl is-active example-app.service
sudo systemctl show example-app.service \
  -p ActiveState \
  -p SubState \
  -p Result \
  -p NRestarts
再确认应用视角的状态:
sudo ss -lntp
curl -v --connect-timeout 3 --max-time 5 http://127.0.0.1:8080/
最后重新读取本次启动产生的日志:
sudo journalctl -u example-app.service \
  --since "5 minutes ago" \
  --no-pager \
  -o short-iso-precise
如果仍然提示 Start request repeated too quickly,不要只执行 reset-failed 来掩盖问题。先保存现有日志,确认配置、端口、依赖和资源问题已经修复后,再清除失败状态:
sudo systemctl reset-failed example-app.service
sudo systemctl start example-app.service
如果服务已经启动,至少观察一个完整的业务周期,或观察数个原本的自动重启间隔。可以使用:
watch -n 5 'systemctl is-active example-app.service; systemctl show example-app.service -p NRestarts'
持续观察时重点确认:
NRestarts 不再增长;如果故障只在重启服务器后复现,还要单独检查 After=、挂载点、网络就绪状态和外部依赖初始化顺序,而不是简单增加 Restart=always。自动重启只能提高恢复能力,不能替代对退出原因的定位。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7988.html