香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


美国洛杉矶服务器运行 Nginx 遇到高并发时,不宜先把 worker_connections 调到很大。更可靠的做法是先确认请求是被连接数、文件描述符、CPU、网络带宽、磁盘 I/O 还是上游应用拖慢,再分别调整连接、缓存、压缩和超时参数。worker_connections 只能决定 Nginx 能够管理多少连接,并不能直接决定每秒能够处理多少请求。
如果请求主要来自北美,洛杉矶机房的网络往返时间通常不是主要矛盾;如果访问者分布在亚洲、欧洲或南美,公网 RTT、TLS 握手和跨洲传输时间会显著影响 p95、p99 延迟。此时应把“网络距离造成的延迟”和“Nginx 排队或上游响应造成的延迟”分开分析,不能仅靠增大并发连接参数解决。
Nginx 处理静态文件时,瓶颈通常在磁盘读取、文件描述符、网络发送和压缩 CPU;反向代理动态请求时,还要额外占用到上游应用的连接,并受到数据库、应用线程池和业务逻辑执行时间的影响。
因此,测试至少应分成三类:
| 测试场景 | 主要观察指标 | 重点参数 |
|---|---|---|
| 静态文件命中 | 吞吐、p95 延迟、网络发送速率、磁盘 I/O | sendfile、文件缓存、压缩、缓存头 |
| 动态请求未缓存 | 上游响应时间、活动连接、CPU、错误率 | proxy_*_timeout、上游连接复用、缓冲 |
| 公共内容缓存命中 | 缓存命中率、源站请求下降比例、p95 延迟 | proxy_cache、缓存键、缓存有效期 |
测试目标要先写成可验收的条件,例如“在 800 请求/秒下,p95 小于 300 ms,5xx 低于 0.1%,CPU 持续低于 80%,内存保留 20% 以上余量”。没有这些边界,只看某一次压测的峰值 RPS,无法判断配置是否适合生产。
可以使用仅针对自有业务和授权环境的压测工具进行对照测试:
wrk -t4 -c200 -d60s --latency https://example.com/assets/app.js
wrk -t4 -c100 -d60s --latency https://example.com/api/health
-c 是客户端连接数,不等于 Nginx 的总连接容量;-d 是持续时间;--latency 用于观察延迟分布。测试前应先预热缓存,正式测试至少重复 3 次,并记录压测端自身的 CPU、带宽和连接数。如果压测机已经成为瓶颈,服务端结果不能作为容量依据。
洛杉矶服务器的测试结果会受到测试端位置影响。来自洛杉矶本地、美国东部、亚洲的请求,RTT 和丢包情况不同。复测时应保持测试端区域、DNS 解析路径、HTTPS 状态和请求内容一致。
同一个接口可以拆成以下对照:
请求速率、响应时间和正在处理的请求数量之间,可以用一个简单关系估算:
正在处理的请求数 ≈ 每秒请求数 × 平均响应时间(秒)
例如,业务平均处理时间为 0.2 秒,目标吞吐为 1000 请求/秒,则同时处于处理中的请求约为:
1000 × 0.2 = 200 个请求
反向代理场景中,一个动态请求通常同时占用客户端连接和上游连接,因此约需要 400 个活动套接字;如果还有 3000 个客户端保持 Keepalive 空闲连接,连接需求就可能接近 3400 个。这个数字还没有计算监控、管理接口、缓存回源和突发流量的余量。
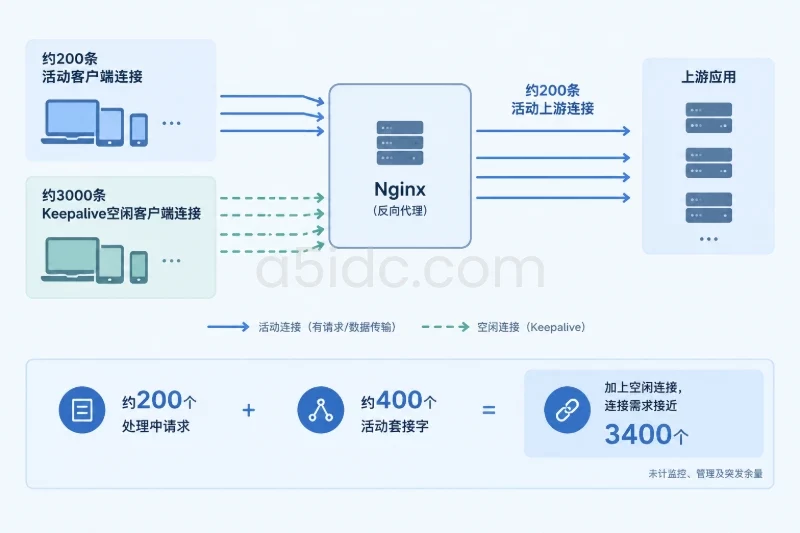
因此,连接容量至少要同时满足:
| 指标 | 典型含义 | 可能的调整方向 |
|---|---|---|
| p50 延迟 | 普通请求的基础处理速度 | 判断常态性能 |
| p95、p99 延迟 | 排队、慢请求和长尾情况 | 查看上游、I/O、连接池和超时 |
| RPS 或吞吐 | 单位时间处理请求数量 | 结合 CPU、带宽和错误率判断 |
| Established 连接 | 当前已建立连接数量 | 检查 Keepalive、上游连接和连接上限 |
| TIME_WAIT | 已关闭连接的短期状态 | 观察连接复用和短连接比例,不等于活动连接 |
| CPU 使用率 | Nginx、压缩、TLS 或上游计算压力 | 降低压缩等级、增加缓存或扩容 CPU |
| 内存使用率 | 连接、缓存、代理缓冲占用 | 控制缓存和缓冲区,保留系统余量 |
| 磁盘 await、util | 静态文件、缓存文件或日志 I/O 压力 | 使用文件缓存、减少无必要日志、优化存储 |
| 网络发送速率 | 是否接近端口或带宽上限 | 压缩静态文本、使用边缘缓存或提升带宽 |
| 5xx、超时率 | 服务是否已经进入不可用区间 | 优先排查上游和资源耗尽 |
可以在压测时配合以下只读命令观察系统状态:
ss -s
ss -lnt
vmstat 1
iostat -xz 1
ss -s 用于查看连接汇总,ss -lnt 可以查看监听队列,vmstat 适合观察运行队列和内存,iostat 用于判断磁盘等待。不要把 TIME_WAIT 数量直接当成当前并发量,也不要在没有连接状态和内核队列证据时盲目修改 TCP 参数。
以下是面向 Linux 环境的参考片段,适合放在 Nginx 主配置中进行对照。worker_processes auto、use epoll 和 worker_connections 不应脱离服务器 CPU、系统限制和实际连接数单独设置。
worker_processes auto;
worker_rlimit_nofile 65535;

events {
    use epoll;
    worker_connections 8192;
}

http {
    keepalive_timeout 15s;
    keepalive_requests 500;

    client_header_timeout 10s;
    client_body_timeout 30s;
    send_timeout 15s;

    reset_timedout_connection on;
}
这段配置中:
worker_processes auto 通常让 Nginx 按可见 CPU 数量创建工作进程。worker_connections 8192 表示每个 worker 可管理的连接槽位数量,包含客户端连接和上游连接,不是“每个连接可以处理 8192 个请求”。worker_rlimit_nofile 只是在 Nginx 进程层面提高文件描述符上限,不能绕过 systemd、容器或操作系统的限制。keepalive_timeout 15s 用于限制客户端空闲连接的保留时间。时间过长会增加空闲连接和文件描述符占用,时间过短则会增加重新建立 TCP 和 TLS 连接的次数。keepalive_requests 500 控制单个长连接可承载的请求数量。API 请求频繁且连接复用良好时可以使用较高值,但需要结合连接生命周期和 TLS 握手率验证。client_header_timeout、client_body_timeout 和 send_timeout 应限制异常慢连接,避免少量慢客户端长期占用资源。worker_processes × worker_connections 只是理论连接槽位上限。比如 4 个 worker 和 8192 个连接槽位,理论上是 32768 个连接,但实际还会受到以下条件限制:
nofile 上限;LimitNOFILE;可先核验限制,而不是直接继续增大参数:
nginx -T
systemctl show nginx -p LimitNOFILE
cat /proc/$(pgrep -o nginx)/limits | grep -i "open files"
如果 worker_connections 已经是 8192,但服务进程实际只能打开 1024 个文件,继续增大 Nginx 参数不会带来有效容量提升。
对于网页静态资源和短接口,过长的客户端 Keepalive 可能使大量连接处于空闲状态。对于跨区域访问,Keepalive 可以减少重复握手,但不能消除公网 RTT。可以从 10 至 30 秒这一范围开始测试,再结合以下指标调整:
worker_connections 使用率;上游连接池与客户端 Keepalive 是两回事。下面的 keepalive 64 表示每个 worker 为该上游缓存一定数量的空闲连接,4 个 worker 时,理论上可能保留约 256 个上游空闲连接:
upstream app_pool {
    server 127.0.0.1:8080;
    keepalive 64;
}
如果上游应用的数据库连接池、线程池或最大连接数较小,不能因为 Nginx 连接数较大就把上游 Keepalive 设置得很高。上游连接空闲过多会占用应用资源,过少则会增加连接建立开销。
静态资源应使用版本化文件名,例如 app.202503.js 或内容哈希文件名。文件内容改变时更新文件名,才能安全地使用较长缓存时间。
http {
    sendfile on;
    tcp_nopush on;
    tcp_nodelay on;

    open_file_cache max=20000 inactive=30s;
    open_file_cache_valid 60s;
    open_file_cache_min_uses 2;
    open_file_cache_errors on;

    server {
        location ~* \.(css|js|png|jpg|jpeg|gif|svg|webp|ico|woff2)$ {
            try_files $uri =404;
            expires 7d;
            add_header Cache-Control "public, max-age=604800";
        }
    }
}
sendfile 可以减少静态文件在用户态和内核态之间的重复拷贝;open_file_cache 缓存文件描述符和元数据,适合小文件较多的场景。max=20000 只是参考值,文件数量较少时没有必要设置过大,否则会增加内存占用。
只有在文件名已版本化、内容不会被原路径覆盖的情况下,才适合使用 immutable。未版本化的 CSS、JS 或配置文件不宜设置很长的浏览器缓存,否则发布新版本后可能继续使用旧内容。
access_log off 可以减少静态资源日志带来的磁盘 I/O,但会降低访问审计能力。如果业务需要统计访问量或保留安全记录,应改为单独的低成本日志策略,而不是直接关闭所有日志。
文本类型资源适合 Gzip,JPEG、PNG、WebP、压缩包等已经压缩过的文件通常不应再次压缩。可以从中等压缩级别开始:
http {
    gzip on;
    gzip_vary on;
    gzip_min_length 1k;
    gzip_comp_level 4;
    gzip_types
        text/plain
        text/css
        text/javascript
        application/javascript
        application/json
        application/xml
        application/rss+xml
        image/svg+xml;
}
如果洛杉矶服务器的网络出口接近上限,而 CPU 仍有较多余量,可以提高压缩收益;如果 CPU 已经持续在 85% 以上,优先降低 gzip_comp_level,而不是继续增加 worker 或连接数。压缩后的响应大小、CPU 时间和发送带宽应同时观察。
动态代理可以采用以下参考配置:
proxy_cache_path /var/cache/nginx
    levels=1:2
    keys_zone=public_cache:50m
    max_size=2g
    inactive=10m
    use_temp_path=off;

upstream app_pool {
    server 127.0.0.1:8080;
    keepalive 64;
}

server {
    location / {
        proxy_pass http://app_pool;

        proxy_http_version 1.1;
        proxy_set_header Connection "";
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        proxy_connect_timeout 2s;
        proxy_send_timeout 15s;
        proxy_read_timeout 30s;

        proxy_buffering on;
        proxy_buffer_size 8k;
        proxy_buffers 8 16k;

        proxy_cache public_cache;
        proxy_cache_methods GET HEAD;
        proxy_cache_valid 200 30s;
        proxy_cache_lock on;

        proxy_cache_bypass $http_authorization $cookie_session;
        proxy_no_cache $http_authorization $cookie_session $upstream_http_set_cookie;

        proxy_cache_use_stale error timeout updating
            http_500 http_502 http_503 http_504;
    }
}
这几个超时参数含义不同:
proxy_connect_timeout 是 Nginx 与上游建立连接的等待时间。洛杉矶服务器和本机应用之间通常应较短;如果上游位于其他地区,应按实际 RTT 和丢包情况调整。proxy_send_timeout 是向上游发送请求时,两次写操作之间允许的最大间隔,不是整个上传请求的总时长。proxy_read_timeout 是等待上游返回数据时,两次读取之间允许的最大间隔,不是整个响应从开始到结束的总时间。如果某个接口需要执行 90 秒,不应简单地把全站 proxy_read_timeout 改成 120 秒。更合理的做法是只对该接口设置更长的超时,并检查应用是否应该改为异步任务。
proxy_buffering on 可以让 Nginx 先接收上游响应,再以更适合客户端的速度发送,避免慢客户端长期占住上游连接。对于 SSE、实时流式输出或大文件下载,应根据业务决定是否关闭缓冲;关闭后,客户端的发送速度会更直接地影响上游连接占用。
上面的缓存示例只适合不包含用户隐私、登录状态和个性化内容的 GET 或 HEAD 请求。以下内容不应直接使用公共缓存:
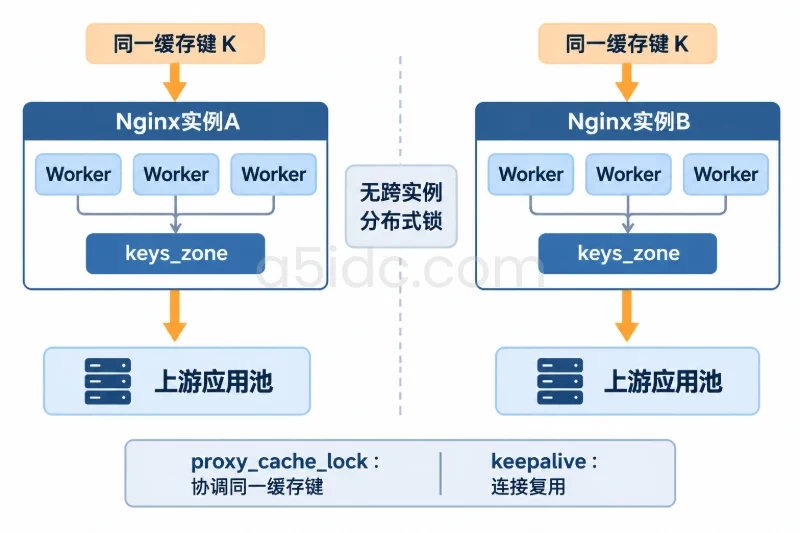
Set-Cookie 的请求;proxy_cache_lock on 可以减少缓存失效时的大量并发回源:第一个请求回源,其余请求等待同一个缓存对象生成。它适合公共热点内容,但不适合响应本身需要实时流式返回的接口。
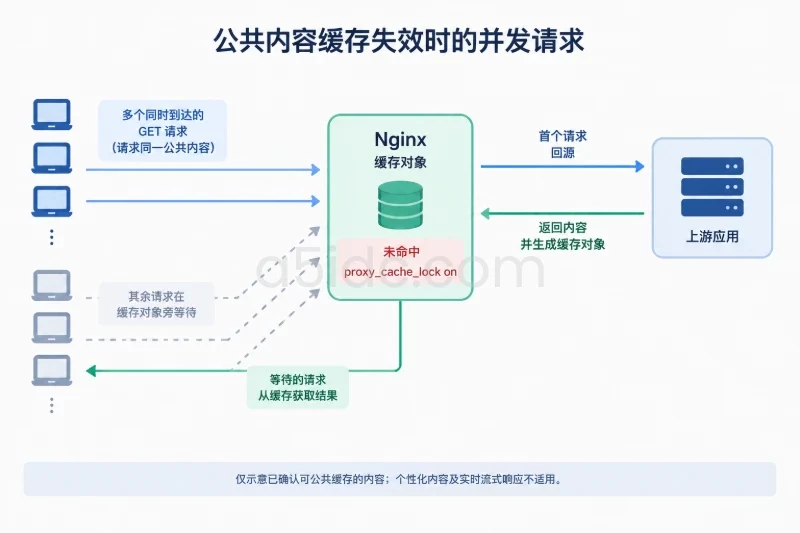
缓存命中后,如果源站 RPS 明显下降、上游 p95 降低而 Nginx CPU 和网络发送速率上升,说明压力可能从应用层转移到了网络层。此时还要检查带宽和缓存磁盘空间,不能只看源站响应时间。
A5idc数据提供美国物理服务器,涵盖常规 Xeon 和 AMD EPYC 等系列,可为面向美国用户的 Nginx 网站、接口服务及反向代理业务提供计算、内存和存储资源。其常规系列设有 CN2 GIA 线路方案,AMD EPYC 系列提供不同档位的内存与 NVMe 存储组合,能够对应缓存文件读写、动态请求处理和不同访问地区的网络资源需求。
下面是一组用于说明分析方法的模拟数据,不代表某台洛杉矶服务器的实测结果:
| 场景 | 配置前 RPS | 配置后 RPS | 配置前 p95 | 配置后 p95 | 关键变化 |
|---|---|---|---|---|---|
| 静态 JS,未压缩 | 4200 | 5900 | 46 ms | 29 ms | 文件缓存和发送路径更稳定 |
| 公共页面,缓存命中 | 780 | 2100 | 310 ms | 112 ms | 回源请求减少 |
| 动态接口,未缓存 | 620 | 660 | 780 ms | 710 ms | 上游仍是主要耗时 |
| 动态接口,慢上游 | 600 | 600 | 820 ms | 840 ms | Nginx 参数没有改变应用执行时间 |
结果解释应围绕瓶颈变化,而不是只看“配置后 RPS 变高”。
worker_connections 没有意义。listen backlog、somaxconn 和 tcp_max_syn_backlog。内核参数调整属于系统级变更,应先记录当前值、确认影响范围并安排回滚,不要把它作为 Nginx 高并发调优的第一步:
sysctl net.core.somaxconn
sysctl net.ipv4.tcp_max_syn_backlog
sysctl fs.file-max
如果确实观察到监听队列溢出,应一次只调整一个参数,完成压测后再决定是否保留。tcp_tw_reuse 等参数也不应在没有连接状态证据时直接开启,尤其不能用来掩盖应用端短连接和连接池配置问题。
正式变更前应备份当前配置,并确认配置文件路径和服务管理方式。不同发行版可能使用不同的 Nginx 用户名、配置目录和 systemd 服务定义,不应直接套用其他系统的路径。
sudo cp -a /etc/nginx/nginx.conf \
    /etc/nginx/nginx.conf.bak.$(date +%F-%H%M)

sudo nginx -t
sudo systemctl reload nginx
sudo systemctl status nginx --no-pager
nginx -t 通过后再 reload,通常比直接 restart 对现有连接的影响更小。变更后应观察至少一个完整业务高峰或一轮固定时长压测,重点关注:
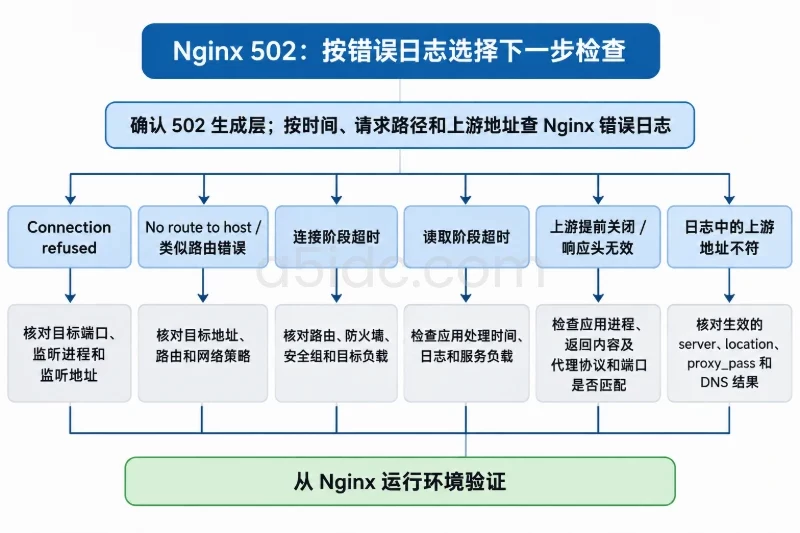
too many open files;upstream timed out、connect() failed;如果新配置导致错误率上升,应停止继续加压,恢复已确认的备份配置,重新执行 nginx -t 后再 reload。缓存目录、日志策略和权限配置也应单独检查,避免因为 Nginx 用户无法写入缓存目录而引发新的 5xx。
容量不应取压测中出现过的最高 RPS,而应取满足业务目标、资源有余量且长尾稳定的持续吞吐。可以按 10% 至 20% 的步长逐级增加并发或请求速率,每一级持续 5 至 10 分钟,记录 p95、p99、5xx、CPU、内存、I/O 和网络速率。
例如,业务要求 p95 不超过 300 ms:
这时不能把 1200 请求/秒称为可用容量。更稳妥的生产目标应落在 900 至 1100 之间,并根据是否需要 20% 至 30% 的突发余量确定实际上线值。如果瓶颈是上游响应时间,优先优化应用和数据库;如果是带宽,优先考虑压缩、静态资源缓存或边缘分发;如果是文件描述符和连接槽位,才调整 Nginx 连接上限。
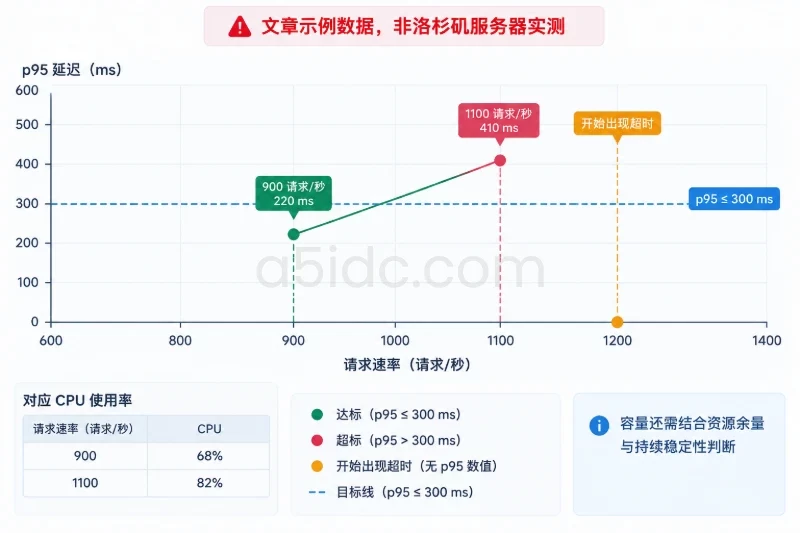
对于美国洛杉矶服务器,最终复测还应加入不同地区的客户端样本。只有在固定测试位置、固定缓存状态、固定请求比例和固定版本配置下重复测试,才能判断本次调整到底改善了 Nginx 连接处理能力,还是仅仅改变了网络路径或缓存命中率。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7936.html