香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


RTX 4090 标称 24GB 显存,但“能装下模型”不等于“能按业务要求持续响应”。一次请求需要多长的上下文、同时有多少人使用、首个字要等多久,都会改变推理体验;服务器的供电、散热和网络路径也可能先于算力成为瓶颈。
香港服务器搭载 RTX 4090,通常适合模型规模可控的文本生成、知识库问答、图像生成、语音转写和部分视觉理解服务,尤其适合需要面向香港及周边地区提供接口、希望用单卡先验证业务的团队。若业务要求大模型高精度常驻、长上下文高并发、严格的服务连续性,或需要稳定承载大批量视频生成,就不能仅凭一张 4090 的显存容量作决定。
RTX 4090 常见的关键规格是 24GB 显存和较高的单卡计算能力。对推理选型而言,显存回答的是“模型、运行时数据和并发请求能否同时留在 GPU 上”;计算能力影响“留在 GPU 上之后处理得有多快”。两者不能互相替代:算力有余而显存不足时,模型可能无法加载;显存刚好够用时,也可能因并发增加而出现排队或显存溢出。
还需要区分显存容量与显存带宽。文本生成通常包含处理输入提示词和逐词生成输出两个阶段。前者更容易受输入长度、计算量和批处理方式影响;后者需要反复读取模型权重及缓存,显存带宽和内存访问效率会影响生成速度。因此,同一张卡运行同一个模型,“短问题、短回答”与“长文档、多轮对话”不会有相同的延迟。
香港机房的位置则回答另一类问题:用户请求到服务器的网络路径、数据进出位置以及交付条件是否合适。它不会让 GPU 本身更快,也不能保证所有中国内地或海外用户都有相同的访问延迟。选型时应把GPU 推理时间和网络往返、上传下载时间分开测量。
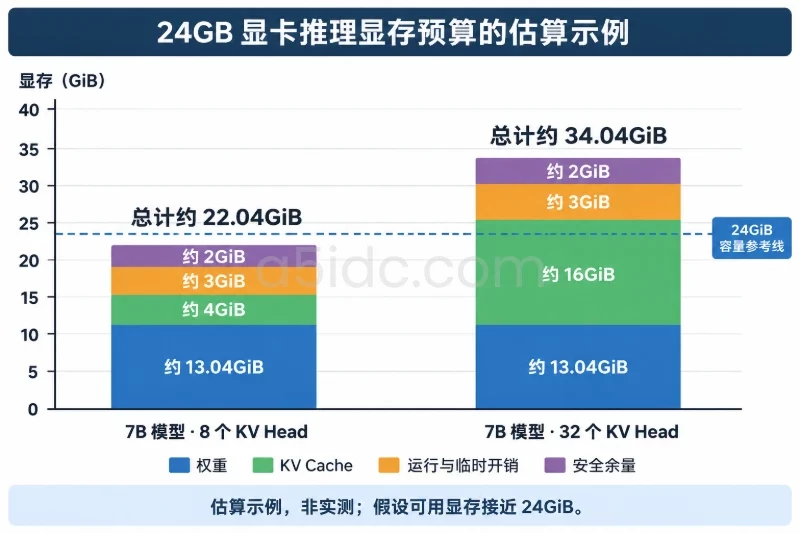
推理显存并非只存放模型权重。实际占用通常还包括推理框架与 CUDA 运行时、输入处理过程中的临时空间、注意力机制使用的 KV Cache,以及显存分配器预留和碎片。量化可以缩小权重,却不会让这些其他开销消失。
以下量级可用于初筛,不代表某个模型或在售服务器的实测占用:
| 模型与精度示例 | 仅权重的粗略量级 | 对单卡 24GB 的含义 |
|---|---|---|
| 8B 参数、FP16/BF16 | 约 16GB | 可能加载,但留给长上下文和并发的空间有限 |
| 8B 参数、4-bit 量化 | 约 4GB 原始权重量级,实际通常更高 | 更适合为缓存和并发留空间,仍需验证质量与框架开销 |
| 14B 参数、FP16/BF16 | 约 28GB | 仅权重就超过 24GB,不适合按单卡全量驻留规划 |
| 14B 参数、4-bit 量化 | 约 7GB 原始权重量级,实际通常更高 | 有机会运行,但可承载的上下文与并发需单独测量 |
| 32B 参数、4-bit 量化 | 约 16GB 原始权重量级,实际通常更高 | 即使能够加载,也容易被缓存和运行时开销挤压 |
“8B 参数、FP16 约 16GB”的计算依据是约 80 亿个参数、每个参数 2 字节;表中的 4-bit 数字同样只是按每参数半字节估算的原始权重。实际量化文件还可能包含比例因子等数据,不同模型结构和推理框架也会改变运行时占用。采购前应以指定模型、指定量化格式、指定框架版本加载后的显存读数为准,而不是以模型文件大小代替显存需求。
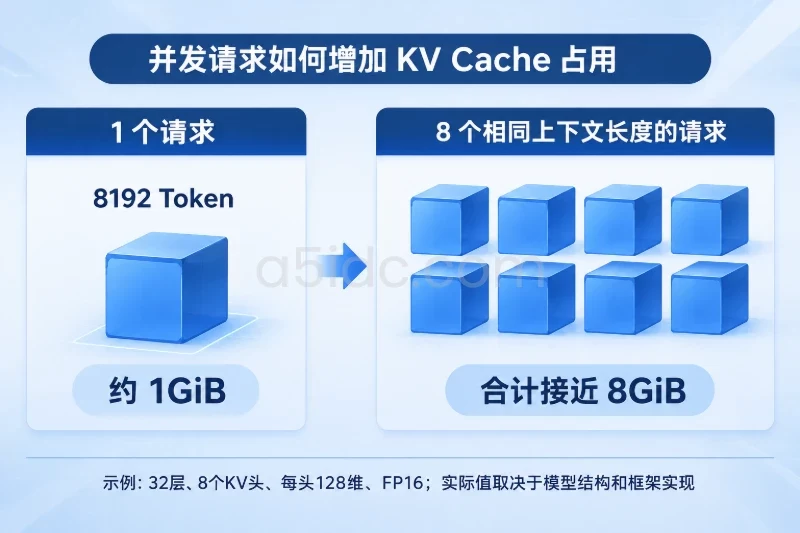
KV Cache 是另一项容易被低估的占用。以一种示例架构为例:32 层、8 个 KV 头、每头维度 128,缓存采用 2 字节精度,则每个 token 的缓存约为 2 × 32 × 8 × 128 × 2 = 131072 字节,即 0.125MiB。单条序列达到 8192 token 时,约占 1GiB;四条这样的活跃序列,缓存合计约 4GiB。实际模型结构、缓存精度和框架管理方式不同,数字也会变化,但规律不变:上下文长度与同时活跃的请求数,会共同消耗显存。
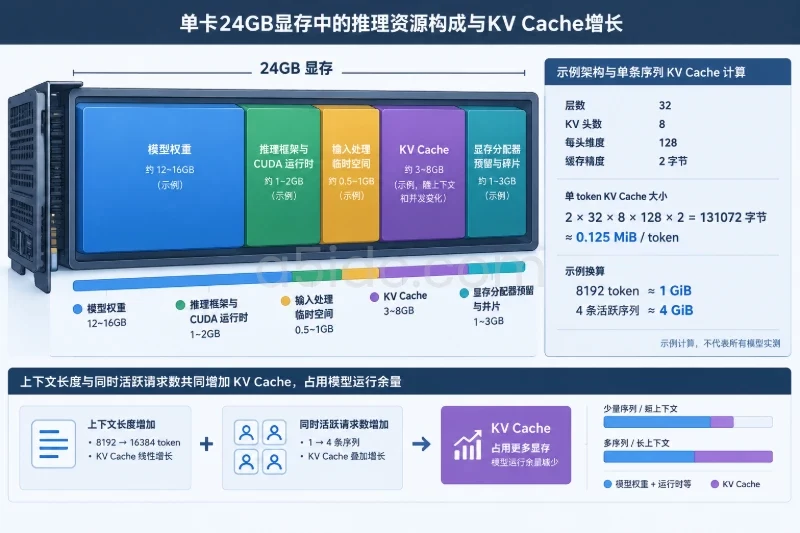
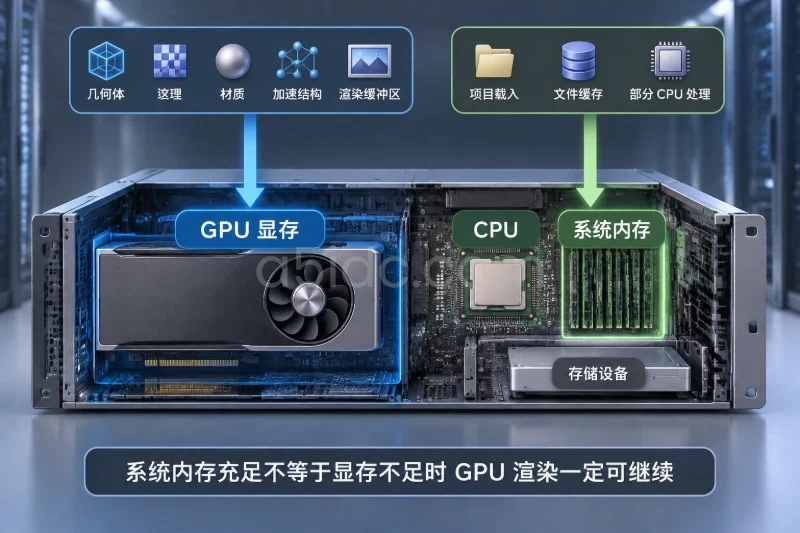
因此,模型宣传的最大上下文长度不等于服务器在该长度下仍能保持预期并发。把权重或缓存频繁转移到系统内存,可能使程序勉强运行,却显著拉高延迟;这不能视为与 GPU 显存常驻等价的方案。
企业知识库问答和轻量级文本接口是较典型的用途。7B~14B 量级模型采用合适的量化方式,配合限定的上下文长度和并发数,可以作为内部助手、客服辅助、文档摘要或结构化信息提取的候选方案。知识库检索本身还依赖 CPU、内存、存储及检索服务;GPU 主要承担模型推理,不会自动解决索引更新、资料质量和答案准确性问题。若要求引用可追溯,还应单独验证检索结果和模型输出。
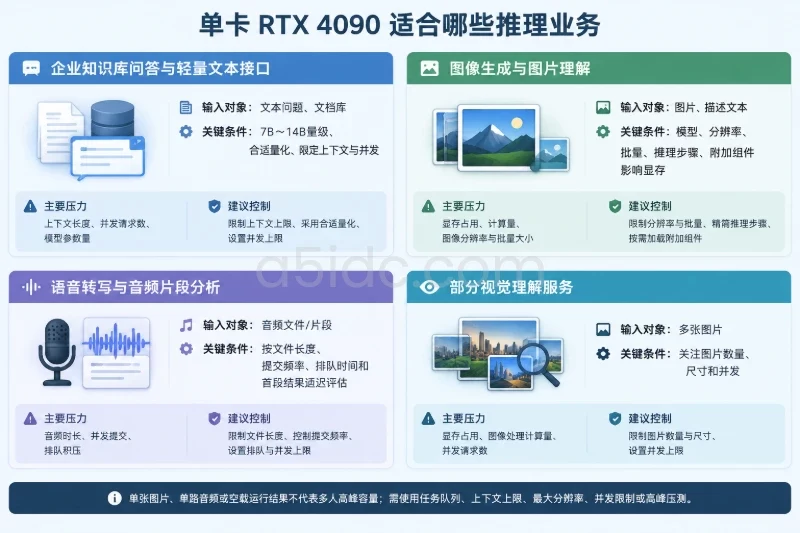
图像生成与图片理解也可以考虑单卡部署。图像生成的显存占用会随模型、分辨率、批量、推理步骤和附加组件改变;图片理解还可能受到输入图片数量与尺寸影响。单张图片生成快,不代表多人同时提交高分辨率任务时仍有相同体验。适合用任务队列、明确的最大分辨率和并发限制来控制等待时间,而不是只看空载下的一张图耗时。
语音转写、音频片段分析通常更适合按文件长度和提交频率评估。短音频实时或准实时处理,要关注请求排队及首段结果延迟;较长录音的离线转写,则要比较处理一小时音频所需的总时间。文件上传、音频解码和结果存储也要计入完整流程。若业务是全天候大量直播流同时转写,应先按流数和高峰时段压测,不能由单路运行结果推断容量。
这些业务共同的适用前提是:允许通过量化、任务队列、上下文上限或并发控制来换取可接受的成本与体验。如果业务要求“所有请求都立即处理、上下文很长、输出还很快”,单卡容量往往比模型能否启动更早成为问题。
A5idc数据提供香港 GPU 服务器,产品包括搭载 RTX 4090 和 A100 80GB 的配置,并配有服务器 CPU、内存与 NVMe 存储,可为模型推理、AI 应用和图像处理提供硬件资源。面向香港及周边用户部署推理服务时,香港 GPU 系列也有 CN2 线路配置;对于从单卡模型运行到更高显存需求的不同任务,可结合相应显卡与整机资源形成部署基础。
需要 14B 以上模型以 FP16/BF16 精度完整驻留显存,或运行更大模型且不接受量化质量变化时,应先评估更大显存的 GPU。多卡也不是简单把两张卡的显存相加:模型切分需要框架支持,卡间数据交换会影响延迟,还要核对主板通道、机箱空间、供电和散热。
长上下文、高并发、严格尾延迟同时存在时,同样要谨慎。平均每秒处理的 token 数可能看起来足够,但高峰期部分请求的首 token 等待时间会明显增长。对外提供有明确服务等级要求的接口,还需考虑故障替换、驱动兼容性和备件安排;消费级显卡的单卡算力,不能替代整套服务连续性设计。
视频生成、较长时段的视频理解等任务,可能同时放大显存、GPU 计算、临时存储和任务时长的压力。若作业无法拆分,或者必须在很短时间内批量完成,应按完整作业测试,不宜用单帧或短片段结果外推。
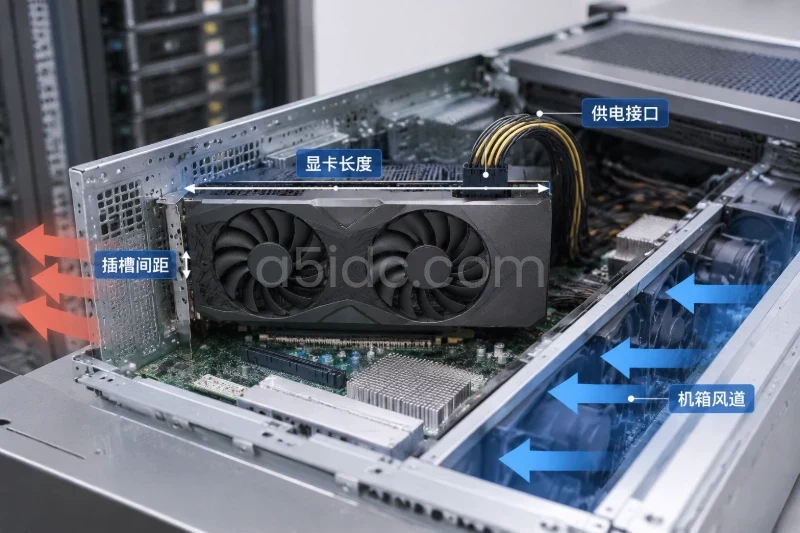
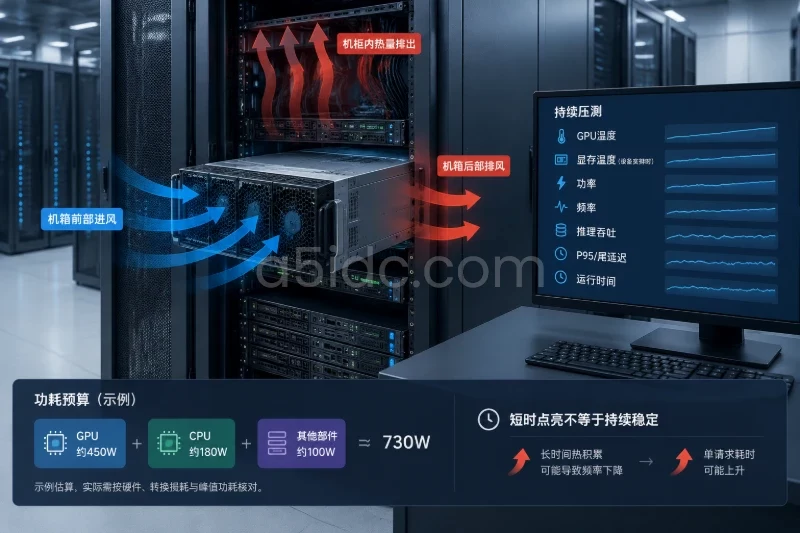
RTX 4090 的具体功耗取决于显卡版本、功率限制和实际负载;评估机房条件时,可把约 450W 作为高功耗单卡的参考量级,而不是认定每张卡始终消耗 450W。供电预算还要叠加 CPU、内存、硬盘、风扇等部件,并为瞬时功耗变化留余量。例如按 GPU 450W、CPU 180W、其余部件 100W 估算,整机部件功耗已约 730W;电源选型仍需结合实际硬件、转换损耗及峰值功耗核对,不能只按 730W 配置。
进入服务器的电能最终大部分转化为热量。散热判断因此至少有三层:显卡自身散热器能否在机箱内获得足够进风;机箱能否把热风有效排出;机柜及机房能否持续带走热量。开放环境下表现正常的显卡,放入风道受限的机箱或密集机柜后,未必还能保持相同频率。双卡、高功率 CPU 或相邻设备的热风回流,会进一步改变结果。
验收时不应只运行几分钟,看见温度没有触顶就结束。更有用的是在预计的最高并发下持续运行,观察 GPU 温度、显存温度(设备支持时)、功率、频率以及是否出现降频,同时记录推理吞吐和尾延迟。如果运行一段时间后频率下降、每请求耗时上升,即使服务没有报错,也说明当前散热条件可能不足以支撑承诺的业务容量。风扇长期处于高转速还涉及噪声、维护和部件寿命,需结合机房托管条件评估。
面向香港及周边地区的用户、需要在香港接入业务系统,或需要就近调用当地数据源时,香港服务器有明确的部署价值。但跨境访问质量取决于用户所在地、运营商、接入线路、时段和双向路由。推理接口应分别测请求上传、首字节或首 token 返回、持续输出,以及结果下载;只测一次网络往返延迟不足以代表使用体验。
传输量较大的业务尤其需要把带宽纳入预算。比如上传一个十进制口径的 10GB 模型文件,在可持续获得 100Mbps 有效传输速率且暂不计协议开销时,理论传输时间为 10 × 8 × 1000 ÷ 100 = 800 秒,约 13 分 20 秒。这里的 GB 是字节、Mbps 是每秒兆比特;实际传输还会受到共享带宽、线路、丢包和存储写入速度影响。模型日常推理的短文本响应未必受同样程度影响,但图片、音频、模型更新和备份可能受影响明显。
数据能否放在香港处理,也不能仅从技术延迟判断。涉及个人信息、行业数据或客户合同约定时,应先核对数据存放、传输和访问要求,再决定部署位置。
向 A5IDC 咨询香港 GPU 服务器时,先确认交付的是哪一版显卡、是否独享、CPU 与内存配置、存储性能、带宽计量及方向、机箱供电散热条件,以及故障处理和硬件更换安排。不要把“搭载 RTX 4090”直接理解成显存、网络和持续功耗条件都已满足。
随后用真实请求构成验收样本,而非只跑模型的默认演示:
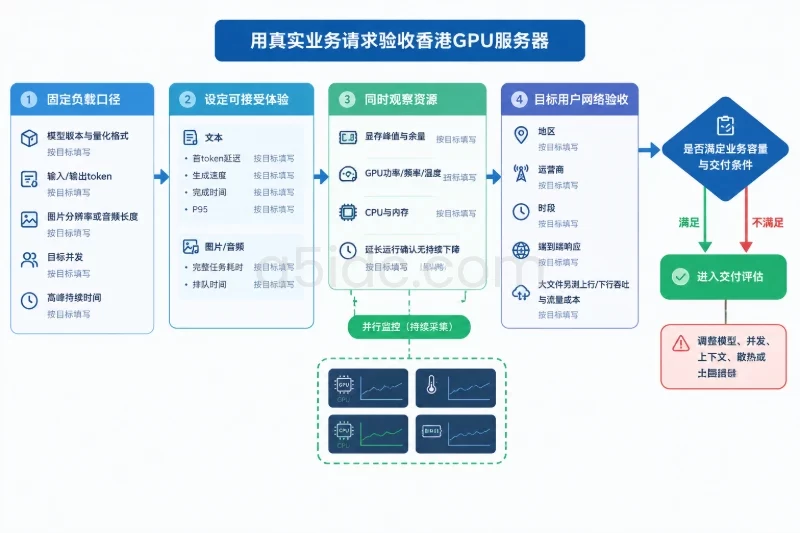
例如,某知识库接口计划使用量化后的 8B 模型,每次输入约 2000 token、输出约 300 token,高峰同时有 4 个活跃请求。此时应先验证四路请求的显存峰值和 P95 首 token 延迟,再决定是否提高上下文上限或并发,而不是因为模型单独运行只占一部分显存,就直接开放更长上下文。若压测中显存充足但请求仍排队,应检查计算吞吐与调度;若空载很快、持续运行变慢,应重点检查散热和功率限制。
选择方法可以概括为从业务倒推:先定模型质量要求、请求形态、并发和可接受延迟,再求出显存与持续算力需求;接着用用户分布决定香港网络是否合适,最后用长时间压测确认供电、散热和交付条件。只有这些条件同时成立,24GB 显存才是可用的业务容量,而不只是规格表上的数字。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7838.html