香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


把 -Xmx 设为 4 GB,并不意味着 Java 进程最多只会占用 4 GB。监控中看到进程使用了 6 GB,也不一定说明堆内存泄漏:-Xmx 限制的是 Java 堆的最大容量,不是整个进程的内存上限。
通常所说的“JVM 堆外内存”,是指 Java 堆之外由 JVM、类库或本地代码使用的内存。判断时要把堆内存、堆外分配、进程驻留内存和容器内存分开看;它们的统计口径不同,不能仅凭一个数字相减,就断定多出的部分都是堆外内存。
堆内存用于存放 Java 对象和数组,由垃圾回收器管理。-Xms 和 -Xmx 分别设置初始堆大小和最大堆大小。堆已提交但暂时没有对象使用的部分,也可能计入进程的已提交内存或虚拟地址空间,因此堆容量、堆已用量和操作系统看到的进程内存不是同一指标。
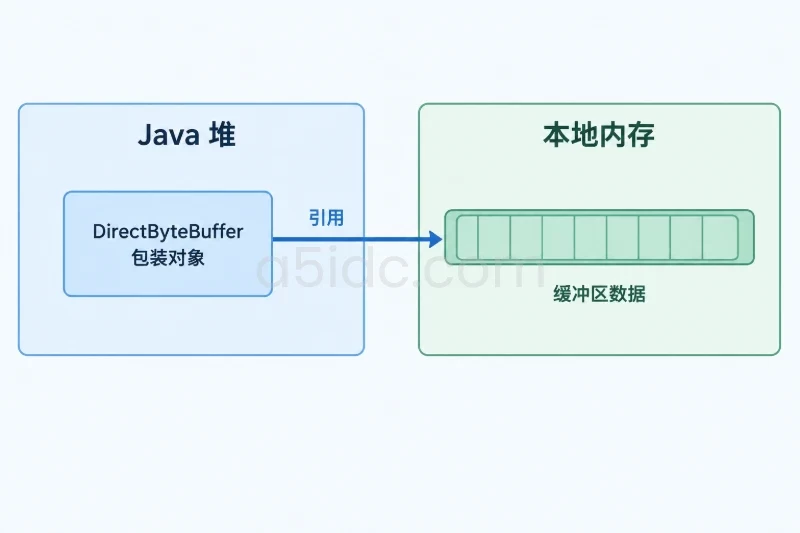
堆外内存通常指 Java 堆之外的本地内存分配。它不由普通 Java 对象的垃圾回收直接管理,但部分分配会由 Java 对象持有引用,待对象不可达后再通过清理机制释放。直接字节缓冲区就是常见例子:ByteBuffer 这个包装对象在堆上,缓冲区的数据则可以位于堆外。
除此之外,JVM 进程还会使用类元数据、线程栈、JIT 编译代码缓存、JNI 或其他本地库分配的内存。日常排查时,这些部分常被统称为“堆外”或“本地内存”,但它们的用途和管理方式并不相同。比如,元空间用于存放类元数据,线程栈服务于线程执行;不能把它们都当成直接缓冲区问题处理。
| 指标或区域 | 表示什么 | 常见观察方式 |
|---|---|---|
| Java 堆已用量 | 堆中当前存活或暂未回收的对象占用 | JMX、GC 日志、jstat |
| Java 堆已提交量 | JVM 已向系统提交、可供堆使用的容量 | JMX、jcmd、GC 日志 |
| 直接缓冲区 | 通过直接缓冲区使用的堆外数据空间 | BufferPoolMXBean、应用指标 |
| 元空间、线程栈、代码缓存 | JVM 的不同本地内存区域 | NMT、JMX、JVM 参数 |
| 进程 RSS | 当前驻留在物理内存中的进程页面,含堆和非堆页面 | /proc、ps、smaps |
| 容器内存用量 | 容器控制组统计的内存,口径受系统和配置影响 | cgroup 指标、容器监控 |
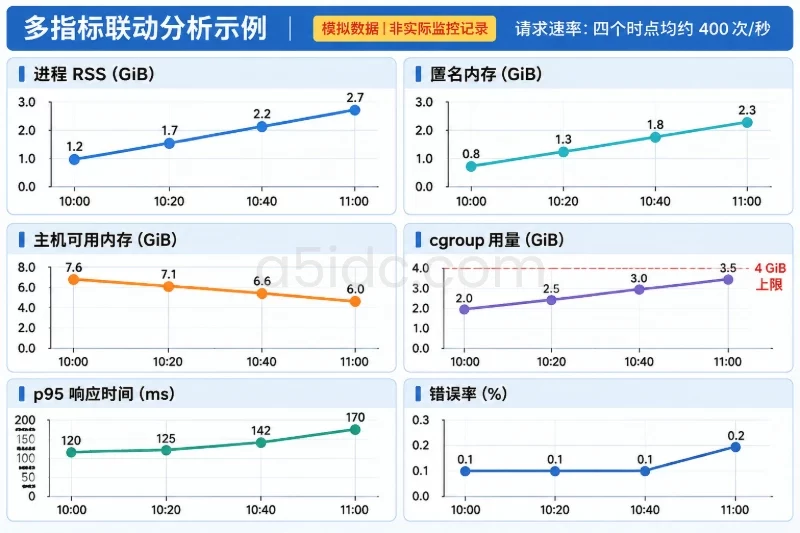
这些指标不能简单相加。例如,RSS 已包含进程中驻留的部分堆页面;如果再把堆已用量加到 RSS 上,就会重复计算。反过来,进程的虚拟地址空间或已提交内存也不代表这些内存都已经驻留在物理内存中。
网络 I/O、文件 I/O 等场景可能使用直接缓冲区,减少数据在 Java 堆缓冲区与本地 I/O 缓冲区之间复制的需求。应用创建的 DirectByteBuffer 包装对象属于堆内对象,而实际缓冲区数据可以位于本地内存。
这类缓冲区并非“脱离 JVM 管理、永不释放”。Java 对象被回收后,关联的本地空间可以通过清理机制释放,但释放时机不一定与对象变为不可达的时刻完全同步。若应用大量创建短生命周期的直接缓冲区,回收与清理跟不上分配速度时,可能出现堆还没有耗尽、直接内存却已逼近限制的情况。
-XX:MaxDirectMemorySize 可用于限制直接缓冲区等相关分配的容量,但其行为和默认值可能受 JDK 实现及版本影响,不宜仅根据参数缺省就假定上限是多少。应结合运行时参数、JDK 版本和直接缓冲区指标确认。
在常见的 HotSpot JVM 中,Java 8 起类元数据主要使用元空间;类加载、动态代理、脚本引擎或频繁部署卸载等行为,都可能影响相关用量。元空间是本地内存区域,不属于 Java 堆。它的上限可由 -XX:MaxMetaspaceSize 控制,但是否应设置以及设置多大,要结合应用的类加载行为判断。
每个线程通常还需要线程栈。线程数量增加时,栈的预留空间及实际使用会增加;-Xss 设置的是单个线程的栈大小参数之一,但不能把线程数直接乘以 -Xss 当作 RSS 的精确值,因为预留、提交和驻留并非一回事。线程池无限增长或线程泄漏,可能使本地内存压力上升,即使堆中对象看起来不多。
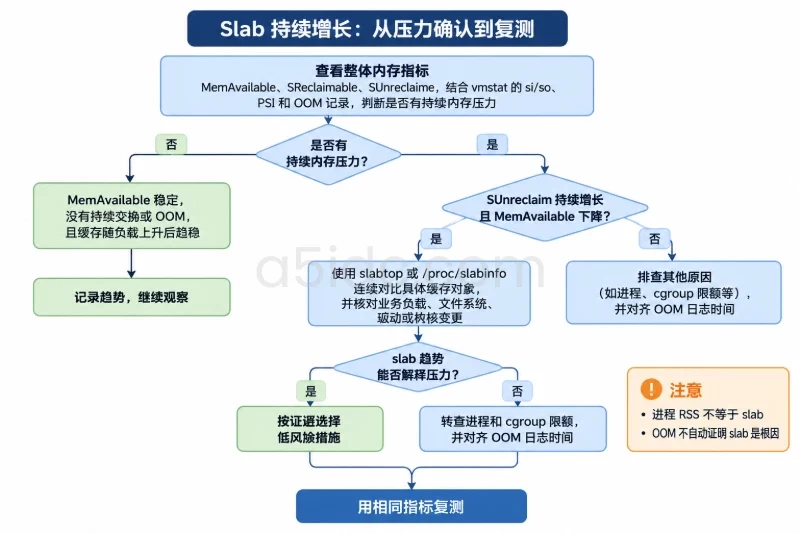
JIT 编译生成的机器码及相关数据会占用代码缓存。JNI、本地加密或压缩库、内存分配器,以及 mmap 映射的文件,也可能带来额外内存使用。并不是所有这些分配都能被 JVM 的同一项指标完整统计。
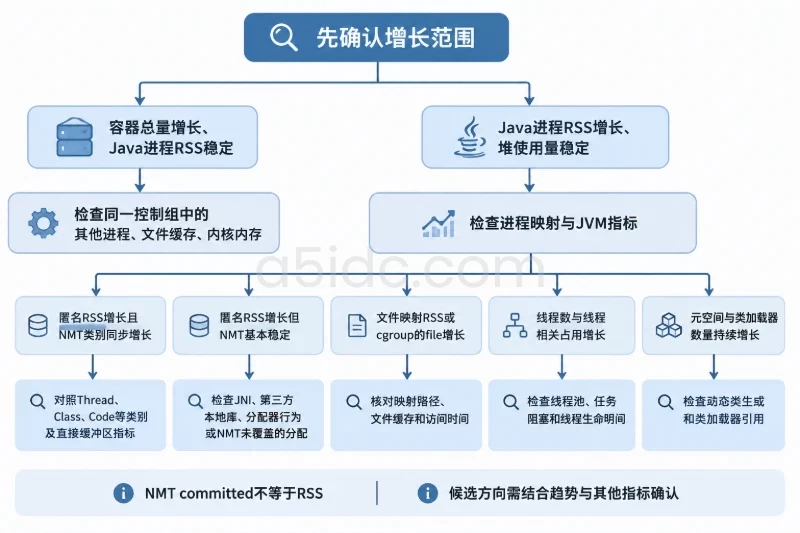
首先看堆的已用量和已提交量差异。例如,堆最大值为 4 GB、当前堆已用 1.5 GB,并不代表 JVM 只向系统使用了 1.5 GB;已提交的堆可能更大。反之,最大堆为 4 GB,也不表示 JVM 启动后立即将 4 GB 全部驻留到物理内存。
其次看线程和类加载规模。线程数上升会增加栈相关开销;大量类加载、动态生成类或类加载器未能释放,则可能使元空间使用增加。此类问题通常需要同时观察线程数、类加载器行为和元空间变化,而不是仅凭堆曲线推断。
再次看本地库和映射文件。某些库会自行分配内存,不一定纳入直接缓冲区指标;文件映射也可能让进程 RSS 增加。内存分配器还可能保留已经申请的内存,导致业务对象释放后 RSS 没有立即下降。RSS 不下降本身不能证明存在持续泄漏。
最后要区分进程指标与容器指标。容器的内存统计可能包含进程之外的其他用量,具体还受操作系统、cgroup 版本和监控采集口径影响。容器出现内存限制告警,不一定意味着 JVM 堆已经接近 -Xmx;需要一并查看容器内存、进程 RSS、堆与本地内存指标。
Java 服务的进程内存不仅由堆占用决定,线程栈、直接缓冲区和其他本地分配也需要相应的资源空间。A5idc数据提供香港、美国、日本等地区的物理服务器,涵盖不同内存容量、CPU平台与SSD或NVMe存储配置,可为运行Java应用、数据库及多任务服务提供硬件资源基础,支持按部署地区和业务负载组合计算与存储资源。
建议至少同时观察三类数据:堆使用情况、JVM 本地内存分类、操作系统或容器的进程内存。先确认它们来自同一进程、同一时间段,并记录 JDK 版本和容器限制,避免把不同时间或不同统计口径的数据拼在一起。
Linux 上可使用 jstat 查看 GC 与堆区域统计,进程号替换为实际 PID:
jstat -gcutil <PID> 1000 5
输出中的各列会显示不同堆区域的使用比例和 GC 次数,具体列名及表现应以所用 JDK 版本的 jstat 文档为准。也可以通过应用的 JMX 指标或 GC 日志观察堆已用量、已提交量和回收后的变化。
如果 GC 后堆使用长期维持在较高水平,应进一步分析 Java 对象和引用关系;如果堆使用不高但进程 RSS 持续偏高,才需要重点检查本地内存区域。两种现象可以同时发生,不能只凭其中一项排除另一类问题。
HotSpot 的 Native Memory Tracking(NMT)需要在 JVM 启动时启用。可在启动参数中加入:
-XX:NativeMemoryTracking=summary
随后通过同一用户权限下的 jcmd 查看摘要:
jcmd <PID> VM.native_memory summary scale=MB
如果需要更细的分类,可在启动时使用 -XX:NativeMemoryTracking=detail,并按需查询详细信息。详细模式带来的开销通常高于摘要模式,是否启用应结合生产环境要求评估。NMT 不能在 JVM 已运行后补开;若启动时没有启用,需要在合适的维护窗口调整启动参数并重启后再采集。
部分版本支持建立基线并查看差异,便于比较一段时间内的变化:
jcmd <PID> VM.native_memory baseline
jcmd <PID> VM.native_memory summary.diff scale=MB
NMT 展示的是 JVM 能追踪到的内存分类,不等于进程全部物理内存清单。它对某些第三方本地库分配、操作系统页面缓存等内容可能无法完整覆盖,因此 NMT 汇总与 RSS 不相等是可能的。
应用可通过 JMX 的 BufferPoolMXBean 观察直接缓冲区池的数量、容量和使用量。若该指标随时间持续增长,可进一步检查直接缓冲区创建、释放方式以及对应的 I/O 负载。它反映的是相关缓冲区池指标,不代表全部堆外内存。
在 Linux 上,可查看进程状态及内存映射汇总:
grep -E 'VmRSS|VmSize|VmHWM|Threads' /proc/<PID>/status
cat /proc/<PID>/smaps_rollup
VmRSS 是进程当前驻留内存的近似统计,VmSize 是虚拟地址空间规模,两者含义不同。smaps_rollup 的可用性取决于内核版本和权限;如果系统不支持该文件,应检查对应进程的 smaps,或使用系统提供的进程内存工具。共享页面、映射文件和采集时点都会影响结果。
若 JVM 运行在容器中,还需同时检查该容器的内存使用和限制,并确认监控系统采用的是工作集、RSS 还是其他口径。操作系统命令看到的进程值与容器面板值可能不完全一致,不能仅凭差额认定某一项为 JVM 泄漏。
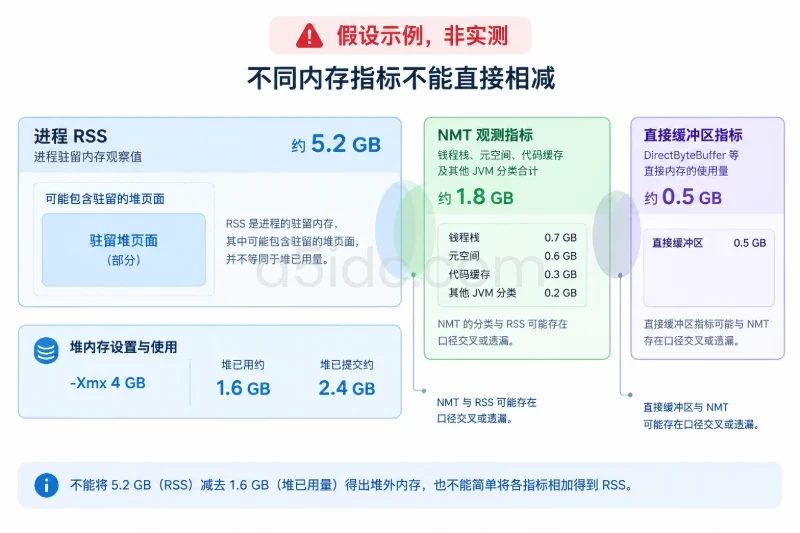
假设某进程配置了 -Xmx4g,采样时堆已用约 1.6 GB、堆已提交约 2.4 GB,RSS 约 5.2 GB;NMT 显示线程栈、元空间、代码缓存及其他 JVM 分类合计约 1.8 GB,直接缓冲区指标约 0.5 GB。
这些数值只用于说明判断方法,不是实测数据。此时不能用 5.2 - 1.6 = 3.6 GB 直接认定“堆外内存是 3.6 GB”,因为 RSS 中也包含已驻留的堆页面,NMT 与直接缓冲区统计还可能存在口径交叉或遗漏。更稳妥的做法是连续采样:
-Xmx 不是 JVM 进程的总内存上限;堆转储通常主要用于分析 Java 堆对象,也不能完整还原本地内存的分配来源。NMT 不是所有 native 分配的全量追踪器,直接缓冲区指标也不能代表所有堆外内存。RSS 是物理驻留页面的观察值,既不是 Java 堆用量,也不总能准确归因到某个 JVM 子系统。
因此,判断“堆外内存是否异常”至少要明确:比较的是什么指标、采集时间是否一致、JDK 和运行环境是什么、变化是否持续,以及哪些内存分类能够解释变化。堆增长优先分析对象和 GC;本地分类或直接缓冲区增长,按相应区域继续核查;只有 RSS 或容器指标偏高而 JVM 分类无法解释时,才应把调查范围扩展到本地库、映射页面和系统统计口径。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7791.html