香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


韩国服务器出现 No space left on device、Disk quota exceeded 或服务写入变慢时,不能只看 df -h 的磁盘百分比。真正的限制可能来自文件系统容量、inode 数量、用户或组配额、XFS project quota、容器存储层,也可能是日志持续增长、已删除但仍被进程打开的文件,甚至是远程挂载的存储端已经超限。
定位时应先确认报错发生在哪个挂载点,再分别核对块容量、inode、用户配额和目录内容。repquota 或 xfs_quota 用于回答“哪个用户或配额类型超限”,du 和 find 用于回答“哪些目录和文件占用空间”,lsof +L1 用于排查“为什么 df 显示已满而 du 看起来没有那么大”。下面的终端结果均为示例,不代表已在某台韩国服务器上执行。
常见现象与下一步并不是一一对应关系,可以先按下表缩小范围:
| 观察到的现象 | 优先怀疑对象 | 下一步检查 |
|---|---|---|
No space left on device | 文件系统块容量、inode、远程挂载、容器存储层 | df -hT、df -ih、findmnt -T |
Disk quota exceeded | 用户、组或项目配额达到硬限制 | quota、repquota、xfs_quota |
| 磁盘还有几十 GB,但无法创建小文件 | inode 用尽、目录配额或用户 inode 配额 | df -ih、quota inode 字段 |
df 接近 100%,但 du 总量明显较小 | 已删除文件仍被进程打开、隐藏挂载、快照或文件系统保留空间 | lsof +L1、findmnt、LVM 检查 |
| 磁盘使用率不高,但写入超时或服务响应变慢 | I/O 延迟、设备队列、文件系统错误、远程存储延迟 | iostat、vmstat、内核日志 |
| 只有某个应用账号无法写入 | 用户配额、目录权限、应用专用目录限制 | quota -u、namei -l、目录级统计 |
其中,“磁盘空间不足”和“配额超限”是两个不同层面。一个用户可能在整个文件系统仍有空闲空间时,先达到自己的 soft limit 或 hard limit;反过来,用户配额正常,也可能因为整个文件系统没有可分配的块或 inode 而写入失败。
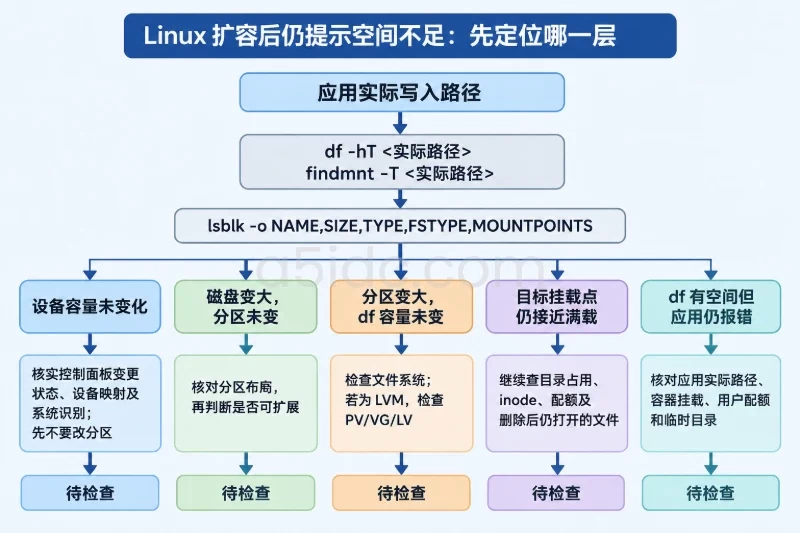
先确定问题路径。例如,应用写入 /var/lib/appdata,日志写入 /var/log,临时文件写入 /tmp,不能只检查根目录 /。
sudo df -hT
sudo df -ih
sudo findmnt -T /var/lib/appdata
sudo findmnt -T /var/log
sudo quota -s
sudo repquota -aug
如果系统没有 quota 或 repquota,先确认工具是否存在,不要直接根据发行版名称猜安装包:
command -v quota
command -v repquota
command -v xfs_quota
建议同时记录检查时间、主机名和当前时区。韩国服务器上的业务日志可能使用 KST(UTC+9),系统、容器或第三方应用也可能使用 UTC。时间不一致会导致“日志增长发生在什么时候”的判断偏移。
hostname
date -Ins
timedatectl status 2>/dev/null || true
磁盘异常可以按四个层级组织:
这个原因树的作用是避免把所有 No space left on device 都归因于“磁盘买小了”。例如,inode 用尽时扩容块容量不一定有效;用户配额触顶时只增加文件系统容量也不一定能让该用户继续写入;远程挂载超限时,客户端上的 du 统计也可能不能代表存储端实际计费结果。
df -hT 查看数据块容量,df -ih 查看 inode。两者应同时检查:
sudo df -hT /var/lib/appdata
sudo df -ih /var/lib/appdata
示例结果:
Filesystem     Type  Size  Used Avail Use% Mounted on
/dev/vdb1      ext4   200G  186G   4G   98% /var/lib/appdata

Filesystem      Inodes   IUsed   IFree IUse% Mounted on
/dev/vdb1       13107200 860000 12247200    7% /var/lib/appdata
这个示例表示块容量接近用尽,但 inode 仍然充足。若结果相反,例如 IUse% 达到 100%,而 Avail 仍有几十 GB,则重点应转向大量小文件、缓存碎片、邮件队列、会话文件或临时目录。
查看文件系统类型和挂载参数:
sudo findmnt -no TARGET,SOURCE,FSTYPE,OPTIONS -T /var/lib/appdata
常见判断方式如下:
ext4 通常使用传统用户、组配额配置,具体是否启用要看挂载参数和 quota 工具状态。xfs 需要优先使用 xfs_quota 查看用户、组或 project quota。overlay、overlay2 等容器存储层应继续追踪其宿主机目录和容器写层。nfs、nfs4 或 cifs 表示容量和配额可能由远程存储端决定,客户端的本地判断不一定完整。如果挂载点显示为只读,或者内核日志出现文件系统错误,不能继续通过反复重试写入来验证:
sudo dmesg --level=err,warn | tail -n 100
sudo journalctl -k -p warning..alert --since "-2 hours"
出现 EXT4-fs error、XFS ... metadata corruption、Remounting filesystem read-only 等信息时,应先备份重要数据并保留现场,联系有控制台或救援环境权限的运维人员。不要在仍然挂载并持续写入的文件系统上直接运行 fsck;离线修复通常需要停止相关服务、卸载文件系统或进入救援系统,影响范围和回滚方案必须提前确认。
如果路径位于 LVM 逻辑卷,文件系统内部有空闲空间,不代表卷组或快照一定健康:
sudo lsblk -f
sudo lvs -a -o vg_name,lv_name,lv_size,attr,data_percent,metadata_percent,origin
sudo vgs
sudo pvs
快照 data_percent 或 metadata_percent 持续接近上限,可能影响快照可用性和写入性能。不要因为名称中包含 snapshot 就直接删除逻辑卷;删除快照可能影响备份、恢复或数据库一致性。应先确认快照的创建者、用途、保留策略以及删除后的回滚方式。
查看挂载参数和系统配置:
sudo findmnt -no TARGET,FSTYPE,OPTIONS -T /var/lib/appdata
sudo grep -R -E 'quota|usrquota|grpquota|uquota|gquota|prjquota|pquota' \
  /etc/fstab /etc/default 2>/dev/null
不同文件系统和发行版的参数名称可能不同,不能仅凭 /etc/fstab 中没有 usrquota 就认定配额未启用,也不能在生产环境直接执行 quotacheck 或 quotaon。这些操作可能需要扫描整个文件系统,并在高负载、大量文件或数据库目录上造成额外 I/O。
对于传统 quota 工具,可以查看全部用户和组的概况:
sudo repquota -aug
查看某个用户:
sudo quota -u alice -s
示例输出:
Disk quotas for user alice:
Filesystem  blocks   quota   limit   grace   files   quota   limit   grace
/dev/vdb1   9.8G     10G     10.5G            185000   200000  210000
这里需要分别看两组字段:
blocks 反映已占用的数据块,可能先触发容量限制。files 反映文件和目录数量,可能先触发 inode 或文件数限制。quota 通常对应 soft limit,超过后可能进入 grace period。limit 通常对应 hard limit,达到后新写入会被拒绝。grace 表示 soft limit 超出后的宽限时间,不应当当作可长期使用的空间。repquota 中如果只看到用户块数正常,但应用仍报配额错误,还要检查组配额、project quota 和实际写入的挂载点。
确认文件系统为 XFS 后,可先检查 quota 状态:
sudo xfs_quota -x -c 'state' /var/lib/appdata
sudo xfs_quota -x -c 'report -h' /var/lib/appdata
sudo xfs_quota -x -c 'report -h -u' /var/lib/appdata
如果应用使用目录级 project quota,还需要确认项目配置和项目 ID。XFS project quota 的限制可能作用于一个目录树,而不是某个 Linux 用户,因此“找不到超限用户”并不代表不存在配额限制。
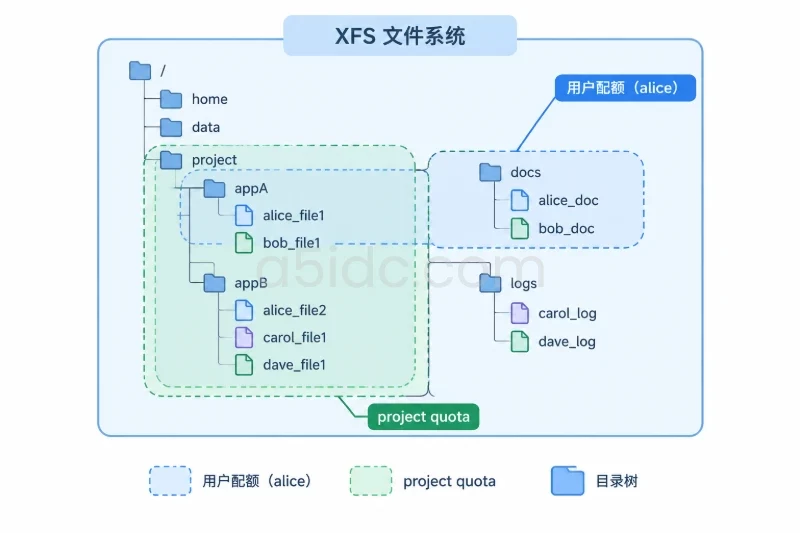
配额命令能指出用户,但不能直接告诉你哪些目录造成了使用量。先从实际挂载点的一级目录开始:
sudo du -xhd1 /var/lib/appdata 2>/dev/null | sort -h
-x 表示不跨越其他文件系统,避免把 /var/lib/appdata 下的另一个挂载点混入统计。发现大目录后,再逐级缩小范围:
sudo du -xhd1 /var/lib/appdata/uploads 2>/dev/null | sort -h
sudo du -xhd1 /var/lib/appdata/cache 2>/dev/null | sort -h
检查单个文件时,可先列出较大的普通文件:
sudo find /var/lib/appdata -xdev -type f \
  -printf '%s\t%u:%g\t%p\n' 2>/dev/null |
  sort -nr | head -n 30
输出中的第一个字段是文件逻辑大小,适合发现大文件,但不一定等于文件系统实际分配的块数。稀疏文件、压缩文件、预分配文件和硬链接都可能导致 find、du 与 quota 的数字存在差异,因此配额的精确结果仍以对应文件系统的 quota 统计为准。
GNU du 支持 --inodes 时,可以查看目录树中 inode 数量:
sudo du -x --inodes -d 1 /var/lib/appdata 2>/dev/null | sort -n
如果该参数不可用,可使用 find 做近似计数:
sudo find /var/lib/appdata -xdev -type f 2>/dev/null | wc -l
sudo find /var/lib/appdata -xdev -type d 2>/dev/null | wc -l
下列目录经常造成 inode 快速消耗:
如果一个目录只占用几 GB,却包含数百万个小文件,删除或压缩少量大文件不会解决 inode 问题,必须定位小文件的生命周期和清理策略。
df 与 du 不一致这是 Linux 磁盘满而目录统计偏小的常见原因。文件名已经从目录中删除,但进程仍持有文件描述符,空间要等进程关闭该描述符后才会释放:
sudo lsof -nP +L1
示例:
COMMAND   PID  USER  FD   TYPE DEVICE  SIZE/OFF NLINK  NAME
java    18420  app   42w   REG  252,1  8589934592     0  /var/log/app.log (deleted)
这个结果表示 Java 进程仍然打开一个约 8 GiB 的已删除日志。正确处理方式通常是确认日志轮转机制后,对对应服务执行受控 reload 或 restart,而不是直接终止任意进程。
sudo systemctl status app.service
sudo systemctl reload app.service
只有在确认该服务支持 reload 且 reload 会关闭旧文件描述符时才适合使用;若不支持,应在维护窗口内重启。重启可能造成连接中断、任务重放或缓存丢失,操作前应备份配置、确认服务依赖,并准备原命令或控制台启动方式作为回滚手段。
重启或 reload 后再次确认:
sudo lsof -nP +L1
sudo df -hT /var/log
如果某个目录曾经被写入大量文件,之后又在该目录上挂载了新文件系统,挂载点下面的旧数据仍然占用原文件系统,但普通 du 可能只看到当前挂载内容。使用以下命令对比挂载关系:
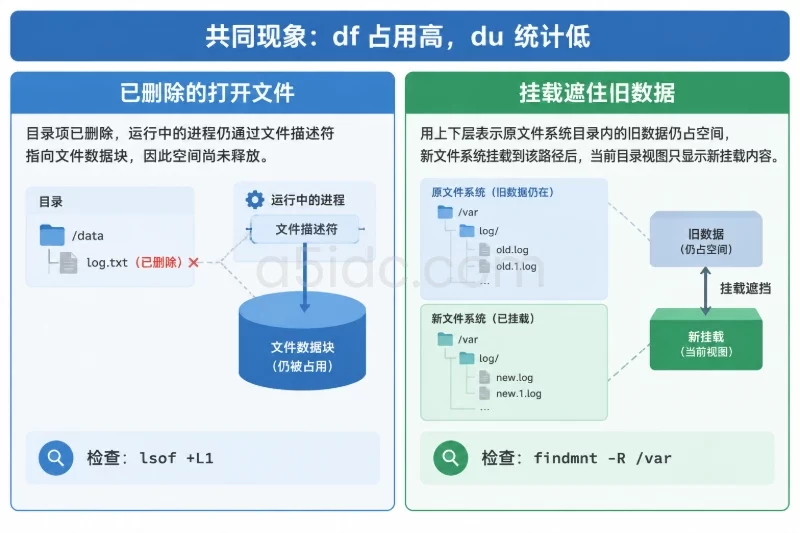
sudo findmnt -R /var
sudo du -xhd1 /var 2>/dev/null | sort -h
sudo df -hT
不要直接卸载生产挂载点来“验证”是否有隐藏数据。卸载可能导致应用读写失败,且容器、数据库或日志服务可能持有该路径。应先梳理依赖,必要时在维护窗口或救援环境中处理。
先做只读统计:
sudo journalctl --disk-usage
sudo du -xhd1 /var/log 2>/dev/null | sort -h
sudo find /var/log -xdev -type f \
  -printf '%s\t%TY-%Tm-%Td %TH:%TM\t%p\n' 2>/dev/null |
  sort -nr | head -n 30
如果某个日志在短时间内快速增长,再按服务和时间窗口核对:
sudo journalctl -u nginx --since "2 hours ago" --no-pager
sudo journalctl -u app.service --since "2 hours ago" --no-pager
sudo systemctl status logrotate.timer 2>/dev/null
在韩国服务器上,访问高峰时间、系统时间和日志时间必须统一。若应用按 UTC 记录,而运维人员按 KST 解读,可能误判日志轮转是否按时执行。
不要为了快速腾出空间而直接删除当前正在写入的日志。更稳妥的顺序是:
logrotate、journal retention 和应用日志级别配置。journalctl --vacuum-time 或 --vacuum-size 会删除旧的归档 journal,执行前应确认日志保留要求、备份策略和审计影响。删除后通常不能通过系统自身回滚,只能从外部备份恢复。
应用目录的增长原因通常比单纯“文件太大”更重要。应把目录大小与业务事件对应起来:
如果使用容器,可以先读取存储占用信息:
sudo docker system df
该命令是否可用取决于部署方式和权限。不要直接执行 docker system prune、删除容器层或清空卷;这些操作可能删除仍被业务使用的镜像、卷和未提交数据。任何清理都要先确认容器、卷、宿主机目录之间的映射关系,并准备从镜像或备份重新部署的方案。
如果 findmnt 显示目标路径是 nfs、nfs4 或 cifs,容量、inode 和配额可能由远程服务器决定:
sudo findmnt -T /mnt/shared
sudo df -hT /mnt/shared
sudo df -ih /mnt/shared
sudo nfsstat -m 2>/dev/null
此时应区分两类问题:
客户端看到的 df 只能说明远程服务返回的当前状态,不能替代远程存储端的 quota 报告。若错误信息只发生在共享目录,需让远程存储管理员检查服务端配额和文件系统状态。
网络流量本身不会直接消耗 inode,但上传失败重试、异常请求、爬虫访问和大文件传输可能造成日志、临时文件或队列快速增长。可以把访问日志中的时间、请求路径、响应状态与目录增长曲线对照,而不是把“网络异常”直接当作磁盘根因。
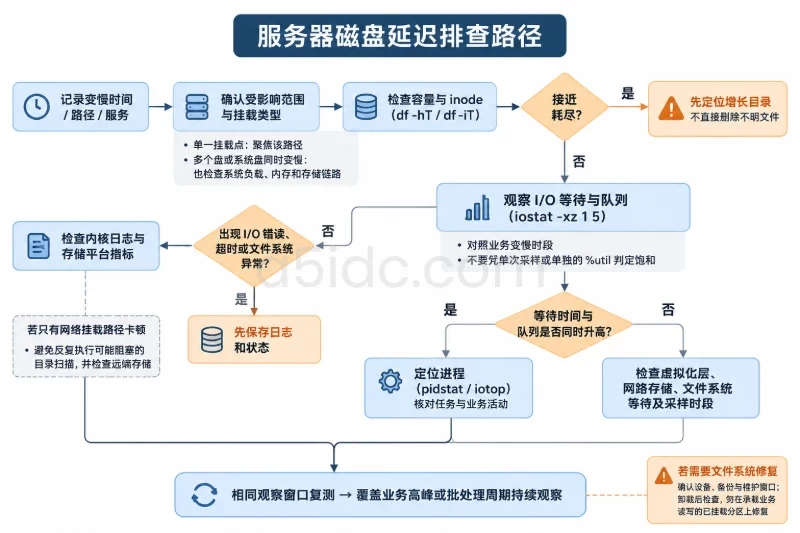
当容量和配额都没有触顶,但服务仍出现写入超时,应检查设备延迟和队列:
sudo iostat -xz 1 5
sudo vmstat 1 5
sudo pidstat -d 1 5 2>/dev/null
判断时重点关注:
await 是否在多个采样周期持续升高;%util 是否长期接近设备饱和;vmstat 中是否出现明显 I/O 等待;“几十毫秒”可以作为排查提醒的示例量级,但不能作为所有 SSD、云盘、网络盘的统一阈值。设备类型、队列深度、业务写入模式和云平台存储等级都会影响正常延迟。应以该服务器平稳时的基线作为比较对象。
单个命令的结果不够时,可以使用多项证据交叉判断:
| 组合结果 | 更接近的根因 | 处理方向 |
|---|---|---|
df -h 接近 100%,df -i 正常,某目录 du 占用明显偏大 | 大文件、日志、上传或备份增长 | 按目录和文件所有者追踪来源,调整留存和归档 |
df -i 接近 100%,块容量仍有余量 | 大量小文件 | 查找生成者、队列、会话和缓存,设计清理或合并策略 |
repquota 显示某用户 blocks 或 files 达到 limit,文件系统仍有余量 | 用户配额超限 | 核对该用户目录和业务需求,调整配额或控制增长 |
| XFS 全局容量正常,但 project quota 超限 | 目录级 project quota | 查看项目配置和对应目录,不要只查用户 quota |
df 很高,du 低,lsof +L1 有大文件 | 已删除文件仍被进程打开 | 受控 reload 或 restart,验证空间释放 |
du 低且 quota 正常,但设备 await、队列和内核日志异常 | I/O 或底层存储问题 | 检查云盘、物理盘、快照、网络存储和文件系统状态 |
| 仅共享目录报错,客户端本地磁盘正常 | 远程文件系统或服务端配额 | 转到远程存储端核对配额和容量 |
/var/log 或 journal 短时间急增,同时访问错误或重试增加 | 服务配置、异常请求或应用错误循环 | 先止住增长源,再处理日志和业务故障 |
例如,某用户配额报告显示 files 达到硬限制,df -h 仍有充足空间,随后 du --inodes 显示 /srv/app/sessions 包含数百万个小文件,那么根因应归到“用户 inode 配额加上会话文件未清理”,而不是“韩国服务器磁盘容量不足”。这种判断可以直接指导修复范围。
在清理前记录以下信息:
sudo df -hT
sudo df -ih
sudo repquota -aug
sudo du -xhd1 /var/lib/appdata 2>/dev/null | sort -h
sudo lsof -nP +L1
然后优先处理仍在增长的源头,例如暂停异常任务、降低过高的日志级别、修正失败重试、限制上传临时目录或让日志轮转恢复。停止服务会影响连接和任务处理,执行前要确认影响范围,并准备 systemctl start、配置回退或从备份恢复。
可清理的数据通常包括已经过期的缓存、已完成任务的临时文件和符合保留策略的旧日志,但必须先确认:
不要使用未经筛选的 rm -rf、find ... -delete 或容器全局清理命令。删除操作具有不可逆性,可能误删当前租户数据、数据库文件或正在处理的任务。
修改配额、扩容卷和调整挂载配置前,应确认备份可用、维护窗口、业务影响和回滚方式。特别是文件系统扩容通常容易回滚困难,不能只根据一次 df 结果操作。
处理完成后,应验证“限制解除、增长停止、业务恢复”三个结果:
sudo df -hT /var/lib/appdata
sudo df -ih /var/lib/appdata
sudo quota -u alice -s
sudo lsof -nP +L1
sudo systemctl is-active app.service
还要回到原始故障路径进行验证:
如果目标目录已经接近 hard limit,不建议用大文件做写入测试。可以先检查服务健康状态和配额余量,避免为了验证而再次消耗有限空间。
至少同时监控文件系统和配额,不要只监控一个指标:
/var/log、上传目录、队列、备份目录和容器存储目录的变化。告警阈值可以先采用分级策略,例如块容量或 inode 达到 70% 进入观察、80% 触发预警、90% 进入处理;对高增长业务还应增加“单位时间增长量”告警。用户 quota 接近 soft limit 时就应通知,而不是等到 hard limit 拒绝写入。具体阈值应结合业务写入峰值、备份周期和扩容所需时间调整。
容量规划也应使用增长速度而不是当前剩余量单独判断。若某挂载点可用空间为 40 GB,近 24 小时增长 5 GB,则理论余量约为 8 天;如果增长来自异常日志或重试循环,这个估算还可能迅速失效。将 KST、UTC 和容器时间统一后,再把容量、inode、quota、日志和 I/O 指标放到同一时间轴上,通常比单独执行一次 df -h 更容易定位复发原因。
围绕韩国服务器上的 Linux 业务部署,A5idc数据提供首尔地区的物理服务器方案,涵盖不同 CPU、存储配置及优化或国际线路选择,可用于承载网站、业务后台、数据库和持续写入日志的应用。多地区服务器资源也覆盖香港、日本、新加坡等地,便于企业按业务部署区域与数据存储需求规划基础设施。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7653.html