香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


同一份 Ansible Playbook 连续执行两次,第二次仍然出现 changed=1,并不一定代表 Ansible 失效;反过来,第二次显示 changed=0,也不能单独证明服务器没有配置漂移。真正的幂等执行,是在目标状态、输入变量和外部依赖保持一致时,第一次执行完成收敛,后续重复执行不再产生新的状态变化。
验证这一点需要同时观察控制端结果和被管理主机的实际状态:先在干净或已知状态的服务器上执行,再使用完全相同的清单、变量和权限重复执行;随后可以在测试环境中人为修改受管配置,确认 Playbook 能重新修正漂移,并再次运行确认恢复到 changed=0。--check 和 --diff 可以辅助判断,但不能替代真实执行和状态核对。
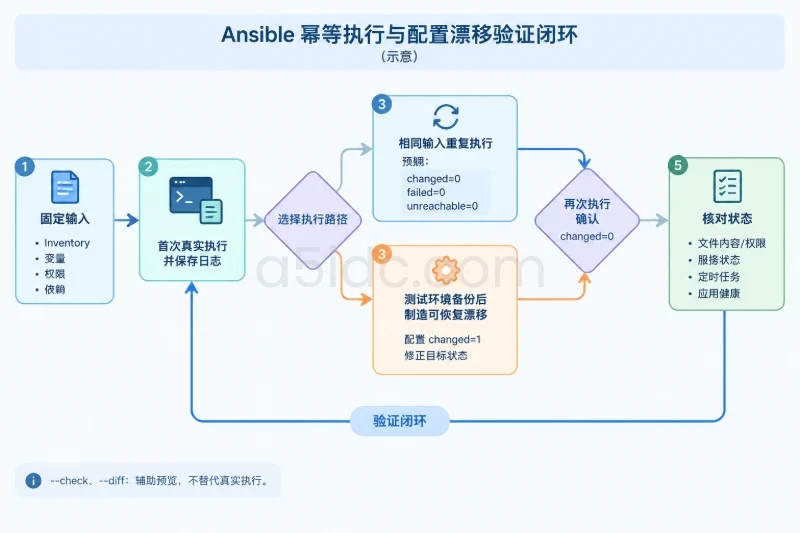
Ansible 的目标是让服务器从当前状态收敛到声明的目标状态。第一次部署时,创建目录、写入配置、安装软件或创建定时任务都属于正常变更,因此可能出现多个任务 changed=1。
例如,下面的状态变化是符合预期的:
| 执行次数 | 服务器状态 | 典型结果 |
|---|---|---|
| 第一次 | 配置文件不存在,服务未启动 | 创建文件、启动服务,出现 changed |
| 第二次 | 配置已符合定义,服务已运行 | changed=0 |
| 人为修改配置后 | 配置偏离定义 | 修正配置,出现 changed |
| 修正后的下一次 | 配置再次符合定义 | changed=0 |
因此,幂等性关注的是“目标状态是否稳定”,而不是“任务是否从未执行”。
可以将三者区分为:
幂等 Playbook 并不阻止管理员临时修改文件,也不能阻止应用程序自行重写配置。它的作用是:下一次执行时识别差异,并将状态重新拉回定义。
此外,幂等也不等于事务回滚。一个 Playbook 可能已经成功修改了前几个主机,随后在某台服务器上失败。Ansible 默认不会把已经完成的所有操作自动撤销,因此还需要单独设计发布批次、备份和回滚机制。
Ansible 模块通常会读取远程状态,再与任务参数比较。例如:
file 比较路径、类型、权限、属主和属组;copy、template 比较文件内容及文件属性;package 根据软件是否存在或版本是否满足要求决定是否安装;service 根据服务是否运行或是否启用决定是否操作;user 和 group 根据账户属性进行调整;cron 根据任务名称、时间表达式和命令维护定时任务。下面的示例同时管理一个应用配置、服务状态和定时任务:
---
- name: Converge application host
  hosts: app
  become: true
  gather_facts: true

  tasks:
    - name: Ensure application configuration directory exists
      ansible.builtin.file:
        path: /etc/myapp
        state: directory
        owner: root
        group: root
        mode: "0755"

    - name: Manage application configuration
      ansible.builtin.copy:
        content: |
          listen = 8080
          log_level = info
          data_dir = /var/lib/myapp
        dest: /etc/myapp/app.conf
        owner: root
        group: root
        mode: "0644"
        backup: true
      notify: Restart myapp

    - name: Ensure myapp is running
      ansible.builtin.service:
        name: myapp
        state: started
        enabled: true

    - name: Manage cleanup cron job
      ansible.builtin.cron:
        name: "myapp log cleanup"
        user: root
        minute: "17"
        hour: "2"
        job: "/usr/local/sbin/myapp-cleanup --days 7"

  handlers:
    - name: Restart myapp
      ansible.builtin.service:
        name: myapp
        state: restarted
这个示例的前提是目标主机已经存在名为 myapp 的服务和清理脚本。配置内容、服务名、路径以及命令需要替换成实际环境中的值,不能直接假定所有发行版都采用相同目录结构。
配置文件只有在内容或属性发生变化时才会触发 Restart myapp。服务任务使用 state: started,只保证服务处于运行状态,不会在每次 Playbook 执行时主动重启。相反,如果任务直接写成 state: restarted,它通常会在每次执行时产生动作,这种写法就不适合作为普通的幂等状态声明。
changed是模块对变更的判断Playbook 运行结果中的 changed 来自模块返回值。它反映的是模块认为自己是否修改了目标状态,而不是 Ansible 对整台服务器进行的独立审计。
这会带来两个重要判断:
changed=0 通常具有较好的参考价值。shell 或 command 时,必须额外定义“何时算发生变更”,否则输出可能无法代表实际状态。例如,下面的命令每次都可能被执行:
- name: Run a maintenance command
  ansible.builtin.command: /usr/local/sbin/myapp-maintenance
如果该命令只是检查状态,或者只有在特定条件下才需要运行,应优先改成有明确状态语义的模块。确实只能调用外部命令时,可以使用 creates、removes,或根据命令输出设置 changed_when:
- name: Create initial data marker once
  ansible.builtin.command:
    cmd: /usr/local/sbin/myapp-init
    creates: /var/lib/myapp/.initialized
另一个例子是检查性命令:
- name: Check application configuration
  ansible.builtin.command: /usr/local/bin/myapp --check-config /etc/myapp/app.conf
  register: config_check
  changed_when: false
  failed_when: config_check.rc != 0
changed_when: false 只适用于确认该命令不会改变服务器状态的场景。不能为了让第二次执行显示 changed=0,把真正会修改文件或服务的命令强行标记为未变更。
配置文件变化后重启服务,是常见的“状态变化触发副作用”场景。使用 notify 和 handler 的好处是:
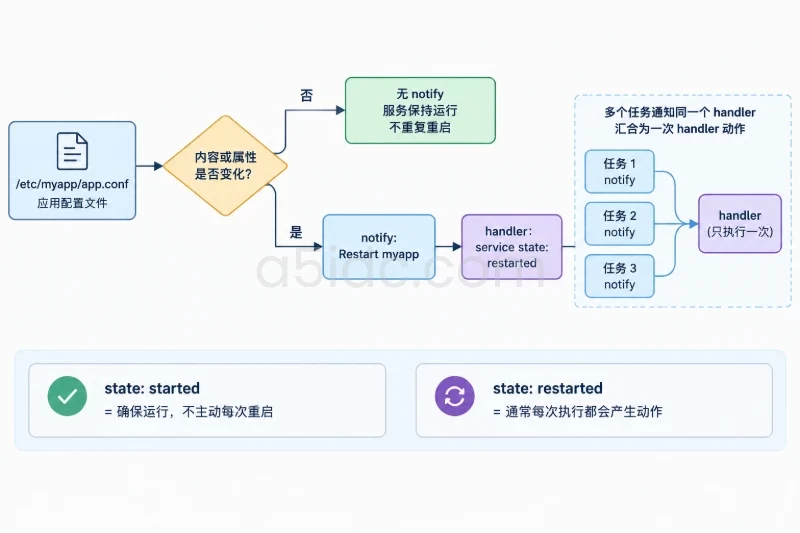
如果服务必须在后续任务前立即重启,可以使用 meta: flush_handlers,但需要评估失败影响。handler 默认在合适的阶段执行,如果后续任务失败,之前已通知的 handler 可能尚未执行。对关键服务进行发布时,应明确安排健康检查和失败处理,而不是只依赖 handler 的默认时机。
shell、command 和 raw 适合调用没有对应模块的工具,但它们本身通常不知道目标状态。以下写法容易产生重复内容:
- name: Append a setting
  ansible.builtin.shell: echo "worker_processes=4" >> /etc/myapp/app.conf
每次执行都有追加风险,最终可能出现多行重复配置。更合适的选择是:
copy 或 template 管理完整文件;lineinfile 管理明确的一行;blockinfile 管理有边界的配置块;changed_when。使用 lineinfile 时,正则表达式应覆盖同一配置项的完整形式,并考虑注释、空白和已有重复行。例如:
- name: Ensure worker count is defined once
  ansible.builtin.lineinfile:
    path: /etc/myapp/app.conf
    regexp: '^\s*worker_processes\s*='
    line: 'worker_processes=4'
    create: true
    owner: root
    group: root
    mode: "0644"
如果文件存在多个旧配置项,仅靠一条规则不一定能清理所有重复内容。对于结构稳定、由 Ansible 完整拥有的文件,使用模板整体生成通常更容易验证。
同样的模板如果每次渲染都得到不同内容,就不可能稳定收敛。常见来源包括:
需要将这些输入固定、排序或隔离。例如,模板中使用列表时可以先排序:
- name: Render allowlist in stable order
  ansible.builtin.template:
    src: allowlist.conf.j2
    dest: /etc/myapp/allowlist.conf
    owner: root
    group: root
    mode: "0644"
模板文件中应尽量基于确定的变量生成内容:
{% for address in allowed_addresses | sort %}
allow = {{ address }}
{% endfor %}
如果确实需要生成一次性值,应先将该值持久化到受控的变量、密钥系统或事实存储中,而不是在每次运行时重新随机生成。
state: present 通常表示软件存在即可;state: latest 则可能因为软件仓库产生新版本,在不同时间执行时再次发生升级。对于需要可重复部署的环境,应明确区分:
present;latest,但接受其输入会变化;即使 Playbook 没有变化,仓库内容、DNS、证书、外部 API 和操作系统软件源也可能变化。验证幂等性时,不能只比较 YAML 文件是否相同,还要记录关键外部输入。
定时任务特别容易出现重复项。使用 cron 模块时,name 应保持稳定,任务内容也应明确:
- name: Maintain one stable backup cron entry
  ansible.builtin.cron:
    name: "myapp daily backup"
    user: root
    minute: "30"
    hour: "1"
    job: "/usr/local/sbin/myapp-backup --retention 7"
如果每次运行都把日期拼进 job,或者动态修改任务名称,Ansible 会将其视为不同条目,可能不断新增任务。手工维护的同类任务也可能与 Ansible 管理的条目并存,因此上线前应检查实际 crontab,并约定哪些条目由 Playbook 完整负责。
Ansible 写入的文件可能随后被应用、代理程序或系统服务重写。例如,程序启动时自动补充默认值,或者管理工具把配置重新格式化。此时即使 Playbook 本身是幂等的,服务器也可能在两次运行之间持续漂移。
处理方式通常有三类:
如果无法确定谁拥有文件的最终控制权,changed=0 不能作为合规结论。
验证应在独立测试主机、快照或可恢复的环境进行。先固定以下内容:
先进行语法检查:
ansible-playbook -i inventory/hosts.yml site.yml --syntax-check
再检查目标主机是否可连接,并确认权限:
ansible -i inventory/hosts.yml app -m ansible.builtin.ping
ansible -i inventory/hosts.yml app -b -m ansible.builtin.command -a 'id'
如果使用了 become,验证结果应与实际发布时一致。普通用户能连接,不代表该用户有权限写入配置目录或管理服务。
第一次执行的输出应保存下来,用于和第二次对比:
ansible-playbook \
  -i inventory/hosts.yml \
  site.yml \
  --diff \
  | tee run-1.log
--diff 可以显示文件内容变化,适合检查模板是否产生了预期结果。但配置中如果包含密码、令牌、证书私钥或其他敏感信息,不应直接输出差异。敏感任务可以使用 no_log: true,同时通过文件校验和、服务健康状态等方式保留必要审计证据。
第一次执行需要记录:
changed;不要在两次运行之间修改变量、切换 Inventory 或更新软件源。直接重复执行:
ansible-playbook \
  -i inventory/hosts.yml \
  site.yml \
  --diff \
  | tee run-2.log
在目标已经收敛、外部依赖没有变化的前提下,常见预期是:
ok=4 changed=0 unreachable=0 failed=0 skipped=0 rescued=0 ignored=0
数字仅表示示例。实际任务数量会随 Playbook 变化,重点是每台目标主机的 changed=0、failed=0 和 unreachable=0。如果第二次仍然有 changed,应先定位具体任务,而不是直接修改 changed_when。
排查顺序可以是:
changed;shell、command 或 state: restarted;在不修改服务器的情况下,可以运行:
ansible-playbook \
  -i inventory/hosts.yml \
  site.yml \
  --check \
  --diff
当服务器已经收敛时,检查模式通常应预测没有待处理变更;如果人为修改了配置,检查模式通常会报告相关任务将发生变化。
但检查模式不是完整证明,原因包括:
command 和 shell 的检查能力有限;因此,检查模式适合作为发布前预览和变更审批依据,不应取代至少一次真实执行和后续状态核对。
要验证“能否修复漂移”,不能只做两次无变化运行。可以在隔离测试主机上备份受管文件后,进行一次可恢复的人工修改:
sudo cp -a /etc/myapp/app.conf /tmp/app.conf.before-drift
sudo sed -i 's/^log_level = info$/log_level = debug/' /etc/myapp/app.conf
上述操作只适用于明确知道文件内容、并且能够恢复的测试环境。修改前应确认服务影响范围,必要时先停止流量或使用快照。测试完成后,如果 Playbook 本身没有修复成功,应使用备份文件恢复,并重新验证服务配置。
再次执行 Playbook,合理的结果应类似于:
changed=1;changed=0。如果手工修改后 Playbook 仍然显示 changed=0,可能说明任务没有真正管理该文件、比较范围不完整,或者 changed_when 掩盖了真实变更。此时应直接检查文件内容、权限、属主和服务实际加载的配置路径。
控制端输出之外,还应对关键状态进行断言。例如,验证配置文件中存在预期内容:
- name: Read managed configuration
  ansible.builtin.slurp:
    src: /etc/myapp/app.conf
  register: app_config
  changed_when: false

- name: Assert required configuration
  ansible.builtin.assert:
    that:
      - "'listen = 8080' in (app_config.content | b64decode)"
      - "'log_level = info' in (app_config.content | b64decode)"
    fail_msg: "The application configuration is not in the expected state"
验证服务状态时,可以使用服务事实:
- name: Gather service facts
  ansible.builtin.service_facts:

- name: Assert myapp is running
  ansible.builtin.assert:
    that:
      - "'myapp.service' in ansible_facts.services
      - ansible_facts.services['myapp.service'].state == 'running'
如果应用提供本地健康检查接口,还应在服务重启后进行业务层验证。仅仅看到 systemd 状态为 running,并不能证明端口已监听、配置已被加载或依赖服务可用。
Ansible 的重复部署与漂移修复,需要稳定的服务器资源承载业务环境。A5idc数据提供中国香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器,涵盖常规建站、AMD计算、存储及多IP等产品方向;不同CPU、内存、磁盘和线路配置,可对应业务后台、数据库、接口服务及跨地区部署等场景,为服务器配置管理提供多样化的基础资源。
将 Playbook 放到定时任务中,可以持续纠正配置漂移,但应先完成一次人工验证。定时执行还需要考虑:
Ansible 控制端可以通过 log_path 或外部作业系统保存运行日志,但日志保存本身不等于合规审计。较完整的审计记录至少应包含执行时间、目标主机、Playbook 版本、操作者或调度任务、变更任务、失败原因以及回滚结果。
配置文件任务中的 backup: true 可以在发生覆盖时生成远程备份,适合处理单个文件的临时恢复:
- name: Deploy application configuration with backup
  ansible.builtin.copy:
    src: files/app.conf
    dest: /etc/myapp/app.conf
    owner: root
    group: root
    mode: "0644"
    backup: true
  register: app_config_deploy
  notify: Restart myapp
但这个备份通常只是一次变更产生的文件副本,不等于长期版本库,也不一定覆盖数据库、软件包、证书和多台主机之间的关联状态。生产发布更适合采用以下方式:
如果需要在同一 Playbook 中处理失败,可以使用 block 和 rescue,但恢复动作本身也必须经过测试。Ansible 没有跨主机的自动事务机制,不能仅凭 rescue 就认为所有已完成操作都会回退。
一个任务连续两次返回 changed=0,只说明该模块认为目标资源没有变化。它不一定说明:
因此,验证层级可以分为:
| 验证层级 | 关注内容 | 常用方式 |
|---|---|---|
| 任务层 | 模块是否重复报告变更 | Playbook recap、changed_when |
| 文件层 | 内容、权限、属主、校验和 | stat、slurp、diff |
| 服务层 | 进程、监听、启用状态 | service_facts、端口检查 |
| 应用层 | 配置是否成功加载、接口是否健康 | 应用自带检查命令、健康接口 |
| 运行层 | 漂移是否被发现和修复 | 定时执行、日志、告警、人工修改测试 |
不同资源应使用对应的验证方式。不能用一个配置文件的 changed=0,推断数据库、定时任务和服务健康状态都没有问题。
在多主机部署中,执行顺序、批次大小和服务依赖会影响结果。可以使用 serial 分批发布,先验证少量主机,再处理剩余节点:
---
- name: Rolling configuration deployment
  hosts: app
  become: true
  serial: 2

  tasks:
    - name: Deploy configuration
      ansible.builtin.template:
        src: app.conf.j2
        dest: /etc/myapp/app.conf
        owner: root
        group: root
        mode: "0644"
      notify: Restart myapp

    - name: Verify local application health
      ansible.builtin.command: /usr/local/bin/myapp-healthcheck
      changed_when: false

  handlers:
    - name: Restart myapp
      ansible.builtin.service:
        name: myapp
        state: restarted
这里的健康检查命令必须是只读检查,并且能够以非零退出码准确表示失败。若应用启动耗时较长,还需要加入适当的等待和重试逻辑,否则可能把正常启动延迟误判为发布失败。
外部 API、软件仓库、DNS、时间同步和证书有效期也会影响重复运行。如果这些因素没有固定,第二次执行发生变化并不一定是 Playbook 非幂等,而可能是输入环境已经变化。验证报告中应记录这些条件,避免把环境波动误判为模块问题。
可以用下面的判断标准确认一个 Playbook 是否达到可接受的幂等水平:
changed=0。达到这些条件时,才可以较有把握地说 Playbook 具备可重复部署能力。若只看到第二次运行的 changed=0,却没有核对实际文件、服务、定时任务和外部副作用,最多只能说明一次执行结果看起来稳定,不能据此排除配置漂移。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7606.html