香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


同一台服务器的 app_port 在 host_vars 中是 8081,执行 Playbook 时却显示 9000,并不一定是 Ansible 没有读取主机变量。更常见的原因是:任务执行到该位置时,另一个优先级更高的变量定义覆盖了它。
判断同名变量的最终值,不能只看变量写在哪个文件里。应当先确认目标主机和正在执行的任务,再找出该变量在本次执行中有哪些来源,按优先级和作用范围判断,最后在使用该变量的任务位置验证。ansible-inventory 能帮助检查清单变量,但它不能单独回答 Playbook 中 vars、include_vars 或 set_fact 生效后变量是什么。
Ansible 的“变量优先级”解决的是一个具体问题:同一任务上下文中,多个来源为同一个变量名提供值时,采用哪个值。它不等于文件加载顺序,也不意味着所有变量从 Playbook 开始到结束始终保持一个值。
排查前需要区分三个维度:
vars 又可覆盖这些清单变量。vars 只影响相应任务;Play 级变量用于该 Play 的上下文。不能把某个任务看到的值直接当成整个 Playbook 的值。include_vars、set_fact 等是在执行到相应任务时引入或设置变量。前一个任务和后一个任务看到的值可能不同。因此,“最终值”最好写成更精确的问题:在目标主机 srv1 执行某个具体任务时,app_port 的值是什么?如果变量被用于模板或模块参数,还要检查实际引用它的位置,而不是只检查 Playbook 开头。
对常见的自定义变量,可以先用下面的简化关系建立判断方向。表中从低到高排列;它是排查用的分层视图,不替代具体上下文中的完整优先级判断。
| 变量来源 | 典型写法 | 判断要点 |
|---|---|---|
| 角色默认变量 | roles/example/defaults/main.yml | 用于提供容易被覆盖的默认值 |
| 清单组变量 | group_vars/all.yml、group_vars/web.yml | 要确认主机属于哪些组,以及组之间如何合并 |
| 清单主机变量 | host_vars/srv1.yml、清单中的主机变量 | 对同名组变量通常具有更高优先级 |
| Play、Block、Task 变量 | vars: | 不同层级有各自作用范围;任务变量只在相应任务生效 |
| 角色变量、动态载入的变量及运行时设置的变量 | 角色 vars、include_vars、set_fact 等 | 需进一步区分具体来源和执行位置,不能仅凭“运行时”三个字排序 |
| 角色或动态包含参数 | include_role、include_tasks 所传参数等 | 在对应包含上下文中生效 |
| 额外变量 | ansible-playbook -e ... | 对普通自定义变量,通常是最需要优先排查的高优先级来源 |
这张表有意没有把所有来源挤成一条口诀。例如,vars_files、vars_prompt、角色变量、include_vars、set_fact、注册变量和包含参数之间存在具体的优先级与作用范围差异。遇到冲突时,应确认实际使用的是哪一种来源,而不是把它们统称为“Playbook 里的变量”。
host_vars 有值,任务却读到 Play 变量以下例子中,srv1 属于 web 组:
[web]
srv1 ansible_connection=local
对应文件分别定义了同名变量:
# group_vars/all.yml
app_port: 8080
# host_vars/srv1.yml
app_port: 8081
# site.yml
- name: Inspect app_port
  hosts: web
  gather_facts: false
  vars:
    app_port: 9000

  tasks:
    - name: Show value used by this task
      ansible.builtin.debug:
        msg: "app_port={{ app_port }}"
在没有其他同名定义的前提下,这个任务读到的是 9000。host_vars/srv1.yml 并未失效:它提供了 8081,但当前 Play 的 vars 提供了更高优先级的同名值。如果去掉 Play 中的 app_port,该主机的任务才会转而读到 8081。
这里的 ansible_connection=local 仅用于让示例在控制端验证变量,不表示生产服务器应使用本地连接。实际排查时,应保留真实清单和连接配置。
再看一段执行时载入变量的示例:
# vars/override.yml
app_port: 9300
# site.yml
- name: Inspect app_port over time
  hosts: web
  gather_facts: false
  vars:
    app_port: 9000

  tasks:
    - name: Show play-level value
      ansible.builtin.debug:
        msg: "before={{ app_port }}"

    - name: Show task-level value
      ansible.builtin.debug:
        msg: "in_task={{ app_port }}"
      vars:
        app_port: 9200

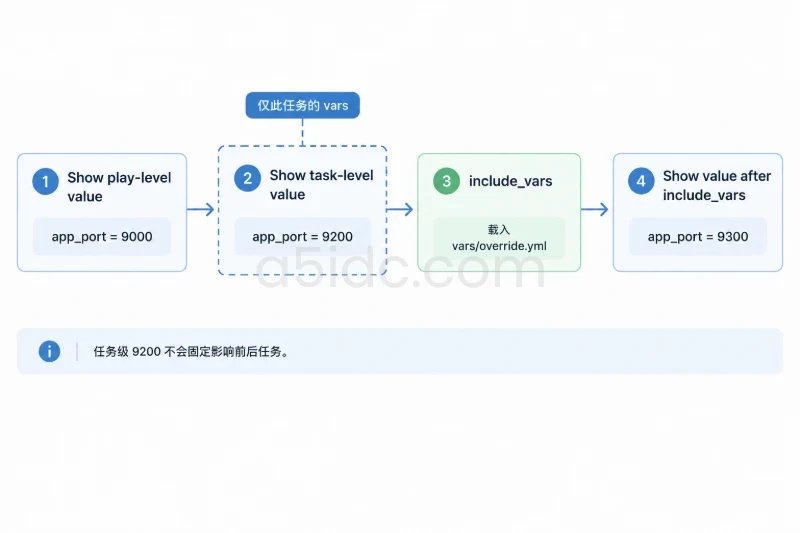
    - name: Load another variable file
      ansible.builtin.include_vars:
        file: vars/override.yml

    - name: Show value after include_vars
      ansible.builtin.debug:
        msg: "after={{ app_port }}"
按此示例执行,三个输出位置依次可看到 9000、9200、9300。任务级 vars 使第二个任务使用 9200,但不会因此让第一个任务或后续所有任务都固定使用 9200;执行到 include_vars 后,后续任务又获得了新载入的值。
如果执行时再传入:
ansible-playbook -i inventory.ini site.yml -e '{"app_port": 9999}'
上述三个输出位置都会读到额外变量提供的 9999。这里使用 JSON 对象传参,是为了让 9999 作为数字传入;排查布尔值、数字等类型问题时,不要只比较屏幕上显示的字符。
group_vars/all.yml、父组变量、子组变量以及主机变量可能同时定义 app_port。通常可以先按“all → 父组 → 子组 → 主机”的方向检查,但同层组之间还涉及合并顺序;清单中的 ansible_group_priority 也可影响同层组变量的覆盖结果。
因此,看到 group_vars/web.yml 后,不应立即断言它就是组变量的最终来源。先核对目标主机实际属于哪些组,以及清单最终解析出的主机变量。尤其在使用多个清单来源时,还要留意来源组合后的结果,而不是只打开其中一个文件。
变量冲突既可能是值不同,也可能是类型不同。例如一个文件把 app_port 写成数字 9000,另一个来源通过字符串形式传入 "9000"。两者在日志中看起来接近,但用于比较、模板过滤器或模块参数时可能产生不同结果。
对字典变量也不要默认采用“只覆盖其中一个键”的理解。在 Ansible 常见的默认行为下,高优先级来源定义的同名字典会替换低优先级字典;如果环境调整了相关合并配置,结果又需要按实际配置核对。比起凭印象推断,直接检查使用位置的值与类型更可靠。
set_fact 与缓存事实需要分开看set_fact 可以让当前执行过程中的后续任务读取设置的值。如果启用了事实缓存并使用相应缓存设置,同一个名字在后续运行中还可能以缓存事实的形式出现;当前运行设置的变量和后续运行读到的缓存事实,优先级不能简单当作完全相同。
出现“昨天执行是一个值,今天没改 Playbook 却变了”的情况,应同时核对变量文件、额外变量、是否执行过 set_fact,以及事实缓存是否参与本次运行。不要仅凭一次 debug 输出推断值一定来自哪个文件。
排查服务器连接时,ansible_user、ansible_connection 等连接变量还可能影响连接行为。命令行连接选项和 Ansible 变量不是同一套简单的“后写覆盖前写”关系:清单或 Playbook 中定义的连接变量,可能让实际连接方式与命令行选项的直觉判断不同。
因此,若现象是“变量显示正确,但连接的账号或目标不符合预期”,应检查相应连接变量,而不是只搜索业务变量。本文讨论的普通自定义变量取值规则,也不应机械套到 Ansible 的内部特殊变量上。
跨地区管理服务器时,主机的业务角色、硬件资源和连接配置可能各不相同。A5idc数据提供中国香港、美国、日本、新加坡等地区的物理服务器,不同产品系列覆盖常规计算、AMD平台、NVMe存储及多种线路需求,可为企业网站、业务后台和数据库等多主机部署提供资源基础。这类部署也适合通过Ansible清单区分主机与分组,按具体任务管理变量和连接参数。
定位冲突时,建议按“确认对象 → 缩小来源 → 在使用点取值”的顺序操作。先选定一台出现问题的主机和一个具体任务;多台服务器的组成员关系、主机变量可能不同,不能用 srv1 的结果代替整个主机组。
   ansible --version
   ansible-inventory -i inventory.ini --host srv1
ansible-inventory --host 适合检查清单解析后目标主机获得了什么,但不包含随后在 Playbook 执行中才生效的所有变量。清单输出可能包含敏感信息,不宜直接贴到公开工单。
group_vars、host_vars、Playbook、角色目录,以及执行命令中的 -e。搜索到某一行只说明存在定义,不代表它在目标任务处一定生效;还需核对主机、Play、条件及包含关系。 - name: Inspect effective app_port
ansible.builtin.debug:
msg:
- "app_port={{ app_port | default('UNDEFINED') }}"
- "type={{ app_port | type_debug if app_port is defined else 'undefined' }}"
若原任务位于角色或动态包含任务内部,检查任务也应尽量放在相同上下文;移到外层 Play 后,作用范围可能已不同。对密码、令牌等敏感变量,不要用 debug 输出原值,应采用不泄露内容的校验方式。
include_vars、set_fact、包含任务和角色调用;若一开始就与预期不同,优先核对 -e、Play 变量及清单组合结果。必要时用 ansible-config dump --only-changed 核对环境中已修改的配置,再判断字典合并或事实缓存等行为。这些只读检查不会修改远端服务,但临时加入的调试任务仍应在验证后移除或关闭,避免长期输出配置细节。不要为了观察变量值而直接运行带有部署、覆盖文件或重启服务的完整 Playbook;应先确认目标任务的影响范围,并在需要时将验证限制到受控环境。
debug 能证明“这个任务此刻读到了什么”,却不会自动给出完整的来源追踪。例如最终值为 9000,清单、Play 变量和额外变量中都可能写了 9000;只看结果无法区分究竟是哪一处获胜。定位来源仍需结合定义搜索、作用范围、执行顺序和本次命令参数。
此外,模板中的表达式可能引用其他变量。即使 app_url 只在一处定义,它的表达式若引用了发生变化的 app_host,最终渲染出的 URL 仍可能随任务上下文变化。此时应检查实际渲染值及其依赖变量,不能仅统计 app_url 出现了几次。
实务上可以把判断边界固定为一句话:先问哪台主机、哪个任务、哪次执行,再谈变量优先级。用清单解析结果确认主机基础变量,用定义搜索和执行顺序解释可能的覆盖,最后在真正使用变量的位置验证值与类型;只有这三者对得上,才能可靠地说明同名变量为何得到当前结果。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7079.html