香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


Pod 反亲和性配置后,Pod 仍然集中在少数节点或同一故障域,不能仅凭 kubectl get pods -o wide 就判断规则失效。先确认使用的是硬性约束还是软性偏好,再核对选择器、命名空间、拓扑标签和调度事件;资源不足、节点不可调度等条件也可能让 Pod Pending,或使软性偏好被调度器放弃。
反亲和性的效果取决于 topologyKey:使用 kubernetes.io/hostname 时,约束的是同一节点;使用可用区标签时,约束的是同一可用区。多个 Pod 分散在不同节点、但仍位于同一可用区,不代表可用区级反亲和性失效。
同时区分两种配置:
requiredDuringSchedulingIgnoredDuringExecution 是硬性约束。新 Pod 调度时必须满足;如果没有符合条件的节点,Pod 通常会保持 Pending。它不会在规则后来变化时自动驱逐已经运行的 Pod。preferredDuringSchedulingIgnoredDuringExecution 是软性偏好。调度器会尽量满足,但在资源、可调度节点或其他约束不理想时,仍可能把 Pod 放到已有匹配 Pod 的拓扑域。因此,排查的第一步是确认观察对象:是新 Pod 仍能落到同一节点,还是新 Pod 已经 Pending;是同一主机,还是同一可用区;配置是硬约束,还是软偏好。
调度结果由一组条件共同决定。可按以下顺序排查:
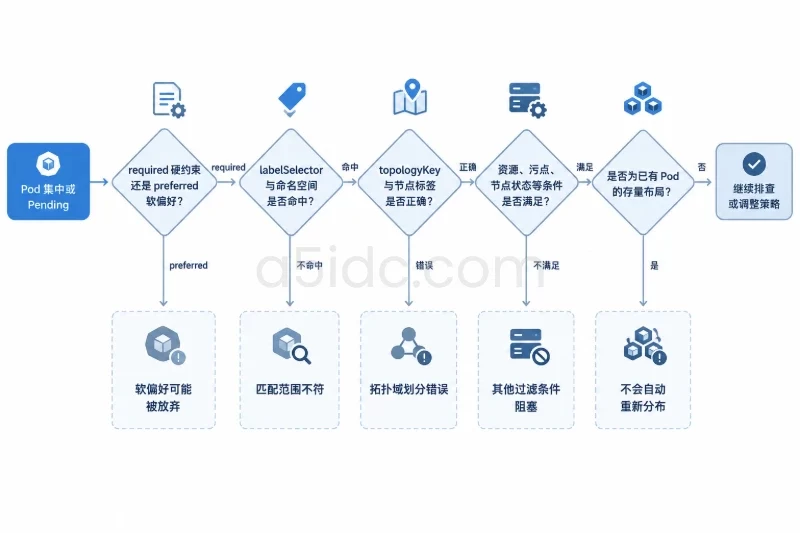
preferred...,或硬约束字段没有被正确提交。topologyKey 不等于希望隔离的故障域,或节点标签不完整。可以先查看 Pod、节点、配置和事件:
kubectl get pods -n <命名空间> -o wide --show-labels
kubectl get nodes --show-labels
kubectl describe pod <Pod名称> -n <命名空间>
kubectl get pod <Pod名称> -n <命名空间> -o yaml
describe 输出中的 Events 是重要线索。若看到类似 FailedScheduling,需结合完整事件判断是反亲和性无可用拓扑域,还是资源不足、节点不可调度等其他过滤条件。以下示例只是模拟输出,不代表已在读者集群中执行:
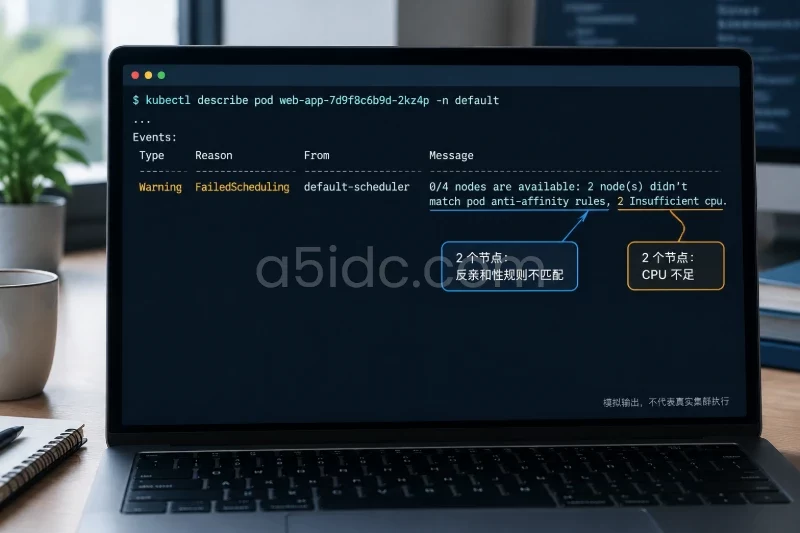
Warning  FailedScheduling  default-scheduler
0/4 nodes are available: 2 node(s) didn't match pod anti-affinity rules,
2 Insufficient cpu.
这表示至少有两个节点因反亲和性规则被排除,另外两个节点因 CPU 不足被排除;不是反亲和性完全没生效。若 Pod 已经处于 Running,则应优先核对它何时创建、当前规则是否后来修改,以及是否期待规则对存量 Pod 自动生效。
检查 Pod 实际生效的 spec.affinity,不要只看本地 YAML 或控制器模板。Deployment、StatefulSet 等控制器创建的是 Pod;修改模板后,新建或替换的 Pod 才会带上新配置,已有 Pod 的实际配置和位置需要单独检查。
硬性反亲和性通常形如:
affinity:
  podAntiAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchLabels:
            app: checkout
        topologyKey: kubernetes.io/hostname
若这里只有 preferredDuringSchedulingIgnoredDuringExecution,Pod 同节点分布属于可能结果,而非配置错误。weight 会影响偏好评分,但不能把软约束变成硬约束。
还应核对 Pod 是否使用预期的调度器:检查 Pod 的 spec.schedulerName,并确认对应调度器及其配置实际可用。自定义调度器或调度配置可能改变过滤、打分过程;不能只根据默认调度器的预期推断实际行为。
反亲亲和性不是按 Deployment 名称、Pod 名称或容器镜像匹配,而是通过 labelSelector 选择 Pod。逐项比较规则中的标签与运行中 Pod 的标签:
kubectl get pods -n <命名空间> --show-labels
kubectl get pods -n <命名空间> -l app=checkout -o wide
常见问题包括:
app.kubernetes.io/name: checkout,规则却匹配 app: checkout。matchExpressions 的 In、NotIn、Exists 或 DoesNotExist 条件与实际标签不符。还要检查 namespaceSelector 和 namespaces。若两者都未设置,通常只匹配当前 Pod 所在命名空间;这在跨命名空间隔离场景下容易造成误判。若设置了 namespaceSelector: {},则表示选择所有命名空间中的 Pod,影响范围会显著扩大。选择器与命名空间范围需要一起评估,而不是单独看标签是否存在。
对每条规则,确认“哪些 Pod 被选中”以及“这些 Pod 当前位于哪些拓扑域”。只有匹配到的 Pod 才会参与该条反亲和性约束。空的 Pod 标签选择器也需谨慎核对:在适用的命名空间范围内,它可能匹配全部 Pod,造成比预期更严格的限制。
topologyKey 与节点标签topologyKey 定义了哪些节点属于同一个拓扑域。常见选择如下:
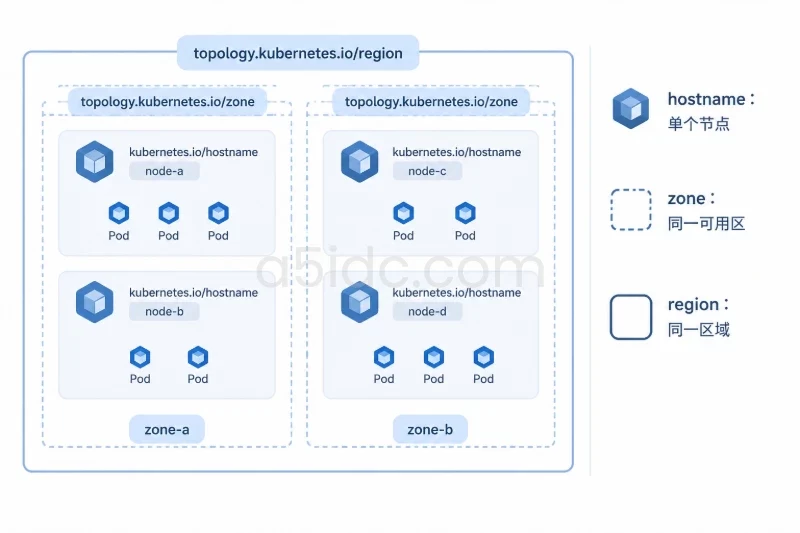
topologyKey | 约束范围 | 需要核对的节点标签 |
|---|---|---|
kubernetes.io/hostname | 单个节点 | 每个候选节点的主机名标签 |
topology.kubernetes.io/zone | 可用区 | 节点的可用区标签及其取值 |
topology.kubernetes.io/region | 区域 | 节点的区域标签及其取值 |
例如,规则使用 topology.kubernetes.io/zone,但运维人员观察的是节点分布,那么多个 Pod 分布在同一可用区内仍可能符合规则。反过来,如果目标是跨可用区隔离,只使用 kubernetes.io/hostname 也无法保证这一点。
检查候选节点是否都有对应标签,以及标签值是否准确:
kubectl get nodes \
  -L kubernetes.io/hostname,topology.kubernetes.io/zone,topology.kubernetes.io/region
如果标签缺失、拼写不同,或不同节点的标签值被错误地设置成相同值,拓扑划分就可能与预期不一致。确认拓扑标签由集群平台或节点管理流程一致维护;不要仅凭节点名称推断它属于哪个可用区。涉及集群版本、调度器实现或准入策略差异时,也应在目标集群中核对支持情况,而不是假设所有环境行为完全一致。
反亲亲和性规则中的 IgnoredDuringExecution 表示:Pod 已经运行后,即使出现不满足规则的情况,也不会仅因该规则自动驱逐它。常见原因包括:
此时要分别观察新创建的 Pod 和已运行的 Pod。新 Pod 遵守硬约束、旧 Pod 仍集中,说明问题可能是存量布局,而不是调度规则未生效。若确实需要重新分布,应结合应用可用性、副本数、驱逐策略和集群容量制定迁移方案;不要直接批量删除 Pod 来“验证”,否则可能造成服务副本短时不足。
硬性反亲和性会排除已有匹配 Pod 所在的拓扑域。如果剩余节点没有足够 CPU、内存,或无法满足 Pod 的其他约束,新 Pod 会 Pending。检查事件,并查看资源请求与节点可分配量:
kubectl describe pod <Pod名称> -n <命名空间>
kubectl describe nodes
重点区分 Insufficient cpu、Insufficient memory、节点不可调度、污点不匹配和反亲和性不满足等原因。若希望将副本铺到多个节点,但集群实际只有一个符合其他条件的节点,硬约束可能让后续副本无法调度;软约束则可能退化为集中部署。
节点的 Ready 状态、SchedulingDisabled 状态、污点和 Pod 的容忍配置也会影响候选节点集合。排查时应先判断哪些节点具备承载 Pod 的基本条件,再比较反亲和性是否把这些节点所在的拓扑域排除了。单看集群总 CPU 或总内存,不能证明某个 Pod 在候选节点上可调度。
在承载 Kubernetes 集群的物理资源层面,A5idc数据提供中国香港、美国、日本、韩国、中国台湾、新加坡及马来西亚等地区的服务器资源,覆盖 Xeon、AMD EPYC、NVMe 存储及多种带宽线路,可为容器编排、数据库、接口服务和多任务业务提供不同 CPU、内存、存储与网络组合,支持按业务分布构建节点资源基础。
检查同一 Pod 还配置了哪些条件,包括节点选择器、节点亲和性、Pod 亲和性、拓扑分布约束、优先级及容忍配置。它们可能共同缩小可调度范围。例如,节点亲和性只允许某个可用区,而硬性反亲和性又要求副本分散到不同可用区;当符合条件的可用区数量不足时,新 Pod 可能无法调度。
这类冲突不能通过不断放宽反亲和性来盲目处理。先确定业务真正要求的是“不同节点”“不同可用区”还是“尽量均匀分布”,再逐项核对约束的作用范围。
当配置看起来正确时,可用受控的小范围验证判断问题落在哪一层:
spec.affinity、schedulerName 和 topologyKey。Events,区分反亲和性过滤、资源不足和其他节点条件。例如,假设三个节点分别位于两个可用区,规则使用 topology.kubernetes.io/zone,并且两个可用区都已有匹配 Pod。此时硬性反亲和性可能让下一副本 Pending,即使第三个节点空闲,因为它所在的可用区已被占用。若规则改用主机名,第三个节点可能成为可用拓扑域;但这代表节点级隔离,不代表跨可用区隔离。这个区别能帮助判断是规则写错,还是集群拓扑不满足业务目标。
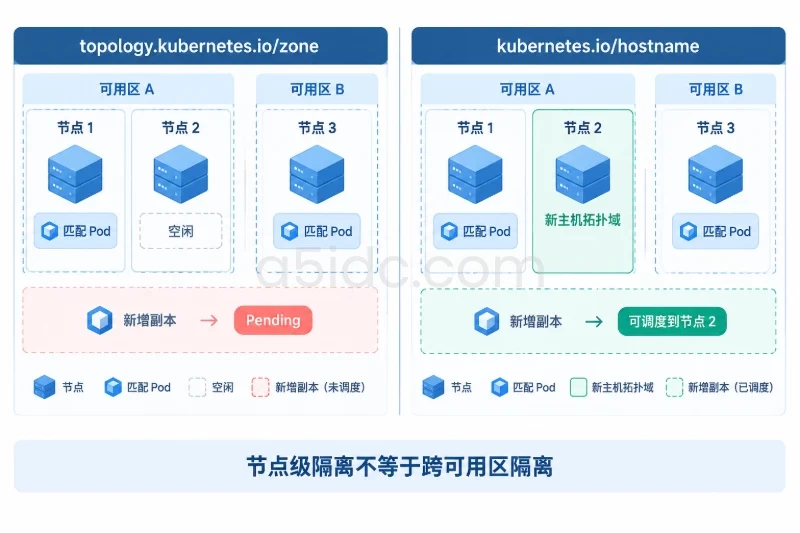
修正后至少验证三件事:新 Pod 的实际配置包含预期规则;新 Pod 落在符合 topologyKey 的拓扑域;调度事件不再出现与该规则相关的失败。如果使用硬约束但新 Pod Pending,应继续看事件中的其他过滤原因,不要仅以“没有集中”判定恢复。
复发监控可关注以下信号:
FailedScheduling,尤其是反亲和性、资源不足或节点条件相关事件。持续监控时,应把“规则配置正确”和“集群具备满足规则的拓扑与容量”分开检查。前者决定调度器如何筛选,后者决定筛选之后是否还有可用位置。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/7076.html