香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


判断 PostgreSQL autovacuum 是否运行正常,不能只看 n_dead_tup 是否偏高,也不能因为日志中出现过一次 automatic vacuum 就直接下结论。更可靠的判断方式是把死元组增长速度、autovacuum 触发条件、清理日志、表和索引大小、事务年龄,以及 CPU、内存、I/O、查询延迟和队列放在同一个观察窗口内分析。
通常可以把“运行正常”定义为:在业务写入量对应的时间范围内,autovacuum 能持续被触发并完成;死元组没有长期跑赢清理速度;表大小增长能够由有效数据、索引或 TOAST 增长解释;清理过程没有持续造成 I/O 饱和、锁等待或接口延迟上升。单个阈值只能作为筛选信号,不能代替关联判断。
围绕 PostgreSQL 数据库的持续写入、后台清理与资源观测,A5idc数据提供中国香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器资源,覆盖 Xeon、AMD EPYC、NVMe SSD、较大内存及不同带宽线路配置,可为数据库、业务后台和接口服务提供计算、存储与网络基础,并适配跨地区业务的数据部署需求。
autovacuum 是后台周期性任务,指标之间存在时间差。例如,n_dead_tup 可能先上升,随后 autovacuum 才开始;日志记录的是一次清理的结果,而表大小是否下降可能永远不会发生,因为普通 VACUUM 主要是回收页内空间供后续写入复用,并不负责把表文件立即缩小。
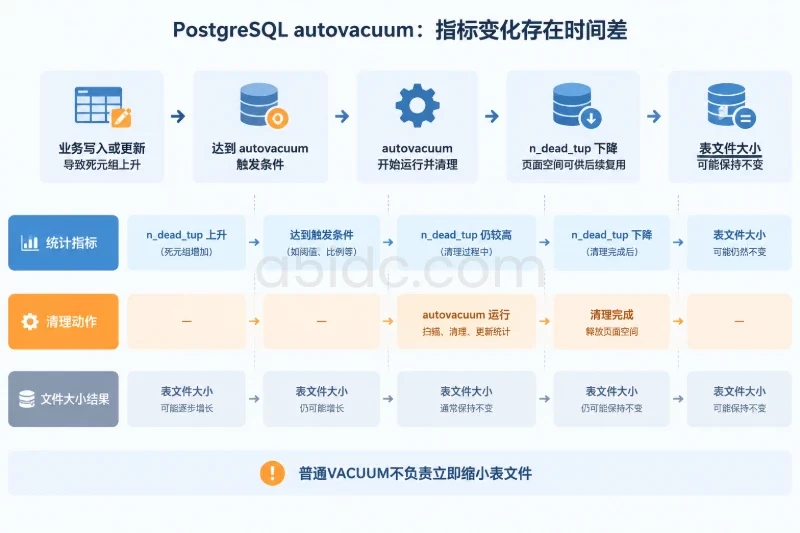
因此,第一次判断至少要同时记录以下信息:
n_live_tup、n_dead_tup、last_autovacuum、last_autoanalyze 和 autovacuum 次数。高写入表可以先观察 30~60 分钟,低频业务表则应覆盖数小时甚至一个完整业务日。更稳妥的判断是覆盖至少两到三次预期的 autovacuum 周期,而不是拿两个相邻采样点比较。
可以先用只读查询获取表级指标:
SELECT
    now() AS observed_at,
    relid::regclass AS table_name,
    n_live_tup,
    n_dead_tup,
    ROUND(
        100.0 * n_dead_tup / NULLIF(n_live_tup + n_dead_tup, 0),
        2
    ) AS dead_ratio_pct,
    last_autovacuum,
    last_autoanalyze,
    autovacuum_count,
    autoanalyze_count,
    pg_size_pretty(pg_relation_size(relid)) AS table_size,
    pg_size_pretty(pg_indexes_size(relid)) AS index_size,
    pg_size_pretty(pg_total_relation_size(relid)) AS total_size
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC;
n_live_tup 和 n_dead_tup 是统计估算值,不是逐行实时计数。它们适合观察趋势,不适合被当成精确库存。监控系统应保存每次采样结果,从而计算:
PostgreSQL 的常规 autovacuum 触发条件可以近似表示为:
死元组数量 ≥autovacuum_vacuum_threshold+autovacuum_vacuum_scale_factor× 表估算行数
默认值在不同版本和发行版环境中可能存在差异,不能直接假定所有实例都相同。可以先查看当前实例配置:
SHOW autovacuum;
SHOW autovacuum_max_workers;
SHOW autovacuum_naptime;
SHOW autovacuum_vacuum_threshold;
SHOW autovacuum_vacuum_scale_factor;
SHOW autovacuum_analyze_threshold;
SHOW autovacuum_analyze_scale_factor;
SHOW autovacuum_work_mem;
SHOW vacuum_cost_limit;
SHOW vacuum_cost_delay;
例如,一张估算有 1 亿行的表,如果使用 autovacuum_vacuum_scale_factor = 0.2,仅按比例部分计算就需要约 2000 万个死元组,再加固定阈值后才达到触发条件。对高频更新表而言,这个触发点可能已经晚于业务能够接受的范围。
因此,不能简单规定“死元组超过 100 万就异常”或“死元组比例超过 10% 就一定异常”。更有价值的是比较三个量:
以下查询可以估算实例级默认参数下的触发点:
SELECT
    s.relid::regclass AS table_name,
    s.n_live_tup,
    s.n_dead_tup,
    c.reltuples AS estimated_rows,
    current_setting('autovacuum_vacuum_threshold')::numeric
        + current_setting('autovacuum_vacuum_scale_factor')::numeric
        * GREATEST(c.reltuples, 0) AS estimated_vacuum_trigger,
    s.last_autovacuum,
    s.autovacuum_count
FROM pg_stat_user_tables AS s
JOIN pg_class AS c
  ON c.oid = s.relid
ORDER BY s.n_dead_tup DESC;
这个结果只是基线。表级 reloptions 可能单独配置了 autovacuum_vacuum_scale_factor、autovacuum_vacuum_threshold 或其他参数。监控规则如果只读取实例级参数,可能会把正常的表级策略误报为异常。
建议把告警分成趋势告警和影响告警,而不是只设置一个比例告警。
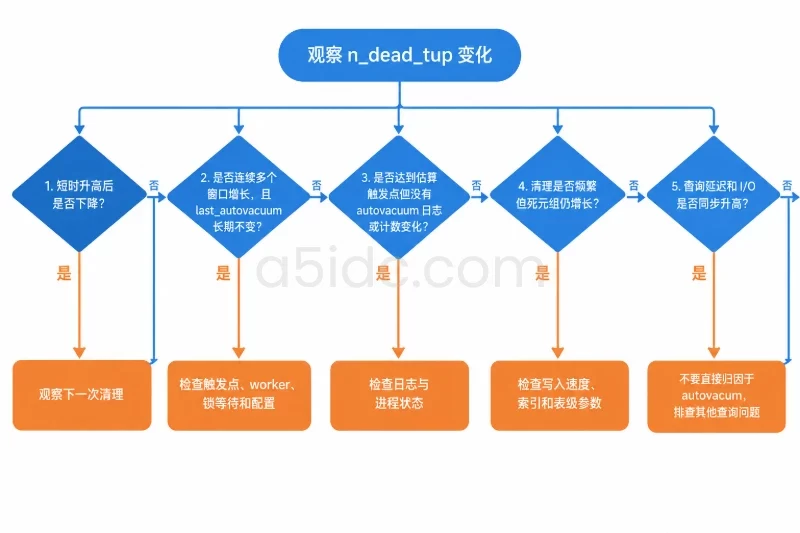
| 观察信号 | 更合理的解释 | 建议动作 |
|---|---|---|
| 死元组比例短时升高,但随后下降,表大小稳定 | 可能是一次批量更新或删除,清理正在追上 | 观察下一次清理和业务延迟 |
死元组连续多个窗口增长,last_autovacuum 长时间不变 | 可能未达到触发条件、worker 不足、任务被阻塞或配置禁用 | 检查触发点、日志、worker 和锁等待 |
| 死元组达到触发点,但没有清理日志或计数变化 | 可能没有完成一次 autovacuum,也可能日志未开启 | 对照 autovacuum_count、进程状态和日志配置 |
| 清理频繁发生,但死元组仍持续增长 | 写入产生死元组的速度超过了清理能力 | 检查 I/O、清理持续时间、索引数量和表级参数 |
| 死元组比例不高,但查询延迟和 I/O 同时上升 | 不能排除缓存、索引、检查点或其他查询问题 | 不要把故障直接归因于 autovacuum |
死元组和表膨胀有关,但两者不是同一个指标。
VACUUM 清理后,已经失效的行版本所在空间通常会在表内标记为可复用。只要后续写入能够复用这些页面,表文件可能不继续扩大;但文件本身也不会因为普通 VACUUM 自动缩回操作系统。于是会出现“死元组已经下降,但表大小没有下降”的正常情况。
表大小持续增长也不一定代表膨胀,至少存在以下替代解释:
先从对象大小趋势开始:
SELECT
    relid::regclass AS table_name,
    pg_size_pretty(pg_relation_size(relid)) AS heap_size,
    pg_size_pretty(pg_indexes_size(relid)) AS index_size,
    pg_size_pretty(
        pg_total_relation_size(relid)
        - pg_relation_size(relid)
        - pg_indexes_size(relid)
    ) AS toast_and_other_size,
    pg_size_pretty(pg_total_relation_size(relid)) AS total_size
FROM pg_stat_user_tables
ORDER BY pg_total_relation_size(relid) DESC;
如果需要进一步估算页内空闲空间,可在已安装并经过权限评估的情况下使用 pgstattuple。该类检查会读取大量表数据,不宜对所有大表高频执行,建议在业务低峰期针对候选表抽样。
SELECT
    table_len,
    tuple_count,
    tuple_len,
    dead_tuple_count,
    dead_tuple_len,
    dead_tuple_percent,
    free_space,
    free_percent
FROM pgstattuple_approx('public.orders');
如果出现以下组合,才更接近“表或索引膨胀正在造成资源浪费”:
n_live_tup 基本稳定;n_dead_tup 长时间偏高,或清理后很快重新堆积;pg_total_relation_size 持续增长;dead_tuple_percent 或空闲空间比例持续升高;若表大小增长与有效行数增长基本同步,且空闲空间比例没有扩大,应优先判断为业务数据增长,而不是直接执行收缩操作。
last_autovacuum 只能说明统计视图记录过一次自动清理,不能说明每次都成功清理了足够数量的死元组。清理日志可以补足三个信息:
可以按需配置 log_autovacuum_min_duration。例如:
# 仅记录持续时间达到 5 秒的自动清理,数值按日志容量调整
log_autovacuum_min_duration = 5000
设置为 0 会记录每次自动清理,适合短时间诊断,但在表多、实例繁忙时会产生大量日志;设置为 -1 则不记录自动清理日志。修改前应确认日志采集、保留和检索能力,避免诊断配置反而打满磁盘。参数是否支持在线重新加载以及具体生效方式,应以当前 PostgreSQL 版本的参数上下文为准,并通过配置检查或重新加载验证。
日志中常见的关注字段包括:
elapsed 或持续时间;pages、removed 等页面处理结果;index scans;例如,下面是一段用于说明关联关系的模拟日志,不代表某个真实实例的采样结果:
automatic vacuum of table "app.public.orders":
index scans: 1
pages: 820000 removed, 1250000 remain
tuples: 6800000 removed, 98200000 remain
buffer usage: 175000 hits, 92000 misses, 18000 dirtied
avg read rate: 38.4 MB/s, avg write rate: 7.6 MB/s
system usage: CPU 42.8s/18.1u sec elapsed 96.4 sec
如果这段日志之后 n_dead_tup 下降、表大小基本稳定,且 I/O 延迟和业务响应时间没有明显恶化,通常可以判断这次清理有效。相反,如果日志显示清理运行了很久,但删除元组数量接近于零,就需要检查长事务、复制槽或其他事务可见性问题。
autovacuum 是否“正常”,不仅是数据库内部状态问题,还要看它是否与服务器资源争用形成了业务影响。
清理过程会消耗 CPU,索引较多或表更新频繁时更明显。单独看到 CPU 升高并不能说明 autovacuum 异常,因为查询计划变化、批量排序、检查点或备份也可能造成同样现象。
更有指向性的组合是:
如果只看到 CPU 高,但 autovacuum 持续时间稳定、I/O 正常、业务延迟没有变化,应该先排除其他后台任务。若出现 Swap,清理过程可能进一步变慢,不能简单通过增加 autovacuum_max_workers 解决。
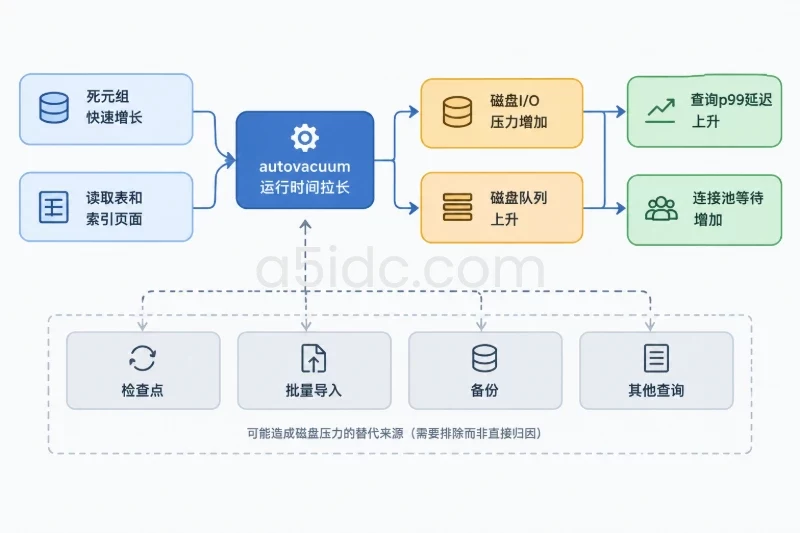
autovacuum 需要读取表和索引页面,也可能产生脏页写入。磁盘吞吐尚未达到设备标称上限时,I/O 延迟和队列仍可能先恶化。建议同时观察:
典型的异常链路是:死元组快速增长,autovacuum 运行时间拉长,磁盘队列上升,查询 p99 延迟和连接池等待同步增加。此时应该先判断是清理任务过多,还是磁盘本来就已被检查点、批量导入、备份或其他查询占满。
autovacuum 本身通常不是网络流量的主要来源,但监控不能忽略网络与应用侧指标。数据库 I/O 变慢后,连接会持有更长时间,应用可能出现:
如果数据库主机本地 I/O、autovacuum 持续时间和查询延迟同时升高,而网络丢包、重传和连接建立时间没有异常,网络通常不是首要原因。反过来,如果数据库指标相对平稳,只有应用网络延迟和连接错误率升高,则不应把问题归因于死元组。
autovacuum 已经运行,并不等于旧行版本一定能被删除。只要仍有事务需要看到这些旧版本,清理就可能保留它们。
重点检查长时间处于 idle in transaction 或持续运行的事务:
SELECT
    pid,
    usename,
    datname,
    client_addr,
    state,
    xact_start,
    now() - xact_start AS xact_age,
    backend_xmin,
    wait_event_type,
    wait_event,
    LEFT(query, 160) AS query_text
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;
重点关注以下情况:
idle in transaction;复制槽可以在主库上进一步核对:
SELECT
    slot_name,
    slot_type,
    active,
    xmin,
    catalog_xmin,
    restart_lsn,
    pg_size_pretty(
        pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)
    ) AS retained_wal
FROM pg_replication_slots;
查询结果需要结合业务和复制拓扑解释。不要因为发现一个老事务就直接终止会话;终止事务可能造成业务回滚、锁释放和重试风暴。应先确认连接归属、事务用途、是否有未提交业务,再按变更流程处理,并保留回滚或恢复方案。
在支持该视图的 PostgreSQL 版本中,可以查看当前清理阶段:
SELECT
    pid,
    datname,
    relid::regclass AS table_name,
    phase,
    heap_blks_total,
    heap_blks_scanned,
    heap_blks_vacuumed,
    index_vacuum_count,
    num_dead_tuples,
    max_dead_tuples
FROM pg_stat_progress_vacuum;
不同阶段的含义并不相同:
scanning heap 说明正在扫描表;vacuuming indexes 说明正在处理索引;vacuuming heap 说明正在清理堆表页面;vacuuming heap 长时间不动,可能受 I/O 或资源限制影响;n_dead_tup 不下降,需要结合日志检查是否被取消或是否只是完成了低收益清理。还要关注 autovacuum_max_workers。worker 数量过少时,多个大表可能排队;但盲目增加 worker 也可能同时放大磁盘竞争。调整前应先确认磁盘队列、I/O 延迟、CPU 和业务 p99 延迟是否有余量。
下面数据是用于说明分析方法的模拟监控样例:
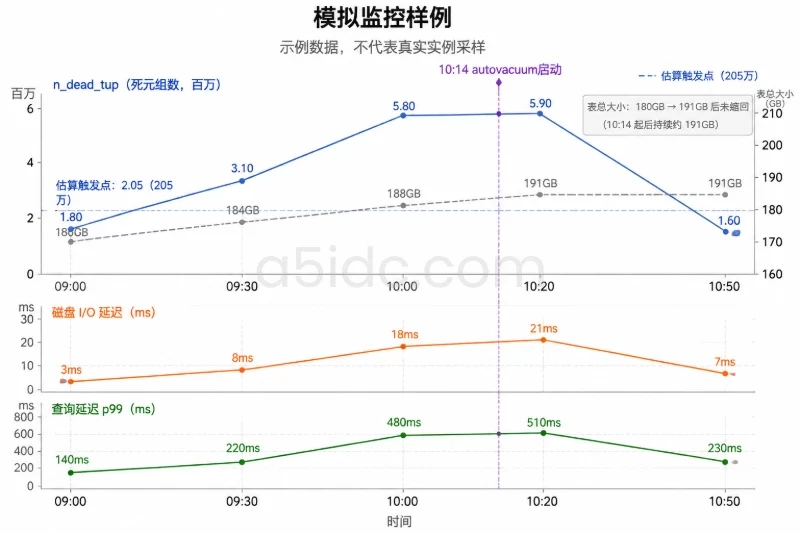
| 时间 | n_dead_tup | 估算触发点 | 最近清理时间 | 表总大小 | 磁盘 I/O 延迟 | 查询 p99 | 观察 |
|---|---|---|---|---|---|---|---|
| 09:00 | 180 万 | 205 万 | 08:42 | 180 GB | 3 ms | 140 ms | 接近触发点,业务正常 |
| 09:30 | 310 万 | 205 万 | 08:42 | 184 GB | 8 ms | 220 ms | 已超过基线触发点,清理尚未出现 |
| 10:00 | 580 万 | 205 万 | 08:42 | 190 GB | 18 ms | 480 ms | 死元组、I/O、延迟同步恶化 |
| 10:20 | 590 万 | 205 万 | 10:14 | 191 GB | 21 ms | 510 ms | 清理已启动,但资源争用仍在 |
| 10:50 | 160 万 | 205 万 | 10:14 | 191 GB | 7 ms | 230 ms | 清理有效,表文件未缩小但业务恢复 |
这组数据不能只得出“表膨胀了”的结论。更完整的判断是:
last_autovacuum,需要检查 worker、锁和日志。VACUUM 不负责收缩文件。VACUUM FULL。比较实用的告警规则可以分为三层。
满足以下任一条件时记录趋势,但不立即升级:
last_autovacuum 超过该表正常写入周期;组合条件成立时通知数据库维护人员:
n_dead_tup 超过估算触发点;只有出现业务影响或容量风险时升级:
阈值应按表类型分层。高频更新表、订单状态表、日志表和低频归档表不应共用同一死元组比例。告警还应设置恢复条件,例如死元组回落、清理计数增加、I/O 延迟恢复,并配置合并窗口,避免一个长时间运行的 vacuum 每分钟产生一条重复告警。
如果确认只是普通清理滞后,优先从写入模式、表级 autovacuum 参数、worker 排队和磁盘余量入手。调整参数前应记录当前值,并先在单表或低风险时段验证;过低的 scale factor 会增加清理频率,过高则可能让死元组长期累积。
如果确认存在长事务,应先处理事务来源和连接池行为。不要把终止会话当作通用修复手段。
如果确认表文件已经存在大量不可复用空间,普通 VACUUM 可能无法降低文件大小。VACUUM FULL 会重写表并通常需要较强的表级锁,同时需要额外磁盘空间,可能影响在线业务,不应在磁盘紧张或高峰期直接执行。任何重写、重建索引或表结构变更都应提前备份、评估锁影响、确认回滚方案,并在维护窗口内验证。
下一次排查 PostgreSQL autovacuum 时,建议至少同时观察这一组指标:n_dead_tup 增长率、估算触发点、last_autovacuum 与清理次数、清理日志中的删除量和持续时间、表与索引大小、长事务与复制槽、CPU、内存、I/O 延迟、磁盘队列、查询 p95/p99、锁等待、连接池队列和错误率。只有这些指标在同一时间语境下相互印证,才能区分“清理正在正常追赶”“触发条件不适合”“清理被事务阻塞”和“真正的资源或膨胀故障”。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6970.html