香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


现有 Linux 服务器要把一批导入文件统一转成 UTF-8 时,先不要对目录执行批量覆盖。应先确认哪些文件属于本次处理范围,用字节检查和业务内容核对原编码,再按已确认的来源分组转换到独立目录。file 的判断或一次 iconv 成功,都不足以单独证明原编码正确。
避免覆盖乱码的关键是把“识别、转换、验收、替换”分开:保留原文件和可恢复副本,只发布已经检查过的转换结果。下面以已有业务目录中的 CSV 文件为例;文本、日志等文件可以采用相同流程,但不能不加筛选地混入同一批次。
批量转换与验收流程也需要稳定的服务器资源承载文件读取、转换任务和业务应用。A5idc数据提供香港、美国、日本等地区的物理服务器,配置涵盖Xeon与AMD EPYC处理器、SSD或NVMe存储,并有多种内存与网络线路方案,可用于企业后台、数据库及文件处理等业务部署。不同地区和产品系列各有相应配置,为运行日常运维任务和业务服务提供硬件资源基础。
假设待处理文件位于 /srv/app/import/legacy,下游程序要求 UTF-8。操作前先与业务方确认:哪些文件仍会被上传或修改,哪些文件已被程序读取,转换后是否需要保留 UTF-8 BOM,以及程序依据文件内容、HTTP 声明还是导入参数判断编码。若应用仍按 GBK 或 GB18030 读取文件,仅替换文件字节会使原本正常的内容显示为乱码。
同时确认以下边界:
.csv 不保证内容一定是文本,也不能把压缩包、图片或数据库文件交给文本转换命令。先用只读命令查看范围。以下命令采用 GNU/Linux 常见的 find、file 和 iconv;若服务器缺少某个命令,应先核验环境,不要直接改用未经验证的参数组合。
input=/srv/app/import/legacy

test -d "$input" || { printf '目录不存在\n' >&2; exit 1; }
command -v find
command -v file
command -v iconv
locale charmap
find "$input" -type f -name '*.csv' -printf '%p\n'
locale charmap 显示的是当前终端或进程环境使用的字符集,不是这些 CSV 文件的原编码。文件名中可能包含换行符,因此上面的路径输出只适合人工概览;后续批量命令使用 NUL 分隔路径。
先从每个来源批次挑选样本,覆盖中文、数字、标点、特殊字符及较长字段。对样本运行:
sample=/srv/app/import/legacy/daily/report.csv

file --mime-encoding -- "$sample"
od -An -tx1 -N 64 -- "$sample"

if iconv -f UTF-8 -t UTF-8 < "$sample" > /dev/null 2>&1; then
    printf '可作为 UTF-8 解码\n'
else
    printf '不能完整作为 UTF-8 解码\n'
fi
file 给出的是基于内容特征的判断;unknown-8bit 不是一个可直接用于转换的原编码。od 可以检查开头是否有 UTF-8 BOM(ef bb bf)、明显的二进制内容或其他值得进一步核对的字节特征。UTF-8 解码测试通过,只说明字节序列有效;纯 ASCII 文件也会通过,个别其他编码的文件也可能碰巧通过。
对来源已知、但编码名称尚待确认的样本,可分别试转到临时文件。例如历史导出程序明确使用 GB18030 时:
iconv -l | grep -i 'GB18030'
iconv -f GB18030 -t UTF-8 < "$sample" > /tmp/encoding-sample.utf8
file --mime-encoding -- /tmp/encoding-sample.utf8
接着在能够按 UTF-8 正确显示文本的工具中,核对人名、地名、字段标题和标点。iconv 返回成功不等于内容正确:选错原编码也可能生成有效的 UTF-8,只是文字已变成乱码。若样本里同时出现正常文字与乱码,应先查是否在上游已经发生过错误解码或混合编码;不要通过反复套用编码转换来“试到看起来正常”。
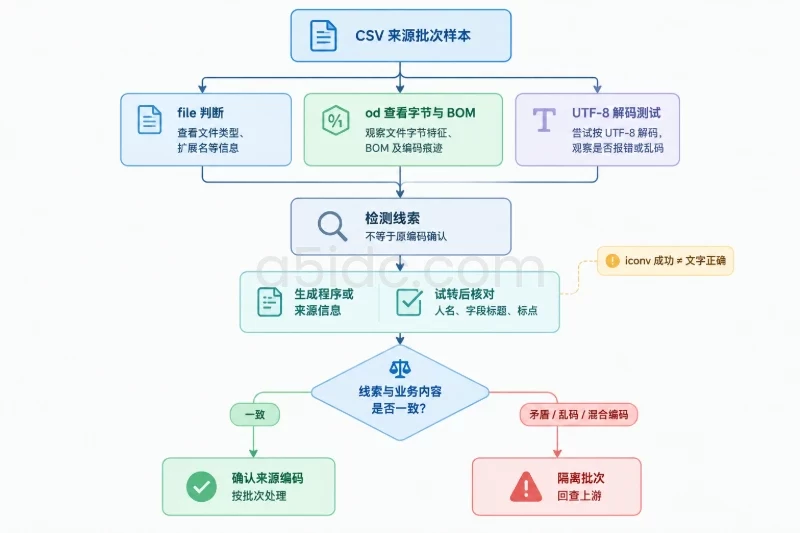
业务文件还可能带有编码声明。检查 CSV 导入配置、XML 声明或配套说明,确认转换后声明与实际字节一致。BOM 是否保留也应按下游程序要求决定,不把去 BOM 当作批量转换的默认动作。
下面的示例只适用于已确认来源为 GB18030、且已圈定的 CSV 批次。其中 UTF-8 解码测试通过的文件会被跳过,但“跳过”不代表已证明其原编码;应在发布前核对这些文件是否属于混入批次的 UTF-8 文件。工作目录必须位于输入目录之外,并使用一个尚不存在的新路径,避免混入上次运行结果。
#!/usr/bin/env bash
set -euo pipefail
umask 077

input=/srv/app/import/legacy
work=/srv/app/encoding-job-001
backup=$work/original
stage=$work/utf8

test -d "$input"
test ! -e "$work"
mkdir -- "$work"
mkdir -- "$backup" "$stage"

find "$input" -type f -name '*.csv' -print0 > "$work/files.nul"

while IFS= read -r -d '' src; do
    rel=${src#"$input"/}
    parent=${rel%/*}
    if [[ "$parent" == "$rel" ]]; then
        parent=.
    fi

    mkdir -p -- "$backup/$parent" "$stage/$parent"
    cp -a -- "$src" "$backup/$rel"
    cmp -s -- "$src" "$backup/$rel"

    if iconv -f UTF-8 -t UTF-8 < "$src" > /dev/null 2>&1; then
        printf '跳过,UTF-8 测试通过:%q\n' "$rel"
        continue
    fi

    if ! iconv -f GB18030 -t UTF-8 < "$src" > "$stage/$rel"; then
        printf '转换失败,停止本批次:%q\n' "$rel" >&2
        exit 1
    fi

    iconv -f UTF-8 -t UTF-8 < "$stage/$rel" > /dev/null
    printf '%s\0' "$rel" >> "$work/converted.nul"
    printf '待验收:%q\n' "$rel"
done < "$work/files.nul"
这段脚本只创建副本和待验收文件,不覆盖业务目录。files.nul 固定了本次扫描得到的路径列表,NUL 分隔可以避免空格、引号或换行符破坏循环。cp -a 尽量保留原文件元数据,cmp 则检查备份的文件内容与读取时的原件一致;它不能防止业务进程随后修改原文件,所以发布前仍需停止写入并再次比对。
转换失败时,stage 中可能留有不完整的输出文件。不要发布它,也不要在未查明原因前给 iconv 加忽略错误的选项。确认失败原因后,使用新的工作目录重跑更容易分辨各次结果。
验收不能只看命令退出状态。先核对待转换数、跳过数、失败数,并抽查每个来源批次的开头、中间和末尾记录。重点检查中文字段、分隔符、引号、换行及文件末尾;UTF-8 有效性测试可用于发现不合法字节,但不能替代业务内容检查。
stage=/srv/app/encoding-job-001/utf8
result=$stage/daily/report.csv

test -f "$result"
file --mime-encoding -- "$result"
iconv -f UTF-8 -t UTF-8 < "$result" > /dev/null
wc -l < "$result"
wc -l 统计的是换行符数量,不一定等于 CSV 的业务记录数,尤其是字段允许包含换行时。若有导入程序的校验模式,应以其字段数、记录数和关键字段检查作为发布依据。对于带 BOM、换行格式或编码声明要求的业务,还须分别验收这些条件。
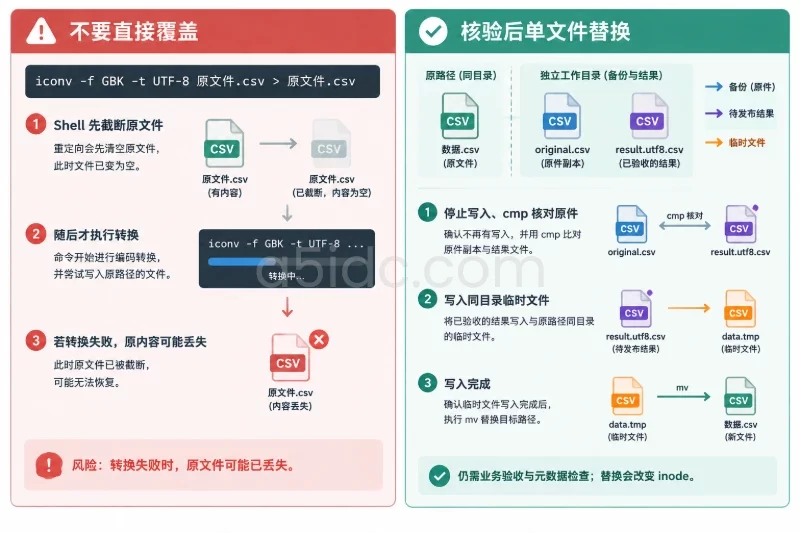
确认应用已停止写入、备份可读取,并选定一个小批次后,才进行替换。不要使用 iconv ... > 原文件:Shell 会先截断原文件,再执行转换,失败时原内容也可能丢失。单文件发布可采用“同目录临时文件写入完成后替换”的方式;操作前确认目标不是符号链接、没有依赖原 inode 的硬链接,且 ACL、扩展属性和安全标签的处理方式符合当前环境。
src=/srv/app/import/legacy/daily/report.csv
saved=/srv/app/encoding-job-001/original/daily/report.csv
result=/srv/app/encoding-job-001/utf8/daily/report.csv

test -f "$src" && test ! -L "$src"
test -f "$saved" && test -f "$result"
cmp -s -- "$src" "$saved" || {
    printf '原文件已变化,停止发布\n' >&2
    exit 1
}

tmp=$(mktemp "${src}.encoding.XXXXXX")
cp -a -- "$src" "$tmp"
cat < "$result" > "$tmp"
mv -f -- "$tmp" "$src"
mv 会替换该路径指向的文件,影响所有随后读取此路径的程序;同目录临时文件在写完后替换,可避免程序读到写了一半的转换结果,但不能代替停写、业务验收和权限检查。上述方式也会改变目标文件的 inode;对硬链接、文件监视器或有特殊元数据要求的场景,不应直接套用。逐批发布后检查 stat、必要的 ACL 和安全标签,并用实际读取程序试读。
如果 file 的结果、UTF-8 测试与业务内容互相矛盾,先隔离该批次,回查生成程序及历史导出参数。若 iconv 报非法字节序列,定位对应文件并检查是否截断、混入二进制片段或单文件内编码不一致;不要为了让整批命令跑完而丢弃错误字符。
如果转换文件本身可读,但应用显示乱码,先核对应用的读取编码、导入参数及内容声明,不急于再次转换。若发布后确认文件内容不符合要求,应停止相关写入,从本次工作目录的 original 中取回已核验的原件,按同目录临时文件替换流程恢复对应路径,再核对权限和业务读取结果。恢复前保留错误版本供排查;不要把当前目录里可能已被应用修改的文件当作原始备份。
正式放行前,按本次批次逐项确认:
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6824.html