香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


在 Linux 物理服务器上,判断 PCIe 设备属于哪个 NUMA 节点,优先查看设备对应的 sysfs 属性,而不是只看机箱上的插槽编号或 lspci 的总线地址。最直接的依据通常是 /sys/bus/pci/devices/<BDF>/numa_node,再结合 local_cpulist、主机 NUMA 拓扑和实际工作进程的 CPU、内存分布进行判断。
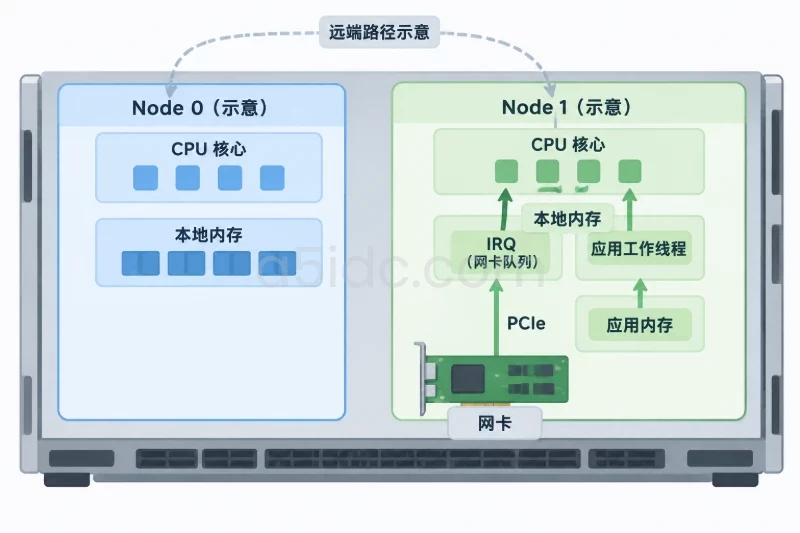
需要注意的是,“PCIe 设备属于 NUMA 节点 1”只表示操作系统认为它与节点 1 的 PCIe 根端口或 I/O 子系统更接近,并不等于所有访问都发生在节点 1。只有当工作线程所在 CPU、DMA 缓冲区所在内存节点、PCIe 设备的归属节点不一致时,才可能形成跨节点访问;是否造成明显性能影响,还要看访问方向、流量规模、队列与中断分布等条件。
NUMA 是处理器、内存和 I/O 设备之间的距离关系。双路服务器通常至少有两个 NUMA 节点,但“NUMA 节点 0”不一定永远等于物理 CPU 插槽 0:
因此,不应仅凭 CPU0、Socket 0 或机箱标签推断 PCIe 设备归属。应先查看操作系统识别出的节点和 CPU 映射。
判断跨节点影响时,至少要分别确认以下三项:
| 对象 | 需要确认的内容 | 典型查看方式 |
|---|---|---|
| PCIe 设备 | 设备被内核归属到哪个 NUMA 节点 | /sys/bus/pci/devices/<BDF>/numa_node |
| 工作线程 | 进程或线程运行在哪些 CPU、对应哪些节点 | taskset、ps、lscpu |
| DMA 缓冲区 | 设备读写的内存主要位于哪个 NUMA 节点 | numastat、/proc/<PID>/numa_maps、驱动行为 |
理想状态通常是三者尽量一致。例如,网卡归属节点 1,收包线程运行在节点 1 的 CPU 上,接收缓冲区也从节点 1 分配。若网卡在节点 1,但线程固定在节点 0,数据包到达后的处理就可能需要跨节点访问。
不过,不同设备的关键路径并不完全相同:
PCIe 设备并不是直接连接到所有 CPU,而是挂在某个 PCIe Root Complex、Root Port 或 PCIe Switch 后面。服务器主板上的每组 PCIe 插槽,通常由某个处理器或 I/O Die 提供。
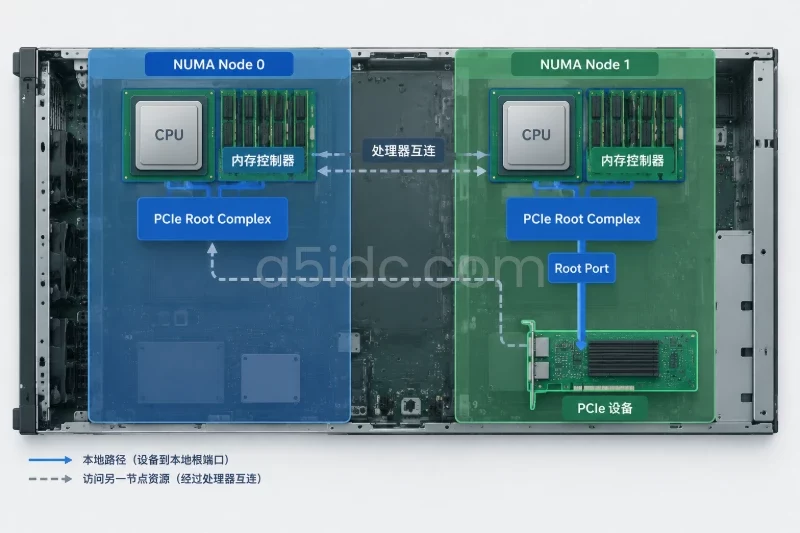
一个简化的路径可以表示为:
CPU NUMA Node 0 ─ 内存控制器 0
              └ PCIe Root Complex 0 ─ Root Port ─ PCIe 设备

CPU NUMA Node 1 ─ 内存控制器 1
              └ PCIe Root Complex 1 ─ Root Port ─ PCIe 设备
当设备位于节点 1 的 Root Complex 下时,Linux 通常会将其 numa_node 标记为 1。设备访问节点 1 的内存,或者节点 1 的 CPU 访问设备控制寄存器,路径通常更短;访问另一个节点的资源,则可能经过处理器之间的互连链路。
实际服务器中还可能存在 PCIe Switch、桥接芯片、重定时器或专用 I/O 芯片,因此物理插槽位置只能作为参考,不能代替系统拓扑信息。
numa_node 是内核的邻近关系标记Linux 常见的 PCIe 设备目录如下:
/sys/bus/pci/devices/0000:3b:00.0/
其中:
0000 是 PCI 域;3b 是总线号;00 是设备号;.0 是功能号。这个完整地址也称为 BDF。设备目录中的 numa_node 一般由固件提供的 ACPI 拓扑信息和内核解析结果形成。常见值包括:
0
1
-1
其中 0 和 1 表示节点编号,-1 表示系统没有提供明确的 NUMA 归属。-1 不一定说明设备性能异常,也可能是固件没有描述 I/O 邻近关系、内核无法解析,或者设备位于虚拟化或特殊桥接路径之后。
local_cpulist 则通常表示与该 PCIe 设备邻近的 CPU 列表。例如:
48-95
它可以帮助判断哪些 CPU 更适合承担该设备的中断和工作线程,但它同样是拓扑建议,不是强制调度规则。
如果设备归属节点 1,而进程只运行在节点 0 的 CPU 上,常见影响包括:
对于低速管理流量,这些差异可能不明显。对于高包速网络、低延迟存储或大量小 I/O,额外的访问路径更容易体现为延迟抖动、CPU 占用上升或吞吐下降。
设备进行 DMA 时,真正需要关注的是 DMA 目标或源内存位于哪个节点。例如:
PCIe 网卡:节点 1
接收缓冲区:节点 0
此时网卡写入数据时,数据需要从设备所在的 I/O 路径到达节点 0 的内存控制器。即使收包线程也运行在节点 0,设备到内存的路径仍然可能是跨节点的。
反过来,如果:
PCIe 网卡:节点 1
接收缓冲区:节点 1
收包线程:节点 0
设备 DMA 可能较为接近,但 CPU 处理数据时仍然要访问节点 1 的内存。这个场景不能简单归类为“完全本地”或“完全远端”,而应区分设备到内存、CPU 到内存两个方向。
多队列网卡、NVMe 控制器和加速卡通常会产生多个 MSI-X 中断。即使设备和内存配置正确,如果中断被调度到远端 CPU,处理链路仍可能跨节点。
网卡的典型路径是:
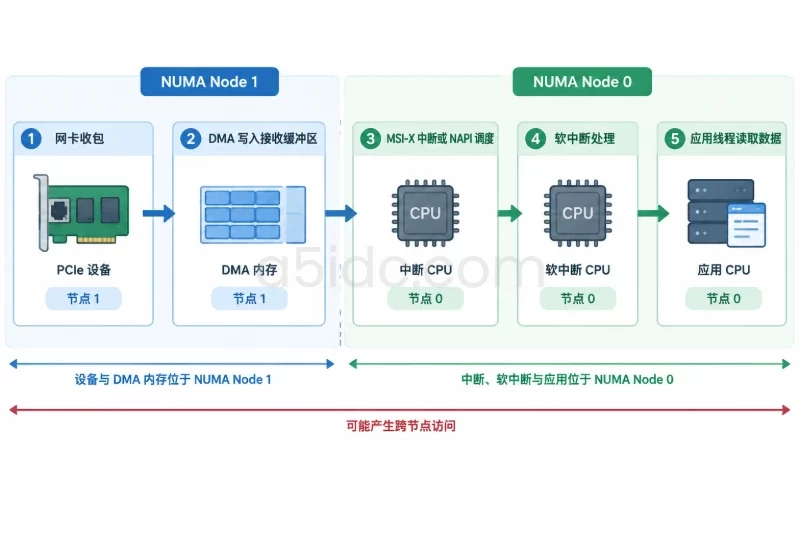
设备收包
  → DMA 写入接收缓冲区
  → MSI-X 中断或 NAPI 调度
  → 软中断处理
  → 应用线程读取数据
这条路径涉及设备、DMA 内存、中断 CPU 和应用 CPU 四个位置。只查看设备 numa_node,不能证明整个数据路径都是本地的。
NUMA 不应成为所有 PCIe 性能问题的默认解释。设备协商到的链路宽度和速率同样重要。例如,设备原本应为 Width x16,但实际只协商到 Width x8,即使 NUMA 分布完全合理,也可能出现明显吞吐差异。
因此,判断时应同时留意:
以下示例以 Linux 物理机上的 PCIe 设备 0000:3b:00.0 为例。命令主要是读取 sysfs、查看拓扑和读取统计信息,不会修改设备配置。
先列出 PCIe 设备:
lspci -Dnn
示例输出:
0000:3b:00.0 Ethernet controller [0200]: Example Network Adapter [1234:5678]
0000:5e:00.0 Non-Volatile memory controller [0108]: Example NVMe Controller [1abc:1001]
0000:af:00.0 VGA compatible controller [0300]: Example Accelerator [1def:2002]
使用完整 BDF 可以避免多 PCI 域或相同总线号导致的歧义:
BDF=0000:3b:00.0
lspci -Dnn -s "$BDF"
查看详细信息:
lspci -Dvv -s "$BDF"
在部分 pciutils 版本中,详细输出会包含类似内容:
NUMA node: 1
LnkCap: Port #0, Speed 32GT/s, Width x16
LnkSta: Speed 32GT/s, Width x16
Kernel driver in use: example_driver
lspci 是否显示 NUMA node 取决于版本和系统环境。没有显示时,不代表设备没有 NUMA 信息,应以 sysfs 为准。
numa_node 和本地 CPUBDF=0000:3b:00.0
DEV="/sys/bus/pci/devices/$BDF"
printf 'NUMA node: '
if [ -r "$DEV/numa_node" ]; then
cat "$DEV/numa_node"
else
echo "unavailable"
fi
printf 'Local CPUs: '
if [ -r "$DEV/local_cpulist" ]; then
cat "$DEV/local_cpulist"
else
echo "unavailable"
fi
printf 'Device path: '
readlink -f "$DEV"
典型示例:
NUMA node: 1
Local CPUs: 48-95
Device path: /sys/devices/pci0000:80/0000:80:02.0/0000:3b:00.0
这里可以得到三个重要信息:
NUMA node: 1:内核认为设备邻近节点 1;Local CPUs: 48-95:这些 CPU 通常属于设备的本地 CPU 范围;Device path:可以观察设备经过了哪个 PCIe 总线层级。如果需要查看原始 CPU 位图,也可以读取:
cat "$DEV/local_cpus"
local_cpus 常以十六进制位图表示,人工阅读不如 local_cpulist 直观。
lspci -Dtv
示例:
-[0000:80]-+-00.0
           +-02.0-[3b]----00.0
           +-03.0-[5e]----00.0
在树形输出中,先找到目标设备,再向上观察它经过的桥和 Root Port。若设备位于复杂的 PCIe Switch 后面,可以同时查看相关上游桥的详细信息:
lspci -Dvv -s 0000:80:02.0
lspci -Dvv -s 0000:3b:00.0
上游桥和终端设备的 numa_node 通常应当具有一致的邻近关系。如果终端设备显示为 -1,但上游 Root Port 有明确节点,说明需要进一步结合固件、内核版本和设备驱动判断,不能直接把 Root Port 的节点强行当成设备节点。
numactl --hardware
示例输出:
available: 2 nodes (0-1)
node 0 cpus: 0-47
node 0 size: 257800 MB
node 0 free: 218400 MB
node 1 cpus: 48-95
node 1 size: 257900 MB
node 1 free: 221100 MB
node distances:
node   0   1
  0:  10  21
  1:  21  10
这里可以判断:
0-47;48-95;10、21 这类距离值是固件和内核使用的相对尺度,不应直接当作纳秒延迟。也可以使用:
lscpu -e=CPU,NODE,SOCKET
示例:
CPU NODE SOCKET
  0    0      0
  1    0      0
...
 48    1      1
 49    1      1
若需要逐个查看节点距离:
for f in /sys/devices/system/node/node*/distance; do
    printf '%s: ' "$f"
    cat "$f"
done
设备节点为 1、本地 CPU 为 48-95,而工作进程被绑定在 0-47 时,可以明确判断为“设备与工作 CPU 存在跨 NUMA 节点关系”。
但这还不能直接等同于“性能一定下降”。还要继续确认进程内存和设备 DMA 缓冲区位置。
先从接口名称反查 PCIe BDF:
IF=ens5f0

readlink -f "/sys/class/net/$IF/device"
cat "/sys/class/net/$IF/device/numa_node"
cat "/sys/class/net/$IF/device/local_cpulist"
示例:
/sys/devices/pci0000:80/0000:80:02.0/0000:3b:00.0
1
48-95
查看网卡队列和驱动信息:
ethtool -i "$IF"
ethtool -l "$IF"
查看中断落在哪些 CPU:
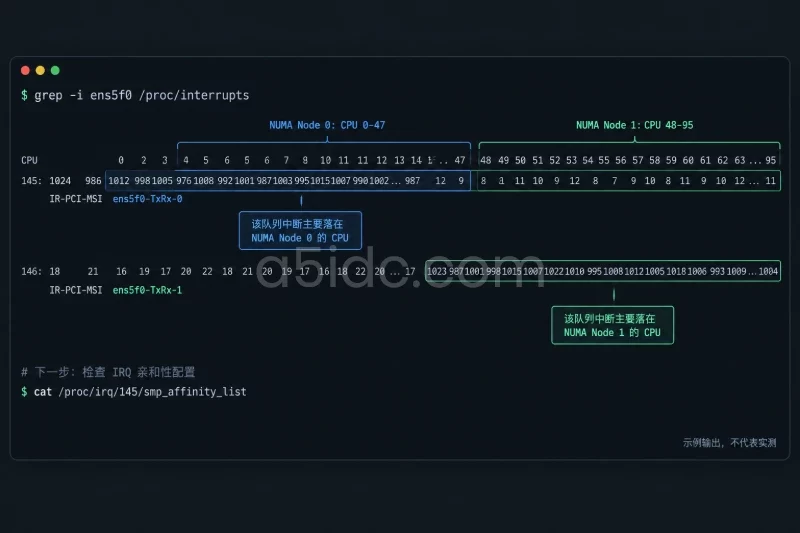
grep -i "$IF" /proc/interrupts
示例:
  145:   12003455          0          0          0  IR-PCI-MSI  524288-edge  ens5f0-TxRx-0
  146:          0   11894521          0          0  IR-PCI-MSI  524289-edge  ens5f0-TxRx-1
再查看对应 IRQ 的 CPU 亲和性:
cat /proc/irq/145/smp_affinity_list
cat /proc/irq/146/smp_affinity_list
如果网卡节点为 1,但网卡主要中断位于 0-47,且收发线程也运行在节点 0,就存在较明确的跨节点处理路径。此时应结合包速率、软中断 CPU 占用、队列利用率和应用延迟观察实际影响。
先确认控制器名称:
ls -l /sys/class/nvme/
读取控制器的 NUMA 属性:
CTRL=nvme0

readlink -f "/sys/class/nvme/$CTRL/device"
cat "/sys/class/nvme/$CTRL/device/numa_node"
cat "/sys/class/nvme/$CTRL/device/local_cpulist"
查看 NVMe 中断分布:
grep -i nvme /proc/interrupts
块设备层面的 I/O 统计可以使用:
iostat -x 1 5
如果 NVMe 控制器属于节点 1,而 I/O 提交线程固定在节点 0,或者 I/O 缓冲区主要位于节点 0,则需要进一步比较本地和远端绑定条件下的延迟、队列深度和 CPU 使用率。不能仅凭磁盘设备名或 /dev/nvme0n1 判断 NUMA 关系。
可以把核对结果整理成如下形式:
| 检查项 | 示例结果 | 判断 |
|---|---|---|
| PCIe 设备节点 | 1 | 设备邻近节点 1 |
| 工作线程 CPU | 0-47 | 工作线程位于节点 0 |
| DMA 或应用内存 | 0 | 设备或 CPU 访问节点 0 内存 |
| 中断 CPU | 48-95 | 中断位于节点 1 |
| NUMA 距离 | 10/21 | 节点 0 与节点 1 存在明显相对距离 |
这个例子中,设备到内存可能较远,但中断处理 CPU 与设备同节点;最终影响取决于应用线程是否需要频繁读取 DMA 数据,以及数据缓冲区最终位于哪个节点。
假设进程 PID 为 8421:
PID=8421

taskset -pc "$PID"
ps -o pid,psr,comm -p "$PID"
numastat -p "$PID"
taskset 显示的是允许使用的 CPU 范围,不一定代表进程此刻一直运行在这些 CPU 上。多线程程序还需要逐线程检查:
ls /proc/"$PID"/task
对具体线程查看:
TID=8450
taskset -pc "$TID"
ps -o pid,tid,psr,comm -p "$TID"
numastat -p 可显示进程内存按节点的分布。示例数据如下:
Per-node process memory usage (in MBs) for PID 8421
                           Node 0   Node 1   Total
Private                     812       34     846
Heap                        460       12     472
Stack                         8        0       8
Mapped                      340       22     362
Total                       820       34     854
这个结果表示进程大部分页面位于节点 0。若设备归属节点 1,则设备 DMA 到这些页面时可能产生跨节点访问。
还可以抽样查看页面分布:
grep -E '(^[0-9a-f]+-| N[0-9]+=)' "/proc/$PID/numa_maps" | head -n 20
numastat 和 numa_maps 反映的是页面分布,不是设备 DMA 字节数。它们可以帮助定位“内存放在哪里”,但不能单独证明某条 PCIe 链路已经成为瓶颈。
如果需要验证跨节点是否造成可观测影响,可以在同一台服务器、相同负载和相同数据规模下做本地与远端对照。以下示例只对测试进程生效:
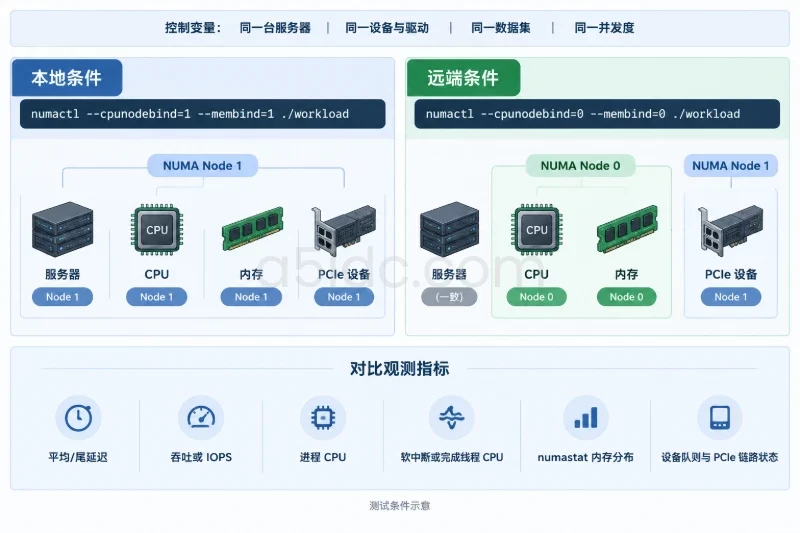
numactl --cpunodebind=1 --membind=1 ./workload
这表示将测试进程的 CPU 和内存都绑定到节点 1。如果 PCIe 设备也位于节点 1,可作为较接近本地的测试条件。
再进行远端对照:
numactl --cpunodebind=0 --membind=0 ./workload
比较时至少记录:
numastat -p 显示的内存节点分布;如果只有 CPU 和内存节点发生变化,设备、驱动、数据集和并发度保持一致,并且多次测试都出现稳定差异,才能较有把握地将差异归因于 NUMA 路径。一次采样中的延迟波动,不能直接作为跨节点影响的证据。
测试绑定也有边界:对于网卡,仍需考虑 IRQ 和 NAPI 线程;对于 NVMe,需要考虑完成队列和工作线程;对于 GPU 或专用加速卡,还要检查设备驱动的内存分配策略。
以下条件同时出现时,风险较明确:
numa_node 为 1;numastat -p 显示应用页面主要在节点 0;这时应优先调整工作线程、IRQ、队列和内存分配,使它们尽量围绕设备所属节点布局。
以下结果只能说明拓扑关系,不能单独证明性能已经受损:
numa_node 不同,但应用大部分时间并不访问该设备;numastat 显示内存跨节点,但设备 DMA 很少;NUMA 是性能分析的一个维度,不是所有 PCIe 问题的统一解释。链路降速、设备共享 Switch 上行、驱动队列不足、IOMMU 映射、锁竞争和应用本身的批处理策略,都可能产生类似现象。
numa_node=-1、虚拟机和特殊设备的限制numa_node=-1 时不要强行推断如果执行:
cat /sys/bus/pci/devices/0000:3b:00.0/numa_node
得到:
-1
应将结果标记为“NUMA 归属未知”,而不是默认归到节点 0。可以继续查看:
readlink -f /sys/bus/pci/devices/0000:3b:00.0
lspci -Dtv
lspci -Dvv -s 0000:3b:00.0
同时检查 BIOS 的 NUMA、I/O 资源和处理器拓扑设置,以及内核版本是否正确识别该平台。若上游 Root Port 有节点信息而终端设备没有,只能把上游信息作为参考,不能替代设备自身属性。
在虚拟机中,PCIe 设备可能是虚拟设备、直通设备或 SR-IOV VF。虚拟机内看到的:
numa_node;不一定等同于物理宿主机的 PCIe 拓扑。直通设备还需要同时检查宿主机上的 PF、Root Port 和物理插槽关系。容器通常共享宿主机内核,但权限和可见的 sysfs 内容可能受到限制。
如果数据在 GPU、网卡、NVMe 或其他加速设备之间直接传输,CPU 内存的 NUMA 归属不一定代表完整数据路径。P2P DMA 可能受 PCIe Root Complex、ACS、IOMMU、设备驱动和硬件兼容性影响。
因此,针对这类场景,numa_node 只能回答“设备靠近哪个 NUMA 节点”,不能单独回答“两个设备之间是否能够本地直连”或“数据是否一定经过主机内存”。
判断物理服务器 PCIe 设备的 NUMA 归属,建议采用以下证据链:先用完整 BDF 定位设备,再读取 numa_node 和 local_cpulist,用 numactl --hardware 确认节点与 CPU 映射,最后把工作线程、中断和 DMA 内存位置放在同一张关系表中。只有在拓扑结果与可重复的本地、远端性能对照相互印证时,才能把跨节点访问认定为实际影响;遇到 -1、虚拟设备、PCIe Switch 或 P2P DMA 时,则应保留“拓扑未知或路径不完整”的判断边界。
A5idc数据提供香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器,涵盖常规计算、AMD平台、GPU及存储型方案,可为数据库、网络服务和计算任务提供不同的硬件资源基础。部分产品搭配多核CPU、大容量内存与NVMe存储,香港和美国还提供GPU服务器,适用于AI推理及图像处理等负载。多地区产品的处理器、存储和网络配置各有不同,为不同部署地点与业务资源需求提供了可选方案。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6621.html