香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


Linux 中看到 shared 或 Shmem 数值较高,并不等于物理内存已经不足。它表示有一部分内存被共享内存机制使用;系统是否紧张,还要结合 MemAvailable、回收与换页情况、进程内存和容器限制判断。另一个常见误区是把“缓存”都视为可立即释放:干净的文件页通常较容易回收,而共享内存、tmpfs 数据以及脏页的回收条件并不相同。
Linux 中,“共享内存”描述内存如何被使用,“可回收缓存”描述内存能否在需要时让出来,两者不是同一分类维度。共享内存可以供多个进程访问,但这不代表内核能随时丢弃其中的数据;反过来,部分缓存虽然归类为缓存,也可能因正在写回或受到锁定而暂时不能回收。
常见监控工具里的几项数据含义如下:
| 指标 | 大致含义 | 能否直接据此判断内存不足 |
|---|---|---|
shared(free 输出) | 通常取自 /proc/meminfo 的 Shmem,反映共享内存和相关机制使用的规模 | 不能 |
Shmem | 内核统计的共享内存类用量,常涉及 tmpfs、共享匿名映射等 | 不能 |
Cached | 文件页缓存等缓存统计;其统计范围可能与 Shmem 有重叠 | 不能 |
MemAvailable | 内核估算在不大量换页的情况下还可供新任务使用的内存 | 是重要参考,但不是唯一依据 |
Swap 使用量 | 已有内存页被换出到交换空间的规模 | 单看已用量不能判断,需观察是否持续换入、换出 |
shared 不是“所有进程共同占用、且只计算一次后就能与其他指标直接相加”的完整清单。它也不是 free 中“可以免费使用”的意思。若把 Shmem、Cached、进程 RSS 等指标简单相加,可能重复计算同一批页面。
例如,一台机器显示 shared 为 3 GiB、buff/cache 为 8 GiB,并不代表共享内存和缓存合计必然独占了 11 GiB。内核统计口径存在交叉,进程映射也可能共享同一批物理页。
共享内存的目的,是让多个进程访问同一片数据,而不是为每个进程各复制一份。常见形式包括 System V 共享内存、POSIX 共享内存、基于 tmpfs 的文件,以及共享映射等。数据库、缓存服务和多进程应用可能使用这些机制;/dev/shm 则通常是挂载在 tmpfs 上的共享内存文件系统。
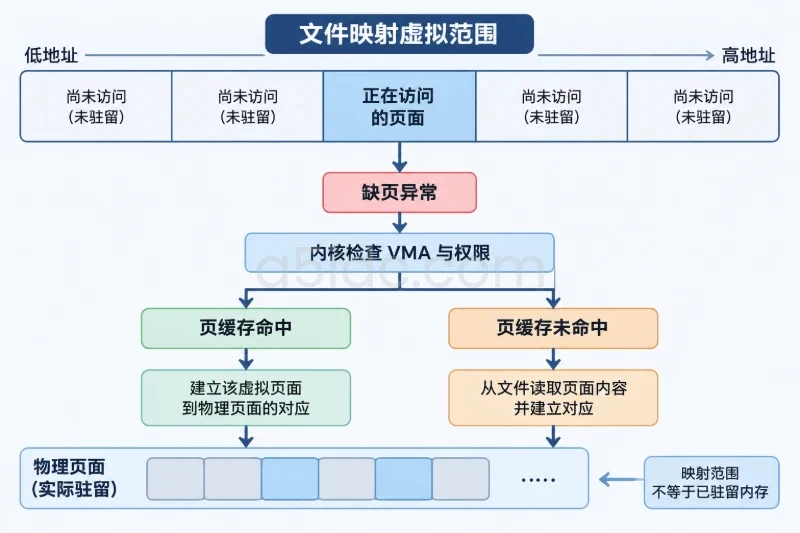
创建共享区域本身不一定会立刻占用与声明容量相等的物理内存。许多页面会在实际写入或访问后才分配、调入。应用申请了一块较大的共享区域,但只触碰其中一小部分时,实际驻留内存可能远低于申请大小。反之,页面被写入并长期持有后,它们确实会消耗内存,不能仅因为“这是共享的”就忽略。
共享页面被多个进程映射时,进程各自报告的 RSS 可能都包含这些页面,因此把多个进程的 RSS 相加会高估实际物理占用。PSS 会按共享进程数量分摊共享页面,更适合估算单个进程承担的比例;但全局容量判断仍应结合系统级内存统计,而不能只看某一个进程的 RSS 或 PSS。
共享内存被占用后是否能释放,取决于其类型和使用状态。应用仍在读写的共享区域不能简单丢弃;System V 共享段通常需要应用解除映射,并按其生命周期规则删除;tmpfs 中仍有文件数据时,也不能当作普通的干净文件缓存随意回收。若共享页可换出,系统可能把它们移入 swap,但这会增加后续访问延迟,并不等于无需代价地释放了内存。
文件页缓存是内核为了减少磁盘读取而保留的数据。文件页通常有对应的磁盘文件:如果页面是干净的,内存紧张时内核可以丢弃它,之后需要时再从存储设备读取。脏页则包含尚未写回文件系统的数据,内核通常要先安排写回,不能像干净页一样立即抛弃。
tmpfs 与普通磁盘文件缓存容易混淆。tmpfs 看起来像文件系统,数据却主要存放在内存中,并可在符合条件时使用 swap。它的内容不是一份可以从普通磁盘文件随时重读的干净副本。因此,监控中出现较高 Shmem 时,不能直接将其归为“缓存很多,可以清掉”。
简单来说,内存回收要看数据能否无损丢弃或换出,而不只看指标名称中是否出现“缓存”或“共享”。干净的普通文件页通常较易回收;正在使用的匿名页和共享页可能需要换出;脏文件页则可能要等写回。可回收 slab 等内核缓存也有自己的条件,不能与文件页、共享内存混为一谈。
Shmem 增长可能有多种原因,未必意味着故障:
/dev/shm 创建较大的临时文件或数据集。Shmem 和 MemAvailable 能完整代表它们的使用状态。判断时也要看趋势。业务启动、批处理或缓存预热期间,共享内存暂时增加并不必然异常;如果任务结束后用量不回落、持续阶梯式增长,或增长同时伴随可用内存下降、换页加剧,就需要进一步追查生命周期和应用行为。
先查看全局内存快照:
free -h
例如,假设某台机器显示:
               total        used        free      shared  buff/cache   available
Mem:             16Gi        9Gi        1Gi         3Gi         6Gi         6Gi
Swap:             4Gi        0Gi        4Gi
这里 shared 为 3 GiB 值得关注,但 available 仍有约 6 GiB,swap 当前未使用。仅凭这组数据,不能判定机器已经内存不足。表格中的数据只是用于说明判断方法的示例,不代表特定服务器的实测状态。
再检查内核提供的详细统计:
grep -E '^(MemTotal|MemFree|MemAvailable|Buffers|Cached|SwapCached|Shmem|SReclaimable|Dirty|Writeback|SwapTotal|SwapFree):' /proc/meminfo
重点看以下变化:
MemAvailable 是否持续下降,而不是仅在一次采样中偏低。Shmem 是否持续增长,是否与应用负载变化相符。Cached、SReclaimable 是否较多,以及系统是否仍能通过回收它们腾出空间。Dirty、Writeback 是否明显升高,提示脏页写回可能影响回收速度。查看 Shmem 和 Cached 时不要把两者机械相加。不同内核版本与工具可能呈现不同统计视图,而且它们之间可能存在重叠。判断“还剩多少可用内存”时,优先参考 MemAvailable,再结合回收、换页和业务延迟等现象。
用 vmstat 观察连续活动,而非只看启动后的累计值:
vmstat 1 5
输出中的 si、so 分别表示采样间隔内的换入和换出活动。若这两项持续非零,同时 MemAvailable 走低、应用响应变慢,就比“swap 已用过一些”更能说明当前存在内存压力。一次短暂的换页可能是正常波动;是否构成问题要结合持续时间、业务影响和负载判断。
先看 System V 共享内存段:
ipcs -m
该命令可以列出共享段的标识、所有者、权限和大小等信息。它适合发现可见的 System V 段,但不会覆盖所有共享内存来源,也不能仅凭段大小断定实际驻留页数;段可能已创建却没有全部触碰。
再查看共享内存目录和挂载使用量:
df -h /dev/shm
如需了解目录下有哪些文件,可使用:
ls -lh /dev/shm
df 显示的是该 tmpfs 挂载的容量使用情况,不等于整台机器的剩余内存;挂载容量也可能由启动参数或容器配置限制。ls 列出的文件大小能帮助定位对象,但稀疏文件、已删除但仍打开的文件等情况会使文件表面大小与实际占用不完全一致。
要判断某个进程映射了哪些区域,可先找到进程号,再查看汇总信息:
cat /proc/PID/smaps_rollup
将 PID 替换为实际进程号。若系统没有 smaps_rollup,可检查 /proc/PID/smaps。其中 RSS、PSS、共享和私有页面等字段有助于区分“多个进程映射同一批页面”与“各进程各自持有页面”。读取 smaps 需要一定权限,进程退出、权限限制或内核配置也可能导致信息不可用。
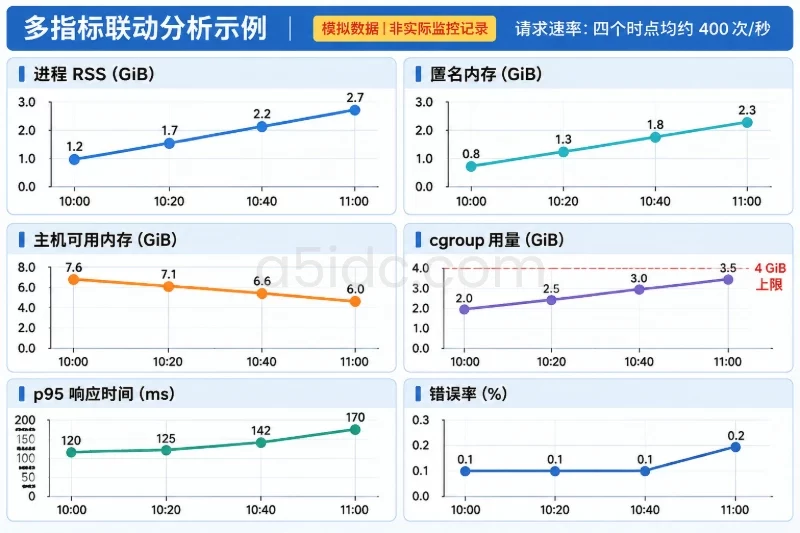
对于容器,应同时确认宿主机整体和容器自身的内存视角。容器可能受到 cgroup 内存上限约束:宿主机仍有可用内存,不代表某个容器没有触及自身限制。可在适用的 cgroup 目录中检查 memory.current、memory.max、memory.stat 等文件。具体路径和字段随 cgroup 版本、内核版本及运行环境而异;memory.stat 中的分类也可能存在包含关系,不应将所有字段直接相加。
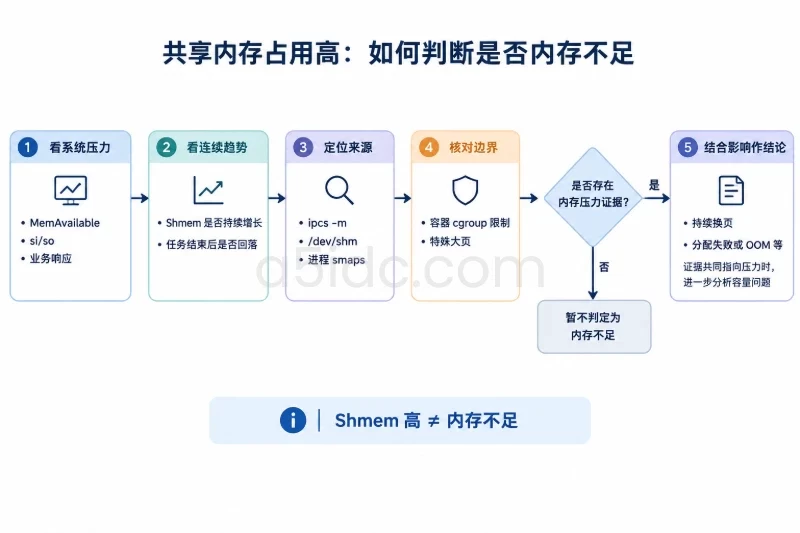
面对“共享内存占用高”,可以按以下顺序判断:
共享内存与文件缓存的判断,离不开对服务器实际内存、存储和业务负载的整体理解。A5idc数据提供香港、美国、日本等地区的物理服务器,配置涵盖大容量内存、NVMe存储及多种CPU平台,可用于承载数据库、缓存服务、业务后台和多进程应用;不同地区与系列也提供不同线路和资源组合,为数据密集型业务及多区域部署提供硬件基础。
MemAvailable、swap 换入换出和业务响应。Shmem 高但可用内存充足、换页不活跃时,通常不能据此直接判定内存不足。ipcs -m 检查 System V 段,检查 /dev/shm,并结合进程的 smaps 或 smaps_rollup 分析映射关系。高 Shmem 不能单独证明内存不足,也不能证明这部分内存可以立即回收。MemAvailable 是内核估算值,不是保证可以无延迟分配的承诺;应用的瞬时峰值、内存碎片、容器上限、NUMA 分布、锁定页面或专用大页等条件,都可能使实际分配结果不同。
free 显示的 used、shared、buff/cache 也不是互不重叠的账本。不能通过“已用内存很高”或“缓存很多”单项作结论,更不要为了让数字下降而盲目删除共享内存文件或终止进程:共享区域可能承载正在处理的数据,操作不当会影响业务或造成数据丢失。
更可靠的判断是把全局可用量、连续换页活动、共享段来源、进程映射和业务症状放在一起看。只有当这些证据共同指向持续的内存压力,或某个进程、容器已经触及自己的容量边界时,才能把“共享内存占用高”进一步判断为真实的内存容量问题。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6615.html