香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


把RAG知识库放在香港服务器上,真正需要先决定的不是“向量数据库和大模型是否安装在同一台机器”,而是在线请求中哪些环节需要低延迟、哪些环节会消耗大量计算资源,以及检索到的知识是否允许跨服务器或跨服务传递。
通常更合理的分工是:应用服务负责鉴权、租户隔离、查询编排和提示词组装;向量检索服务负责召回相关内容;生成服务负责根据问题和检索结果输出答案。三者可以先部署在同一节点上,但职责应当从逻辑上分开,后续再根据并发、数据边界和资源争用情况决定是否拆成多台香港服务器或独立服务。
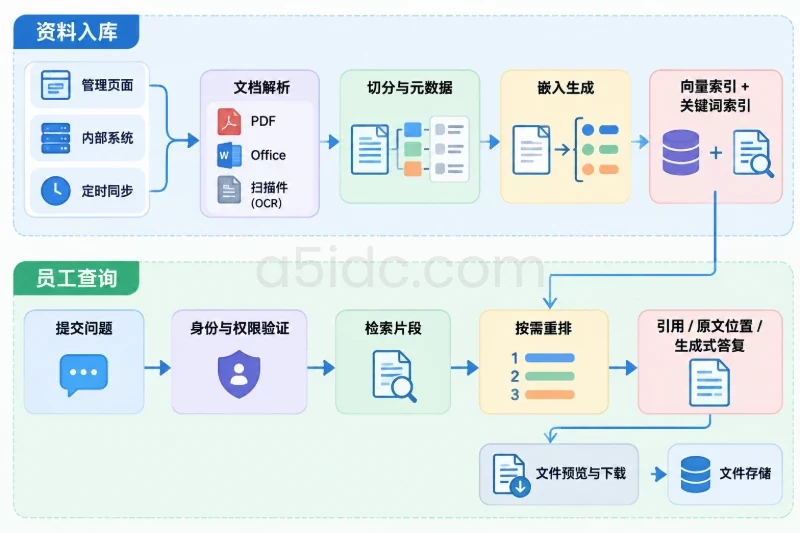
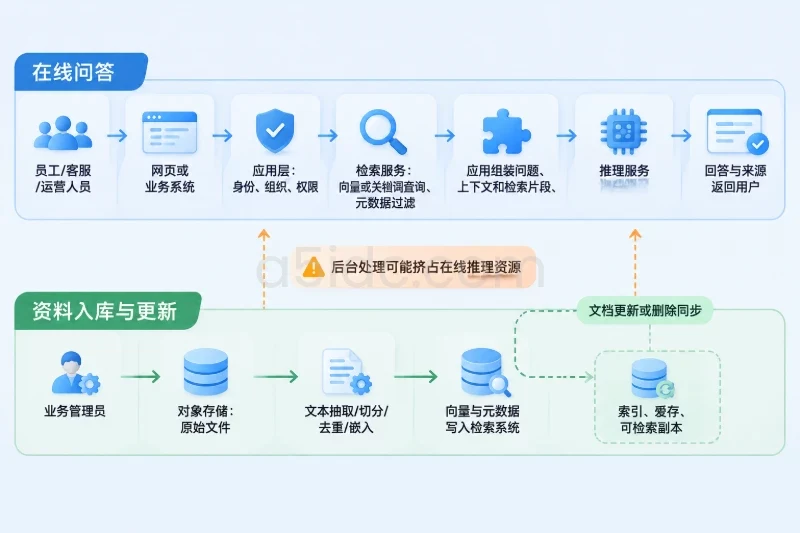
RAG知识库不是单一的“问答程序”,而是由离线入库链路和在线问答链路组成。
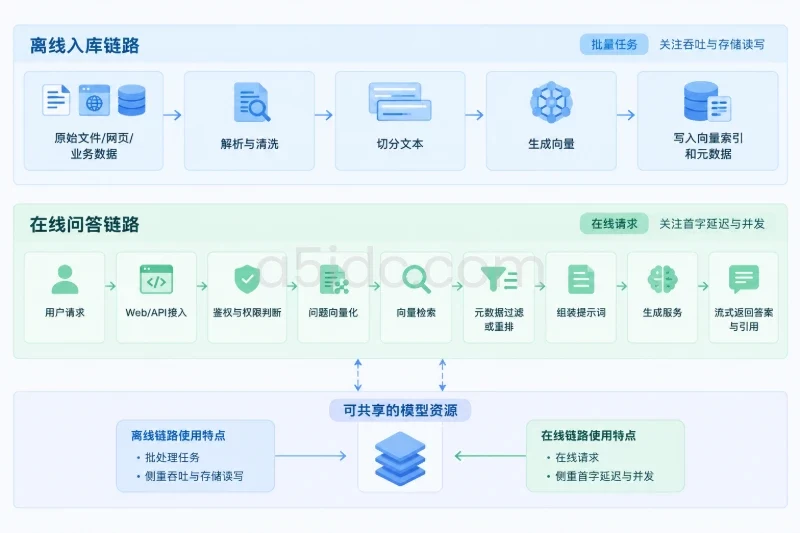
离线链路负责把原始资料转换成可检索的知识:
文件、网页或业务数据
        ↓
解析与清洗
        ↓
切分文本
        ↓
生成向量
        ↓
写入向量索引和元数据
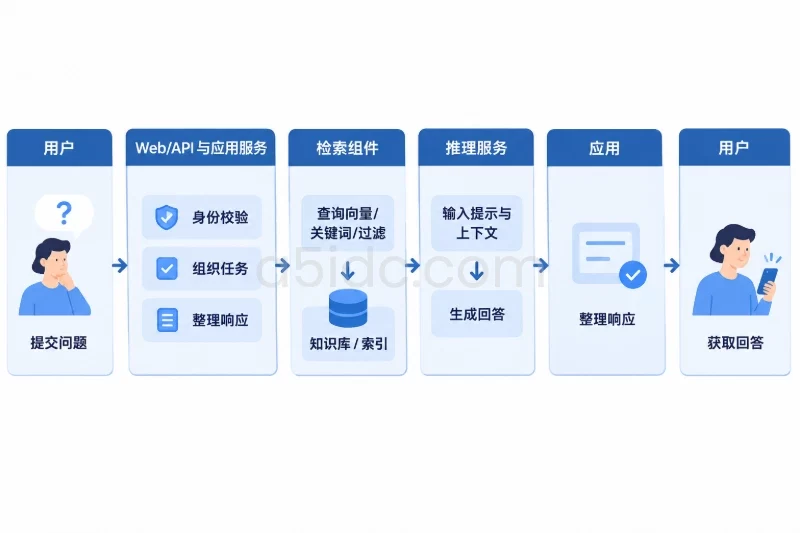
在线链路则负责处理一次用户提问:
用户请求
    ↓
Web/API接入
    ↓
鉴权与权限判断
    ↓
问题向量化
    ↓
向量检索
    ↓
元数据过滤或重排
    ↓
组装提示词
    ↓
生成服务
    ↓
流式返回答案与引用
这两条链路的资源特征不同。文档入库往往是批量任务,对吞吐、队列和存储读写更敏感;在线问答更关注首字延迟、并发连接数和生成速度。如果把它们放在同一进程或同一资源池中,批量重建索引可能影响正常问答。
将应用、向量库和本地模型都部署在香港,并不等于所有数据都始终留在香港。只要生成服务使用外部模型接口,检索出的片段、用户问题和提示词就可能离开香港服务器。
因此,部署前应先确认三个位置:
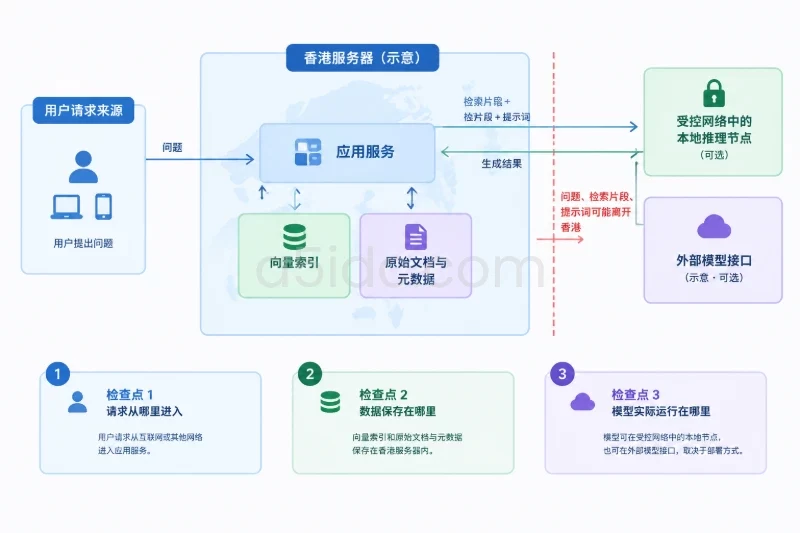
如果业务要求资料不离开指定网络范围,生成服务应使用本地模型或部署在受控网络中的推理节点。如果可以接受外部模型,则需要单独确认服务商的数据保存、日志、训练使用和区域处理政策,不能仅以“服务器在香港”作为数据边界判断。
应用服务是RAG链路的控制中心,通常包括API、会话管理和权限逻辑。它不应把所有功能都塞进向量数据库或生成服务中,主要职责包括:
应用服务通常是无状态的,适合通过多实例扩展。但会话状态、任务状态和权限数据不能只保存在单个进程内,否则在多节点部署后容易出现请求漂移或状态丢失。
文档入库时,切分后的文本需要经过Embedding模型生成向量;用户提问时,也必须使用兼容的模型生成查询向量。
向量化服务有两类负载:
两者可以共用模型,但不一定要共用资源池。批量导入期间,如果离线任务占满CPU、GPU或显存,在线问题向量化会出现排队。
Embedding模型、分词方式、文本切分策略发生变化时,原有向量索引通常不能直接与新向量混用。因此需要记录:
向量数据库或检索服务的输出应当是结构化的候选内容,而不是最终回答。一个合格的检索结果通常包括:
向量检索主要消耗内存、CPU和高速磁盘读写。索引越大,内存压力越明显;如果每次检索还要读取大量原文,存储延迟也会影响整体响应。
向量检索服务不应直接决定用户最终看到的答案。权限过滤、结果数量、引用格式和回答风格应由应用服务控制,避免不同入口对同一个知识库产生不一致的业务规则。
向量检索适合快速召回候选片段,但候选结果的排序未必完全符合问题语义。需要更高准确度时,可以在向量检索之后加入重排模型:
向量检索 Top-K
        ↓
重排模型重新评分
        ↓
保留少量高相关片段
        ↓
交给生成服务
重排模型通常比简单向量相似度更消耗CPU或GPU,也会增加一次网络或推理等待。知识库规模较小、问题模式稳定时,可以先不独立部署重排服务;当召回结果数量较多、文档相似度高或回答经常引用错误内容时,再考虑将其独立出来。
生成服务接收应用服务组装好的提示词、检索片段和输出要求,主要负责:
生成服务的资源特征与向量检索明显不同。它更依赖GPU计算能力、显存容量、上下文长度和并发控制。即使向量库查询只需要几十毫秒,生成阶段仍可能因为模型推理或排队占用大部分请求时间。
如果使用外部模型接口,香港服务器上的“生成服务”可以只是一个适配层,负责统一鉴权、超时、重试、流式协议和模型路由,而不是实际运行模型。此时应重点评估香港服务器到模型服务端点的网络延迟、出站数据边界和接口限流。
向量索引适合相似度检索,但不应成为唯一的知识源。建议至少区分三类数据:
| 数据类型 | 主要用途 | 适合保存的位置 |
|---|---|---|
| 原始文档 | 重新切分、审计、下载和恢复 | 对象存储或文件存储 |
| 文档元数据 | 权限、标题、标签、版本和更新时间 | 关系数据库或文档数据库 |
| 向量索引 | 快速相似度检索 | 向量数据库或向量索引服务 |
这样做的好处是,索引损坏或Embedding模型更换时,可以从原始文档和元数据重新构建,而不必把向量库当成唯一数据源。
文档上传后,可以先写入原始存储和元数据数据库,再通过队列投递解析、切分和向量化任务。队列的作用是削峰和记录处理状态,而不是参与每一次在线检索。
较清晰的关系如下:
上传接口
  ├─ 写入原始文档
  ├─ 写入文档状态和权限元数据
  └─ 投递入库任务
             ↓
       解析与文本切分
             ↓
       Embedding批处理
             ↓
       写入新向量索引
             ↓
       更新索引版本
如果文档较少、更新频率低,可以暂时不单独部署消息队列,由后台任务直接处理。但需要保留任务状态和失败记录,否则批量处理被中断后,很难判断哪些文档已经完成。
一次在线请求的推荐职责分工如下:
生成服务不建议直接访问向量数据库。这样可以减少服务之间的隐式依赖,也便于限制生成服务能看到的数据范围。将检索结果以标准结构传给生成服务后,未来更换本地模型、外部模型或模型版本时,应用层不需要重写检索逻辑。
拆分服务后,服务器之间需要传递查询向量、检索结果和提示词。向量本身通常不是主要流量来源,真正容易增大的部分是返回的文本片段和最终提示词。
例如,一次请求返回8个片段,每个片段约2 KB,100次请求每秒时,仅检索片段的理论传输量为:
8 × 2 KB × 100 次/秒 = 1600 KB/秒
1600 KB/秒 × 8 = 12800 Kb/秒 ≈ 12.8 Mbps
这是未计算协议开销、重复字段和生成输出的估算值。实际部署中还要考虑峰值并发、流式返回、重试以及同一节点上的其他流量。对于普通规模的内网部署,这类流量通常可控;但如果把生成服务、检索服务和原始文档存储放在不同网络区域,延迟和数据传输成本会明显增加。
同机部署适合验证阶段、内部使用或访问量较小的知识库。应用服务、Embedding、向量索引和生成服务可以在同一台香港服务器上运行,但应使用独立进程或容器,并限制各自的CPU、内存和GPU资源。
这种方式的优点是:
主要风险在于资源争用。生成模型可能占用大部分显存和内存,批量Embedding可能持续消耗CPU,向量索引则需要稳定的内存和磁盘访问。一旦生成并发上升,检索查询的延迟可能随之增加。
同机部署不能简单理解为“所有组件共享资源”。至少需要进行进程隔离、资源上限、日志限额和任务优先级控制。离线入库任务应避免在在线高峰期无限制运行。
围绕RAG中检索与生成的资源差异,A5idc数据提供香港Xeon Gold、AMD EPYC等物理服务器,配备SSD或NVMe存储,可承载应用编排、向量检索及相关数据服务;香港GPU服务器则提供A100 80GB、RTX 4090等显卡选项,并有CN2线路配置,为模型推理与检索服务分机部署提供不同的硬件资源基础。
当生成模型使用GPU,而向量检索主要使用CPU、内存和SSD时,分机通常是更自然的架构:
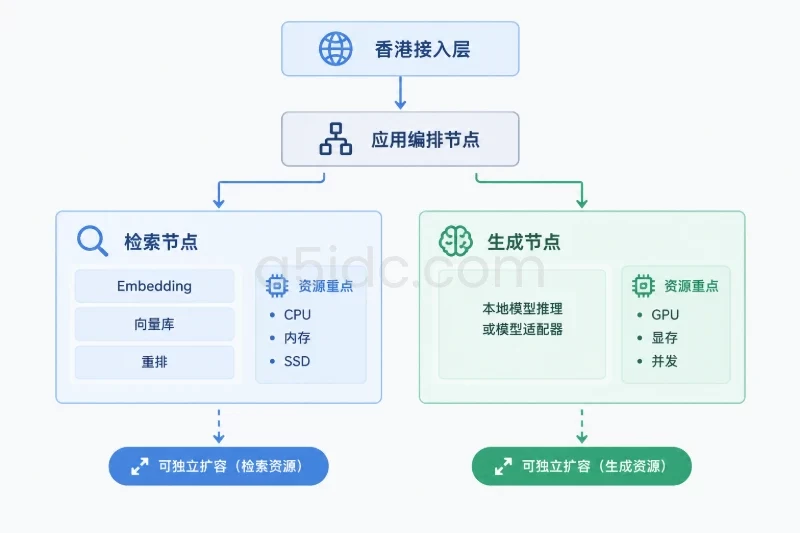
香港接入层
    ↓
应用编排节点
    ├── 检索节点:Embedding、向量库、重排
    └── 生成节点:本地模型推理或模型适配器
拆分后可以分别扩容:
但分机也带来新的要求。应用服务与检索、生成服务之间应使用内网访问和服务鉴权,不能因为处于同一机房就默认可信。检索片段、提示词和答案可能包含敏感信息,内部传输也应根据数据等级采用加密和访问控制。
单节点适合业务规模尚未稳定的阶段,但它的故障影响范围较大。即使应用服务采用多个进程,只要向量库、原始文档和模型都在同一台服务器上,主机故障仍可能使整条链路不可用。
多节点部署通常按以下方式拆分:
| 节点或服务 | 扩展方式 | 主要关注点 |
|---|---|---|
| 应用服务 | 无状态多实例 | 负载均衡、会话和权限状态 |
| 向量检索 | 副本或分片 | 索引一致性、内存和磁盘 |
| 生成服务 | 多推理实例 | 显存、并发、首字延迟 |
| Embedding服务 | 批处理与在线分离 | 模型版本、任务队列 |
| 原始文档存储 | 副本或备份 | 恢复能力、版本管理 |
| 任务队列 | 高可用或持久化 | 积压、重复消费、失败重试 |
多节点并不一定意味着每个组件都要立即做集群。向量数据库的副本、分片和一致性会增加运维复杂度;生成服务的多实例还需要考虑模型加载时间和显存成本。只有当可用性、并发或隔离需求明确存在时,才值得引入对应的集群机制。
可以按资源和故障边界逐步拆分,而不是一次性拆成大量微服务。
| 部署结构 | 适用条件 | 主要收益 | 需要接受的代价 |
|---|---|---|---|
| 全部同机、逻辑分进程 | 小规模、低并发、模型较轻 | 成本和维护压力较低 | 资源争用,主机故障影响大 |
| 应用与模型分机 | 本地生成模型占用GPU | 生成与检索独立扩容 | 内部调用和数据传输增加 |
| 检索、生成、入库分离 | 在线与离线负载差异明显 | 互不干扰,便于限流 | 版本和监控对象增多 |
| 应用多节点、数据服务独立 | 需要滚动发布或较高可用性 | 应用故障影响范围较小 | 需要处理状态、负载均衡和服务发现 |
| 向量库集群、模型多实例 | 并发或索引规模较大 | 支持横向扩展 | 索引同步、显存和运维复杂度上升 |
一个常见的演进顺序是:先在单节点上完成应用、检索和生成的逻辑分层;当生成资源成为瓶颈时,将生成服务迁移到独立节点;当离线入库影响在线请求时,再拆分Embedding和任务队列;只有在节点故障、索引规模或并发需求明确时,才继续建设多节点集群。
RAG知识库的容量评估至少要分别看四项:
原始文档只有几GB,并不代表向量服务只需要几GB内存。索引结构、元数据、缓存和副本都可能增加实际占用。生成服务也不能只按模型文件大小估算,还要把上下文长度、KV缓存和并发请求纳入容量判断。
整条请求链路应拆成多个可观测阶段:
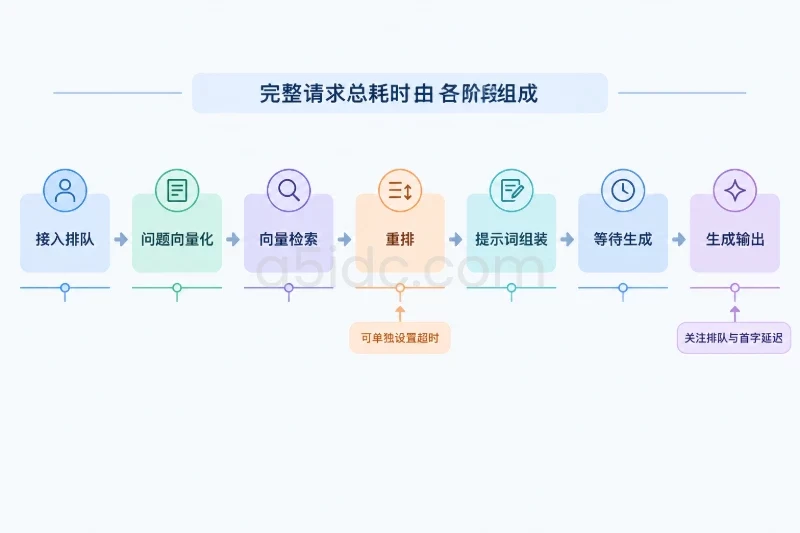
接入排队
+ 问题向量化
+ 向量检索
+ 重排
+ 提示词组装
+ 等待生成
+ 生成输出
如果只有一个总超时,无法判断是检索慢、模型排队,还是外部模型接口延迟。应用服务应为检索、重排和生成分别设置超时与降级策略。例如,重排超时可以退回初步召回结果;生成服务不可用时,可以返回检索到的文档标题和引用状态,但是否允许这种降级取决于业务要求。
Embedding模型变化后,旧向量与新向量可能不在同一语义空间。切分规则、向量维度或索引参数变化,也可能要求重建索引。
较稳妥的方式是:
索引切换不应直接覆盖唯一副本。原始文档、元数据、任务状态和向量索引都应制定对应的备份或重建方案。
RAG最容易被忽略的风险不是“检索不到”,而是把无权限片段送进了提示词。权限条件应在检索阶段尽早参与,并在应用服务拿到结果后再次校验。
至少需要明确:
生成模型只应接收本次请求允许使用的上下文,不能依赖模型自行判断哪些内容可以公开。
不能只监控香港服务器的CPU和内存,还应分别记录:
验收时可以将“仅检索”“仅生成”和“完整RAG链路”分开测试。只有完整链路变慢,说明需要检查服务间传输、提示词长度或编排逻辑;如果仅生成变慢,优先看模型节点资源;如果仅检索变慢,则应检查索引内存、磁盘和过滤条件。
对于部署在香港服务器上的RAG知识库,先记录在线请求量、峰值并发、知识库规模、文档更新频率和生成模型位置,再决定是否拆分。低并发、资料规模有限且使用轻量模型时,可以选择同机部署,但必须做好进程隔离和备份;生成模型占用独立GPU、在线与离线负载差异明显,或需要分别扩容时,应优先将生成服务与向量检索服务分开。
最终需要验证的不是“组件是否都安装在香港”,而是三件事:检索结果是否能在目标延迟内返回,生成服务是否会被索引或入库任务拖慢,以及问题和知识片段是否经过了可接受的数据边界。围绕这三项验证部署结构,通常比一开始追求完整的多节点架构更稳妥。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6589.html