香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


执行计划的核心不是看见 Seq Scan 或 Sort 就立即判定“数据库有问题”,而是把估算行数、实际行数、执行时间、缓冲区命中、临时文件和等待事件放在同一条链路中分析。扫描是否成为瓶颈,取决于扫描了多少数据、筛选条件的选择性以及数据是否在内存中;排序是否成为瓶颈,则要看排序输入规模、排序方式和是否发生磁盘溢写。
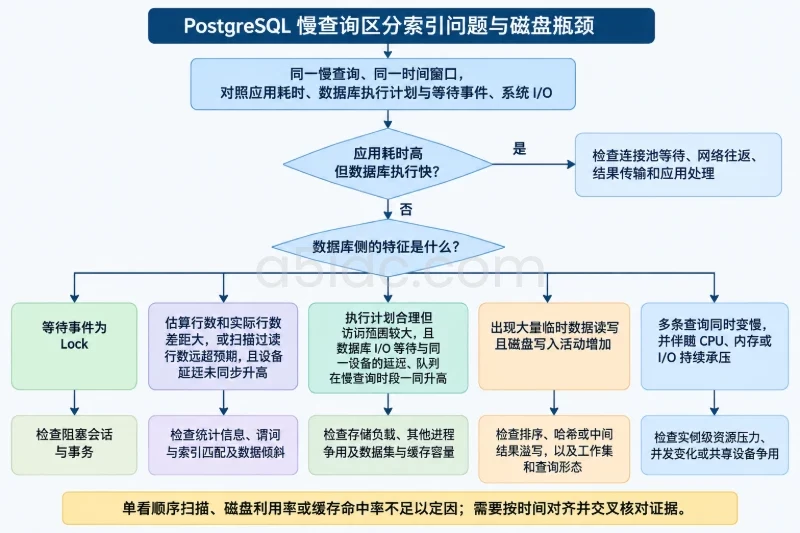
在数据库服务器上定位性能问题,可以按“查询执行了什么 → 消耗了哪类资源 → 资源是否达到边界 → 应该调整哪一层”的顺序判断。PostgreSQL 执行计划负责解释数据库内部的执行过程,操作系统指标负责确认 CPU、内存和磁盘,应用侧延迟与连接池指标则用于排除网络、连接等待和重复查询等数据库之外的问题。
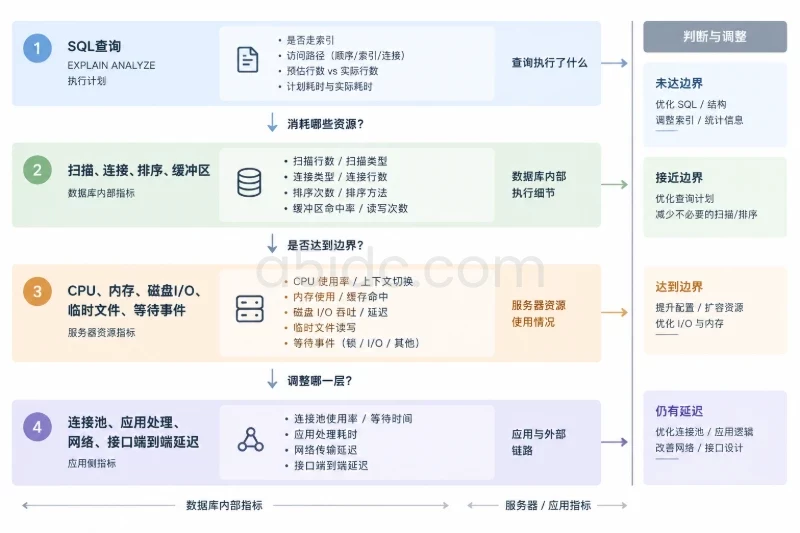
普通 EXPLAIN 只展示优化器估算的计划,不会真正执行查询。要判断实际扫描行数、排序方式和资源消耗,通常需要使用 EXPLAIN ANALYZE。
EXPLAIN (
    ANALYZE,
    BUFFERS,
    SETTINGS,
    TIMING OFF
)
SELECT order_id, customer_id, created_at, amount
FROM orders
WHERE tenant_id = 42
  AND status = 'paid'
ORDER BY created_at DESC
LIMIT 50;
这些选项的作用不同:
| 选项 | 主要作用 | 判断重点 |
|---|---|---|
ANALYZE | 实际执行查询并记录真实数据 | 实际耗时、实际行数、循环次数 |
BUFFERS | 统计共享缓冲区和临时缓冲区访问 | 内存命中、数据读取、排序溢写 |
SETTINGS | 显示影响计划的相关配置 | work_mem、并行参数等是否发生变化 |
TIMING OFF | 关闭每个节点的细粒度计时 | 降低计时开销,适合先做整体判断 |
WAL | 统计部分写入操作产生的 WAL | 更新、插入、删除查询的写放大 |
EXPLAIN ANALYZE 会执行查询。对 SELECT 来说通常没有数据修改风险,但查询中如果调用了有副作用的函数,仍然可能产生外部影响。对 UPDATE、DELETE、INSERT 等语句,不要直接在生产环境裸跑;应先确认备份、影响范围和回滚方式,并在可回滚事务或隔离环境中验证。即使事务最终回滚,触发器调用外部系统等副作用也不一定能够回滚。
分析测试最好使用接近真实业务的参数。一个返回 20 行的查询和一个返回 200 万行的查询,可能使用完全不同的计划。冷缓存和热缓存也应分别记录,否则很容易把“第一次从存储读取”的延迟误判成固定性能。
cost 不是毫秒执行计划中的:
(cost=0.42..1850.60 rows=120 width=96)
表示优化器的成本估算、预计返回行数和行宽,cost 是内部成本单位,不是毫秒。真正的时间要看:
(actual time=0.180..96.420 rows=120 loops=1)
其中:
actual time 是节点实际开始产生结果和完成处理的时间,单位为毫秒;rows 是实际输出行数;loops 是节点被执行的次数;loops 大于 1 时,节点内部的实际时间和行数通常需要结合循环次数理解;估算行数与实际行数差异较大,是执行计划判断中的重要信号。比如优化器预计返回 10 行,实际返回 100 万行,可能导致它选择了嵌套循环或索引访问,而实际数据规模更适合哈希连接或顺序扫描。
可以先用一个相对简单的比例筛查:
实际行数 ÷ 估算行数
在关键节点上,如果这个比例长期达到 5 倍、10 倍甚至更高,应优先检查统计信息、数据分布和查询条件,而不是直接修改 enable_seqscan 等规划器开关。数据刚发生大量变化、列值分布高度倾斜、多个列之间存在相关性时,默认统计信息可能不足以描述真实分布。
Index Cond 和 Filter例如:
Index Scan using idx_orders_tenant on orders
  Index Cond: (tenant_id = 42)
  Filter: (status = 'paid')
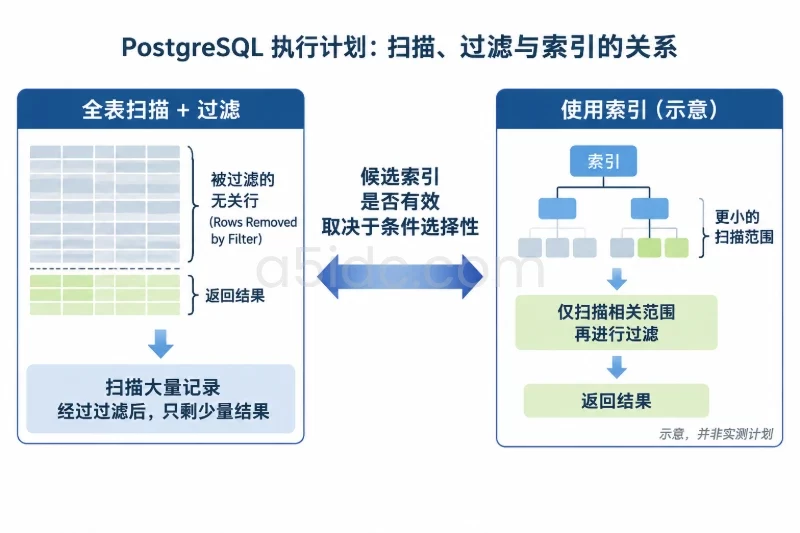
Index Cond 表示索引直接参与了数据定位;Filter 表示数据取出后才进行过滤。如果 status 的过滤选择性很高,却只出现在 Filter 中,查询仍可能读取大量不符合条件的表行。
判断扫描效率时,应同时观察:
Rows Removed by Filter 是否远高于最终输出行数;Buffers 中读取了多少数据块;Seq Scan 并不天然代表错误。小表、需要读取大部分表数据的查询、选择性较低的条件,使用顺序扫描往往更合理。相反,一张很大的表只需要返回几十行,却进行了数百万行的顺序扫描,才更值得重点调查。
一个具有代表性的示例计划如下,数据仅用于说明判断方法:
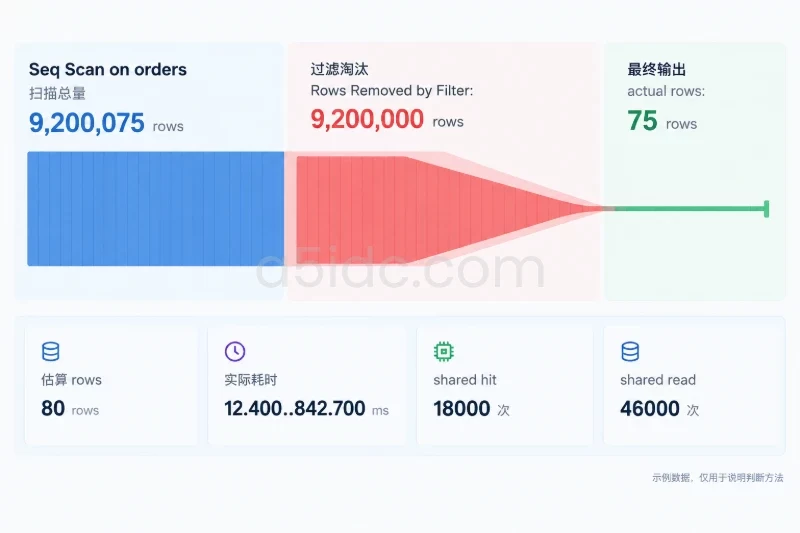
Seq Scan on orders
  (cost=0.00..184000.00 rows=80 width=64)
  (actual time=12.400..842.700 rows=75 loops=1)
  Filter: ((tenant_id = 42) AND (status = 'paid'))
  Rows Removed by Filter: 9200000
  Buffers: shared hit=18000 read=46000
这里值得关注的不是 Seq Scan 这三个字,而是:
shared read;如果该查询经常执行,并且条件通常只命中很少数据,可以评估是否需要更匹配的索引。索引设计要结合等值条件、范围条件和排序条件,而不是只为每个过滤列分别建立单列索引。例如:
WHERE tenant_id = 42
  AND status = 'paid'
ORDER BY created_at DESC
LIMIT 50
在数据分布和写入模式合适时,类似 (tenant_id, status, created_at DESC) 的组合索引可能同时帮助定位和排序。但索引并非没有代价:它会增加磁盘空间、写入维护和缓存压力;如果查询经常返回表中很大比例的数据,索引扫描反而可能产生大量随机堆表访问。
索引扫描也可能很慢,常见原因包括:
对于 Index Only Scan,还要观察 Heap Fetches。如果堆表回表次数很高,说明并非所有数据都能直接从索引可见性信息中确认,索引覆盖带来的收益可能低于预期。
Bitmap Heap Scan 通常介于顺序扫描和普通索引扫描之间,适合先通过索引收集一批行位置,再批量访问表数据。此时可以关注:
Heap Blocks: exact=12000 lossy=3000
lossy 页面较多时,位图精度下降,后续需要重新检查条件,可能增加 CPU 和表扫描工作量。这类问题需要结合实际数据规模和 work_mem 验证,不能只凭一个节点名称下结论。
如果扫描本身不慢,但连接节点出现:
Nested Loop
  (actual time=... rows=500000 loops=1)
同时内层索引扫描的 loops 很高,就要计算内层访问总量。内层节点每次只返回几行,不代表总成本低;外层返回 10 万行时,内层可能被执行 10 万次。
判断连接放大效应时,重点看:
loops;这类问题通常属于执行计划和统计信息问题,但也可能来自应用传入了过宽的时间范围或缺少租户、状态等约束。
执行计划中的排序节点通常会显示方法:
Sort
  Sort Key: created_at DESC
  Sort Method: quicksort  Memory: 18640kB
常见含义如下:
| 排序信息 | 含义 | 关注方向 |
|---|---|---|
quicksort | 排序在内存中完成 | 主要看输入行数和 CPU 时间 |
top-N heapsort | 存在 LIMIT,只保留部分结果 | 通常比全量排序节省内存和 CPU |
external merge | 内存不足,使用临时文件进行外部排序 | 检查临时 I/O 和 work_mem |
incremental sort | 利用已有的部分有序性继续排序 | 查看前置节点是否提供了有效顺序 |
例如:
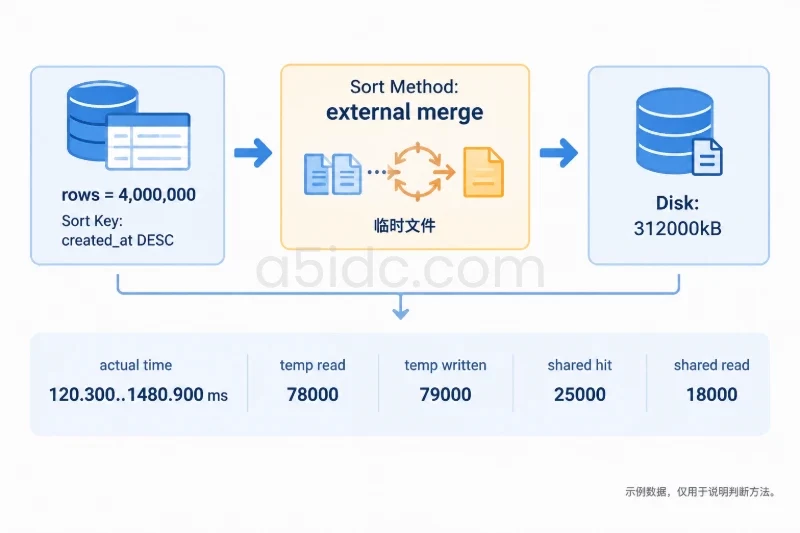
Sort
  (cost=210000.00..220000.00 rows=4000000 width=120)
  (actual time=120.300..1480.900 rows=4000000 loops=1)
  Sort Key: created_at DESC
  Sort Method: external merge  Disk: 312000kB
  Buffers: shared hit=25000 read=18000
  temp read=78000 written=79000
这里的主要信号是:
external merge,说明排序过程发生了磁盘溢写;这类排序瓶颈可能有三种不同根因:
不能简单通过提高 work_mem 解决所有问题。work_mem 是每个排序或哈希节点的工作内存上限,复杂查询、并行查询或大量并发连接可能同时创建多个节点。假设单个查询存在 3 个排序或哈希节点,并行度为 2,配置的 work_mem 为 64 MB,理论上就可能产生多个工作内存使用单元;在几十个并发查询下,内存压力会迅速放大。
验证时,可以只在当前会话或事务中临时调整,而不是直接修改全局配置:
BEGIN;

SET LOCAL work_mem = '64MB';

EXPLAIN (
    ANALYZE,
    BUFFERS,
    SETTINGS,
    TIMING OFF
)
SELECT order_id, customer_id, created_at, amount
FROM orders
WHERE tenant_id = 42
ORDER BY created_at DESC
LIMIT 50;

ROLLBACK;
这段测试只适用于确认内存变化对计划和排序方法的影响。测试前仍应确认连接池会话范围、并发数量和服务器剩余内存,避免将局部实验配置扩散到所有业务请求。
如果排序发生溢写,按以下顺序判断更稳妥:
work_mem 后,临时文件是否消失,CPU 和总延迟是否确实下降;如果查询是“按租户筛选,再按时间倒序取最新 50 条”,匹配的组合索引有机会让数据库直接按索引顺序取数,从而减少排序。但如果查询需要返回大量数据、排序列分布不适合索引,或排序发生在复杂连接之后,索引不一定能够消除排序节点。
单份执行计划只能说明数据库做了什么,还需要结合服务器指标判断消耗属于哪一类资源。
| 观察结果 | 更可能的瓶颈 | 需要进一步核对 |
|---|---|---|
shared hit 高、shared read 低,节点耗时高,CPU 使用率高 | CPU 计算、过滤、连接或内存内排序 | 进程 CPU、节点实际耗时、函数和表达式 |
shared read 高,I/O 时间和磁盘等待上升 | 数据读取或缓存未命中 | track_io_timing、磁盘延迟、吞吐、队列 |
external merge、temp read/write 明显 | 排序或哈希溢写 | work_mem、输入行数、并发规模 |
| 数据库执行时间较短,但接口耗时很长 | 网络、应用处理、连接池或重复查询 | 客户端接收时间、返回字节数、应用日志 |
wait_event_type = Lock | 锁等待 | 阻塞会话、事务持续时间、锁对象 |
wait_event_type = Client | 客户端读取或接收速度影响服务端 | 客户端处理、网络链路、结果集大小 |
| 执行计划估算行数严重偏小或偏大 | 统计信息或数据分布问题 | ANALYZE 状态、列分布、参数差异 |
shared hit 表示从 PostgreSQL 共享缓冲区命中,不等于没有任何成本;大量命中仍然可能消耗 CPU。shared read 表示从共享缓冲区读取数据块,数据后续可能命中操作系统缓存,也可能真正落到存储设备,因此不能仅凭 read 数量断言磁盘一定慢。
需要更明确地区分 I/O 和 CPU 时,可以在测试会话中启用 I/O 计时:
BEGIN;

SET LOCAL track_io_timing = on;

EXPLAIN (
    ANALYZE,
    BUFFERS,
    TIMING OFF
)
SELECT count(*)
FROM orders
WHERE tenant_id = 42;

ROLLBACK;
如果权限或版本不允许在会话级修改该参数,应先核对当前 PostgreSQL 版本和参数上下文,不要直接改写生产配置。执行计划中的 I/O 时间与操作系统监控应放在相近时间窗口内观察,避免取到不同请求的指标。
查看当前活动查询和等待事件,可以使用:
SELECT
    pid,
    usename,
    state,
    wait_event_type,
    wait_event,
    now() - query_start AS elapsed,
    left(query, 160) AS query_text
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
如果执行计划显示数据库节点只用了几十毫秒,但接口端到端延迟达到几百毫秒,应检查是否存在以下情况:
ClientWrite 等等待事件。因此,数据库执行时间不能直接等同于用户看到的接口响应时间。
PostgreSQL执行计划所反映的扫描、排序与资源消耗,也与数据库服务器的CPU、内存和存储资源密切相关。A5idc数据提供香港、美国、日本等地区的物理服务器,涵盖Xeon Gold与AMD EPYC平台,并有搭配较大内存和NVMe存储的配置,可为数据库、业务后台及多任务运行提供相应的硬件资源基础。
单次 EXPLAIN ANALYZE 适合解释计划,不能代表并发下的稳定表现。需要观察同一类查询的调用次数、平均耗时、总耗时和资源累计值时,可以使用 pg_stat_statements。该扩展已启用的环境中,可查询类似信息:
SELECT
    queryid,
    calls,
    total_exec_time,
    mean_exec_time,
    rows,
    shared_blks_hit,
    shared_blks_read,
    temp_blks_read,
    temp_blks_written,
    left(query, 180) AS query_text
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 20;
不同 PostgreSQL 版本的字段名称可能存在差异,老版本可能使用 total_time、mean_time 等字段,应以当前版本视图定义为准。这个统计视图适合发现两类问题:
例如,一条查询平均执行 80 毫秒,每秒执行 200 次,理论上的并发执行量可用下面的关系估算:
并发执行量 ≈ 每秒请求数 × 平均执行时间(秒)
代入示例:
200 × 0.08 = 16
这只表示平均意义上的活动查询量,不代表数据库一定能够稳定承载 200 次每秒。实际还要考虑每个请求包含几条 SQL、锁等待、CPU 核数、缓存命中、磁盘延迟和连接池排队。如果接口一次请求执行 4 条相同查询,数据库侧的查询执行次数可能接近 800 次每秒,资源压力会完全不同。
容量判断应同时记录:
CPU 持续接近满载、磁盘延迟随并发增长、临时文件持续增加、p95 延迟开始突破业务目标,通常都可以视为容量边界的候选信号。但这些阈值不是固定规则。例如 CPU 达到 80% 在低延迟业务中可能已经需要扩容,而批处理任务可能还能接受;磁盘吞吐不高但单次 I/O 延迟很高,也可能已经成为瓶颈。
面对一条慢 SQL,可以按以下顺序处理,减少“看到一个节点就改参数”的误判:
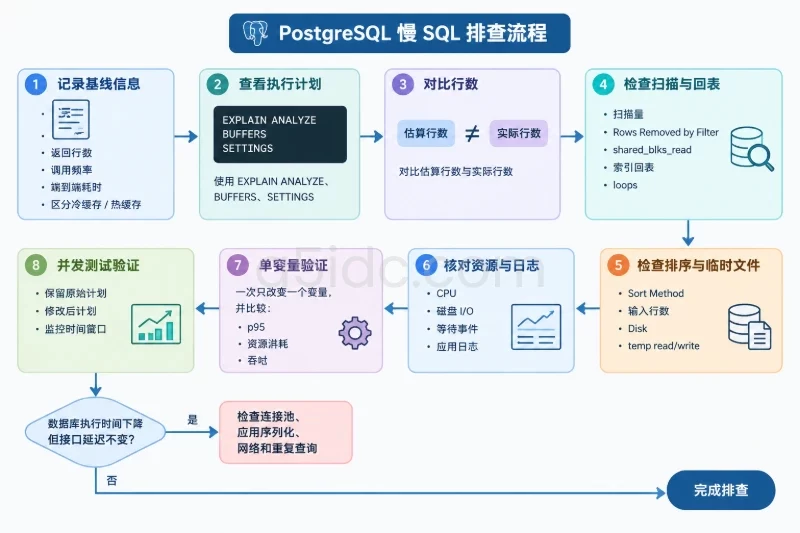
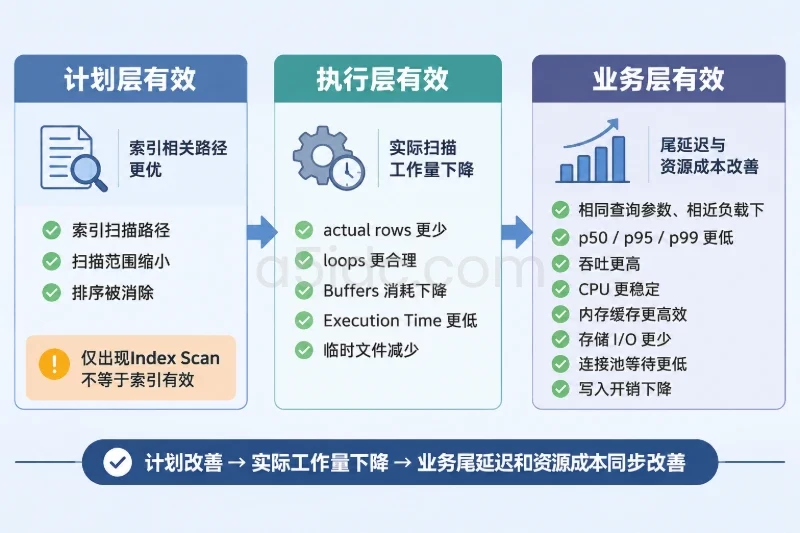
EXPLAIN (ANALYZE, BUFFERS, SETTINGS) 获取实际计划,先看顶层总耗时,再定位耗时占比高的子节点。Rows Removed by Filter、shared_blks_read、索引回表情况和循环次数。Sort Method、输入行数、Disk、temp read/write,确认是输入过大还是内存不足。work_mem,重新比较相同参数下的 p95、资源消耗和吞吐。复测时至少保留原始计划、修改后的计划和对应监控时间窗口。只有当扫描数据量、排序方法、临时 I/O、CPU 或磁盘等待与延迟改善同时对应,才能认为优化方向成立;如果数据库执行时间下降而接口延迟不变,应把排查重点转向连接池、应用序列化、网络传输和重复查询。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6572.html