香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


PostgreSQL 事务 ID 回卷风险,通常不会先表现为数据库突然报错,而是逐渐出现自动清理跟不上、表的事务年龄持续升高,或日志开始提示回卷风险。判断时不能只看磁盘空间和死元组数量:应先检查各数据库的冻结事务年龄,再定位具体表,最后核对自动清理、长事务和复制槽等因素。
核心指标是 age(datfrozenxid):它表示数据库最老、尚未冻结的事务 ID 距离当前事务 ID 的年龄。年龄持续逼近 autovacuum_freeze_max_age,意味着回卷保护性清理的压力正在增加。若年龄逼近 PostgreSQL 的保护边界,服务器可能拒绝启动新事务,以避免事务 ID 回卷导致数据可见性判断错误。
事务 ID(XID)是有限宽度的计数器,会循环使用。PostgreSQL 通过冻结足够老的行版本,避免旧事务 ID 在再次出现时被误认为新事务。回卷风险并不等同于“事务 ID 快用完了”:关键在于最老的未冻结事务 ID 是否仍在持续变老,以及清理能否及时推进冻结边界。
常见信号包括:
age(datfrozenxid) 持续上升,已达到本机 autovacuum_freeze_max_age 的较高比例。age(relfrozenxid) 特别高。这些信号需要结合判断。例如,死元组多说明清理可能有压力,但不能单独证明已经接近回卷;死元组少也不能排除某张表冻结年龄过高。
以下查询为只读操作,可在任意一个可连接的数据库中执行。权限不足时,使用具有查看系统目录权限的运维账号。
SELECT
    datname,
    age(datfrozenxid) AS xid_age,
    current_setting('autovacuum_freeze_max_age')::bigint AS freeze_max_age,
    round(
        100.0 * age(datfrozenxid)
        / current_setting('autovacuum_freeze_max_age')::bigint,
        1
    ) AS pct_of_freeze_max
FROM pg_database
WHERE datallowconn
ORDER BY age(datfrozenxid) DESC;
xid_age 是距离数据库冻结边界的事务年龄,pct_of_freeze_max 是相对于当前服务器 autovacuum_freeze_max_age 的比例。默认值通常为 2 亿个事务,但实际值可能已被调整,应以查询结果为准。
比例不是 PostgreSQL 的统一故障分级标准,可用于设定本地告警。例如,可将 50% 设为关注、75% 设为高优先级、90% 设为紧急检查的起点,再结合业务事务速率、维护窗口和清理能力调整。若某个数据库比例远高于其他数据库,应先排查该库内部的问题;若所有数据库都在升高,则应关注实例级清理能力或长期存在的全局清理阻塞。
数据库级指标适合监控全局趋势,但不能指出具体哪张表拖慢了冻结进度。下一步应连接到年龄最高的数据库,检查表级指标。
对上一步排名靠前的数据库逐个连接,再执行:
SELECT
    n.nspname AS schema_name,
    c.relname AS relation_name,
    c.relkind,
    age(c.relfrozenxid) AS xid_age,
    pg_size_pretty(pg_total_relation_size(c.oid)) AS total_size
FROM pg_class AS c
JOIN pg_namespace AS n ON n.oid = c.relnamespace
WHERE c.relkind IN ('r', 'm', 't')
ORDER BY age(c.relfrozenxid) DESC
LIMIT 20;
结果包含普通表、物化视图和 TOAST 表。TOAST 表可能承载大字段数据,不能因为业务查询中看不到它,就忽略其冻结年龄。大表的清理可能耗时较长,但表大小本身不等于回卷风险;判断重点仍是 xid_age 是否持续偏高,以及清理后冻结边界能否推进。
如果某张表的年龄显著高于本库其他表,需优先检查它的自动清理状态、写入量和清理是否受阻。若表级结果普遍偏高,则更像是整个数据库清理能力不足,或有事务、复制机制长期持有旧的清理边界。
检查常用设置及是否启用自动清理:
SHOW autovacuum;
SHOW autovacuum_freeze_max_age;
SHOW vacuum_freeze_table_age;
SHOW vacuum_freeze_min_age;
SHOW vacuum_cost_delay;
autovacuum_freeze_max_age 决定 PostgreSQL 在事务年龄达到一定程度时启动保护性清理;vacuum_freeze_table_age 和 vacuum_freeze_min_age 会影响冻结行为。不要仅因年龄高就随意调大 autovacuum_freeze_max_age:延后清理并不会消除风险,还会减少距离保护边界的余量。改参数前应核对 PostgreSQL 版本、实例负载、清理能力和变更流程。
再查看近期自动清理记录:
SELECT
    schemaname,
    relname,
    last_autovacuum,
    autovacuum_count,
    last_vacuum,
    vacuum_count,
    n_dead_tup
FROM pg_stat_user_tables
ORDER BY last_autovacuum NULLS FIRST
LIMIT 30;
last_autovacuum 长期为空、清理次数很少,可能说明表没有触发清理,也可能只是统计数据尚未记录;n_dead_tup 是估算值,不能当作冻结年龄。可结合日志、表级年龄和正在运行的清理进一步判断。统计视图也可能受统计重置或权限影响,查询结果应与实际配置和日志交叉核验。
若当前有真空清理正在运行,可检查进度:
SELECT
    p.pid,
    p.datname,
    p.relid::regclass AS relation_name,
    p.phase,
    p.heap_blks_scanned,
    p.heap_blks_total,
    p.heap_blks_vacuumed
FROM pg_stat_progress_vacuum AS p
ORDER BY p.datname, p.pid;
该视图在支持它的 PostgreSQL 版本中提供;若查询提示视图不存在,先核对服务器版本,不要据此认定没有清理任务。任务持续运行、扫描量增加,说明清理正在推进;长时间停滞则需结合系统负载、I/O 和清理阻塞原因继续排查。不同阶段的进度字段含义不同,不能只用单个百分比判断任务是否卡死。
长事务可能让清理无法越过仍被事务使用的旧数据边界。先查看持续时间较长且尚未结束的事务:
SELECT
    pid,
    usename,
    datname,
    state,
    xact_start,
    now() - xact_start AS xact_duration,
    backend_xmin,
    left(query, 200) AS query_sample
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start
LIMIT 30;
重点核对运行时间长、backend_xmin 非空的会话,并联系应用负责人确认它是否仍需保留。长事务不一定都是故障;不要只因为持续时间长就直接终止业务连接。若确认可以终止,先评估语句回滚时间、业务影响和应用重试行为,再通过变更流程处理。
检查复制槽保留的事务边界:
SELECT
    slot_name,
    slot_type,
    active,
    xmin,
    catalog_xmin
FROM pg_replication_slots
ORDER BY slot_name;
长期未使用或异常滞留的槽可能保留清理所需的事务信息。不要直接删除复制槽:这可能影响下游复制或逻辑订阅,且删除后通常不能原样恢复。先确认槽的消费者、恢复计划和重新建立成本,再决定是否处理。备用节点反馈旧快照等因素也可能限制清理,需结合复制架构及相应监控核查。
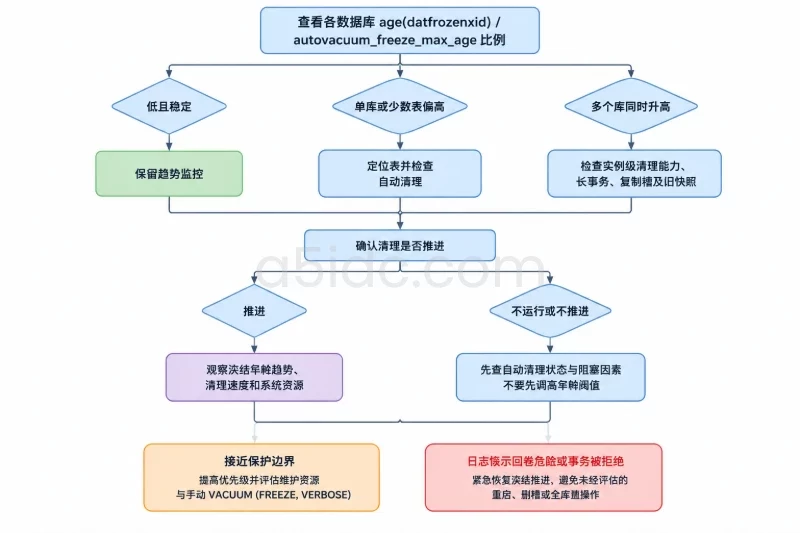
| 检查结果 | 优先判断 | 处理方向 |
|---|---|---|
| 数据库年龄较低且稳定 | 暂无明显回卷压力 | 保留趋势监控,核实告警是否覆盖最高年龄数据库 |
| 单库或少数表年龄偏高 | 局部自动清理不足、个别表清理受阻 | 查清理记录、任务进度、写入负载和相关旧快照 |
| 多个库的年龄同时上升 | 实例级清理能力不足,或存在全局阻塞 | 查自动清理配置、长事务、复制槽及系统资源 |
| 年龄接近本机阈值并继续升高 | 保护性清理压力较大 | 提高处理优先级,准备维护资源并评估手动清理 |
| 日志提示回卷危险或事务拒绝 | 已属紧急情况 | 先保障可连接性和维护通道,尽快恢复冻结推进;避免无评估的重启、删槽或全库重操作 |
如果表级年龄和清理任务进度显示冻结边界正在推进,可先确认清理速度是否足以在进入更高风险区前完成。对业务写入较高的实例,清理消耗的 I/O 和 CPU 可能影响在线负载,应安排资源监控,避免在高峰期贸然叠加大型清理任务。
先修复原因,而不是先调整年龄阈值。确认 autovacuum 是否启用、相关表是否有清理活动,再定位长事务、复制槽和备用节点反馈。若需要改变参数,保存变更前配置并评估生效方式、负载影响及回退条件。参数变更不会自动清理已经积累的高年龄表。
此时优先保证 PostgreSQL 能持续完成清理。若确认需要手动处理,可连接到目标数据库,在非事务块中对已确认的对象执行 VACUUM (FREEZE, VERBOSE)。该操作可能带来明显 I/O 和 CPU 负载;运行前应确认维护权限、备份与恢复方案、业务负载承受能力和执行窗口。普通 VACUUM 不等同于 VACUUM FULL:后者会重写表并造成更强锁与资源影响,不应作为回卷风险的默认处理手段。
手动清理期间持续观察日志、进度、表级年龄和系统资源。如果清理造成不可接受的业务影响,应按现场变更方案暂停或调整操作并评估后续步骤;不要在没有确认命令状态和版本行为前连续重复执行。也不要通过重启数据库、清空数据目录、修改系统目录或盲目删除复制槽来“重置”事务年龄,这些操作可能扩大故障范围。
处理后重新执行数据库级和表级查询,确认最高年龄不再持续上升,并观察清理是否完成。不要只看一次查询的下降值:应结合相邻时间点的趋势、自动清理记录和日志判断冻结进度是否稳定恢复。
建议将以下指标纳入持续监控:
age(datfrozenxid),同时记录相对于本机 autovacuum_freeze_max_age 的比例。告警应同时关注阈值和增长趋势。年龄在短时间内快速上升,即使比例尚未达到高位,也值得提前调查;反之,年龄稳定且清理持续推进时,可按本地风险策略跟进,不必仅凭一个百分比执行高风险变更。修复后至少跨越一个与业务负载和清理周期相匹配的观察窗口,确认指标持续稳定,再关闭故障处置。
PostgreSQL事务回卷风险的持续管理,也离不开能够承载数据库及业务服务的服务器资源。A5idc数据提供香港、美国、日本等地区的物理服务器,涵盖Xeon Gold与AMD EPYC平台,并有搭配NVMe存储和不同内存容量的方案,可用于数据库、业务后台及多任务运行。多地区部署选择与不同线路配置,也为面向不同区域用户的业务提供相应的服务器资源基础。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6419.html