香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


很多人看到云负载均衡控制台显示“后端实例正常”,就认为健康检查已经配置成功。但这只能说明探测请求在某个时间点得到了符合规则的响应,并不代表真实业务请求一定可用。比如 /healthz 返回 200,而登录接口依赖的数据库已经不可连接,负载均衡仍可能继续向该实例分发流量。
验收健康检查时,需要同时验证三件事:探测请求是否真正到达正确的后端端口和路径,后端返回的状态是否符合云负载均衡的判定规则,以及实例从正常到异常、再从异常恢复的时间是否符合预期。探测路径、检查间隔、超时时间和连续成功或失败阈值,应放在同一套验证逻辑中判断,而不能只看某一个配置项。
云负载均衡的健康检查,本质上是由负载均衡节点按照固定规则访问后端实例,并依据连接结果、HTTP 状态码或协议响应决定该实例是否继续接收流量。
它主要回答的是:
它不自动等同于以下结论:
因此,健康检查是流量分发决策的一项依据,而不是完整的业务监控系统。
健康检查协议决定了可以验证的范围。
| 检查协议 | 能够验证的内容 | 不能直接验证的内容 |
|---|---|---|
| TCP | 目标端口可建立 TCP 连接 | HTTP 路径、状态码、应用响应内容 |
| HTTP | HTTP 请求能够到达,状态码符合条件 | HTTPS 握手、证书链和加密配置 |
| HTTPS | TLS 握手及 HTTP 请求能够完成,状态码符合条件 | 复杂业务流程是否完整 |
| 其他应用协议 | 具体协议能否完成约定的探测 | 未纳入探测报文的业务依赖 |
如果负载均衡对后端使用 HTTP,而真实流量使用 HTTPS,HTTP 检查无法验证后端 HTTPS 证书、TLS 版本或加密套件。反过来,HTTPS 检查失败,也不一定意味着应用本身不可用,可能是证书名称、证书链或探测节点信任配置不匹配。
TCP 检查没有“探测路径”这一概念。只有在 HTTP 或 HTTPS 检查中,路径、状态码和请求头才会影响结果。
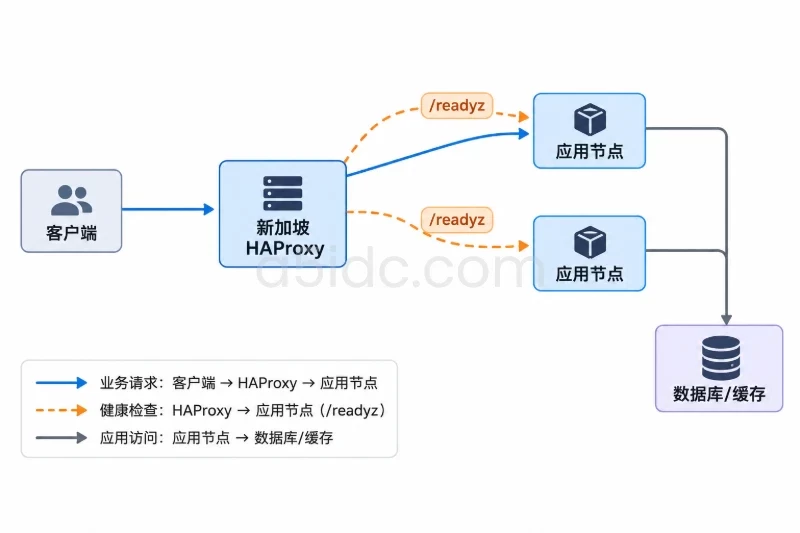
后端可以设计两个层次的接口:
例如,Web 进程仍然运行,但数据库连接池已经耗尽。/livez 可以返回 200,表示进程没有崩溃;/readyz 则可以检查数据库连接、必要配置和关键依赖,并在实例不适合接收流量时返回非成功状态。
如果健康检查绑定到存活接口,检查结果稳定,但可能把故障实例继续留在后端池中。如果绑定到过于复杂的就绪接口,又可能因为短暂的依赖抖动导致实例频繁摘除。实际使用时,应根据业务故障的影响范围选择检查深度。
一组常见参数包括协议、端口、路径、检查间隔、超时时间、健康阈值和不健康阈值。不同云平台的字段名称和默认值可能不同,控制台中的“成功次数”“失败次数”“连续次数”也可能对应不同语义,应以实际产品说明和控制台定义为准。
以下是一个用于说明逻辑的示例配置,字段名不是所有云平台都能直接导入:
health_check:
  protocol: HTTP
  port: 8080
  path: /healthz
  interval_seconds: 10
  timeout_seconds: 3
  healthy_threshold: 2
  unhealthy_threshold: 3
  expected_status_codes:
    - 200
这组示例可以理解为:
“可能”是因为云平台可能在多个负载均衡节点上分别探测,状态同步和调度时间也会产生差异。
健康检查路径建议使用专用、稳定且成本较低的接口,例如:
/healthz
/readyz
/internal/health
路径设计应重点确认以下内容:
GET,部分检查类型可能使用 HEAD 或其他方式。/healthz 与 /Healthz 在部分应用和 Web 服务器中不是同一路由。如果云平台支持设置成功状态码,建议明确限定范围。对于只要求接口正常的场景,可以接受 200;如果接口存在正常重定向,应确认平台是否支持 3xx,并判断这种配置是否会掩盖路径或域名错误。不要仅凭“浏览器最终打开了页面”来判断健康检查成功,因为浏览器会自动跟随重定向,而负载均衡的判定规则未必如此。
这几个参数解决的是不同问题:
不健康阈值过低,实例可能因为一次网络抖动就被摘除;阈值过高,真正故障的实例又会继续接收流量。检查间隔过短会增加后端请求量,过长则会延迟故障发现。
以“间隔 10 秒、单次超时 3 秒、不健康阈值 3 次”为例,如果首次失败探测立即发生,通常需要等到后续两次探测完成后才会转为异常,实际摘除时间大致落在 20 至 30 秒附近。若云平台在探测失败后等待完整超时时间,或者不同节点的探测起点不同,时间还会进一步变化。
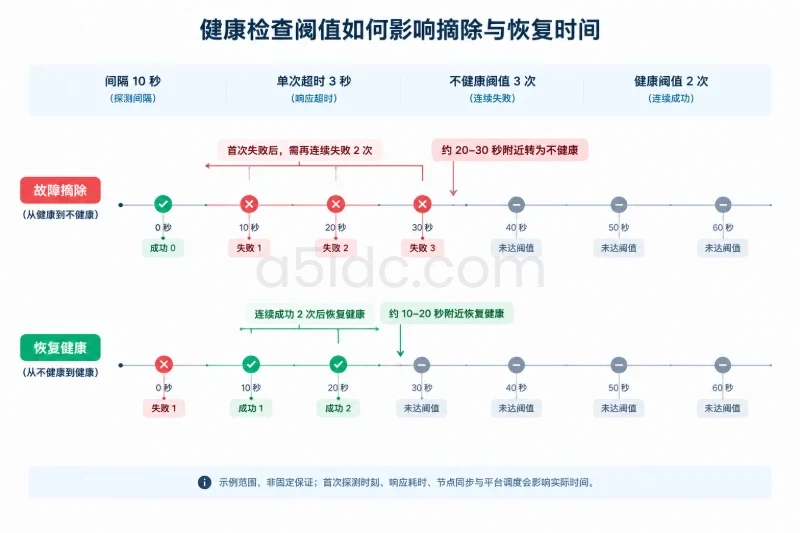
恢复过程也类似。间隔 10 秒、健康阈值为 2 次时,实例通常需要连续通过两次检查,恢复时间大致为 10 至 20 秒。这个时间不能只用“间隔乘阈值”机械计算,还要考虑首次探测时刻、响应耗时、节点同步和平台调度。
健康检查请求量通常与负载均衡探测节点数、后端实例数和检查间隔有关。可以用下面的估算方法理解数量级:
每秒探测次数 ≈ 探测节点数 × 后端实例数 ÷ 检查间隔(秒)
例如,3 个探测节点、20 个后端实例、每 5 秒检查一次:
3 × 20 ÷ 5 = 12 次/秒
这还没有计入多个监听器、多个端口或多个健康检查任务。如果健康接口每次都查询数据库、调用远程服务或生成复杂报表,探测请求可能反过来放大依赖系统压力。因此,健康接口应尽量轻量,并避免把所有深度诊断都放在每次探测中。
验收不能只从负载均衡前端域名访问,因为这样无法确定请求是否真的到达了目标后端,也无法排除缓存、域名解析或其他后端实例的影响。
应优先从与负载均衡后端网络连通的位置发起请求,例如同一私有网络中的运维主机、同安全组的测试实例,或云平台提供的网络诊断环境。
HTTP 检查可以先执行:
curl -i --connect-timeout 2 --max-time 5 \
  http://10.0.1.20:8080/healthz
重点观察:
如果服务依赖 Host 请求头,应显式带上测试域名:
curl -i --connect-timeout 2 --max-time 5 \
  -H 'Host: app.example.com' \
  http://10.0.1.20:8080/healthz
HTTPS 后端还需要验证证书和域名匹配关系。测试时可以使用域名解析到指定后端地址的方式:
curl -i --connect-timeout 3 --max-time 6 \
  --resolve app.example.com:443:10.0.1.20 \
  https://app.example.com/healthz
如果测试环境使用内部 CA,应通过 --cacert 指定正确的 CA 文件。只有在明确知道证书信任问题与本次验证目标无关时,才可临时使用忽略证书校验的方式;该做法不能作为生产健康检查配置的验收标准。
为了便于批量记录状态码和耗时,可以使用:
curl -sS -o /dev/null \
  --connect-timeout 2 \
  --max-time 5 \
  -w 'code=%{http_code} connect=%{time_connect}s start=%{time_starttransfer}s total=%{time_total}s\n' \
  http://10.0.1.20:8080/healthz
一次成功不代表配置已经稳定。建议连续执行多次,确认状态码和响应时间没有明显波动。例如,示例验收结果可以记录为:
code=200 connect=0.003s start=0.018s total=0.020s
code=200 connect=0.002s start=0.016s total=0.018s
code=200 connect=0.002s start=0.021s total=0.023s
这些数据只是示例,实际应以测试环境和业务接口的响应情况为准。
在后端访问日志中搜索 /healthz 或实际配置的路径,核对以下字段:
如果后端完全没有对应日志,而控制台显示异常,应优先检查网络访问控制、路由、监听端口和安全组。如果后端日志显示 200,但控制台仍显示异常,则应继续检查云平台是否要求特定状态码、响应头、证书信任、请求方法或探测端口。
不要把业务访问日志中偶尔出现的 200 当成健康检查证据。业务请求可能来自用户、缓存层或其他代理,必须结合请求路径、来源和时间间隔进行区分。
直接访问后端,只能证明后端接口本身可访问;还需要观察负载均衡是否按照健康状态执行了流量分配。
验收时至少关注以下指标:
| 指标 | 主要验证问题 | 合格表现示例 |
|---|---|---|
| 健康后端数量 | 探测结果是否被平台识别 | 与预期实例数一致 |
| 不健康后端数量 | 故障实例是否被摘除 | 测试故障后按阈值增加 |
| 后端 5xx | 流量是否仍进入异常实例 | 故障实例摘除后明显下降 |
| 后端响应延迟 | 健康接口是否超时或抖动 | 持续低于超时时间 |
| 前端请求分布 | 是否只向健康实例分发 | 异常实例不再接收新请求 |
| 连接数和活跃会话 | 摘除后是否仍有存量连接 | 新连接停止,旧连接按策略结束 |
| 健康检查失败原因 | 失败属于网络、协议还是应用 | 原因与后端日志能够对应 |
健康检查状态通常以实例为单位,但实际流量还受到连接复用、长连接、会话保持和连接排空策略影响。后端刚被标记为不健康时,已经建立的连接不一定立即中断;因此不能只看短时间内是否还有少量请求到达该实例。
在没有人为制造故障前,记录一份基线:
这份基线用于区分“配置错误”和“原本就存在的业务问题”。例如,配置健康检查前已经有 5xx,不能把后续健康状态异常全部归因于探测参数。
为了验证阈值是否真的生效,可以在测试环境对单个后端进行可恢复的故障模拟,例如让健康接口临时返回 503,或者让响应时间稳定超过健康检查超时。测试时不要直接停止生产服务、删除配置或修改防火墙规则;如果必须进行生产验证,应先确认影响范围、安排维护窗口、保留原配置并准备恢复操作。
测试记录至少包括:
以间隔 10 秒、不健康阈值 3 次为例,预期不是“10 秒后立即摘除”,而是至少需要累计足够的连续失败探测。若测试结果在不同探测节点之间相差几秒,通常属于调度和状态同步差异;如果长时间没有变化,则应回到日志、指标和平台规则核对。
故障测试完成后,应恢复健康接口原有逻辑,并确认:
多域名、多租户或多端口应用经常出现这种情况:直接访问 IP 时返回 200,但负载均衡探测没有携带正确 Host,最终命中默认站点并返回 404。反过来,默认站点可能恰好返回一个静态 200,又会造成“看似健康、实际业务错误”。
验收时要同时核对 IP、端口、Host、协议和路径,不能只复制浏览器中的完整 URL。
健康检查路径如果被统一认证中间件保护,常见返回结果可能是:
401:缺少登录凭据;403:探测来源未加入允许范围;302:跳转到登录页;429:被限流;503:应用网关或依赖服务主动拒绝。如果平台只认可 200,这些响应都会被视为失败。更稳妥的做法是为健康检查设计独立路由,并通过网络访问控制限制来源,而不是把用户登录流程硬套到探测请求上。
真实流量可能经过 443 转发到后端 8443,而健康检查仍然访问 8080。8080 上的进程即使能够返回 200,也不代表真实请求使用的服务链路正常;如果 8080 没有服务,则会持续失败。
应核对监听器、后端服务组、端口映射和健康检查端口是否为同一业务链路。若有意使用独立管理端口,则必须接受它只能证明独立端口可用,不能完全代表业务端口可用。
HTTPS 健康检查可能因为以下原因失败:
此时应先确认平台对后端证书校验的规则,再用与平台一致的域名、端口和协议测试。不能通过在业务客户端中关闭证书校验,来证明云平台 HTTPS 检查一定能够通过。
健康接口每次都同步查询数据库、缓存和第三方服务,可能造成两个问题:依赖短暂抖动时大量后端同时被摘除;健康检查自身产生额外依赖流量,进一步加重故障。
可以按照故障影响范围分层设计:
不要把包含敏感配置、内部拓扑或详细异常堆栈的诊断信息直接暴露在公网健康路径中。
健康检查配置达到预期,通常需要同时满足以下条件:
可以把最终结果写成一张验收记录:
| 验收项 | 记录内容 | 判断标准 |
|---|---|---|
| 探测路径 | 协议、端口、路径、Host | 与目标业务链路一致 |
| 正常响应 | 状态码、连接时间、总耗时 | 状态码符合规则且未超时 |
| 日志到达 | 时间、来源、实例、请求头 | 能确认请求真正到达 |
| 故障摘除 | 首次失败、达到阈值、摘除时间 | 落在预期时间窗口 |
| 故障恢复 | 首次成功、达到阈值、恢复时间 | 达到健康阈值后恢复 |
| 流量变化 | 前端错误、后端分布、连接状态 | 新请求避开异常实例 |
| 资源影响 | 探测请求量、接口耗时、依赖调用 | 不造成额外明显压力 |
健康检查适合验证后端是否具备接收流量的基本条件,尤其适用于自动摘除已停止、端口不可达、路由错误或应用明确返回不可用状态的实例。它不适合单独承担端到端业务验收,也不能替代应用指标、日志、链路追踪和真实请求监控。
如果业务故障只影响某个接口,而健康路径仍然正常,负载均衡不会自动识别该接口的异常。如果所有后端共享同一个数据库,而数据库故障同时影响全部实例,健康检查可能让所有后端一起变为不健康,前端仍然无法提供服务。若应用采用异步启动、滚动发布或长时间预热,固定的健康阈值也需要结合启动时间和连接排空策略调整。
最终判断应建立在“配置、请求、日志、状态和流量”五类证据之上:配置说明探测规则,请求证明路径可达,日志证明请求到达正确服务,状态指标证明平台完成了判定,流量变化则证明判定真正影响了后端分发。只有这几部分能够相互对应,才能确认探测路径、间隔和阈值不仅填写正确,而且已经达到预期的流量治理效果。
A5idc数据提供中国香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器资源,覆盖企业网站、业务后台、数据库及接口服务等后端场景。不同地区可匹配相应网络线路,结合多IP、不同带宽、NVMe存储及AMD EPYC、Xeon等计算平台,为多后端节点部署、流量分发和健康检查体系提供灵活的基础设施选择。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6228.html