香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


数据库服务器升级后,PostgreSQL 的排序结果发生变化,通常不是 SQL 语法或数据编码突然失效,而是数据库依赖的排序提供者发生了变化。常见触发因素包括操作系统升级、glibc 或其他 libc 版本变化、ICU 版本变化、数据库集群迁移到另一台系统,以及 PostgreSQL 大版本升级时使用了不同的 locale 配置。
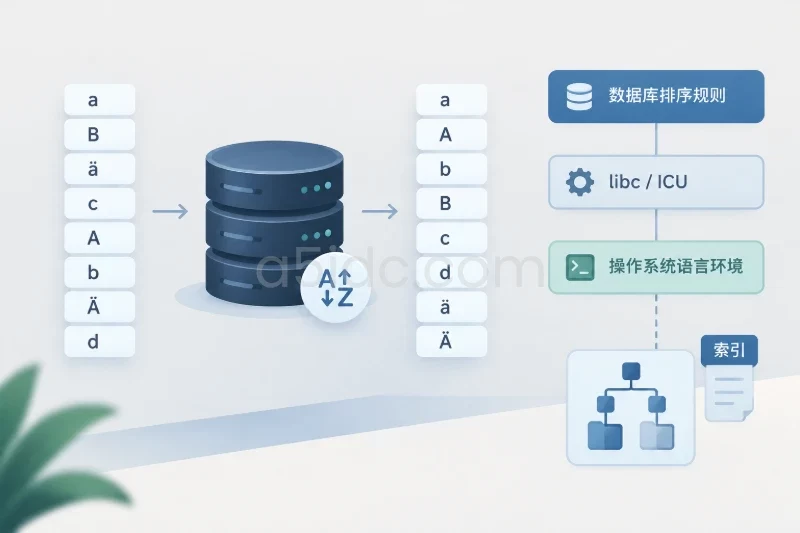
这种变化首先影响 ORDER BY、范围比较、分页和依赖排序的索引;如果列使用了唯一索引、表达式索引或非确定性 ICU 排序规则,还可能影响约束校验、重复值判断和查询结果。确认兼容性不能只比较 PostgreSQL 的版本号,需要同时核对数据库、操作系统、libc/ICU、排序规则提供者,以及应用运行时是否自行实现了另一套排序逻辑。
PostgreSQL 的排序规则不是完全由数据库服务端独立提供,实际结果通常由以下链路共同决定:
应用或SQL表达式
        ↓
数据库列或表达式使用的 COLLATE
        ↓
PostgreSQL 的排序规则提供者
        ↓
libc 或 ICU
        ↓
操作系统及其语言环境数据
其中,libc 排序通常依赖操作系统提供的 locale 数据;ICU 排序则依赖 ICU 库及其语言环境数据。数据库服务器硬件更换本身一般不会改变排序,但如果硬件更换同时伴随操作系统镜像、基础软件包或容器运行时变化,就不能只按“硬件升级”判断。
需要区分以下几类配置:
| 配置或对象 | 作用 | 变化后的主要影响 |
|---|---|---|
server_encoding | 数据库字符编码 | 影响字符存储和编码转换,不等同于排序规则 |
lc_collate | 字符串排序与比较规则 | 影响 ORDER BY、范围比较及部分索引 |
lc_ctype | 字符分类、大小写和字符属性判断 | 可能影响大小写转换及字符处理 |
COLLATE | 为表达式、列或查询指定具体排序规则 | 可覆盖数据库默认规则 |
| libc | 为 libc 提供排序实现和 locale 数据 | 操作系统升级可能改变排序结果 |
| ICU | 为 ICU 提供语言环境和比较实现 | ICU 升级可能改变排序版本 |
| 应用运行时 | Java、Python、Node.js 等自身的排序实现 | 可能与数据库排序结果不一致 |
数据库默认的 lc_collate 和 lc_ctype 通常在创建数据库时确定。它们不是普通运行时参数,不能简单通过修改一个配置文件就替换为另一套默认规则。若业务需要彻底更换数据库默认排序规则,通常要考虑新建数据库或新集群,再通过逻辑迁移、备份恢复等方式完成替换。
在旧服务器和新服务器上分别保存以下信息。查询本身是只读操作,可以先在生产环境执行,但应将结果留档,避免只比较“升级前后能否启动”。
SELECT version();

SHOW server_encoding;
SHOW lc_collate;
SHOW lc_ctype;

SELECT
    datname,
    datcollate,
    datctype,
    datcollversion
FROM pg_database
ORDER BY datname;
再查看数据库中登记的排序规则:
SELECT
    oid::regcollation AS collation_name,
    collprovider,
    collisdeterministic,
    collversion
FROM pg_collation
ORDER BY 1;
collprovider 通常用 c 表示 libc,i 表示 ICU;不同 PostgreSQL 版本对默认排序规则的表示可能存在差异。collversion 是 PostgreSQL 记录的排序规则版本,不应直接当作 PostgreSQL 版本号使用。
如果当前 PostgreSQL 版本提供 pg_collation_actual_version,可以进一步比较数据库记录值和系统实际值:
SELECT
    oid::regcollation AS collation_name,
    collprovider,
    collisdeterministic,
    collversion AS recorded_version,
    pg_collation_actual_version(oid) AS actual_version
FROM pg_collation
WHERE collversion IS DISTINCT FROM pg_collation_actual_version(oid)
ORDER BY 1;
如果查询返回记录,说明 PostgreSQL 记录的版本与当前系统检测到的版本不一致。没有返回记录也不代表业务一定兼容,因为应用可能使用自己的排序库,或者升级前后更换了数据库默认 locale,但数据库元数据没有覆盖到所有业务规则。
操作系统侧还应记录发行版、libc 以及 locale 列表。例如 Linux 环境可以先执行:
cat /etc/os-release
ldd --version 2>&1 | head -n 1
locale -a | sort
不同发行版的 ICU 查询方式不完全一致。对于数据库是否发现排序版本变化,应优先参考 PostgreSQL 的 collversion 和 pg_collation_actual_version,不要用某个系统命令输出的库版本号代替数据库层判断。
只查看数据库默认值不够。业务表可能在列级别使用了其他排序规则,也可能在索引表达式或查询中显式使用 COLLATE。
查看列级排序规则:
SELECT
    n.nspname AS schema_name,
    c.relname AS table_name,
    a.attname AS column_name,
    co.collname AS collation_name,
    co.collprovider,
    co.collisdeterministic,
    co.collversion
FROM pg_attribute AS a
JOIN pg_class AS c
    ON c.oid = a.attrelid
JOIN pg_namespace AS n
    ON n.oid = c.relnamespace
JOIN pg_collation AS co
    ON co.oid = a.attcollation
WHERE a.attnum > 0
  AND NOT a.attisdropped
  AND a.attcollation <> 0
  AND n.nspname NOT LIKE 'pg_%'
  AND n.nspname <> 'information_schema'
ORDER BY n.nspname, c.relname, a.attname;
查看索引键登记的排序规则:
SELECT
    i.indexrelid::regclass AS index_name,
    co.collname AS collation_name,
    co.collprovider,
    co.collversion,
    pg_get_indexdef(i.indexrelid) AS index_definition
FROM pg_index AS i
CROSS JOIN LATERAL unnest(i.indcollation) AS u(collation_oid)
JOIN pg_collation AS co
    ON co.oid = u.collation_oid
WHERE u.collation_oid <> 0
ORDER BY 1, 2;
这两类查询可以找出主要依赖,但表达式索引、函数内部排序和应用拼接出来的 SQL 仍需结合代码检查。尤其要关注以下对象:
UNIQUE 约束及其背后的唯一索引;lower()、upper() 或其他大小写处理函数的表达式索引;“PostgreSQL 版本没变”只能说明数据库服务端软件没有变化,不能说明排序环境没有变化。以下变化都可能造成排序规则版本变化:
initdb locale;因此,兼容性判断应按“PostgreSQL 版本 + 排序提供者 + 提供者版本 + 数据库和列级配置”组合判断,而不是只写成“PostgreSQL 14 是否兼容 PostgreSQL 15”。
| 变化情况 | 兼容性判断 | 重点验证 |
|---|---|---|
| 仅更换硬件,操作系统和库完全一致 | 通常风险较低 | 检查主从和容器实际镜像是否一致 |
| PostgreSQL 升级,libc/ICU 保持一致 | 仍需验证 | 检查 collversion、索引和应用回归 |
| 操作系统或 libc 升级 | 需要重点处理 | 排序结果、索引重建、唯一约束 |
| ICU 版本升级 | 需要重点处理 | ICU 排序规则、非确定性排序、跨节点一致性 |
| 默认排序规则名称变化 | 不能按原库直接判断 | 新建集群配置、恢复和索引重建 |
| libc 与 ICU 之间切换 | 不属于简单兼容升级 | 业务排序语义、数据迁移和约束冲突 |
| 应用从数据库排序改为程序排序 | 需要双端对照 | 分页、展示顺序和重复值处理 |
B-tree 索引不仅保存字符串值,还依赖比较函数决定键值顺序。如果系统升级后同一批字符串的比较顺序发生改变,旧索引仍然是按旧规则建立的。此时不一定出现数据文件损坏,但索引顺序与当前比较规则可能不再匹配,进而影响范围扫描、排序扫描和依赖唯一性的判断。
典型受影响查询包括:
SELECT id, title
FROM article
ORDER BY title
LIMIT 50;
以及:
SELECT id, title
FROM article
WHERE title > $1
ORDER BY title
LIMIT 50;
第二类查询常用于基于游标的分页。如果第一页使用旧排序规则得到游标,下一页却在新排序规则下继续查询,可能出现重复记录、遗漏记录或分页边界漂移。
即使排序规则没有变化,ORDER BY title 也不能保证相同值之间的顺序。业务需要稳定分页时,应使用明确的第二排序键,例如:
SELECT id, title
FROM article
ORDER BY title, id
LIMIT 50;
这里的 id 只能解决相同排序值的稳定性,不能消除新旧排序规则之间的差异。
如果旧业务依赖固定的展示顺序、外部接口签名或分页游标,可以暂时保留原来的操作系统 locale、libc/ICU 版本和数据库排序提供者。新服务器应尽量使用与旧服务器一致的系统镜像和软件包来源,并确认主库、备库、测试环境的基础环境一致。
这种路径适合需要先保证旧业务连续性的场景,但不代表可以永久冻结系统软件。旧版本库可能影响安全更新、操作系统维护和后续 PostgreSQL 升级,因此应同时制定后续兼容测试窗口,而不是只保留旧环境。
如果业务规则允许新的语言排序结果,或者升级后的排序更符合现行产品要求,可以接受结果变化,但要重新建立依赖排序的索引,并调整应用测试。
PostgreSQL 检测到排序版本不一致时,常会提示重建相关对象。需要注意,刷新排序版本元数据不会自动重建索引。例如以下操作的作用是更新记录值,而不是修复已有索引:
ALTER COLLATION some_collation REFRESH VERSION;
数据库默认排序规则的元数据刷新通常使用:
ALTER DATABASE appdb REFRESH COLLATION VERSION;
执行刷新前,应先完成受影响对象清单和索引重建计划。若先刷新元数据,再查找差异,可能会失去原始不一致提示,增加后续核对难度。
在确认备份、维护窗口、连接排空和回滚方案后,可以对目标数据库执行较宽范围的重建:
REINDEX DATABASE appdb;
该操作可能占用大量 CPU、磁盘 I/O 和锁资源,具体阻塞行为还与 PostgreSQL 版本、索引类型和访问方式有关。生产环境不应直接照搬到高峰期执行。若只重建单个表或索引,应先确认该对象确实覆盖了受影响的列、表达式和约束。支持并发重建的版本可以针对单个索引评估 REINDEX INDEX CONCURRENTLY,但它会产生额外空间和时间开销,也不能替代完整的依赖清单。
如果业务需要跨服务器、跨地区保持更一致的语言排序,可以考虑为关键列或数据库设计明确的 ICU 排序规则。需要注意,ICU 并不意味着排序结果永久不变,ICU 升级仍可能带来版本差异;同时,确定性排序和非确定性排序对相等判断、索引和唯一约束的影响也不同。
新规则更适合在新数据库或新集群中设计验证,而不是直接把现有生产数据库的默认排序规则“改名替换”。可采用的方式包括:
COLLATE;如果选择备份恢复,目标环境会按目标规则重建索引,但数据中原本被旧规则接受的值,可能在新规则下触发唯一约束冲突。因此,恢复成功不等于业务兼容,仍需验证约束和接口结果。
旧生产库和新业务库并行时,不能只比较表数据行数。相同的字符串数据在两个环境中可能拥有不同排序结果,导致以下问题:
并行阶段应把排序规则作为环境契约的一部分,明确哪些接口必须保持旧顺序,哪些接口允许切换新顺序,哪些数据只能在同一排序环境内生成和消费。
围绕 PostgreSQL 升级时的新旧环境并行需求,A5idc数据提供中国香港、美国、日本等地区的物理服务器,涵盖 Xeon Gold、AMD EPYC 平台及 SSD、NVMe 等存储配置,可为旧业务库、新集群和应用服务分别提供部署资源。多地区的计算、存储与线路选择,也为跨地区业务安排迁移期间的数据库和接口环境提供了基础。
需要重点检查 ORDER BY、DISTINCT ON、窗口函数排序、范围条件以及 LIMIT/OFFSET 分页。GROUP BY 和普通等值判断通常不应简单归因于排序规则变化,但使用非确定性 ICU 排序规则时,比较和等价语义可能发生变化,必须通过实际测试确认。
应用如果在数据库中排序后又在 Java、Python、Node.js 等运行时重新排序,也可能产生双重不一致。应明确排序责任由哪一层承担,避免数据库按一种规则返回,应用再按另一种规则重排。
字符串列上的普通索引、表达式索引、唯一索引和唯一约束都应纳入清单。尤其需要检查:
UNIQUE (name) 是否会出现新的等价值;lower(name) 唯一索引是否改变大小写折叠结果;排序版本不一致时,不能把“数据库可以正常启动”视为索引已经兼容。
物理复制要求主库和副本使用相容的数据库大版本及运行环境。即使 WAL 能够正常传输,也应核对副本的操作系统、libc/ICU 和排序规则版本,避免主副本的查询结果不同。
逻辑复制传输的是数据变化,不会把源端的排序语义一并传给目标端。目标端建立索引和执行唯一约束时,会按照目标环境的规则处理。因此,逻辑复制切换前要单独验证目标端的排序和约束。
备份恢复到新服务器后,索引通常会在目标环境重新建立,但这会把新排序规则带入查询结果。恢复测试应同时检查数据量、约束、索引状态、接口样例和分页连续性。
先保存 PostgreSQL、数据库 locale、排序规则版本和系统库信息。对旧生产库执行只读查询,对新环境执行相同查询,再逐项比较。
至少应记录:
lc_collate、lc_ctype、编码;pg_database.datcollversion;pg_collation.collversion 与实际版本;不要只使用空库或少量英文数据。测试数据应覆盖业务中真实出现的类别,例如大小写混合、重音字符、中文、日文、土耳其语字符、组合字符、数字和符号。
可以使用临时表进行基础顺序对照:
CREATE TEMP TABLE sort_probe (
    value text
);

INSERT INTO sort_probe (value) VALUES
    ('a'),
    ('A'),
    ('ä'),
    ('å'),
    ('ß'),
    ('ss'),
    ('é'),
    ('é'),
    ('中'),
    ('İ'),
    ('i');

SELECT value
FROM sort_probe
ORDER BY value;

SELECT value
FROM sort_probe
ORDER BY value COLLATE "C", value;
第一条查询用于观察数据库默认排序,第二条查询用于提供一个明确的字节序参照。"C" 不代表任何特定语言的自然排序,不能直接当作业务规则,只适合用于对照和定位差异。
在旧环境和新环境分别保存第一条查询的完整顺序,并继续验证以下条件:
ORDER BY ... LIMIT 的前后页是否连续;执行列级和索引级查询,结合数据库对象定义、ORM 模型和业务 SQL 做补充检查。对于没有显式 COLLATE 的字符串列,也要考虑它们是否继承了数据库默认规则。
如果暂时无法精确列出所有依赖对象,生产处理可以采用更保守的数据库级重建方案,但必须提前评估锁、磁盘、CPU、连接和维护时间。不要因为一条告警只重建一个看起来相关的索引。
应用回归应优先覆盖依赖顺序的功能,而不是只检查登录、增删改查是否成功:
如果应用层也进行排序,应将数据库结果和运行时结果并列比较,确认最终对外规则只有一套。
确认新旧环境的业务差异属于“可接受变化”后,再在维护窗口内执行排序规则刷新和索引重建。执行前应完成数据库备份或可恢复快照,确认剩余磁盘空间,并明确失败时的处理方式。
REFRESH VERSION 本身不提供旧排序索引的回滚能力;索引重建完成后,若要恢复旧语义,通常需要切回保留的旧环境,或在旧排序环境中重新建立索引。因此,生产切换前应保留旧服务器或旧集群一段时间,并避免让无法回放的写入只存在于新环境。
最后再次查询排序版本、索引状态和关键接口结果,确认告警消失只是其中一个条件,不能替代业务验证。数据库服务器升级后,下一步应先回答“变的是 PostgreSQL、操作系统库、排序提供者,还是应用自身排序”,再根据旧业务是否必须保持原顺序,选择保留环境、接受变化并重建索引,或在新集群中引入明确的排序规则。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/6140.html