香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


网站接入AI客服后,请求链路和业务数据流的复杂度会明显高于传统静态站点。一次用户提问背后,可能同时涉及前端页面、会话网关、大模型API、业务数据库、向量检索和日志存储等多个环节。对于把AI客服部署在美国服务器上的业务方来说,真正要回答的不是“买什么配置”,而是:用户请求从哪进来、经过哪些组件、每一步产生什么数据、数据落在哪里、负载高峰出现在哪个环节。把这些想清楚,服务器和资源安排自然就有了依据。
A5数据提供美国常规Xeon、AMD EPYC、GPU及多IP物理服务器资源,可为AI客服的前端接入、会话网关、业务应用、数据库和日志存储提供不同层次的硬件基础。美国产品配有不同内存、NVMe存储与CN2 GIA线路方案,GPU系列则可承载模型推理和测试,便于将请求链路中的计算、数据与网络环节落到相应的部署资源上。
AI客服的典型业务流程可以拆成几个动作:访客打开网站并加载客服组件;输入问题;系统结合业务知识生成回答;必要时转接人工;会话结束后留存记录供后续分析。
这些动作各自形成不同的请求路径:
关键在于识别每条路径的访问人群和频次。北美本地用户为主的站点,美国服务器可以同时承担前端、API和会话网关;而访客分布在多个大洲时,前端接入点与会话后端的部署位置就要分开考虑,因为模型调用环节的时间消耗决定了整体响应下限,接入层距离带来的延迟需要控制在次要位置。
把一次典型会话请求完整走一遍,可以看出数据的流向和各环节的约束:
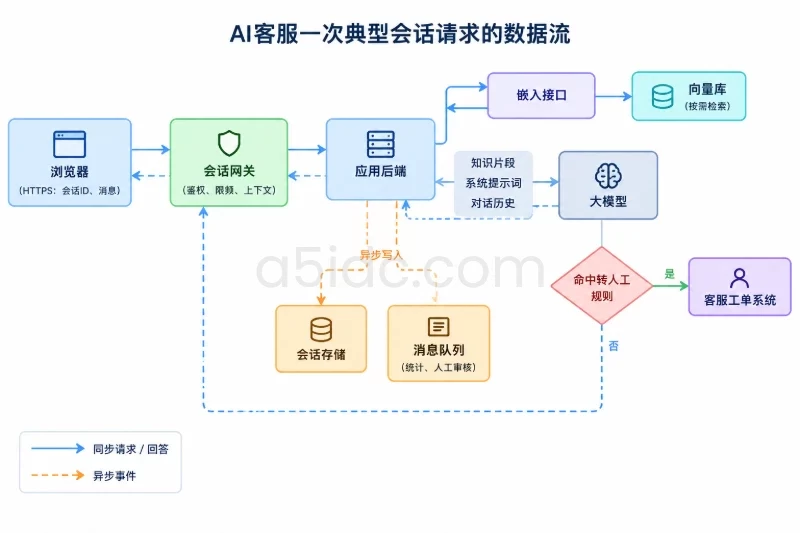
由此能看出几条硬约束。响应延迟主要由模型调用决定,网关到模型服务之间的网络质量直接影响体验;如果模型是第三方API,美国服务器与该API所在区域的链路要纳入评估。并发约束体现在会话状态和连接保持上:流式输出意味着每个活跃会话占住一条长连接,500个并发流式会话就是500条同时存活的连接,加上SSE或WebSocket的心跳,对连接数和内存的消耗要按活跃会话数而不是日活来估算。数据一致性约束较轻——会话记录允许短暂的异步落库延迟,但订单类业务数据查询必须实时且带权限校验,这两类数据应分库存放,避免互相争抢资源。
把上述数据流映射到服务器资源,可以得到一个需求清单:
| 组件 | 业务作用 | 资源关注点 |
|---|---|---|
| 会话网关/API服务 | 承接用户请求、鉴权、限流 | CPU中等,内存按并发连接数估算,网络吞吐敏感 |
| 应用后端 | 组装提示词、调模型、查业务数据 | CPU为主,依赖与模型API的链路延迟 |
| 关系数据库 | 会话记录、工单、用户数据 | 磁盘IO与备份能力,容量随会话量线性增长 |
| 向量数据库 | 知识库相似检索 | 内存为主,容量随知识条目数和维度增长 |
| 对象存储 | 知识文档、日志归档、导出文件 | 容量与带宽,读多写少 |
| 消息队列 | 异步落库、统计、审核事件 | 常规配置即可,注意持久化 |
| 监控与日志 | 链路追踪、错误率、模型耗时统计 | 磁盘容量,保留周期 |
按典型规模粗略估算:日均1万次会话、峰值50个并发流式会话的站点,一台8核32GB的服务器可以承载网关、应用后端和消息队列;向量库如果知识条目在几十万条以内、向量维度1536,内存占用大约在几GB到十几GB量级,可以和应用共置;业务数据库建议独立实例,即使规格不大,也要和应用分离,因为数据库IO抖动会拖慢所有请求。日会话量上到十万级、并发会话过百时,网关和后端应各自独立,并预留横向扩展的架构空间。
需要特别计算的是网络带宽。流式回答平均每次会话输出约2KB文本,加上TLS和协议开销按3KB计,日均1万次会话产生的出站流量约30MB,这在带宽层面几乎可以忽略;真正的带宽消耗仍来自网站本身。也就是说,AI客服对服务器资源的压力在CPU内存与连接管理,而不是流量,这一点和很多人的直觉相反。
在美国服务器上部署AI客服,常见有三种形态,对应不同的业务条件。
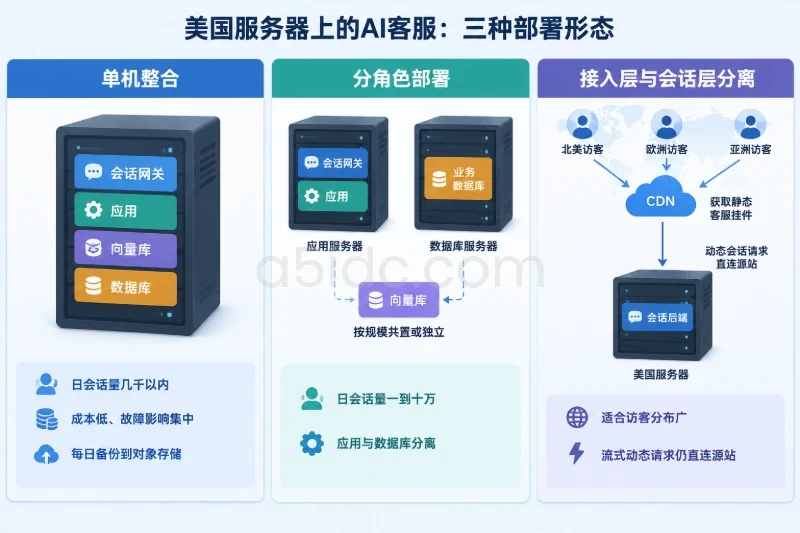
单机整合部署适合日会话量几千以内、团队规模小的场景。网关、应用、向量库、数据库全部装在一台服务器上,用容器编排管理。优点是成本低、运维简单;缺点是任何组件异常都影响全局,扩展只能整体升配。这种形态下必须做每日数据库备份到对象存储,因为单机故障意味着全部数据同时暴露风险。
分角色部署是目前最平衡的方案:一台服务器跑会话网关和应用后端,一台独立跑业务数据库,向量库视规模决定共置或独立。数据库独立后,应用侧可以随时重启、升级而不影响会话记录;备份、慢查询优化也互不干扰。日会话量一到十万之间,这是主流选择。
接入层与会话层分离针对访客分布广的站点。会话后端留在美国服务器(靠近模型API和业务数据),前端客服挂件和静态资源通过CDN分发到访客所在区域。需要注意流式回答的CDN支持有限,动态会话请求仍直连源站,此时访客到美国源站的往返延迟会成为体验的一部分,对延迟敏感的业务需要在接入侧评估链路质量。
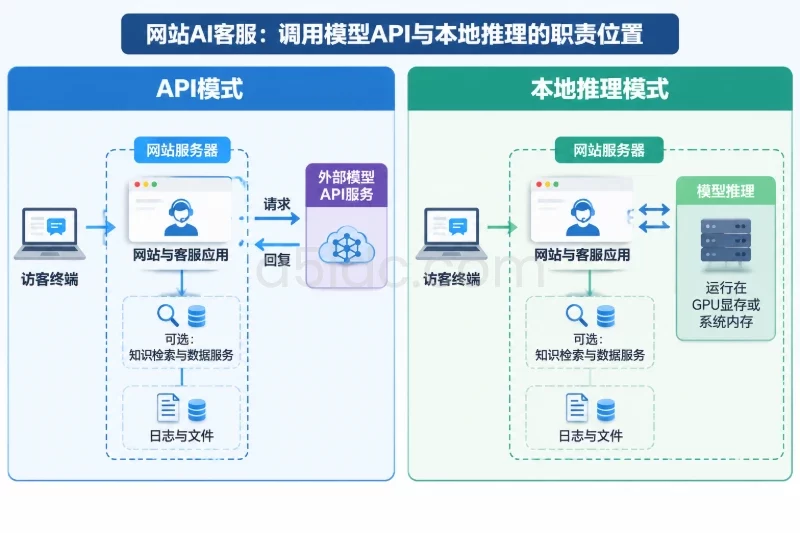
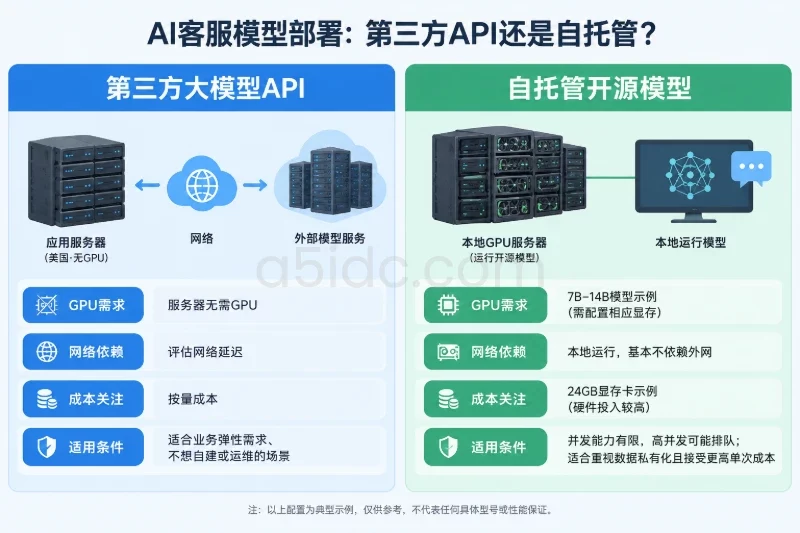
模型侧的选择也影响部署。调用第三方大模型API,服务器不需要GPU,配置压力小,但要评估与API提供方之间的网络延迟和按量成本;自托管开源模型则需要GPU实例,通常7B到14B参数的模型配一张24GB显存的卡可以支撑中小规模并发,但推理并发能力有限,高并发下排队延迟明显,适合对数据私有化要求高、可以接受更高单次成本的团队。
上线后的运维重点和传统网站不同,有几个值得提前安排的事项。
第一是链路耗时监控。AI客服的故障往往不是服务挂掉,而是回答变慢或质量下降。建议对每个环节埋点:网关接收耗时、检索耗时、模型首字延迟、模型总耗时,分别记录。典型情况下模型首字延迟在1秒以内为佳,超过3秒用户会明显流失。有了分段数据,问题定位才不需要猜测。
第二是成本与配额管理。模型API按token计费,一次会话的成本由输入上下文长度和输出长度决定。控制对话历史轮数、压缩知识片段,既降成本也降延迟。同时要在网关层做每用户的频率限制,防止异常流量直接放大账单。
第三是数据保留与合规。会话内容可能包含用户个人信息,数据库和日志要设定保留周期,过期数据归档或删除;跨区域业务要确认会话数据存储位置符合自身的合规要求,这也是选择美国服务器承载客服数据前需要明确的业务前提。
第四是扩展路径。架构上从一开始就让会话网关无状态——会话上下文存在数据库或缓存里而不是应用内存中——这样后续加一台服务器做负载均衡只是加节点,不需要迁移逻辑。数据库则通过升配支撑更久,等写入压力真正上来再考虑读写分离。
回到业务条件本身:先用两周左右的实际会话数据确认日均量、峰值并发和单次回答的平均耗时,这三个数字直接决定是单机整合还是分角色部署、模型走API还是自托管、带宽和内存按什么档位准备。A5IDC的美国服务器提供从入门单机到独立数据库、GPU实例的多档选择,按上述链路拆解对号入座,可以先用一台中配机器承载网关和应用、独立数据库实例起步,在业务量验证后再按实测瓶颈扩容,避免一开始就为未发生的并发买单。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5958.html