香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


服务器上已经有应用日志,排查目标是找出某个时间段内包含 ERROR 或 timeout 的记录,同时看到每条记录前后的日志。对于时间戳和关键词位于同一行的文本日志,可以用 grep -E 同时限定时间与关键词,再用 -B、-A 或 -C 保留原文件中的上下文。
关键是在原始日志上完成匹配并提取上下文。如果先按时间筛出若干行,再对筛选结果执行 grep -C,时间范围外但紧挨故障的记录已经被丢弃;如果先只筛关键词,后续输出也可能失去判断故障发生时间所需的相邻记录。
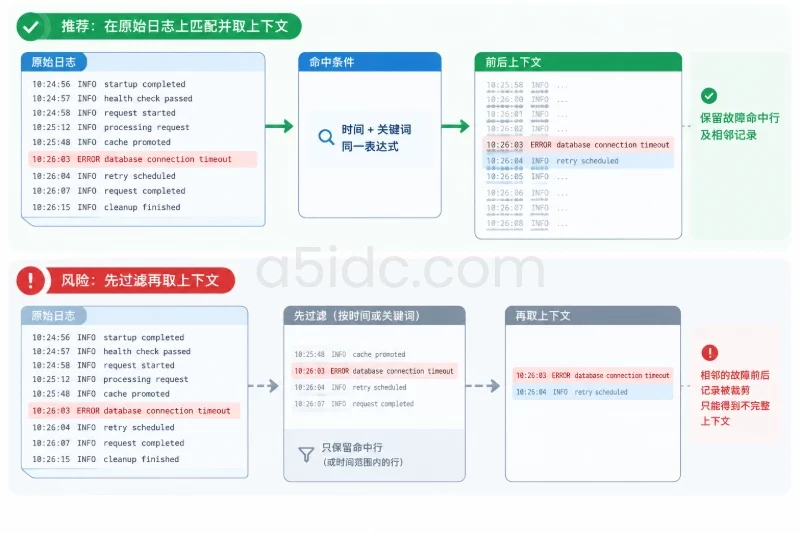
以下以 /var/log/myapp/app.log 为示例路径,日志每行以 YYYY-MM-DD HH:MM:SS 开头。实际操作时,先换成目标服务的日志路径,并检查文件是否可读、时间戳是否确实位于行首:
log=/var/log/myapp/app.log

test -r "$log" && printf '日志可读:%s\n' "$log"
head -n 3 "$log"
tail -n 3 "$log"
date '+系统时间:%F %T %Z %z'
例如,适用下文命令的日志行可能是:
2026-04-12 10:24:58 INFO request started id=8f2
2026-04-12 10:26:03 ERROR database connection timeout id=8f2
2026-04-12 10:26:04 INFO retry scheduled id=8f2
先核对三个条件:
date 显示的是当前系统时间口径,不代表历史日志一定采用同一口径。.1 或压缩归档中。本文查询的是示例日期 2026-04-12 的 10:25:00 至 10:35:59。这个范围覆盖 10:25 到 10:35 的完整分钟;如果验收要求截止于 10:35:00,就不能照用同一个正则。
先把时间与关键词写进同一条匹配表达式,再让 grep 从原文件取上下文:
log=/var/log/myapp/app.log
pattern='^2026-04-12 10:(2[5-9]|3[0-5]):[0-5][0-9].*(ERROR|timeout)'

grep -n -i -C 5 -E "$pattern" -- "$log"
这条命令只读取日志,不会修改原文件。各部分分别承担不同任务:
^2026-04-12 要求日期出现在行首,避免把正文中提到的日期误当成该行时间。10:(2[5-9]|3[0-5]):[0-5][0-9] 匹配 10:25:00—10:35:59。.*(ERROR|timeout) 要求同一行在时间戳之后出现任一关键词;-i 使关键词匹配不区分大小写。-n 显示原文件行号;-C 5 为每条命中记录附带前后各 5 行。-- 将表达式与文件参数分开,便于路径以特殊字符开头时仍按文件处理。输出中的命中行与上下文行可以这样区分:
120-2026-04-12 10:24:58 INFO request started id=8f2
121:2026-04-12 10:26:03 ERROR database connection timeout id=8f2
122-2026-04-12 10:26:04 INFO retry scheduled id=8f2
使用 -n 时,行号后的 : 表示该行匹配了表达式,- 表示该行只是上下文。两组结果相隔较远时,grep 通常用 -- 分隔;上下文范围重叠时则会合并,不会把同一行重复打印。上例中的 10:24:58 虽然早于查询起点,仍会出现,因为它是故障前的上下文,不是时间条件命中的记录。
如果要多看故障后的处理过程,而故障前只需少量记录,可以分别指定两侧行数:
grep -n -i -B 3 -A 12 -E "$pattern" -- "$log"
-B 3 是命中行之前 3 行,-A 12 是之后 12 行。上下文行数应按日志密度调整:每秒成百上千行的日志,前后 5 行可能只覆盖极短时间;低频日志的 5 行则可能跨越很久。行数不是时间长度。
正式阅读上下文前,可以先只看命中行,核对日期、时段和关键词是否都落在预期位置:
grep -n -i -E "$pattern" -- "$log"
验收时至少检查一条命中行的原文件行号及完整时间戳,再向前后看同一请求 ID、任务 ID 或错误调用链。不要仅凭输出里出现 ERROR 就判断条件正确:它可能只是另一条命中记录的上下文。
如果需要统计,grep -c 统计的是匹配的行数,不是错误事件数,也不是关键词出现次数:
grep -c -i -E "$pattern" -- "$log"
一行同时包含 ERROR 和 timeout,计数仍为 1;一处故障写出多条匹配日志,则可能计为多行。需要按请求或事件去重时,应结合日志中的业务标识另行判断。
自动化检查还应区分“没有命中”和“读取失败”。GNU grep 常见退出状态为:0 表示有匹配,1 表示无匹配,2 表示发生错误。可在不输出日志内容时检查:
grep -q -i -E "$pattern" -- "$log"
rc=$?
printf 'grep 退出状态:%s\n' "$rc"
执行完 grep 后立即取得 $?,避免它被下一条命令覆盖。状态为 2 时,优先检查路径、读取权限及表达式,而不是直接认定该时段没有故障。
没有输出时,从低风险的只读检查开始,分别验证时间和关键词,避免一次改动多个条件:
log=/var/log/myapp/app.log

# 先确认示例日期和小时在文件中存在
grep -n -m 5 -E '^2026-04-12 10:' -- "$log"

# 再确认关键词在文件中是否存在
grep -n -m 5 -i -E 'ERROR|timeout' -- "$log"
第一条无结果而第二条有结果,通常要检查日期、时区、文件选择或日志轮转;第一条有结果而第二条无结果,则要核对实际使用的错误级别和关键词。两条都有结果,但组合条件无结果,说明它们未必出现在同一时间段、同一行。-m 5 只是让这两次抽样检查在找到 5 行后停止,不能据此计算总量。
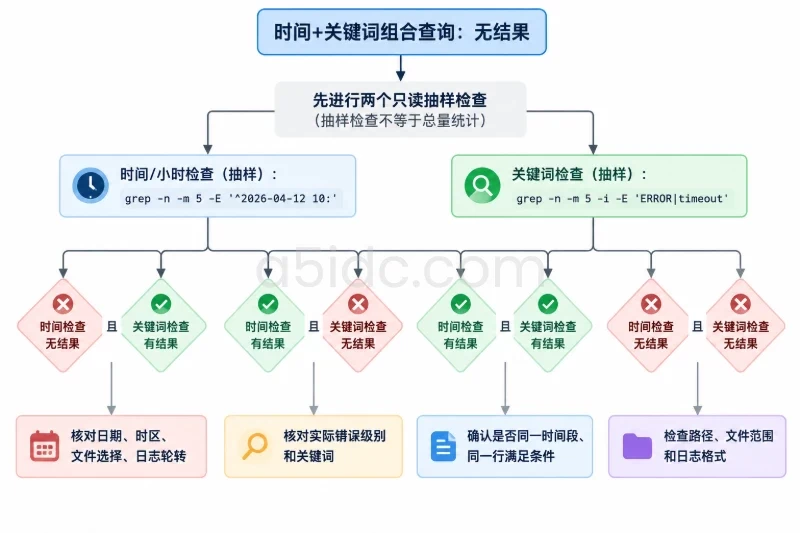
还要留意以下边界:
[ 开始,^2026-04-12 自然不会命中。先查看原始行,再按实际格式修改正则。 grep -n -i -B 8 -A 12 -E 'ERROR|timeout' -- "$log"
此命令不再限定时间,日志很大时输出可能较多;不能把上下文中最近的时间戳不经核对就当作续行的精确发生时间。
   pattern='^(2026-04-12 23:5[5-9]:[0-5][0-9]|2026-04-13 00:0[0-5]:[0-5][0-9]).*(ERROR|timeout)'
   grep -n -i -C 5 -E "$pattern" -- "$log"
   gzip -t -- /var/log/myapp/app.log.1.gz
   gzip -cd -- /var/log/myapp/app.log.1.gz |
     grep -n -i -C 5 -E "$pattern"
第二条命令的行号属于该归档解压后的内容,不是当前 app.log 的行号。若要据此认定“无匹配”,还需确认解压过程成功;不要只看管道末端没有输出。
对带毫秒、JSON 字段时间或非固定格式的日志,也应先观察样本再写表达式。尤其是要求精确到任意起止秒的时间窗口时,手写分钟范围正则容易多选或漏选;应改用与该时间格式相符的时间比较方法,再明确上下文是否仍取自原文件,不要把过滤后相邻的行误称为故障前后日志。
上述查询均为只读操作,不需要停止服务或改动日志配置。若需把结果交给同事,避免用 > 写入现有文件:重定向会覆盖目标文件。可以在获准保存日志摘录的目录中,用 mktemp 创建一个仅供当前用户访问的新文件;日志可能含 IP、令牌或业务字段,应按内部留存要求处理。
umask 077
report=$(mktemp "$HOME/loggrep.XXXXXXXX") || exit 1

grep -n -i -C 5 -E "$pattern" -- "$log" > "$report"
rc=$?
printf 'grep 退出状态:%s;结果文件:%s\n' "$rc" "$report"
这里的写入范围仅是新建的结果文件,不影响源日志。若 rc 为 1,结果文件可能为空;若为 2,先排除读取错误,不要交付为“未发现故障”。不再需要摘录时,先核对 report 指向的是刚创建的文件,再按留存要求清理,切勿把清理命令指向源日志。查询期间如遇日志轮转,应重新确认正在读取的文件和归档范围,必要时重新执行查询。
交付排查结果前,按下面的清单复核:
日志排查不仅依赖grep命令,也离不开稳定承载业务日志的服务器资源。A5数据提供香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器,覆盖建站、数据库及不同存储需求;部分方案搭载NVMe存储,可为业务程序运行与日志读写提供硬件基础。多地区资源也能适配不同区域的业务部署,让日志所在的应用服务按需运行在相应的服务器环境中。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5938.html