香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


“Docker Compose可以用docker compose up -d做滚动替换,服务不会中断”——这句话在很多教程里出现过,但直接照做的人往往会发现,替换过程中请求照样失败。原因并不复杂:Compose原生提供的滚动更新能力只对Swarm模式下的deploy配置生效,普通docker compose up -d在单机上是“先停旧容器、再启新容器”的顺序替换,中间存在一段服务完全不可用的窗口。对于内部工具,几秒钟的窗口可以接受;对于对外提供HTTP服务的业务,这段时间就是真实的失败请求。
这篇内容不否定Compose的价值,而是把“无中断替换”这个结论拆开:它在什么条件下成立,在哪些常见场景下失效,单实例服务到底受哪些限制,以及上线前如何用低成本的方式验证自己的替换流程是否真的无中断。
“Compose可以无中断更新”这个说法,严格成立需要同时满足以下条件:
docker stack deploy),deploy.replicas大于等于2,并且update_config配置了合理的parallelism和order: start-first;docker compose up --no-deps --scale扩容新版本、再缩容旧版本来实现替换;healthcheck)配置正确,新容器在真正就绪之前不会被纳入流量;四个条件里缺任何一个,“无中断”都会打折扣。最常见的缺口有两个:副本数为1,以及健康检查缺失导致新容器未就绪就接流量。
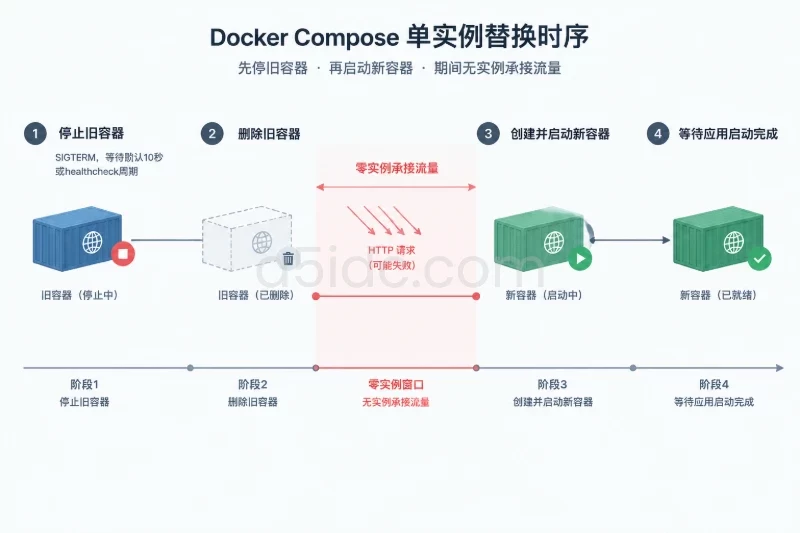
这是最典型的边界。一个只配置了一个容器的服务,执行版本替换时的实际时序是这样的:
docker compose up -d web

1. 停止旧容器(SIGTERM,等待默认10秒或healthcheck周期)
2. 删除旧容器
3. 创建并启动新容器
4. 等待应用启动完成
在第1步到第4步之间,这个服务的所有端口都没有进程监听。假设应用启动需要5秒,那么就有至少5到10秒的完全不可用窗口。期间到达的TCP连接会被拒绝(端口未监听)或超时,对客户端表现为连接失败,而不是平滑过渡。
有人认为给服务配了healthcheck就能解决,实际上不能。Compose单机模式的healthcheck只决定容器被标记为healthy的时间,并不提供“新容器healthy之前保留旧容器”的编排逻辑——因为单实例下根本没有第二个容器可以承接流量。
用--scale扩到2个实例、替换镜像、再缩回1个,思路是对的,但细节容易出错:
services:
  web:
    image: myapp:v2
    ports:
      - "8080:8080"
注意ports写的是固定端口映射。第二个容器会因为宿主机8080端口被占用而启动失败,扩容根本做不到。要支持多实例,端口必须改成ports: - "8080"让Docker随机分配,或者干脆不映射端口、由上游代理通过容器网络访问。这是单实例思维留下的配置痕迹,也是滚动替换在Compose单机上最常见的第一个卡点。
第二个卡点是缩容时的会话问题。docker compose up --scale web=2之后执行docker compose stop或再次up时,Compose停止哪个实例、是否等它处理完存量请求,取决于stop_grace_period和应用的SIGTERM处理。如果应用收到SIGTERM就直接退出,正在处理中的长请求会被截断。
一个看起来合理的架构:Nginx做反向代理,upstream指向web:8080(Compose网络内的服务名)。用扩缩容方式替换新版本后,Nginx可能仍然把请求发往已经不存在的旧容器IP,返回502。
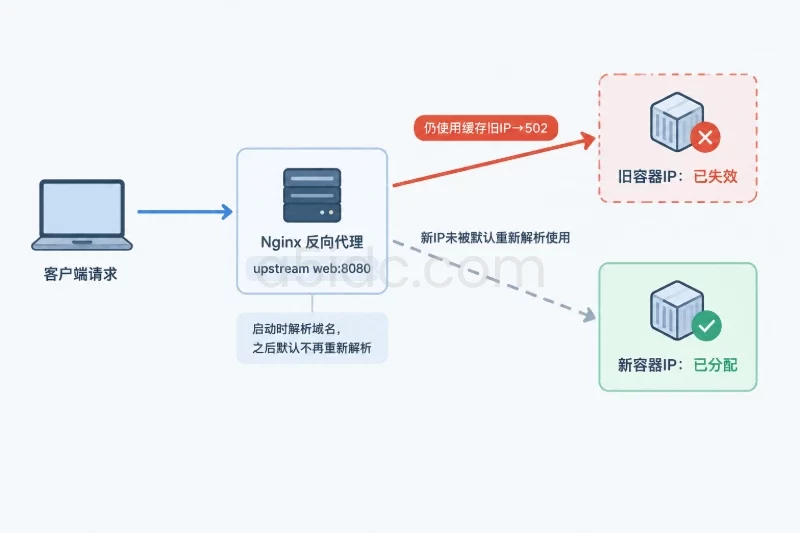
原因是Nginx在启动时解析upstream中的域名,之后默认不再重新解析(除非在proxy_pass中使用变量并配置resolver)。旧容器销毁、新容器拿到新IP后,Nginx缓存的IP就成了死地址。这个反例说明:即使容器编排层面做到了“新旧并存”,流量层如果不配合,“无中断”依然不成立。
核心在于流量承接能力。无中断替换的必要条件是:任意时刻至少有一个健康实例在接收流量。这意味着替换过程中新旧实例必须有一段共存期,让流量从旧实例平滑切到新实例。单实例服务在任何时刻都只有一个容器,替换必然经历“零实例”窗口,这是结构性的限制,不是配置技巧能绕过的。
Compose单机模式与Swarm模式的差异也在这里:
| 能力 | Compose单机 | Swarm模式 |
|---|---|---|
| 多副本编排 | 手动--scale,无自动策略 | deploy.replicas声明式管理 |
| 滚动更新策略 | 不支持deploy.update_config | 支持parallelism、order、延迟 |
| 新实例就绪控制 | 依赖healthcheck状态,但不阻塞编排 | order: start-first配合healthcheck,旧实例在新实例就绪后才停 |
| 失败回滚 | 手动 | 可配置failure_action: rollback |
换句话说,很多人引用的“滚动更新配置”(deploy.update_config.order: start-first)在普通docker compose up下是被忽略的。这是文档明确的行为,但容易被混合阅读两套文档时误用。
与其在发布时才发现中断,不如在预发布环境用一套固定的验证流程确认。以下方法适用于普通Compose单机部署:
1. 端口配置检查。 确认服务没有使用固定的宿主机端口映射,否则多实例共存无法实现:
docker compose config | grep -A3 ports
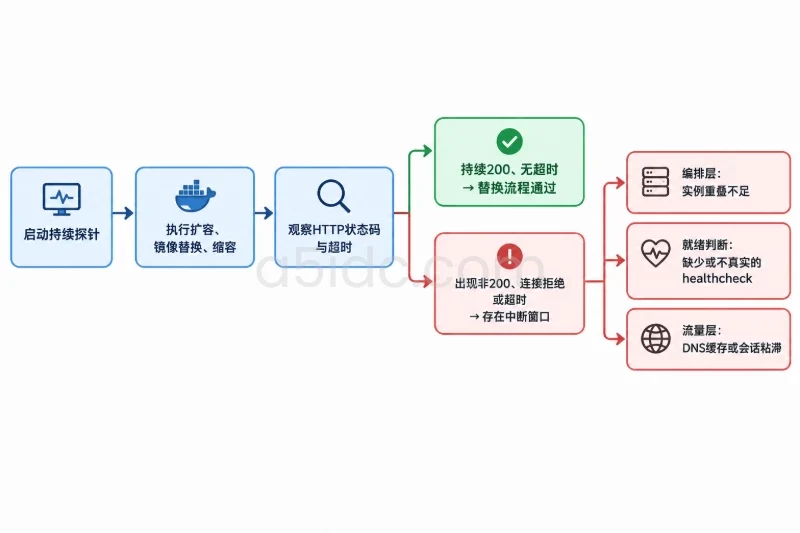
2. 用探针脚本模拟持续流量。 起一个循环请求脚本,替换过程中观察是否有失败:
while true; do
  code=$(curl -s -o /dev/null -w "%{http_code}" --max-time 2 http://127.0.0.1:8080/health)
  echo "$(date +%T) $code"
  sleep 0.5
done
3. 执行替换并观察。 依次执行扩容、镜像替换、缩容,记录探针日志中出现的非200状态码或超时。如果出现连续5xx或连接拒绝,说明中断窗口存在,需要回查是编排层(实例重叠不足)、就绪判断(缺healthcheck)还是流量层(DNS缓存、会话粘滞)的问题。
4. 健康检查真实性核对。 healthcheck探测的路径要能代表“可以接业务流量”,而不是仅代表“进程活着”。一个只检查TCP端口监听的healthcheck,无法发现应用还在做数据库迁移或缓存预热,这类实例接流量同样会产生失败请求。
5. 优雅退出核对。 给服务配置合理的停止宽限期,并确认应用处理SIGTERM时完成存量请求:
services:
  web:
    image: myapp:v2
    stop_grace_period: 30s
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8080/health"]
      interval: 5s
      timeout: 3s
      retries: 3
这套流程在预发布环境跑通一次,之后每次版本替换按第2、3步复测即可,成本很低。
保留结论成立的必要条件,可以归纳成三条边界:
够用的场景: 副本数可以大于等于1(即愿意接受扩到2个实例再缩回)、服务无状态或会话可外置、前面有能感知容器变化的上游代理(或在代理配置中使用resolver动态解析)、客户端是短连接或有重试。满足这些条件时,Compose单机配合扩缩容和Nginx可以实现工程意义上的无中断替换。
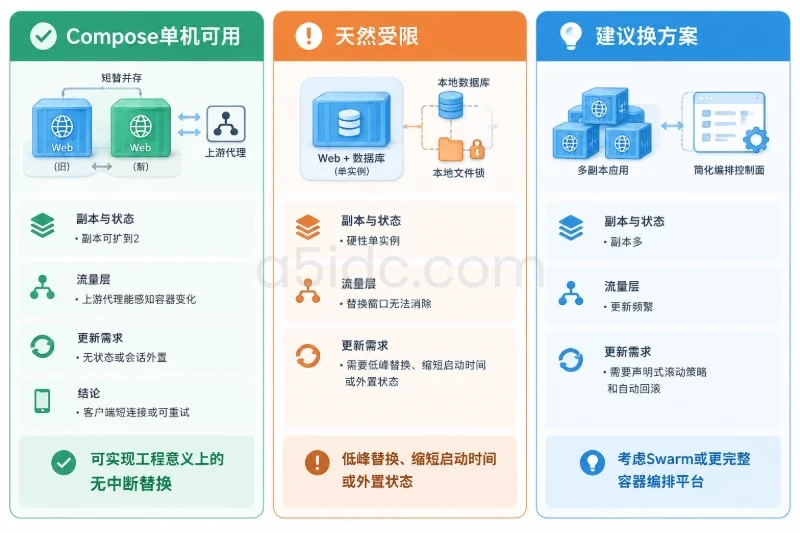
天然受限的场景: 硬性单实例的服务,例如内嵌数据库、依赖本地文件锁的有状态服务、许可证限制单实例运行的应用。这类服务无论怎么配置,替换窗口都无法消除,只能把窗口挪到低峰期、缩短应用启动时间,或者把状态外置后改造成多实例。
建议换方案的场景: 副本多、更新频繁、需要声明式滚动策略和自动回滚的持续交付场景,Swarm模式或更完整的容器编排平台是更匹配的工具,Compose的deploy段在这些场景下才有实际效力。
回到开头那句话:Docker Compose确实能做平滑的版本替换,但“无中断”不是命令自带的属性,而是副本重叠、健康检查、流量层配合三者共同作用的结果。单实例服务缺的正是第一项,这是结构限制而非配置失误。在预发布环境用持续探针跑一遍替换流程,是目前确认自身环境是否落入边界之内最直接的办法。如果验证发现窗口无法消除,把状态外置、拆出可水平扩展的无状态层,或者选择支持start-first滚动策略的编排方式,是三条明确的改进路径。
A5数据提供中国香港、美国、日本等地区的物理服务器,涵盖Xeon与AMD EPYC平台,并提供不同内存、SSD或NVMe存储及带宽线路配置。对于将Compose服务拆分为可水平扩展的应用层、分别承载数据库与反向代理的业务,这些服务器可提供容器副本并行运行和组件分层部署所需的硬件资源;多地区产品也能适配不同访问区域的部署需求。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5892.html