香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


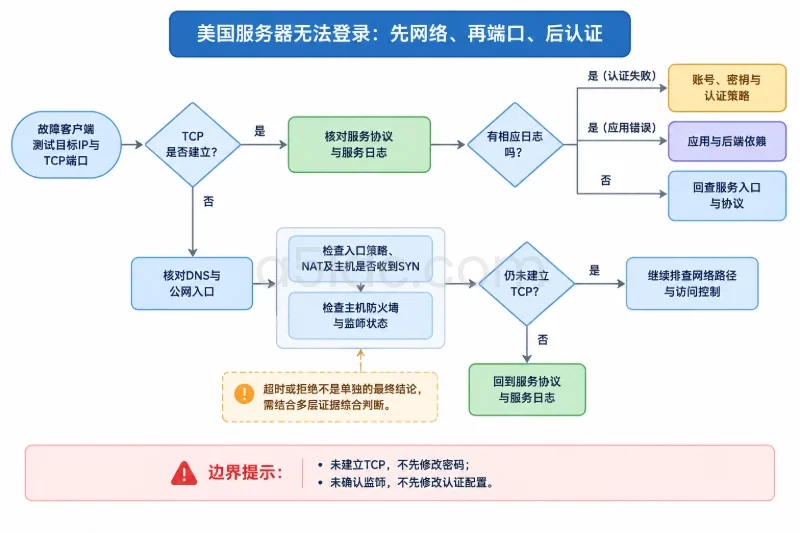
美国服务器突然无法登录时,最容易误判的是把“登录失败”直接归因于账号、密码或密钥。实际上,登录动作至少要经过公网解析、路由、上游安全策略、NAT映射、服务器防火墙、端口监听、服务协议和身份认证多个环节。只要前面的TCP连接没有建立,认证日志里通常不会留下有效记录。
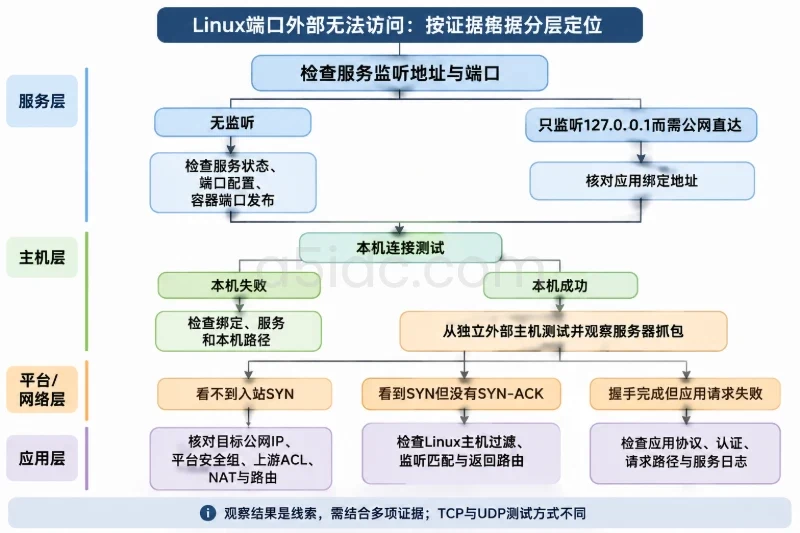
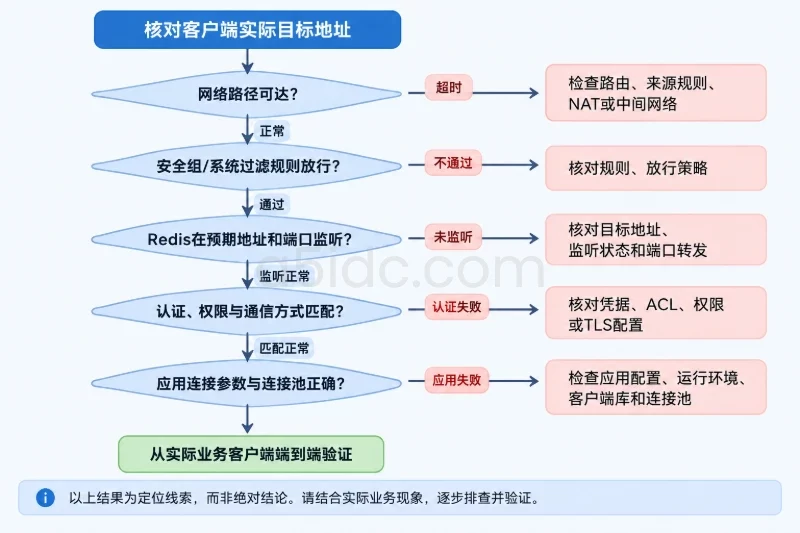
排查应按照“先确认是否到达服务器,再确认端口是否有服务,最后分析认证日志”的顺序进行。这样可以把网络不通、端口被拦截、服务未监听、地址绑定错误和账号认证失败区分开,避免反复修改密码或盲目放开防火墙。
A5数据提供美国物理服务器租用,覆盖常规Xeon、AMD EPYC及多IP服务器,并配备CN2 GIA等线路方案,可为面向美国用户的网站、业务后台、数据库和容器服务提供独立硬件与网络资源。不同配置结合内存、NVMe存储、带宽和IP资源,能够适配从常规建站到多服务部署的场景,为公网入口、端口服务及认证链路的稳定运行提供基础环境。
先固定以下信息,不要只记录“无法登录”:
如果客户端出口IP发生变化,而服务器仍只允许旧IP访问,表现可能就是“服务器突然无法登录”。美国服务器本身没有变化,访问来源变化也可能触发同样的现象。
下面的结果是诊断方向,不应单独作为最终结论:
| 客户端现象 | 常见含义 | 下一步 |
|---|---|---|
Connection timed out | 数据包可能被安全组、防火墙、NAT或链路丢弃 | 检查入口策略,并在服务器侧确认是否收到SYN |
Connection refused | 目标主机可达,但端口没有监听,或设备主动拒绝 | 检查监听状态、服务状态和端口映射 |
| SSH能建立连接,但密码或密钥被拒绝 | 网络和端口大概率正常 | 查看认证日志、账号状态和认证策略 |
| 域名访问失败,但直接访问IP正常 | DNS记录、A/AAAA解析或虚拟主机配置异常 | 分别检查IPv4、IPv6和域名解析 |
| 只有部分网络无法访问 | 来源IP策略、运营商路径、IPv6或区域性ACL问题 | 使用多个已授权来源对比测试 |
| 连接建立后立即断开 | 协议不匹配、服务异常、认证前策略或资源不足 | 查看服务日志和认证前日志 |
“超时”不一定代表服务器宕机,“拒绝”也不一定代表应用完全停止。中间的安全设备可能会主动丢弃或拒绝连接,因此还需要服务器侧证据进行确认。
以下命令用于示例环境,端口需要替换为实际端口。测试应从真正无法登录的客户端执行,而不是只在服务器本机执行。
# 查询IPv4和IPv6解析结果
dig +short A server.example.com
dig +short AAAA server.example.com

# 测试TCP端口是否能够建立连接
nc -vz -w 5 server.example.com 22
nc -vz -w 5 server.example.com 443

# SSH开启详细调试信息
ssh -vvv -o ConnectTimeout=10 user@server.example.com
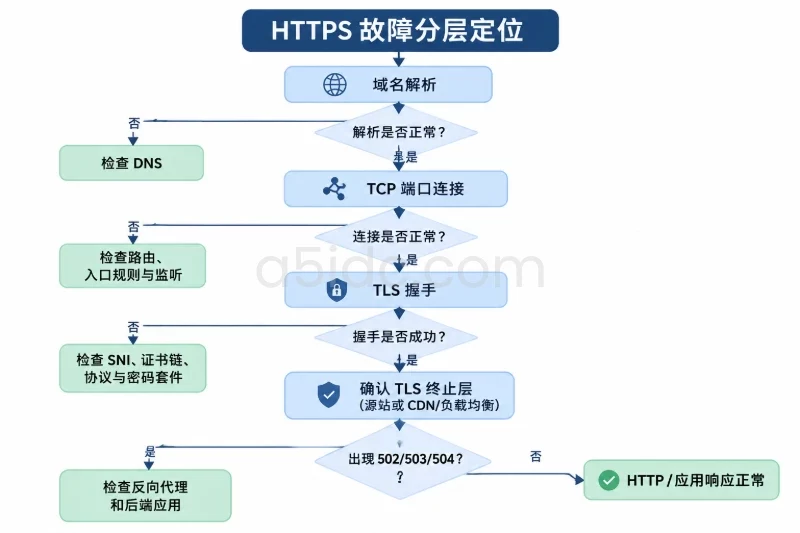
如果是HTTPS管理入口,可以使用:
curl -vk --connect-timeout 10 https://server.example.com/
若需要区分域名解析与服务器实际地址,可以在确认目标IP属于自身服务器的前提下使用:
curl -vk --resolve server.example.com:443:203.0.113.10 https://server.example.com/
上面的203.0.113.10是文档示例地址,不代表实际服务器。--resolve只适合用于核对指定IP上的TLS和虚拟主机行为,不能据此绕过平台安全策略。
Windows客户端可以使用:
Resolve-DnsName server.example.com
Test-NetConnection server.example.com -Port 22
Test-NetConnection server.example.com -Port 443
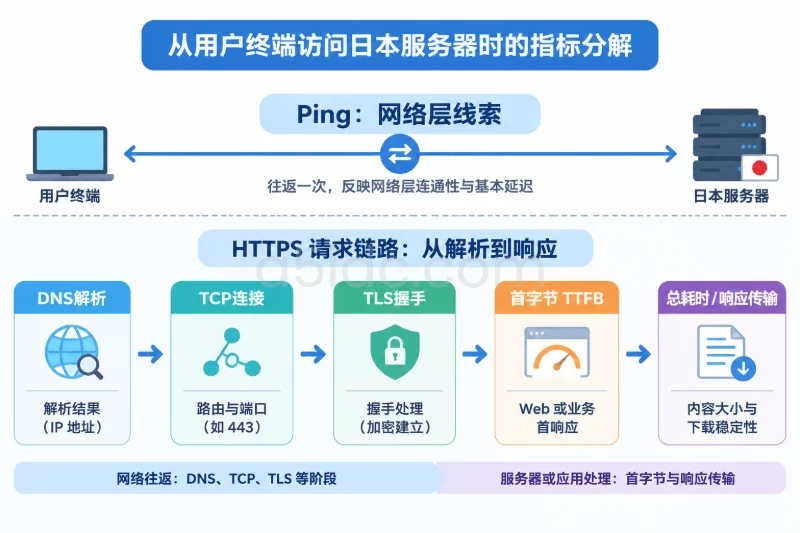
ping只能说明ICMP是否有回应,不能代替TCP端口测试。很多云服务器会限制ICMP,即使SSH或HTTPS正常,ping也可能超时。
将问题拆成四层后,每层都有对应的观察证据:
| 层级 | 核心问题 | 主要证据 |
|---|---|---|
| 网络路径 | 请求是否到达美国服务器或入口设备 | DNS结果、TCP测试、路由、服务器抓包 |
| 访问控制 | 安全组、ACL和主机防火墙是否允许来源访问 | 云平台规则、NAT策略、OS防火墙规则 |
| 端口与服务 | 目标端口是否监听,监听地址是否正确 | ss、服务状态、进程日志 |
| 认证与应用 | TCP建立后,账号、密钥、权限或应用会话是否失败 | SSH/RDP/应用认证日志 |
判断时应遵循一个重要边界:没有建立TCP连接,就不要先分析密码和密钥;没有确认监听状态,就不要先修改认证配置。
域名可能同时存在A记录和AAAA记录。部分客户端优先使用IPv6,如果AAAA记录指向了没有配置服务的地址,可能表现为“有些网络能访问,有些网络不能访问”。
检查时分别记录:
如果直接访问IPv4地址正常,而域名访问失败,优先检查DNS和IPv6,不要先重启应用。如果IPv4和IPv6的监听状态不一致,也会出现类似现象,例如服务只监听IPv4,而AAAA记录让客户端走IPv6。
云平台通常至少存在一层平台侧访问控制,可能称为安全组、入站规则、网络ACL或边界防火墙。检查时应逐项确认:
如果只允许固定办公出口IP,先通过浏览器或其他方式确认当前出口地址:
curl -4 https://ifconfig.me
curl -6 https://ifconfig.me
这两个地址仅用于查看客户端出口,具体可用性取决于网络环境。不要把临时变化的家庭宽带IP长期写入生产白名单,也不要为了验证问题直接开放0.0.0.0/0。应使用必要的来源范围,并在测试结束后撤销临时规则。
平台侧规则允许连接,不代表服务器一定会接受。云安全组、网络ACL、主机防火墙和应用自身的访问控制可能同时存在,任何一层拒绝都可能造成登录失败。
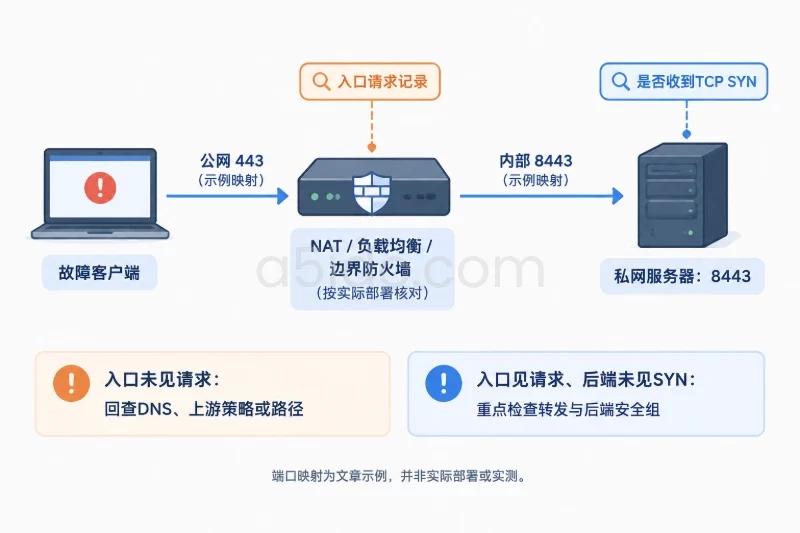
如果服务器使用私有地址,公网IP可能属于NAT网关、负载均衡器或边界防火墙。这时要确认:
例如公网443转发到内部8443时,服务器上的监听可能是8443,而不是443。直接在服务器上检查443没有监听,并不能说明公网入口一定有问题;需要同时检查入口设备的映射关系。
如果服务器侧抓不到来自客户端的TCP SYN,而平台入口日志也没有对应请求,问题通常在DNS、上游安全策略、NAT或路由层。如果入口设备能看到请求,但后端实例没有收到,则应重点检查转发和后端安全组。
确认服务器可以通过云控制台、串口或带外管理方式访问后,再进行本机检查。不要为了排查SSH而先关闭防火墙或重启网络服务,因为错误操作可能让现有会话也中断。
Linux服务器可以使用:
sudo ss -lntp
检查指定端口:
sudo ss -lntp | grep -E ':(22|443|3389)\b'
sudo lsof -nP -iTCP:22 -sTCP:LISTEN
示例结果:
LISTEN 0 128 0.0.0.0:22    0.0.0.0:*    users:(("sshd",pid=812,fd=3))
LISTEN 0 128 127.0.0.1:8080 0.0.0.0:*  users:(("app",pid=1460,fd=9))
两行的含义不同:
0.0.0.0:22表示服务监听所有IPv4地址,外部访问具备基础条件。127.0.0.1:8080表示服务只接受本机连接,公网或其他服务器无法直接连接。[::]:443通常表示监听IPv6地址,是否同时接受IPv4取决于系统参数和应用配置。如果应用只绑定到127.0.0.1,而外部访问需要通过Nginx反向代理,那么这可能是正确设计;此时应检查Nginx是否监听公网端口,以及Nginx到后端的连接是否正常,不能简单地把应用改成公网监听。
不同发行版的服务名可能不同。常见检查方式如下:
sudo systemctl status ssh --no-pager
sudo systemctl status sshd --no-pager
sudo journalctl -u ssh --since "30 minutes ago" --no-pager
sudo journalctl -u sshd --since "30 minutes ago" --no-pager
如果不确定服务名,可以先查询:
systemctl list-unit-files | grep -E 'ssh|sshd'
对于SSH配置,修改前应先备份,并只执行语法检查:
sudo cp -a /etc/ssh/sshd_config /etc/ssh/sshd_config.bak.$(date +%Y%m%d%H%M%S)
sudo sshd -t
sudo sshd -T | egrep '^(port|listenaddress|passwordauthentication|pubkeyauthentication|permitrootlogin)'
sshd -t只检查配置语法,不会自动修复问题。确认新配置能够通过语法检查后,也应保留当前会话并使用第二个会话验证。直接重启SSH服务前,要确认控制台或带外通道可用,因为错误的监听地址、端口或认证配置可能导致远程连接全部中断。
如果服务运行在Docker容器中,宿主机监听状态和容器内部监听状态可能不同:
docker ps
docker port <container_name_or_id>
docker inspect <container_name_or_id> --format '{{json .NetworkSettings.Ports}}'
常见差异包括:
127.0.0.1。如需调整Docker映射或编排配置,应先保存当前Compose文件和容器参数,确认变更会影响哪些服务,再执行重建或重启。生产环境不建议在没有回滚文件和控制台通道的情况下直接修改端口发布。
Ubuntu或Debian常见UFW检查:
sudo ufw status verbose
使用firewalld的系统可以查看:
sudo firewall-cmd --state
sudo firewall-cmd --list-all
sudo firewall-cmd --get-active-zones
使用nftables的系统可以查看当前规则集:
sudo nft list ruleset
不要根据发行版名称猜测防火墙一定使用哪种工具。先查看服务状态和当前规则,再判断实际生效的组件。某些系统同时安装了多个工具,但只有其中一个服务正在加载规则。
需要重点检查:
防火墙调整属于高影响操作。执行前至少完成以下准备:
例如,下面是UFW的示例写法,地址和端口仅为示例,不能直接照搬:
# 示例:仅允许指定来源网段访问TCP 22
sudo ufw allow from 203.0.113.0/24 to any port 22 proto tcp

# 示例回滚:删除完全匹配的临时规则
sudo ufw delete allow from 203.0.113.0/24 to any port 22 proto tcp
执行这类命令前,必须确认系统确实使用UFW,并将示例网段替换为实际、受控的管理出口。若平台安全组仍未放行,单独修改UFW不会解决公网连接问题;反过来,安全组放行而UFW拒绝,也同样无法登录。
在已经确认授权并且只做短时间采集的情况下,可以观察目标端口是否收到连接请求:
sudo timeout 30 tcpdump -ni any 'tcp port 22'
示例中的地址和报文仅用于解释:
IP 198.51.100.24.52100 > 10.0.0.8.22: Flags [S], seq 1001
IP 10.0.0.8.22 > 198.51.100.24.52100: Flags [S.], seq 3001, ack 1002
判断方向如下:
抓包可能包含账号、请求路径或其他敏感元数据,应限制持续时间、过滤端口,并妥善处理输出文件。不要将完整抓包直接上传到公开工单或聊天群。
Debian、Ubuntu通常使用:
sudo journalctl -u ssh --since "30 minutes ago" --no-pager
sudo tail -n 100 /var/log/auth.log
RHEL、CentOS及部分其他发行版常见位置是:
sudo journalctl -u sshd --since "30 minutes ago" --no-pager
sudo tail -n 100 /var/log/secure
示例日志及其含义:
Failed password for invalid user admin from 198.51.100.24 port 52100 ssh2
说明请求已经到达SSH服务,并且进入了密码认证流程,网络、端口监听和基础协议协商大概率正常。需要检查用户名、密码、账号策略和来源限制。
Accepted publickey for deploy from 198.51.100.24 port 52110 ssh2
说明该次密钥认证成功。若客户端仍然显示失败,应查看登录后的Shell、权限、目录、跳板配置或客户端使用的并非同一账号。
Connection closed by authenticating user deploy 198.51.100.24 port 52120 [preauth]
说明连接在认证完成前关闭,可能与密钥协商、客户端主动退出、认证策略、连接限制或安全软件有关,不能直接认定为密码错误。
如果客户端明确显示连接超时,而对应时间段完全没有SSH日志,优先回到网络、平台规则和端口监听层排查。认证日志没有记录,通常意味着请求尚未到达SSH服务,或被更前面的设备丢弃。
在确认TCP连接正常后,再核对以下项目:
authorized_keys中的公钥对应。AllowUsers、AllowGroups、DenyUsers等规则是否匹配。可以使用只读命令查看账号状态:
id deploy
sudo passwd -S deploy
sudo chage -l deploy
timedatectl status
如果系统安装了Fail2ban,可查看对应监狱状态:
sudo fail2ban-client status
sudo fail2ban-client status sshd
命令输出中的用户名、来源IP和策略信息可能属于敏感数据。对外提交日志时,应遮盖公网IP、用户名、主机名和密钥指纹,但保留时间、错误类型和端口信息。
如果登录方式是Windows远程桌面,客户端能到达3389并不代表身份认证一定成功。可以在Windows服务器上检查监听状态:
Get-NetTCPConnection -LocalPort 3389 -State Listen
Windows事件查看器中的“Windows日志”下,重点关注“安全”和“系统”日志,并结合登录失败时间、来源地址和事件ID判断是网络层拒绝、账号锁定还是凭据错误。
对于Web管理后台,应分别查看:
如果Nginx访问日志中完全没有请求,而应用日志也没有记录,问题应继续向公网入口、监听端口和反向代理层追溯。若Nginx有401或403,说明请求已经到达应用入口,重点转向账号、权限、来源策略或会话配置。
将外部测试、本机监听和日志结果放在一起,通常可以快速缩小范围:
| 外部TCP测试 | 本机监听 | 认证或应用日志 | 更可能的根因 |
|---|---|---|---|
| 超时 | 有监听 | 无记录 | 安全组、ACL、NAT、主机防火墙或返回路径 |
| 超时 | 无监听 | 无记录 | 服务停止、端口配置错误,同时也需检查上游策略 |
| 拒绝 | 无监听 | 无记录 | 端口没有服务监听,或设备主动拒绝 |
| 正常 | 有监听 | 有认证失败 | 用户名、密码、密钥、账号状态或认证策略 |
| 正常 | 有监听 | 有应用错误 | 应用配置、数据库、会话、TLS或后端依赖 |
| IP正常、域名失败 | 有监听 | 直接访问有记录 | DNS、AAAA记录、虚拟主机或证书名称 |
| 本机访问正常、外部失败 | 仅回环监听或外部端口被拦截 | 本机有记录 | 监听地址、防火墙、安全组或NAT |
| 只有一个来源失败 | 有监听 | 该来源无记录或被拒绝 | 来源白名单、封禁、IPv6或特定链路 |
例如,curl localhost:8080正常,只能说明应用在本机8080提供服务,不能证明公网访问条件成立。还需要确认公网端口是否转发到8080、Nginx是否监听外部地址、主机防火墙是否放行,以及安全组是否允许来源访问。
再如,SSH客户端出现密码错误并且服务器日志记录了Failed password,就不应继续排查NAT。此时网络链路已经走通,应检查账号、密码、认证方式或登录限制。
定位后不要一次修改多层配置。建议按照以下顺序处理:
成功验证至少应包含三个层面:
如果刚刚修改过SSH端口、监听地址或防火墙规则,必须在现有会话保持可用时打开第二个会话验证。确认第二个会话成功后,再关闭旧会话,避免单一连接成为唯一恢复手段。
为减少美国服务器登录故障的定位时间,可以建立以下监控点:
preauth事件设置告警。当下一次出现“无法登录”时,先看外部TCP探测是否失败,再对照服务器是否收到连接,最后查看认证日志。按照这条证据链,可以较快判断故障究竟发生在公网入口、端口策略、主机服务,还是账号认证阶段。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5857.html