香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


节点变为 NotReady 后,最直接的影响是它不再适合承接新的普通工作负载;节点上已有的 Pod 也可能因故障类型不同而出现通信中断、探针失败或状态迟迟不更新。排查时不要只看 kubelet 是否在运行:NotReady 可能表示节点持续上报“自身未就绪”,也可能表示控制平面已经收不到节点心跳。
有效的排查顺序是先确认状态和影响范围,再区分心跳链路、容器运行时与 CNI、节点资源三个分支。每一步都应同时回答两个问题:观察到了什么,以及这个结果能排除什么。只有证据指向具体配置时,才修改配置并验证恢复。
在 Kubernetes 集群的节点承载与资源规划场景中,A5数据提供中国香港、美国、日本、韩国、中国台湾、新加坡、马来西亚等地区的物理服务器租用资源,覆盖 Xeon Gold、AMD EPYC、GPU、NVMe 与大容量存储、多 IP 及不同带宽线路方案,可为容器运行时、数据库、接口服务和多任务计算提供相应的 CPU、内存、磁盘与网络基础,便于结合业务访问区域和负载特点构建节点资源池。
在能访问集群的管理终端执行以下命令,将示例节点名替换为实际名称:
NODE='worker-01'
kubectl get nodes -o wide
kubectl describe node "$NODE"
kubectl get pods -A --field-selector spec.nodeName="$NODE" -o wide
重点看 kubectl describe node 中的 Conditions、LastHeartbeatTime、LastTransitionTime、Reason 和 Message。同时记录节点开始异常的时间,后续查看日志时才有明确窗口。
Ready=False,且心跳时间持续更新:通常说明 kubelet仍能向控制平面汇报,但它认为节点不满足就绪条件。优先检查 kubelet 日志、容器运行时、CNI 和资源状态。Ready=Unknown,心跳长时间不更新:优先检查 kubelet 是否存活,以及节点到 API Server 的网络、DNS、证书和认证链路。此时不能仅凭 NotReady 推断 CNI 故障。MemoryPressure、DiskPressure 或 PIDPressure 为 True:相应资源分支需要优先处理,但仍应核对 kubelet 日志,确认它是否同时存在其他错误。还要观察影响范围:仅一台节点异常,更值得检查该节点的主机网络、磁盘、运行时和本地配置;同一网络区域的多台节点同时异常,应先检查它们共用的网络路径或 API Server 入口。kubectl 能从管理终端访问集群,只能证明管理终端的访问正常,不能证明故障节点也能访问。
如果节点反复在 Ready 与 NotReady 间切换,先保存事件、日志和配置,不要马上重启服务。重启可能暂时清除症状,却使配置冲突或资源耗尽的证据更难定位。
可以把一次 NotReady 排查拆成四层:
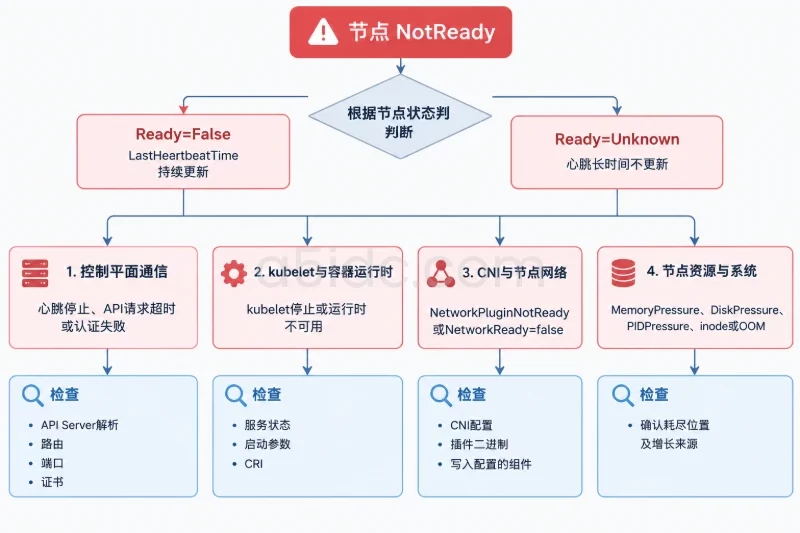
| 分支 | 优先观察的证据 | 下一步 |
|---|---|---|
| 控制平面通信 | Ready=Unknown、心跳停止、kubelet 日志提示 API 请求超时或认证失败 | 在故障节点检查 API Server 地址解析、路由、端口及证书相关错误 |
| kubelet 与容器运行时 | kubelet 停止、反复退出,或日志提示运行时不可用 | 检查服务状态、实际启动参数、运行时状态和配置 |
| CNI 与节点网络 | kubelet 持续上报 NetworkPluginNotReady,运行时报告 NetworkReady=false | 对照 CNI 配置文件、插件二进制和负责写入配置的组件 |
| 节点资源与系统 | 磁盘、inode、内存、进程数压力,文件系统错误或 OOM 记录 | 确认耗尽位置和增长来源,再决定清理或扩容 |
这不是按表格顺序把所有服务重启一遍。比如,API Server 请求已经因证书错误失败时,修改 CNI 配置不会修复心跳;运行时明确报告 CNI 未初始化时,也不应仅凭 CPU 使用率偏高就归因于资源不足。
排查期间如需防止新工作负载进入故障节点,可以在确认业务影响和操作权限后执行 kubectl cordon "$NODE"。这不会主动停止已有 Pod;节点恢复且完成验证后,再执行 kubectl uncordon "$NODE"。若节点已长期 NotReady,仍应按业务实际影响决定是否需要这一步。
先登录故障节点,确认主机时间、kubelet 状态和故障时间段日志。以下命令适用于使用 systemd 管理 kubelet 的节点:
sudo systemctl status kubelet --no-pager
sudo journalctl -u kubelet --since '30 minutes ago' --no-pager
timedatectl
服务处于 active 并不代表上报成功。日志里的信息要按错误类型分流:
connection refused、i/o timeout 或 DNS 解析失败:检查 kubelet 实际连接的 API Server 地址,以及从该节点出发的主机网络路径。x509、证书过期或认证失败:检查节点时间、kubelet 使用的 kubeconfig、证书及集群侧认证状态;不要用跳过证书校验的方式掩盖问题。在常见的 kubeadm 部署中,可以读取 kubelet kubeconfig 中配置的服务端地址;非 kubeadm 环境应以实际启动参数和部署配置为准:
sudo kubectl config view \
  --kubeconfig=/etc/kubernetes/kubelet.conf \
  --minify \
  -o jsonpath='{.clusters[0].cluster.server}{"\n"}'
sudo systemctl cat kubelet
随后在故障节点检查该地址对应的解析、路由和 TCP 连通性。例如,API Server 地址为域名时,先用 getent ahosts 看解析结果;地址和端口确定后,再检查路由及端口:
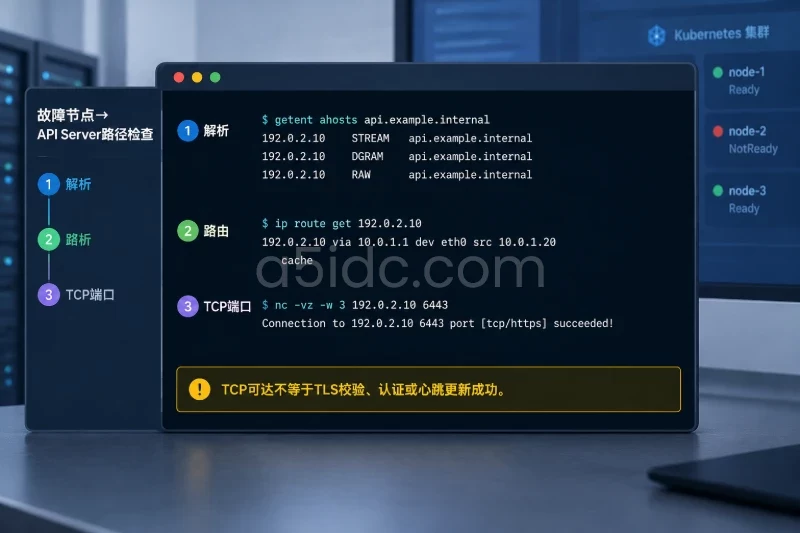
getent ahosts api.example.internal
ip route get 192.0.2.10
nc -vz -w 3 192.0.2.10 6443
这里的域名、IP 和端口仅为示例,必须换成节点实际使用的端点。TCP 端口可达只说明基础连接可建立,不能证明 TLS 校验、认证或节点状态更新成功;应继续结合 kubelet 日志判断。若多台节点同时无法连接同一端点,优先检查共用入口;若仅单节点失败,再检查其路由、主机防火墙和所在网络。调整防火墙规则前,应保存现有规则、明确影响范围,并准备恢复方法。
当 Ready=False 且心跳仍更新时,重点查看 Ready 条件的 Message 和 kubelet 日志。类似下面的内容仅用于演示判断方式,并非对具体环境的检查结果:
Ready=False
Reason=KubeletNotReady
Message=container runtime network not ready:
NetworkReady=false reason:NetworkPluginNotReady
它指向“运行时报告网络未就绪”,但还不能直接得出“宿主机到 API Server 的网络断了”。Kubernetes 节点上至少有两条需要分开的路径:宿主机访问控制平面的路径,以及运行时和 CNI 为 Pod 建立网络的路径。前者正常时,后者仍可能因配置文件或插件错误而使节点 NotReady。
先确认 kubelet连接的是哪个容器运行时,以及该运行时本身的状态。下面以 containerd 为例;如果实际使用其他运行时,应使用相应的服务名和端点,不要照搬路径:
sudo systemctl status containerd --no-pager
sudo journalctl -u containerd --since '30 minutes ago' --no-pager
sudo crictl --runtime-endpoint unix:///run/containerd/containerd.sock info
若 socket 路径不存在,先从 kubelet 实际启动参数或本机运行时配置核实 CRI 端点。crictl info 中若显示运行时不可用,先处理运行时服务和 CRI 连接;若运行时可用、但网络状态未就绪,再进入 CNI 分支。
一种容易遗漏的情况是:更换或重新部署 CNI 后,新配置已经写入 /etc/cni/net.d/,旧配置却没有移走。节点上因此同时存在 05-old.conflist 和 10-current.conflist。不能只凭文件名前缀判定哪个文件正在生效;应核对运行时实际使用的 CNI 配置目录、读取到的配置及错误日志。若日志明确指向旧配置中的网络名称或缺失的插件,再将其作为根因候选。
在节点上检查:
sudo ls -la /etc/cni/net.d/
sudo find /etc/cni/net.d/ -maxdepth 1 -type f -print
sudo ls -la /opt/cni/bin/
sudo journalctl -u kubelet --since '30 minutes ago' --no-pager
这些是常见路径,并非所有发行版和部署方式都相同。还应核对运行时配置、CNI 组件的部署参数,确定其配置目录与插件目录。若日志类似“找不到旧配置引用的插件”,而当前 CNI 组件写入的新配置及其插件文件均存在,就形成了较完整的证据链:
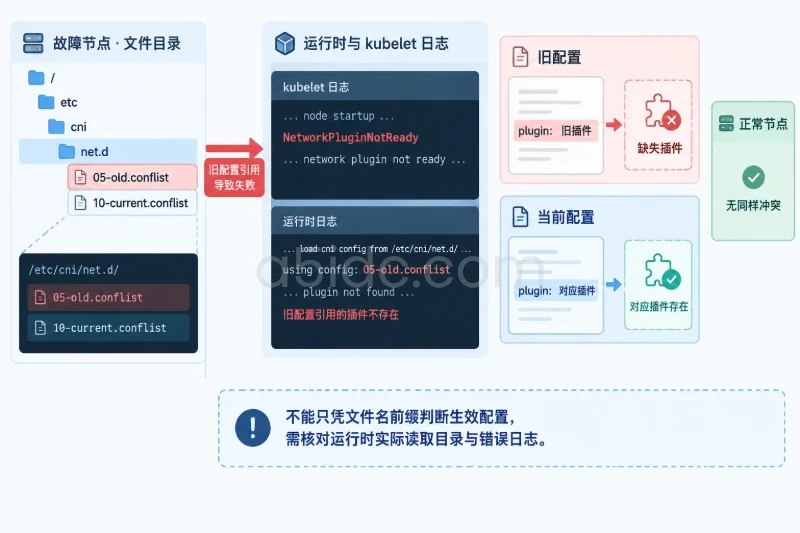
在确认旧文件不再由当前 CNI 组件使用、并确认其不会被部署组件重新写回后,才能变更。移动文件前,备份整个配置目录并安排维护窗口;CNI 变更可能影响新 Pod 建网,运行时重载或重启还可能扩大影响范围。以下仅演示针对已确认无效的单个旧文件的处理方式:
BACKUP_DIR="/root/cni-recovery-$(date +%Y%m%d%H%M%S)"
sudo mkdir -m 700 "$BACKUP_DIR"
sudo cp -a /etc/cni/net.d/. "$BACKUP_DIR/"
sudo mv /etc/cni/net.d/05-old.conflist \
  "$BACKUP_DIR/05-old.conflist.disabled"
变更后观察 crictl info、kubelet日志和节点 Ready 条件。如果运行时仍持有旧配置,应先核对该版本运行时的加载方式,再评估是否需要在维护窗口重启运行时;不要把重启 containerd 和 kubelet 当作固定步骤。若判断错误,可从备份目录恢复原文件,并按该运行时的加载方式使配置重新生效。同时修正产生旧文件的部署配置,否则手工移走后仍可能复发。
即使日志出现网络相关错误,也要检查资源是否导致 CNI 组件、运行时或 kubelet 无法正常工作。特别要区分磁盘容量与 inode:容量尚有剩余,并不代表还能创建文件。
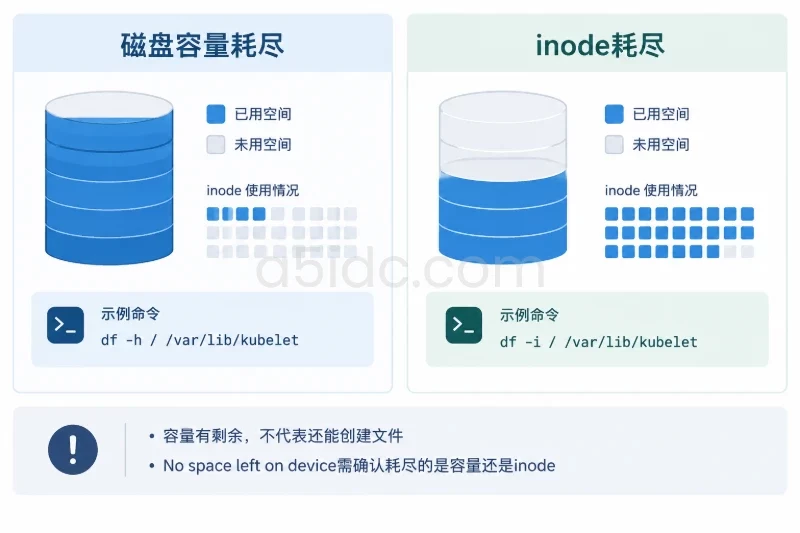
df -h / /var/lib/kubelet
df -i / /var/lib/kubelet
free -h
sudo journalctl -k --since '30 minutes ago' --no-pager
容器运行时数据目录因部署而异,确认实际路径后再检查其磁盘使用情况。重点寻找 No space left on device、OOM、文件系统只读或 I/O 错误,并与异常开始时间对应。若 DiskPressure=True,要找到占用来源,再按业务和运行时的清理规范处理;不要直接删除 /var/lib/kubelet 或运行时数据目录。若看到 OOM,也要确认被终止的是哪个进程,不能将任何内存波动都视为 NotReady 根因。
资源、服务和网络问题还可能相互叠加:例如磁盘写满使 CNI 无法写入配置,同时 kubelet仍可上报状态。这时只移动旧配置文件不会完成修复,必须让资源状态及相关组件一并恢复。
Ready,还要确认故障链条已闭合修复后,在控制平面和故障节点两侧交叉验证:
NODE='worker-01'
kubectl get node "$NODE" -o wide
kubectl describe node "$NODE"
kubectl get pods -A --field-selector spec.nodeName="$NODE" -o wide
成功标准不只是某一瞬间显示 Ready。还应确认心跳持续更新、原有错误不再重复、容器运行时与网络状态恢复,以及该节点上的 CNI 组件和业务 Pod 状态符合预期。如果故障涉及 CNI,新建 Pod 能否完成网络初始化,比仅查看已有 Pod 的 Running 状态更有说明力。此前若执行了 cordon,应在这些检查通过后再 uncordon。
为降低复发风险,持续监控节点 Ready 状态及切换频率、心跳中断、kubelet和运行时重启次数、CNI 未就绪报错、磁盘容量与 inode、内存压力,并在 CNI 升级或切换后核对各节点配置目录是否仍有残留文件。这样下次出现 NotReady 时,才能迅速判断是通信中断、配置冲突,还是资源问题,而不是再次从重启服务开始。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5845.html