香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


同一个 Kubernetes 集群里,部分 Pod 解析失败而其他 Pod 正常,通常先看 Pod 的 DNS 配置;所有 Pod 都无法访问 CoreDNS 服务,则应转向集群网络和 Service 路径;集群内的 Service 名称可以解析,但外部域名失败,重点往往在 CoreDNS 的 forward 配置或上游 DNS。仅凭“域名解析失败”这一现象,不能直接判定是 CoreDNS 宕机。
排查的关键是把一次解析拆成三段:Pod 是否把请求发给了正确的 DNS 地址,集群网络是否能把请求送到 CoreDNS,CoreDNS 能否继续访问可用的上游 DNS。下面按影响范围和请求路径逐层缩小范围。
A5数据面向需要承载 Kubernetes 集群、业务后台和接口服务的场景,提供中国香港、美国、日本、韩国、中国台湾、新加坡及马来西亚等地区的物理服务器,配备不同 CPU、内存、NVMe/SSD、带宽与线路方案。多地区资源可用于跨区域业务部署,AMD EPYC、Xeon Gold 及多IP等产品也能为容器节点、数据库和网络服务提供相应的硬件与网络基础。
先从发生故障的 Pod 中测试一个集群内的完整域名和一个外部域名。集群内的测试可以使用 Kubernetes API Service:
kubectl exec -n <namespace> <pod-name> -- \
  nslookup kubernetes.default.svc.cluster.local.
如果容器没有 nslookup,可以进入已经安装 dig 的诊断 Pod,或者使用应用镜像中已有的 DNS 工具:
kubectl exec -n <namespace> <pod-name> -- \
  dig +time=2 +tries=1 kubernetes.default.svc.cluster.local. A

kubectl exec -n <namespace> <pod-name> -- \
  dig +time=2 +tries=1 example.com. A
example.com. 只是示例,生产环境应优先使用企业允许访问、且已知有稳定记录的外部域名。域名末尾的点表示绝对域名,可以避免 search 搜索域造成额外干扰。
不同结果对应的方向不同:
| 现象 | 更应优先检查的位置 | 说明 |
|---|---|---|
timeout、no servers could be reached | Pod 到 CoreDNS 的网络路径、Service、Endpoint、NetworkPolicy | DNS 请求可能没有到达监听端口 |
connection refused | CoreDNS Pod 未监听、目标地址错误、端口映射异常 | 与纯超时相比,更接近目标端口不可用 |
内部域名返回 NXDOMAIN | Service 名称、命名空间、集群域名、CoreDNS kubernetes 配置 | DNS 服务器已响应,但认为记录不存在 |
外部域名返回 SERVFAIL | CoreDNS forward、上游 DNS、DNSSEC 或上游网络 | CoreDNS 收到请求,但没有得到有效结果 |
| 内部域名正常,外部域名超时 | 上游 DNS 地址和出站 UDP/TCP 53 | CoreDNS 的 Kubernetes 插件本身可能正常 |
| 只有一个 Pod 或一个命名空间失败 | Pod dnsPolicy、dnsConfig、网络策略或应用自身 | 不宜先重启整个 CoreDNS |
还要记录影响范围:是单个 Pod、同一节点上的 Pod、某个命名空间,还是整个集群。可以用一个已知正常的 Pod 做对照。若两个 Pod 的 /etc/resolv.conf 不一致,问题很可能发生在 Pod 配置层;如果一致但结果不同,再检查网络策略、节点和应用运行环境。
Kubernetes 中 CoreDNS 的 Service 名称通常是 kube-dns,名称并不代表后端一定运行着传统的 kube-dns。先确认实际 Service:
kubectl -n kube-system get svc
kubectl -n kube-system get svc kube-dns -o wide
kubectl -n kube-system get endpointslice \
  -l kubernetes.io/service-name=kube-dns -o wide
记录 kube-dns 的 CLUSTER-IP,后续把它记作 <cluster-dns-ip>。再查看 CoreDNS Pod:
kubectl -n kube-system get pods \
  -l k8s-app=kube-dns -o wide

kubectl -n kube-system get deploy coredns -o wide
不同发行版的标签可能不同。如果没有返回结果,应先查看 Deployment 的实际标签和 Pod 的 app、k8s-app 标签,而不是据此认定 CoreDNS 不存在。
可以把故障分为四个层次:
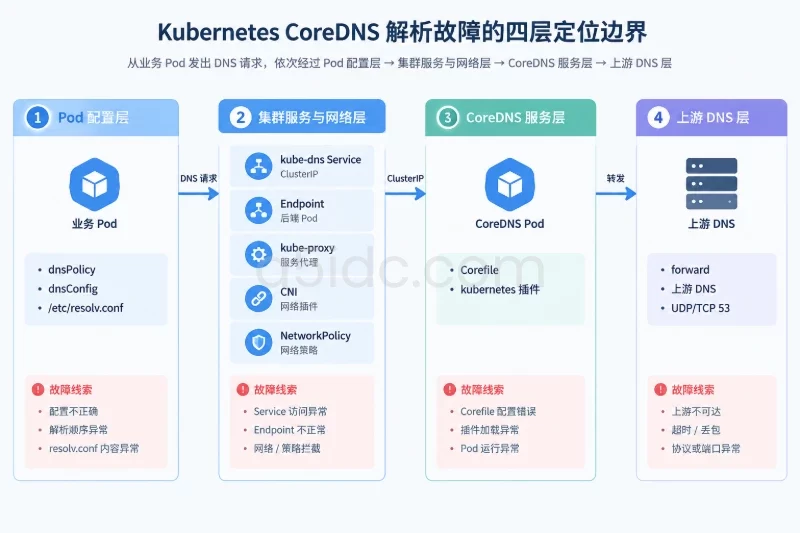
dnsConfig 与集群设置冲突。这个顺序是由外到内、由低风险到高风险。先读取现状,再考虑修改配置;不要一看到解析失败就直接重启 CoreDNS 或修改节点 DNS。
先看 Pod 声明的策略和容器内实际生效的文件:
kubectl get pod -n <namespace> <pod-name> \
  -o jsonpath='{.spec.dnsPolicy}{"\n"}{.spec.hostNetwork}{"\n"}{.spec.dnsConfig}{"\n"}'

kubectl exec -n <namespace> <pod-name> -- cat /etc/resolv.conf
正常使用集群 DNS 的普通 Pod,常见结果类似:
nameserver 10.96.0.10
search app.svc.cluster.local svc.cluster.local cluster.local
options ndots:5
其中 10.96.0.10 只是示例,实际值必须与 kube-dns Service 的 ClusterIP 一致。需要重点检查以下情况:
dnsPolicy: Default:Pod 通常继承节点的解析配置,不一定使用 CoreDNS。dnsPolicy: None:必须配合 dnsConfig,否则是有意绕过集群默认 DNS。hostNetwork: true 但没有使用 ClusterFirstWithHostNet:Pod 可能回退到节点 DNS 行为。dnsConfig.nameservers 指向企业外部 DNS或错误地址,导致集群内部域名无法解析。search 缺少 <namespace>.svc.cluster.local、svc.cluster.local 或集群域名,短名称解析可能失败。options ndots 较高导致外部短域名先尝试多个集群搜索后缀,表现为延迟增加;这通常是性能问题,不等同于 CoreDNS 故障。/etc/resolv.conf 是判断 Pod 实际行为的依据,不能只看 Deployment 模板或 Helm values。修改了 dnsPolicy、dnsConfig 或 hostNetwork 后,通常需要让 Pod 重新创建,旧 Pod 不会自动变成新配置。
例如,某个应用 Deployment 设置了:
spec:
  template:
    spec:
      dnsPolicy: Default
节点上的 DNS 可以解析公网域名,但不能解析 orders.prod.svc.cluster.local。这时其他普通 Pod 可能完全正常,只有该应用异常。根因不是 CoreDNS 全局不可用,而是该 Pod 根本没有把请求送到集群 DNS。
普通 Pod 通常应使用:
spec:
  template:
    spec:
      dnsPolicy: ClusterFirst
使用 hostNetwork: true 的 Pod,则应根据集群要求明确设置:
spec:
  template:
    spec:
      hostNetwork: true
      dnsPolicy: ClusterFirstWithHostNet
如果业务确实需要 dnsPolicy: None,应在 dnsConfig.nameservers 中明确加入可访问的 DNS 地址,并验证其是否能够解析集群内部域名。不要为了临时解决外部域名问题,直接删除集群 DNS 地址。
修改工作负载前,先保存当前清单或使用版本控制记录变更。发布后检查:
kubectl -n <namespace> rollout status deploy/<deployment-name>
kubectl exec -n <namespace> <new-pod-name> -- cat /etc/resolv.conf
如果修改造成回退需求,可以使用工作负载自身的版本回滚机制;但回滚 Deployment 不会自动恢复被单独修改的 CoreDNS ConfigMap,两者应分别管理。
在能够运行 dig 的诊断 Pod 中,分别查询 CoreDNS Service IP 和某个 CoreDNS Pod IP:
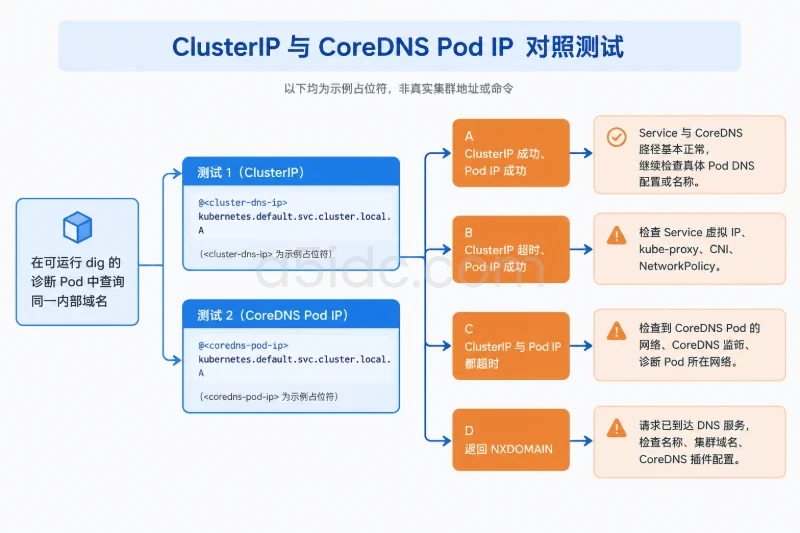
dig +time=2 +tries=1 @<cluster-dns-ip> \
  kubernetes.default.svc.cluster.local. A

dig +time=2 +tries=1 @<coredns-pod-ip> \
  kubernetes.default.svc.cluster.local. A
这两个测试的意义不同:
查询 CoreDNS Pod IP 前,确认它们处于 Running 且 Ready:
kubectl -n kube-system get pod -o wide
kubectl -n kube-system describe pod <coredns-pod-name>
DNS 查询通常优先使用 UDP,但响应过大、DNSSEC 或特定客户端场景可能转为 TCP。因此 NetworkPolicy、防火墙和安全组不能只放行 UDP 53。
dig +time=2 +tries=1 @<cluster-dns-ip> \
  kubernetes.default.svc.cluster.local. A

dig +tcp +time=2 +tries=1 @<cluster-dns-ip> \
  kubernetes.default.svc.cluster.local. A
如果 UDP 失败而 TCP 成功,应重点查看 UDP 53 的策略、MTU、分片处理和 conntrack;如果 TCP 也失败,则继续检查 Service、Endpoint 或整体路径。
列出可能影响 DNS 的 NetworkPolicy 和系统组件:
kubectl get networkpolicy -A

kubectl -n kube-system get pods -o wide
kubectl -n kube-system get pods -l k8s-app=kube-proxy
CNI 和 kube-proxy 的具体排查命令取决于发行版及实现,不宜在未知环境中直接执行重启或清理规则。对比同节点正常 Pod 和异常 Pod 的结果,通常比全局重启更容易定位问题。
先查看 ConfigMap,而不是直接编辑:
kubectl -n kube-system get cm coredns -o yaml
kubectl -n kube-system get cm coredns \
  -o jsonpath='{.data.Corefile}{"\n"}'
要核对三个位置是否一致:
kube-system。coredns。volumeMounts 是否挂载了这个 ConfigMap。kubectl -n kube-system get deploy coredns -o yaml
部分集群使用其他名称或由 Operator 管理配置。如果只修改了一个未被 Deployment 引用的 ConfigMap,配置自然不会生效。
再从实际 CoreDNS 容器中读取挂载后的文件。常见路径是 /etc/coredns/Corefile,但应以 Deployment 的 volumeMounts 为准:
kubectl -n kube-system exec <coredns-pod-name> \
  -- cat /etc/coredns/Corefile
如果 ConfigMap 内容和容器内文件不同,说明挂载、更新或控制器同步存在问题;如果两者一致但行为未变,再检查配置逻辑和 CoreDNS 是否已重新加载。
kubernetes 和 forward 的职责边界常见 Corefile 结构大致如下,具体插件和参数必须匹配实际集群:
.:53 {
    errors
    health
    ready

    kubernetes cluster.local in-addr.arpa ip6.arpa {
        pods insecure
        fallthrough in-addr.arpa ip6.arpa
    }

    prometheus :9153
    forward . /etc/resolv.conf
    cache 30
    loop
    reload
    loadbalance
}
这里有两个重要边界:
kubernetes 插件负责集群 Service、Pod 和反向区域的记录。forward 负责把未由集群区域处理的请求转发给上游 DNS。如果集群实际域名不是 cluster.local,但 Corefile 仍然配置为 kubernetes cluster.local,内部域名可能返回 NXDOMAIN。应同时核对 kubelet 的 clusterDNS、集群初始化参数和 Corefile 中的集群域名。
如果存在多个重叠的 server block、rewrite、hosts、template 或针对根区域的 forward,请求可能进入与预期不同的处理路径。不要只按 Corefile 中的文字顺序猜测插件执行效果,必须结合实际 CoreDNS 版本和插件链判断。
查看 CoreDNS 日志:
kubectl -n kube-system logs <coredns-pod-name> \
  --since=15m --timestamps
可关注以下类型:
i/o timeout:上游 DNS 或网络路径超时。connection refused:目标 DNS 端口没有服务或被拒绝。plugin/errors:插件处理失败,需要结合查询区域判断。CrashLoopBackOff:不要继续反复修改配置,应先保留日志并恢复上一个可用版本。修改 Corefile 前应先备份并检查变更内容。更新 ConfigMap 后,带有 reload 插件的 CoreDNS 可能会自动加载;如果没有生效,需在确认副本数、PodDisruptionBudget 和容量余量后再考虑滚动重启。滚动重启会影响 DNS 处理能力,不能把它当作无影响操作。
forward 实际指向如果内部 Service 名称正常,只有外部域名失败,先看 CoreDNS 容器内的解析文件:
kubectl -n kube-system exec <coredns-pod-name> \
  -- cat /etc/resolv.conf
当 Corefile 使用:
forward . /etc/resolv.conf
它读取的是 CoreDNS 运行环境中的 /etc/resolv.conf,不能简单等同于管理员在节点上看到的文件。尤其要警惕:
nameserver 127.0.0.53
CoreDNS Pod 中的 127.0.0.53 指向该 Pod 自己的回环地址,若 Pod 内没有对应的本地 DNS 监听,就会导致外部查询超时。节点使用 systemd-resolved 时,常见处理方向是让 kubelet 使用实际可达的上游配置文件,或者在 CoreDNS forward 中指定可从 Pod 网络访问的上游 DNS。具体地址应由企业 DNS 管理方式决定,不能直接套用公共地址。
测试上游时,要确认以下条件:
如果集群内域名解析成功、外部域名返回 SERVFAIL,同时 CoreDNS 日志持续出现上游超时,根因就更接近上游网络或上游 DNS,而不是 Pod 的 dnsPolicy。
下面是一组适合现场使用的判断顺序:
/etc/resolv.conf。nameserver 不是 CoreDNS Service IP,先修正 Pod 策略或模板。/etc/resolv.conf,检查 forward 上游。例如,模拟结果如下:
异常 Pod resolv.conf:
nameserver 172.20.0.2

正常 Pod resolv.conf:
nameserver 10.96.0.10

异常 Pod:
kubernetes.default.svc.cluster.local. -> timeout
example.com. -> 成功
这里更符合 dnsPolicy: Default 或自定义 dnsConfig 的特征。因为异常 Pod 查询的是节点或企业 DNS,它能解析外部域名,但不认识 Kubernetes Service 区域。修复 Pod DNS 策略并重新创建 Pod,比重启 CoreDNS更直接。
另一组模拟结果:
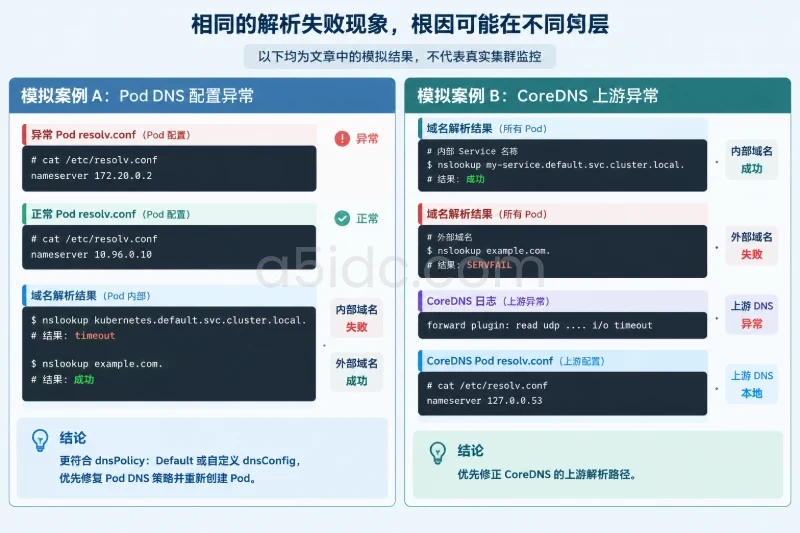
所有 Pod 的内部 Service 名称 -> 成功
所有 Pod 的外部域名 -> SERVFAIL
CoreDNS 日志 -> forward plugin: read udp ... i/o timeout
CoreDNS Pod resolv.conf -> nameserver 127.0.0.53
这时 Pod 配置和集群内 Service 路径都不是首要嫌疑,应该修正 CoreDNS 的上游解析路径,并验证节点或企业 DNS 的真实监听地址。
修复后不要只验证一次 nslookup。至少覆盖以下路径:
# 1. 从业务 Pod 验证集群内域名
kubectl exec -n <namespace> <pod-name> -- \
  nslookup kubernetes.default.svc.cluster.local.

# 2. 验证外部域名
kubectl exec -n <namespace> <pod-name> -- \
  nslookup <known-external-domain>.

# 3. 查看 CoreDNS 是否全部就绪
kubectl -n kube-system get pods -o wide
kubectl -n kube-system rollout status deploy/coredns

# 4. 检查最近日志是否仍有错误
kubectl -n kube-system logs <coredns-pod-name> \
  --since=10m --timestamps
还应重新检查一个不同节点上的 Pod。如果只有原节点恢复,其他节点仍失败,说明问题可能与节点路由、CNI、节点防火墙或节点侧 resolver 配置有关。若新创建的 Pod正常、旧 Pod异常,则确认是 Pod 配置变更未重新生成,而不是 CoreDNS本身反复故障。
CoreDNS 故障不应只依赖业务告警发现。建议从以下几类指标建立监控:
kube-dns Service 的 EndpointSlice 是否存在就绪地址。SERVFAIL 比例和请求延迟。forward 上游的超时、健康检查失败和不同上游之间的成功率。clusterDNS、节点 resolver 文件和 CNI 配置的变更。指标名称会随 CoreDNS 版本和启用的插件变化,实际告警前应先查看监控端点中暴露的指标。告警阈值可以从业务基线开始,例如连续多个时间窗口出现 SERVFAIL、上游超时或可用副本降为零,再结合请求量判断,避免把一次不存在的域名导致的正常 NXDOMAIN 当成集群 DNS 故障。
这样处理时,判断链条应始终保持清晰:先证明 Pod 使用了谁,再证明请求能否到达 CoreDNS,随后确认 CoreDNS 是否能处理集群区域,最后验证上游是否可用。只有把这几层分别验证,才能区分“Pod 配置没有生效”“集群网络到不了 DNS 服务”和“CoreDNS 转发上游异常”这三类看起来相似、修复位置却完全不同的问题。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5841.html