香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


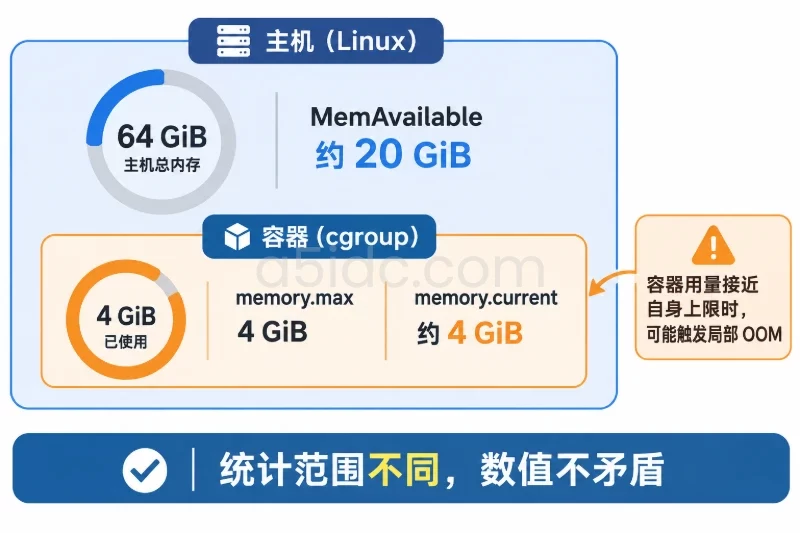
很多人看到容器设置了 512 MB 内存上限,监控显示使用量接近上限后进程退出,就会认为“容器被内核回收了”。实际情况通常分为两步:cgroup 先尝试回收页缓存、可回收内核对象或可换出的匿名页;只有在回收后仍无法满足新的内存申请时,才可能触发 cgroup OOM,由 OOM killer 终止其中一个或多个进程。
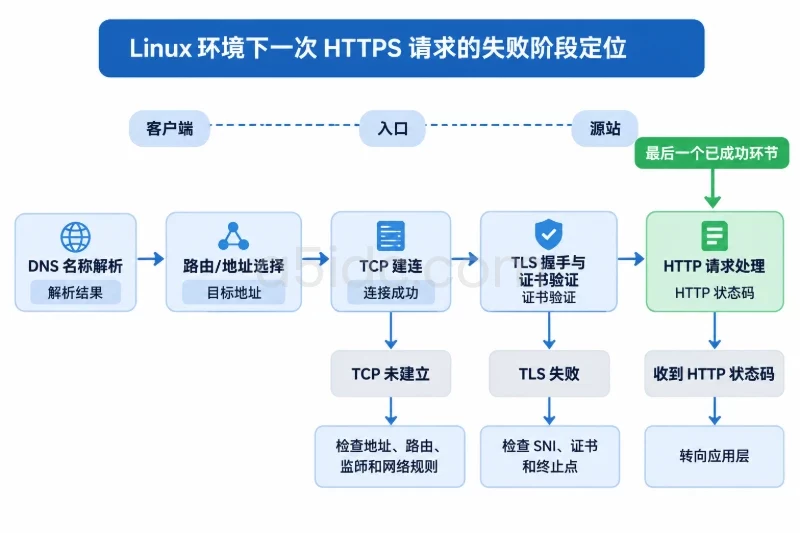
判断是否因内存超限导致退出,不能只看某一时刻的 memory.current、容器监控曲线或退出码 137。更可靠的证据链是:确认目标进程所属 cgroup,读取 memory.max、memory.events 等文件,结合内核日志和容器运行时状态,再排除宿主机整体 OOM、应用主动退出以及其他进程发送 SIGKILL 的可能性。
Linux cgroup 是内核提供的进程分组和资源控制机制。容器运行时通常会把容器内的进程放入独立 cgroup,再通过 cgroup 文件设置内存限制。
在 cgroup v2 中,常见文件位于目标 cgroup 目录下:
| 文件 | 作用 | 是否直接表示发生 OOM |
|---|---|---|
memory.current | 当前 cgroup 及其子 cgroup 使用的内存量,单位通常为字节 | 否 |
memory.max | 内存硬上限 | 否 |
memory.high | 内存压力控制线,超过后会触发回收和限流 | 否 |
memory.events | 记录达到上限、OOM 等累计事件 | 可作为重要证据 |
memory.swap.current | 当前使用的 swap 量 | 否 |
memory.swap.max | cgroup 可使用的 swap 上限 | 否 |
memory.stat | 按匿名内存、文件页、共享内存等维度拆分使用量 | 否 |
memory.max 是硬限制,但它不是“定时检查器”。进程申请或建立新的内存页时,内核会对这部分内存进行 cgroup 计费。如果当前使用量接近上限,内核会先尝试回收能够回收的内存;如果仍然无法完成这次计费,才会进入 cgroup OOM 处理。
因此,下面三种情况必须分开理解:
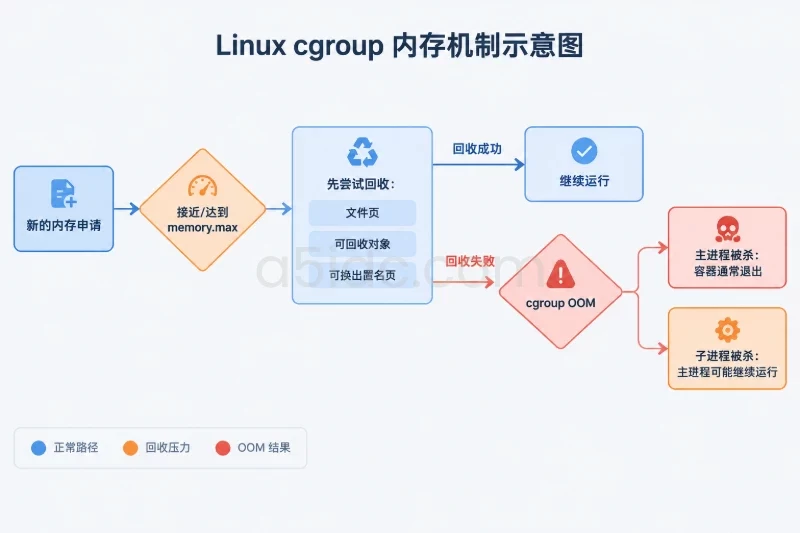
memory.max:说明资源空间不足,但不代表进程已经被杀。容器本身不是 Linux 内核中的一个单独进程。更准确地说,是容器内的进程被放在 cgroup 中。当其中的主进程被杀死,容器运行时可能因此将容器标记为退出;如果只是某个工作进程被杀死,主进程仍可能继续运行。
memory.high 与 memory.max 不能混用memory.high 更接近压力控制线,而不是绝对禁止超过的上限。进程超过该值后,内核会增加回收和调度压力,可能导致分配操作变慢或被限制,但它本身通常不会直接触发 OOM killer。
memory.max 才是硬上限。内核会尽量把 cgroup 的可计费内存控制在该值以内;如果回收、换出等方式都无法解决,才可能触发 OOM。
此外,memory.min 和 memory.low 用于内存保护:
memory.low 是尽力而为的保护,系统有压力时会优先保护低于该范围的内存。memory.min 是更强的保护,可能让上层 cgroup 在回收时承担更多压力。容器内存统计通常会包含多个来源:
tmpfs、共享内存和内存映射文件;而单个进程的 RSS、应用自身的内存监控、容器运行时的统计值,可能采用不同口径。比如某些工具会从容器内存统计中扣除部分文件缓存,docker stats 的展示方式也不应直接等同于 cgroup 原始计数。
当进程分配匿名内存、读取文件形成页缓存、创建共享内存或使用其他可计费对象时,内核会把相应页面计入某个 cgroup。
这个计费通常不是简单地把每个进程 RSS 相加。共享页、文件页、页缓存以及子 cgroup 的归属,都可能影响最终结果。因此,下面的估算并不可靠:
容器内三个进程的 RSS 分别是 100 MiB、100 MiB 和 100 MiB,所以容器使用量一定是 300 MiB。
共享页面可能不会按照这种方式重复计算,文件缓存和 tmpfs 也可能让 cgroup 使用量明显高于应用只关注的堆内存。
当新的内存计费可能让 cgroup 超过限制,内核会尝试回收:
memory.high 的 cgroup 增加限流和回收压力。如果应用主要使用文件缓存,回收可能很快完成,进程不会退出。如果应用主要使用匿名内存,并且 swap 被关闭或已经耗尽,回收空间就会很小,更容易进入 OOM。
当 cgroup 仍然无法满足内存申请,内核会在受影响的 cgroup 范围内选择进程执行 OOM kill。被杀的进程不一定是内存占用最大的进程,选择结果还会受到进程优先级、oom_score_adj、进程关系以及内核实现的影响。
默认情况下,cgroup OOM 不一定杀掉容器内所有进程:
memory.oom.group=1,内核可以把 cgroup 作为整体处理,但是否启用取决于运行时和部署配置;因此,“容器退出”与“容器内发生过 OOM”之间通常有关联,但并不是完全相同的内核事件。
在 cgroup v2 中,通常需要同时关注:
memory.max:RAM 内存上限;memory.swap.max:可使用的 swap 上限。如果 memory.max 为 256 MiB,memory.swap.max 也允许使用一定空间,进程可能保持较低的 RAM 占用,但把部分匿名页换出。此时系统总体可用空间不等于单独的 memory.max。
如果 memory.swap.max 为 0,通常表示该 cgroup 不能新增 swap 使用。容器运行时的 --memory-swap、主机是否启用 swap、内核版本以及 cgroup 版本,都会影响实际行为,不能只根据启动参数名称推断结果。
匿名内存和文件缓存的回收特征不同。
| 使用类型 | 典型来源 | 达到上限后的常见表现 |
|---|---|---|
| 匿名内存 | Java 堆、Python 对象、C/C++ 堆、线程栈 | 没有 swap 时较难回收,容易触发 OOM |
| 文件页 | 读取文件、动态库、数据库文件缓存 | 干净页可以被回收,可能只表现为性能下降 |
tmpfs | /dev/shm、内存盘、临时文件 | 通常直接消耗内存额度,不能按普通磁盘空间理解 |
| 共享内存 | 进程间通信、共享缓冲区 | 可能由多个进程共同使用,需查看 cgroup 统计 |
| 内存映射 | 映射文件、共享库、内存映射数据 | 具体计费和回收效果取决于页面是否实际驻留 |
数据库、编译任务、JVM、缓存服务等应用的内存曲线不能只看主堆。比如容器给 JVM 设置了 512 MiB 堆上限,JVM 的元空间、线程栈、直接内存、类库映射和页缓存仍可能继续消耗 cgroup 额度。
cgroup 的统计通常包括其子 cgroup。一个容器中如果启动了多个工作进程,父 cgroup 的 memory.current 反映的是整体使用量,而不是容器主进程的单独用量。
类似地,如果一个服务的 cgroup 下还有多个子服务,读取父级 memory.events 时,事件可能包含后代 cgroup 的事件。cgroup v2 中如果系统提供 memory.events.local,它更适合区分当前 cgroup 自身产生的事件与后代事件。
cgroup 是层级结构。一个容器自身的 memory.max 可能是 2 GiB,但它所在的父级 slice 只有 1 GiB。此时容器无法实际使用超过父级允许范围的内存。
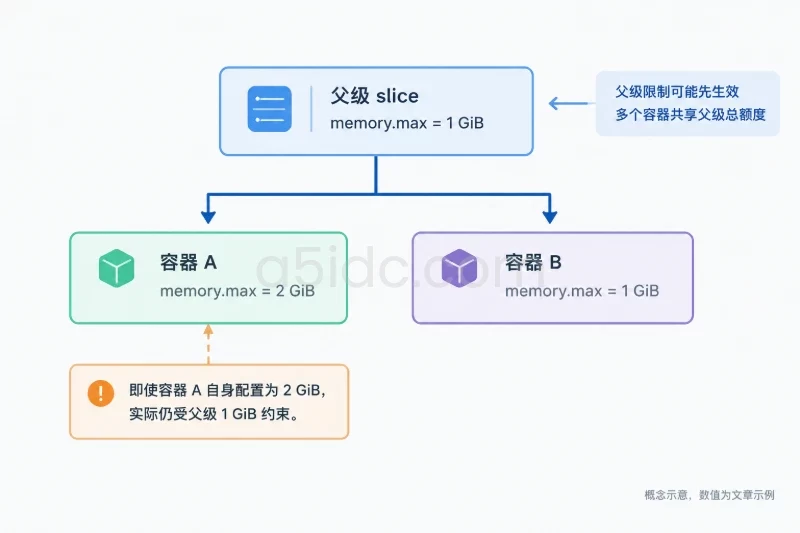
还可能出现多个容器共同放在一个父级 cgroup 中:
因此,排查时不能只读取容器自己的限制文件,也要检查其父级路径和上层事件。
如果宿主机整体内存不足,内核可能执行全局 OOM。此时被杀的进程可能属于某个容器,但并不代表该容器达到了自己的 memory.max。
两种场景的证据通常不同:
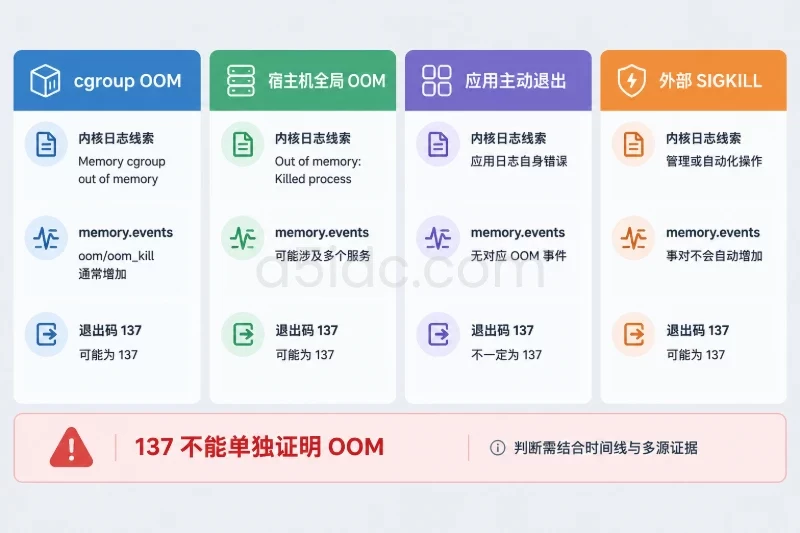
Memory cgroup out of memory 或带有 cgroup 信息的记录,目标 cgroup 的 memory.events 中通常能看到 oom、oom_kill 增加。Out of memory: Killed process 等信息,可能涉及多个服务,不能只看单个容器的限制。137,但 cgroup 事件不会因此自动增加。在 Linux 主机上,可以先确认 cgroup 文件系统类型:
stat -fc '%T' /sys/fs/cgroup
常见结果包括:
cgroup2fs:使用 cgroup v2;tmpfs 或其他结果:可能是 cgroup v1、未按预期挂载,或者当前环境没有直接暴露 cgroup 文件系统。再查看目标进程所属路径。下面的 PID 应替换为容器内实际运行进程在主机上的 PID:
PID=12345
cat /proc/"$PID"/cgroup
cgroup v2 中可能看到类似结果:
0::/system.slice/container-runtime.service/container-abcd.scope
其中 0:: 后面的内容是相对于 cgroup v2 挂载点的路径。通常可以把它与 /sys/fs/cgroup 拼接,找到对应目录。不同发行版、systemd、容器运行时和 rootless 模式下,实际路径会不同,不要根据容器名称直接猜路径。
在 cgroup v2 中,进入上一步找到的目录后读取文件:
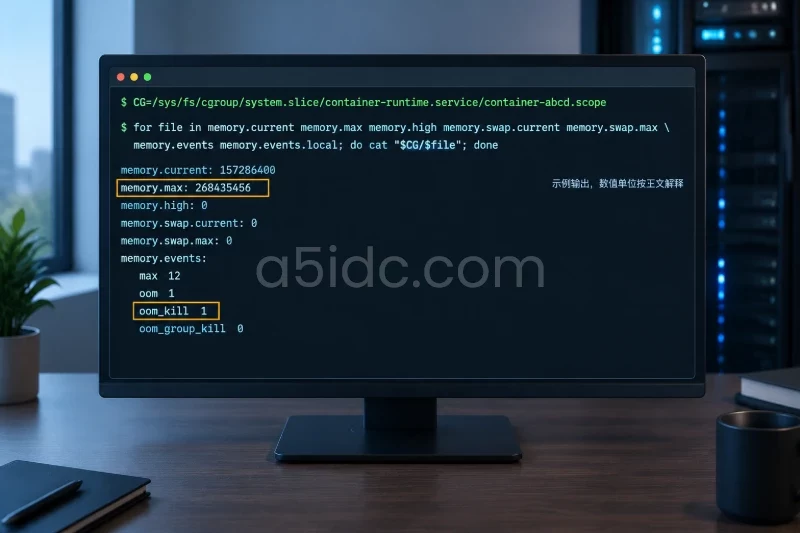
CG=/sys/fs/cgroup/system.slice/container-runtime.service/container-abcd.scope

for file in memory.current memory.max memory.high memory.swap.current memory.swap.max memory.events memory.events.local; do
    if [ -e "$CG/$file" ]; then
        printf '\n[%s]\n' "$file"
        cat "$CG/$file"
    fi
done
文件中的内存数值通常以字节表示。例如:
memory.current: 157286400
memory.max: 268435456
这里的 memory.max 是 268435456 字节,也就是 256 MiB,计算方式为:
268,435,456 ÷ 1,048,576 = 256 MiB
不要把 MB 和 MiB 混为一谈。命令行工具中的 m、mb、MiB 也可能采用不同换算规则,最终应以 cgroup 文件中的字节数为准。
一个典型的示例事件可能是:
low 0
high 0
max 12
oom 1
oom_kill 1
oom_group_kill 0
这组数据可以这样理解:
max 12:有 12 次内存计费曾经触及或尝试超过 memory.max;oom 1:发生过一次 OOM 处理;oom_kill 1:至少有一个进程被 OOM killer 终止;high 0:没有记录超过 memory.high 的事件。这些计数是累计值,不是当前瞬时状态。即使进程被杀后内存已经降到上限以下,memory.current 也可能看起来很低,但 oom_kill 仍然保留历史证据。
需要注意的是,max 增加并不等于一定杀过进程。它可能表示内核触及上限后通过回收或换出解决了问题。要判断“是否被 OOM killer 杀死”,应重点结合 oom、oom_kill 和内核日志。
如果系统提供 memory.stat,还可以查看匿名内存、文件页和共享内存等构成:
cat "$CG/memory.stat"
不同内核版本提供的字段可能不同,应以当前系统实际存在的字段为准。
在主机上查看指定时间段的内核日志:
journalctl -k --since "2025-01-01 10:00:00" --until "2025-01-01 10:10:00"
也可以筛选常见关键词:
journalctl -k --since "2025-01-01 10:00:00" --until "2025-01-01 10:10:00" \
  | grep -Ei 'out of memory|oom|killed process|memory cgroup'
部分环境不能使用 journalctl,可以尝试:
dmesg -T | grep -Ei 'out of memory|oom|killed process|memory cgroup'
容器内通常无法读取宿主机内核日志,即使容器内执行 dmesg 也可能因为权限限制失败。应在宿主机或具备相应日志权限的节点上检查。
如果看到类似下面的记录,通常能较强地支持 cgroup OOM 判断:
Memory cgroup out of memory: Killed process 12345 (java)
日志格式会因内核版本、发行版和日志配置而变化,不能只按某一条固定文本匹配。
如果使用 Docker,可以读取容器配置和退出状态:
CID=container_name_or_id

docker inspect -f \
'Memory={{.HostConfig.Memory}} MemorySwap={{.HostConfig.MemorySwap}} OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}}' \
"$CID"
还可以查看一次当前统计:
docker stats --no-stream "$CID"
OOMKilled=true 是运行时记录的重要线索,ExitCode=137 表示进程通常因 SIGKILL 退出,因为 137 = 128 + 9。但是 137 本身不能单独证明发生了内存超限,也可能是其他进程或管理操作发送了 SIGKILL。
docker stats 是当前或最近一次采样结果,不是完整历史。容器退出后,运行时可能仍保留退出状态,但对应 cgroup 目录可能已被删除,memory.events 也可能无法再读取。因此,生产环境最好持续采集 cgroup 事件、容器状态和内核日志。
在 Kubernetes 中,可以先查看容器最后一次终止原因:
kubectl get pod POD_NAME -n NAMESPACE \
  -o jsonpath='{range .status.containerStatuses[*]}{.name}{" reason="}{.lastState.terminated.reason}{" exit="}{.lastState.terminated.exitCode}{"\n"}{end}'
如果显示 reason=OOMKilled,说明 kubelet 或运行时记录到 OOM 相关终止,但仍应结合节点内核日志和 cgroup 事件确认是容器自身限制、Pod 或节点层面的内存压力。
一次完整判断可以按下面顺序进行:
memory.max、memory.current、memory.events、memory.stat。memory.swap.max 和 memory.swap.current。abort、异常退出或主动关闭。只有当时间、cgroup 事件、内核日志和运行时状态能够相互印证时,才适合明确判断为“因 cgroup 内存超限被杀”。
部分旧系统或混合部署环境仍可能使用 cgroup v1。此时常见文件名不同:
CG=/sys/fs/cgroup/memory/example

for file in memory.usage_in_bytes memory.limit_in_bytes memory.failcnt memory.oom_control; do
    if [ -e "$CG/$file" ]; then
        printf '\n[%s]\n' "$file"
        cat "$CG/$file"
    fi
done
常见含义如下:
memory.usage_in_bytes:当前使用量;memory.limit_in_bytes:内存限制;memory.failcnt:达到限制的累计计数;memory.oom_control:OOM 控制和相关状态。v1 的 memory.failcnt 只能说明曾经触及限制,不能单独证明某个进程已被杀。是否发生 OOM kill,仍应结合 memory.oom_control、内核日志、容器运行时状态和应用退出时间判断。
v1 中还可能存在 memory.memsw.limit_in_bytes 等 swap 相关接口,但是否可用取决于内核配置和挂载方式。不要把 v1 的 memory.limit_in_bytes、v2 的 memory.max 以及运行时的 --memory-swap 直接按同一含义替换。
如果 OOM killer 已经杀死了占用内存较多的进程,释放出的内存会让 memory.current 快速下降。事后采集到的低值不能否定之前发生过 OOM,必须查看累计事件和时间对应的日志。
memory.max 没有达到,不代表一定不是内存问题如果限制配置在父级 cgroup,子 cgroup 自身的 memory.max 可能看起来很宽松,但父级已经达到上限。此外,宿主机全局 OOM、节点级内存压力以及其他资源限制,也可能导致容器进程退出。
137 只表示进程以 SIGKILL 结束,来源可能包括:
SIGKILL;容器内存可能在几秒内快速增长并触发 OOM,随后进程被杀、使用量下降。如果监控每分钟采样一次,曲线上可能完全看不到峰值。memory.events 的累计计数和内核日志通常比单纯的使用量曲线更适合做事后确认。
容器删除、Pod 重建或 cgroup 被回收后,相关事件文件可能随目录一起消失。生产环境需要提前保留:
在 cgroup v2 环境中,最直接的判断组合是:确认目标进程的 cgroup 路径,读取 memory.max 与 memory.current,检查 memory.events 中的 oom 和 oom_kill,再与同一时间段的内核日志、容器运行时状态进行关联。memory.high、memory.current、memory.failcnt 或退出码 137 都只能作为辅助信息,不能单独代替 OOM 证据。
还需要明确判断对象:是容器自身达到硬上限,还是父级 cgroup 达到限制;是匿名内存无法回收,还是页缓存被回收后暂时恢复;是 cgroup OOM,还是宿主机全局 OOM。只有把限制层级、内存类型、swap 状态、事件计数和时间线放在一起,才能区分“内存被回收”与“进程因超限被杀”,并判断容器是否真的因 cgroup 内存上限退出。
面向容器化业务与多进程服务,A5数据提供香港、美国、日本等地区的物理服务器,覆盖不同CPU平台、内存容量与SSD、NVMe存储配置,可为业务进程运行、数据库及数据读写提供硬件资源基础。不同地区还有相应的网络线路方案,便于按业务部署位置和访问需求组合计算、存储与网络资源。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5647.html