香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


表文件变大,不等于PostgreSQL表已经发生膨胀。只要有效行数、索引、TOAST数据和表文件一起按业务量增长,通常属于正常增长;真正需要关注的是:有效数据没有明显增加,但表或索引持续变大,dead tuple长期偏高,且空间没有被后续写入重新利用。
区分两者不能只看数据库服务器上的磁盘占用,也不能只看某一次n_dead_tup数值。较可靠的判断需要同时观察有效行数、死元组比例、表与索引的实际大小、自动清理是否正常,以及长事务是否阻止了清理。下面的指标和SQL可以把“正常增长”“可复用但尚未归还操作系统的空间”“持续膨胀”区分开。
PostgreSQL的表空间通常可以分成几个部分:
DELETE删除的旧行,或UPDATE产生的新旧行版本中已经不再需要的旧版本。VACUUM处理后,页面内部留下的可再次写入空间。因此,“磁盘上还占着空间”至少有三种含义:
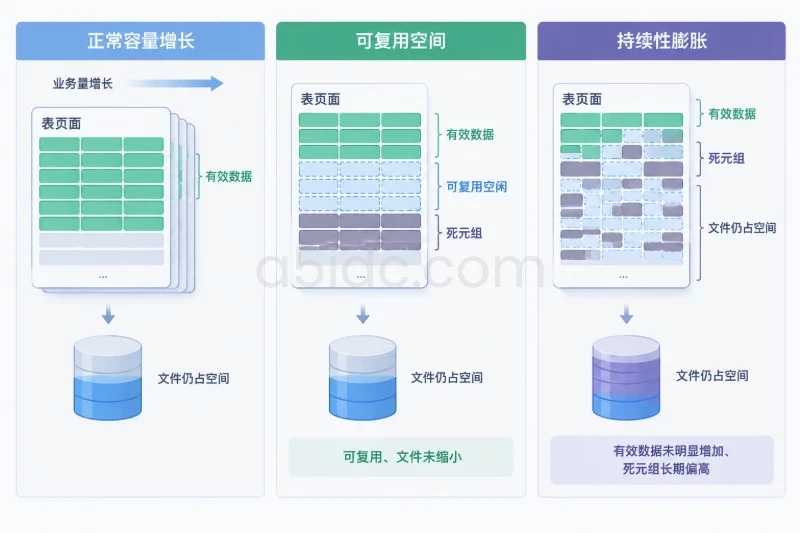
普通VACUUM的主要工作是标记和回收死元组,使页面空间可以重新使用,并更新可见性等信息。它通常不会像文件压缩工具一样把整个表重新排列后交还给操作系统。因此,执行过VACUUM后,df -h看到的数据目录大小没有明显下降,并不能单独证明清理失败。
PostgreSQL使用多版本并发控制。一个事务执行UPDATE时,通常不是直接覆盖原来的行,而是写入新的行版本;执行DELETE时,也不会立即从数据文件中物理擦除该行。
这样做可以让正在运行的事务继续读取符合其快照的数据,但旧行版本必须等到所有可能需要它的事务结束后,才能被清理。清理工作主要由VACUUM和自动清理进程完成。
高频更新表尤其容易出现这种现象。例如一个订单状态表只有100万条逻辑记录,但每天更新数千万次状态,物理行版本数量可能远高于当前有效行数。此时需要观察的是更新模式和清理速度,而不是把逻辑行数直接等同于文件大小。
VACUUM完成后,页面中的死元组空间通常会被记录为空闲空间,后续插入或更新可以优先利用这些页面。如果空闲页面位于文件末端,某些情况下可以被截断;但大量分散在表内部的空闲空间通常不会让文件整体变小。
这会造成一个常见误判:
n_dead_tup已经下降;更准确的说法是:表可能已经停止继续恶化,但操作系统层面仍保留着数据文件容量。
只要某个长事务仍可能看到旧版本,VACUUM就不能安全删除这些版本。常见来源包括:
idle in transaction会话;这类问题下,自动清理可能持续运行,但死元组数量仍然下降很慢。需要先找出阻塞清理的事务,而不是盲目增加VACUUM频率。
pg_stat_user_tables中的n_live_tup和n_dead_tup是估算值,适合做趋势观察和初筛,不是精确计数。
SELECT
    relid::regclass AS table_name,
    n_live_tup,
    n_dead_tup,
    ROUND(
        100.0 * n_dead_tup /
        NULLIF(n_live_tup + n_dead_tup, 0),
        2
    ) AS dead_ratio_percent,
    n_mod_since_analyze,
    last_autovacuum,
    autovacuum_count
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 30;
可以按以下方式理解:
| 观察结果 | 更可能的含义 |
|---|---|
n_live_tup持续增加,n_dead_tup占比稳定且较低 | 业务数据正常增长 |
有效行数基本不变,n_dead_tup持续增加 | 更新或删除产生的旧版本没有及时清理 |
n_dead_tup曾经较高,自动清理后明显下降,但表文件未变小 | 空间已部分可复用,不代表仍在持续膨胀 |
n_dead_tup高,同时长期没有last_autovacuum | 需要检查自动清理配置、权限、负载或阻塞事务 |
| 死元组比例不高,但索引或TOAST占总空间很大 | 问题可能不在主表死元组 |
死元组比例没有适用于所有业务的统一阈值。对于几百MB的小表,20%的死元组未必马上造成问题;对于100GB的大表,5%也可能意味着数GB的额外扫描和缓存占用。
在大型更新频繁的表上,可以把“持续超过10%至20%,并且表大小达到GB级”作为需要进一步核验的筛选信号,但不能把它直接当成执行VACUUM FULL的条件。
只看pg_total_relation_size无法知道空间到底由什么组成。可以先列出各表的主表、TOAST、索引和总大小:
SELECT
    schemaname,
    relname,
    pg_size_pretty(pg_relation_size(relid)) AS main_relation_size,
    pg_size_pretty(pg_table_size(relid)) AS table_size_including_toast,
    pg_size_pretty(pg_indexes_size(relid)) AS indexes_size,
    pg_size_pretty(pg_total_relation_size(relid)) AS total_relation_size
FROM pg_stat_user_tables
ORDER BY pg_total_relation_size(relid) DESC
LIMIT 30;
这些函数的含义不同:
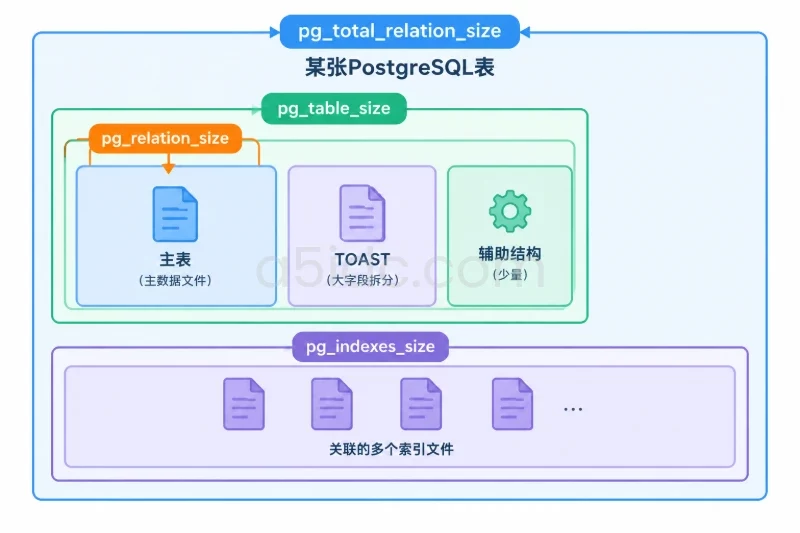
pg_relation_size主要反映关系的主数据文件;pg_table_size包含表数据、TOAST以及相关辅助结构;pg_indexes_size统计该表关联索引的大小;pg_total_relation_size包含表、TOAST和索引。例如,一张主表只有20GB,但索引达到70GB,此时即使表本身没有明显死元组,数据库服务器仍可能因为索引占用过大而出现空间压力。反过来,主表很大而索引较小,也要检查是否存在大量宽字段被写入TOAST。
还可以进一步列出单个表的索引:
SELECT
    ui.schemaname,
    ui.relname AS table_name,
    ui.indexrelname AS index_name,
    pg_size_pretty(pg_relation_size(ui.indexrelid)) AS index_size,
    ui.idx_scan
FROM pg_stat_user_indexes AS ui
WHERE ui.schemaname NOT IN ('pg_catalog', 'information_schema')
ORDER BY pg_relation_size(ui.indexrelid) DESC
LIMIT 50;
idx_scan低不等于索引一定应该删除。索引可能用于低频但关键的查询,也可能是约束索引。它只能帮助定位“空间主要在哪里”,不能直接替代索引使用分析。
pgstattuple核对物理页面当统计视图显示出明显异常时,可以使用pgstattuple观察表中实际的元组和空闲空间比例。该扩展需要在目标数据库中安装,并且通常需要相应权限。
CREATE EXTENSION IF NOT EXISTS pgstattuple;
对示例表进行检查:
SELECT *
FROM pgstattuple('public.orders'::regclass);
重点关注:
table_len:关系长度;tuple_count和tuple_len:当前检测到的有效元组数量及大小;dead_tuple_count和dead_tuple_len:死元组数量及大小;dead_tuple_percent:死元组比例;free_space和free_percent:页面中的空闲空间。pgstattuple比统计视图更接近物理实际,但可能扫描大量数据,带来明显磁盘读压力。对数百GB甚至TB级表,宜在业务低峰期执行,并先评估I/O能力。若只需要较快的估算,可以查看实例版本支持的pgstattuple_approx,但估算结果仍不能当作精确盘点。
一个典型的判断过程如下:
free_percent较高:可能是之前已经清理过,空间留在文件内部等待复用。自动清理触发条件与表的估算行数、修改量和实例配置有关。若仍使用常见默认比例,表的自动清理阈值大致可以理解为:
清理阈值 = 固定阈值 + 表估算行数 × 清理比例
例如,某表估算有1000万行,清理比例按20%计算,则达到约200万条死元组或相关修改量后才可能触发一次清理。实际值必须以实例配置为准:
SHOW autovacuum;
SHOW autovacuum_vacuum_threshold;
SHOW autovacuum_vacuum_scale_factor;
SHOW autovacuum_max_workers;
SHOW log_autovacuum_min_duration;
如果表只有100万行但每小时更新几十万行,按较高的全局比例等待自动清理,可能已经造成明显堆积。此时通常应对高写入表设置更合适的表级参数,而不是简单提高全局清理进程数量。
查看表是否存在单独配置:
SELECT
    n.nspname AS schema_name,
    c.relname AS table_name,
    c.reltuples,
    c.reloptions
FROM pg_class AS c
JOIN pg_namespace AS n
  ON n.oid = c.relnamespace
WHERE n.nspname NOT IN ('pg_catalog', 'information_schema')
  AND c.relkind IN ('r', 'm')
ORDER BY c.reltuples DESC
LIMIT 50;
如果last_autovacuum长期为空,不能立即断定自动清理失效。临时表、很少变化的表、没有达到阈值的表都可能没有记录。但对于一个持续更新且死元组明显增加的业务表,长期没有自动清理记录就值得进一步检查。
数据库服务器的磁盘占用不只来自表,还可能来自:
pg_wal中的WAL文件;因此,先从数据库维度查看各库大小,再结合操作系统的文件系统使用情况。不要把df -h中看到的全部已用空间都归因于某一张表。
在数据库内部可以先查看数据库总量:
SELECT
    datname,
    pg_size_pretty(pg_database_size(datname)) AS database_size
FROM pg_database
ORDER BY pg_database_size(datname) DESC;
这一查询只能定位数据库级别,之后还要结合表、索引和WAL等项目继续拆分。
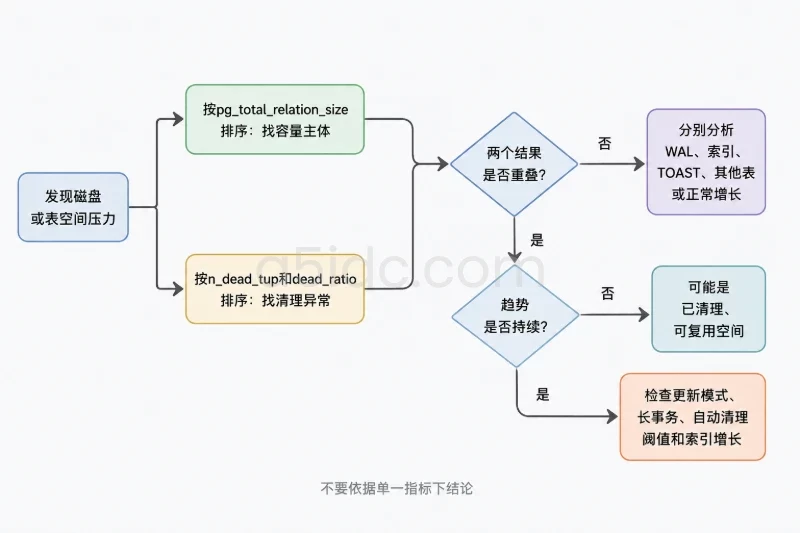
同一张表可能“总大小最大”,但并没有膨胀;另一张表可能总大小不在前列,却因为高频更新持续制造死元组。建议分别进行两次排序:
pg_total_relation_size找容量主体;n_dead_tup和死元组比例找清理异常。只有当两类结果重叠,并且趋势持续,才更像是既影响容量又影响运行效率的膨胀问题。
查找持续时间较长的事务:
SELECT
    pid,
    usename,
    application_name,
    client_addr,
    state,
    xact_start,
    now() - xact_start AS transaction_age,
    backend_xmin,
    LEFT(query, 160) AS query_sample
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;
重点关注:
state为idle in transaction;xact_start已经持续很久;如果怀疑某个会话阻止清理,应先联系业务确认其用途和事务边界。不要直接终止生产会话。终止会话属于有影响的数据库操作,执行前需要确认业务方、保留必要日志,并准备应用重试或回滚方案。
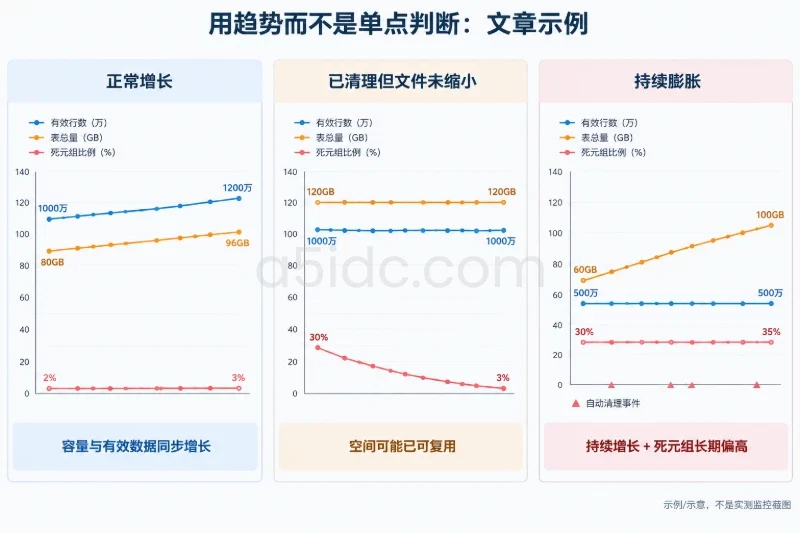
至少连续记录以下指标:
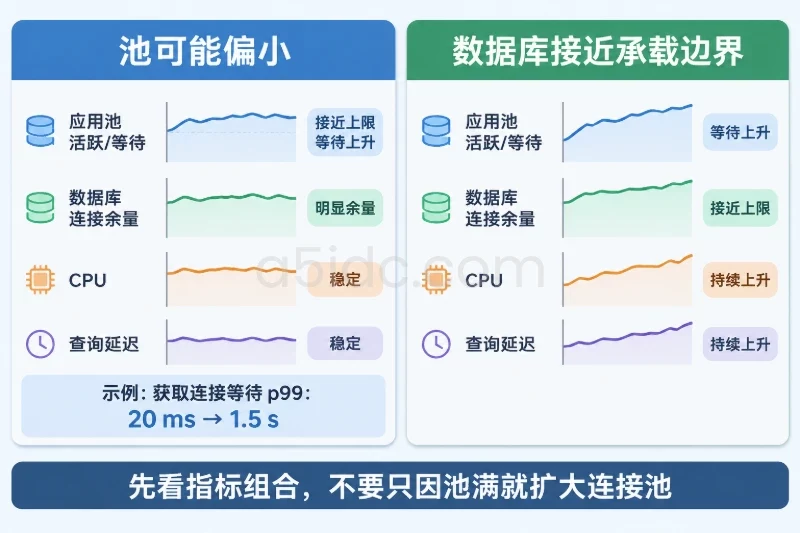
n_live_tup;n_dead_tup;dead_ratio_percent;可以构造出三种常见曲线:
正常增长:有效行数从1000万增长到1200万,表总量从80GB增长到96GB,死元组比例始终在较低范围内。容量增加与业务数据增加基本同步。
已清理但文件未缩小:有效行数基本不变,死元组曾从30%下降到3%,表文件仍保持120GB。此时空间可能已经可以被复用,不宜仅凭文件大小执行重写。
持续膨胀:有效行数稳定在500万左右,表总量从60GB持续增长到100GB,死元组比例长期维持在30%以上,自动清理记录很少或清理后很快再次堆积。此时应查更新模式、长事务、自动清理阈值和索引增长。
如果只是死元组暂时偏高,优先确认自动清理是否正在工作,并在低峰期对单表执行普通清理。例如:
VACUUM (VERBOSE, ANALYZE) public.orders;
这会针对指定表执行清理和统计信息更新,通常不会删除业务可见行,但会产生磁盘I/O并消耗资源。执行前应确认已有可恢复的备份或快照,评估业务高峰和复制延迟。普通VACUUM不是用于压缩文件的操作,通常没有“回滚文件大小”的效果;如果中途停止,一般可以在后续窗口继续处理。
只有在需要把大量内部空闲空间重新组织并尽量归还文件系统时,才考虑VACUUM FULL或其他表重写方式。它需要更强的锁,可能阻塞读写,通常还需要接近原表大小的额外临时磁盘空间。执行前必须完成备份可恢复性确认、磁盘余量检查、维护窗口安排和回滚预案。VACUUM FULL一旦开始,不适合依赖事务回滚来恢复原状。
如果空间主要集中在索引,应先确认索引是否仍有业务用途,再评估REINDEX或在线重建方案。在线重建通常需要额外索引空间,并可能增加I/O、WAL和复制延迟;失败时要按照版本支持情况和工具行为进行清理,不能把“重建索引”当成无影响操作。
分区父表的统计信息和空间通常不能代表所有分区。应按实际分区逐个检查大小、死元组和最近清理时间,尤其关注写入最频繁的热分区。
age(relfrozenxid)不是膨胀指标事务ID年龄主要用于判断冻结和事务ID回卷风险。它非常重要,但不能直接说明表有多少无效空间。一个表可能事务ID年龄较大但没有明显膨胀,也可能死元组很多但事务ID年龄并不突出,二者要分开处理。
n_dead_tup是估算值统计视图适合趋势和筛选,不适合直接作为精确空间核算。需要决定是否重写大表时,应结合pgstattuple、表大小、业务访问模式和时间序列共同判断。
如果空闲空间能被新写入复用,且查询主要访问有效页面,较大的文件未必立即造成性能问题。但顺序扫描、缓存命中率、备份耗时和存储空间都会受到影响。是否需要处理,应结合实际I/O、查询延迟和容量余量,而不是只看一个百分比。
PostgreSQL表空间管理与数据库服务器的计算、内存和存储资源密切相关。A5数据提供香港、美国、日本等地区的物理服务器,涵盖Xeon Gold与AMD EPYC平台,并有NVMe存储配置,可为数据库、业务后台和接口服务提供部署资源。针对数据规模和存储需求,香港及日本部分方案还提供大容量机械硬盘配置;多地区产品则覆盖不同线路选择,适用于面向不同区域用户的业务部署。
WAL、临时文件、归档、备份文件和其他表空间都可能造成服务器磁盘增长。只有在数据库级、表级和关系组成级指标相互对应时,才能把磁盘压力归因到某张PostgreSQL表。
最终可以用一个简单标准收口:有效行数增长与表总量增长大致同步,死元组比例可控且自动清理正常,通常属于正常增长;有效行数不变而表持续变大,死元组长期偏高或旧事务阻止清理,才应按膨胀问题继续处理。任何重写表或重建索引的动作,都应在完成指标核验、备份确认、影响评估和回滚安排后执行。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5639.html