香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


美国服务器上运行 Linux 时,应用报错“无法创建文件”并不一定代表磁盘容量已经用尽。最常见的两类原因是数据块耗尽和 inode 耗尽:前者表示还能使用多少字节,后者表示文件系统还能创建多少个文件、目录、软链接或套接字。即使 df -h 显示还有几十 GB 空间,只要 df -i 的 IFree 为 0,创建新文件仍会失败。
定位小文件目录时,应先确认发生故障的路径属于哪个文件系统,再使用 inode 统计而不是单纯查看目录大小。通常先执行 df -hT 和 df -i,随后以 du --inodes 找出 inode 数量集中的目录,最后结合日志、服务进程、容器挂载和定时任务确认是谁持续创建这些文件。下面的示例输出均为演示数据,不代表某台实际美国服务器的检查结果。
应用日志、Shell 返回值和系统日志中的错误文本,能够帮助确定排查分支,但不能单独作为最终结论。
| 现象或错误 | 常见含义 | 需要继续确认的项目 |
|---|---|---|
No space left on device | 数据块或 inode 可能耗尽 | df -h、df -i、配额 |
Disk quota exceeded | 用户、组或项目配额达到上限 | quota、XFS 配额 |
Too many open files | 进程文件描述符达到限制 | ulimit -n、进程 FD 数量 |
Read-only file system | 文件系统被以只读方式挂载,或发生错误后自动只读 | findmnt、内核日志 |
Permission denied | 权限、ACL、SELinux 或服务用户不允许写入 | namei、getfacl、服务运行用户 |
| 创建文件操作长时间卡住 | 存储 I/O、NFS/CIFS 或文件系统异常 | iostat、vmstat、挂载类型、内核日志 |
No space left on device 对应 Linux 的 ENOSPC,既可能是数据块没有了,也可能是 inode 没有了。先不要直接删除日志或重启服务,应先查看目标路径对应的挂载点。
以下命令属于只读检查。将路径替换为实际报错目录,例如应用临时目录、上传目录或日志目录。
TARGET=/var/lib/app/tmp

df -hT -- "$TARGET"
df -i -- "$TARGET"
findmnt -T "$TARGET" -o TARGET,SOURCE,FSTYPE,OPTIONS
示例输出:
Filesystem     Type  Size  Used Avail Use% Mounted on
/dev/vda2      ext4   80G   44G   32G  58% /

Filesystem      Inodes  IUsed   IFree IUse% Mounted on
/dev/vda2      8388608 8388608       0  100% /
这个示例中,容量使用率只有 58%,但 inode 使用率已经达到 100%,所以新建普通文件、目录或临时文件都可能失败。df -i 中最值得关注的是:
IUsed:已经使用的 inode 数量;IFree:剩余 inode 数量;IUse%:inode 使用百分比;Mounted on:该统计对应的挂载点。如果目标路径是 /var/lib/app/tmp,但 findmnt 显示它实际位于独立的 /data 挂载点,就应该在 /data 范围内继续排查,不能只扫描根目录。
大多数 Linux 文件系统中,一个普通文件至少对应一个 inode,目录、软链接、Unix socket、FIFO 等也会消耗 inode。文件内容只有 0 字节,并不意味着不占 inode。
因此,以下场景都可能造成 inode 枯竭:
ext4 通常在创建文件系统时预先分配 inode,inode 数量与创建时的参数有关;XFS 的 inode 分配机制不同,但同样需要通过 df -i 和文件系统工具确认实际状态。删除大量文件只能释放已经使用的 inode,不能改变文件系统最初规划的 inode 密度。
美国服务器所在的机房或地区不会改变 Linux inode 的工作方式。真正需要确认的是目标路径位于本地磁盘、独立数据盘、容器存储层,还是 NFS、CIFS 等远程文件系统。不同层级的观察重点不同。
如果目标目录是 NFS 或 CIFS 挂载,客户端看到的 inode 和容量信息可能来自远端文件服务器。网络抖动通常不会直接消耗本地 inode,但应用在写入失败、超时重试时,可能把临时文件、断点文件或失败队列留在本地目录。
先确认挂载来源:
findmnt -T /var/lib/app/tmp -o TARGET,SOURCE,FSTYPE,OPTIONS
mount | grep -E 'nfs|cifs'
判断依据如下:
FSTYPE 为 nfs、nfs4 或 cifs:先确认远程文件系统的容量和 inode 状态;SOURCE 是远端地址或共享路径:本地 df -i 反映的未必是本机磁盘;df、ls 或应用写操作长时间无响应:需要同时考虑网络存储延迟;不要因为服务器位于美国就默认问题来自跨地域网络。只有在挂载类型、连接状态或应用重试日志支持时,才把网络作为主要分支。
系统层面要确认四件事:挂载点是否正确、是否只读、是否受到配额限制、是否存在文件系统错误。
findmnt -T /var/lib/app/tmp -o TARGET,SOURCE,FSTYPE,OPTIONS
namei -l /var/lib/app/tmp
quota -s
quota -s 是否有效取决于系统是否启用了用户或组配额。XFS 环境还可能使用项目配额,可在确认挂载点和文件系统类型后检查:
xfs_quota -x -c 'report -h' /data
如果文件系统为 XFS,且命令提示配额未启用或无法访问,不要据此判断没有 inode 问题。
还可以检查内核日志中的 I/O、只读和文件系统错误:
journalctl -k -b --no-pager | grep -Ei 'I/O error|read-only|no space|quota|ext4|xfs'
常见判断方式:
df -i 的 IFree 为 0:优先定位小文件、目录或其他 inode 对象;df -h 已满但 df -i 还有大量空闲:优先定位大日志、大上传文件、数据库文件或镜像层;df -i 仍有空闲,但应用无法创建文件:检查权限、只读挂载、配额、服务用户和应用自己的限制;df 显示正常,但路径访问卡顿:检查 I/O 延迟、远程挂载和内核错误。Too many open files 也要单独处理。它表示进程文件描述符不足,不等于 inode 耗尽:
ulimit -n
cat /proc/$(pgrep -o app-process)/limits | grep -i 'open files'
其中 app-process 只是示例进程名,实际操作时应替换为真实服务进程,避免误查其他进程。
即使文件系统本身没有损坏,系统服务也可能持续制造大量小文件。常见位置包括:
/var/log:日志切片过于频繁,或轮转失败;/var/lib:服务状态、队列、缓存和数据库辅助文件;/var/spool:邮件、打印、任务或失败队列;/tmp、/var/tmp:临时文件未设置生命周期;/var/cache:缓存没有上限或清理任务失效;/var/lib/docker 或其他容器运行时目录:容器可写层和临时层增长。可以先从几个常见目录查看 inode 分布:
for d in /var/log /var/lib /var/spool /tmp /var/tmp; do
    [ -e "$d" ] || continue
    echo "===== $d ====="
    du -x --inodes -d 1 -- "$d" 2>/dev/null | sort -n | tail -15
done
这段命令是读取统计,不会删除文件。--inodes 是 GNU Coreutils du 的选项,主流 Debian、Ubuntu、RHEL、Rocky Linux 和 AlmaLinux 环境通常可用。若系统版本较老而提示不支持,应先查看:
du --help | grep -i inode
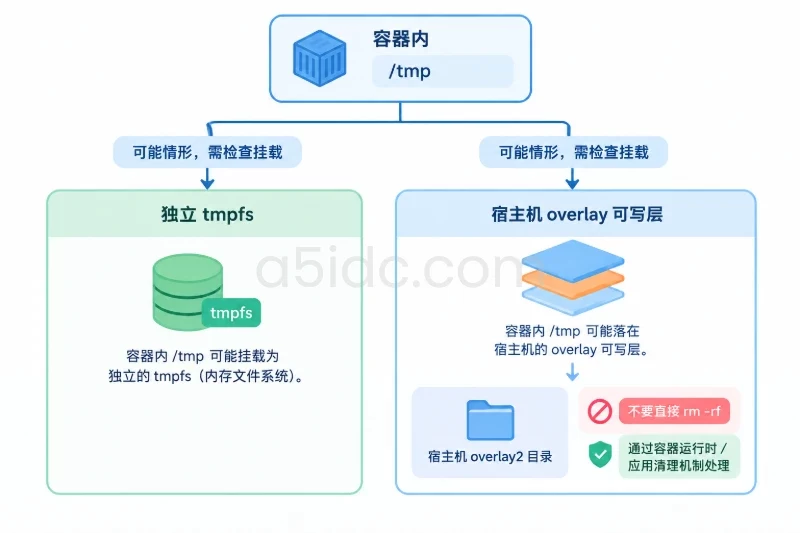
如果应用运行在容器中,需要同时检查宿主机和容器内的路径。容器中的 /tmp 可能是独立的 tmpfs,也可能落到宿主机的 overlay 上层目录。不要直接进入宿主机的 overlay2 下层目录使用 rm -rf 清理,这可能破坏镜像层或容器元数据。应通过容器运行时和应用自身的清理机制处理。
应用层通常是 inode 耗尽的根因。重点查看程序是否有以下行为:
.tmp、.part、.lock 等中间文件;建议从应用日志中搜索创建失败前后的时间窗口,并按服务运行用户、目录前缀和文件后缀进行关联。若应用日志只记录“写入失败”,可以结合系统调用跟踪或服务配置确认实际写入路径,而不要凭目录名称猜测。
不要直接对整个 / 做递归扫描。/proc、/sys、/dev、容器挂载和远程文件系统可能产生无关结果,也会增加 I/O 压力。
先设置已确认的目录:
TARGET=/var/lib/app
findmnt -T "$TARGET" -o TARGET,SOURCE,FSTYPE,OPTIONS
df -hT -- "$TARGET"
df -i -- "$TARGET"
findmnt 显示的挂载点应与 df 的 Mounted on 对应。后续使用 -x 或 -xdev,确保扫描不跨越到其他文件系统。
du --inodes 找出热点层级TARGET=/var/lib/app
du -x --inodes -d 2 -- "$TARGET" 2>/dev/null \
| sort -n \
| tail -30
示例输出:
41200   /var/lib/app/cache
98300   /var/lib/app/uploads
2865400 /var/lib/app/tmp
3011200 /var/lib/app
这里的数值是 inode 数量示例,不是字节数。/var/lib/app/tmp 占用了约 286 万个 inode,即使这些文件总大小只有几 GB,也足以成为主要嫌疑目录。
-d 2 表示显示两层深度。若热点位于更深层目录,可逐步扩大深度:
du -x --inodes -d 3 -- /var/lib/app/tmp 2>/dev/null | sort -n | tail -50
扫描大量目录会产生磁盘读取和排序开销。生产业务高峰期应降低优先级或在业务低峰执行:
nice -n 19 du -x --inodes -d 2 -- /var/lib/app/tmp 2>/dev/null \
  | sort -n \
  | tail -30
如果 sort 因临时空间不足而失败,可将排序临时目录放到另一个有空间的文件系统,例如:
sort -T /mnt/diagnostics -n
前提是 /mnt/diagnostics 已经存在、容量足够,并且不会与故障文件系统形成循环依赖。
du --inodes 适合快速定位层级。如果需要知道“哪些目录直接包含了最多文件”,可以使用 GNU find 的 %h 格式统计父目录:
TARGET=/var/lib/app/tmp

find "$TARGET" -xdev -mindepth 1 -printf '%h\n' 2>/dev/null \
  | LC_ALL=C sort \
  | uniq -c \
  | sort -nr \
  | head -50
示例结果:
2450000 /var/lib/app/tmp/failed
 180000 /var/lib/app/tmp/parts
  72000 /var/lib/app/tmp/session
这个结果表示 /var/lib/app/tmp/failed 目录下的直接和递归条目较多,应该继续检查其文件名模式、创建时间和对应服务。该命令统计的是所有类型的目录项,包括目录、文件、软链接等;如果只想统计普通文件,可以改为:
find "$TARGET" -xdev -type f -printf '%h\n' 2>/dev/null \
  | LC_ALL=C sort \
  | uniq -c \
  | sort -nr \
  | head -50
如果 find 报权限错误,使用具有读取权限的账号执行,但不要为了排查而对整个目录树递归执行 chmod -R 777。这种做法会扩大安全风险,也不能解决 inode 问题。
目录项数量高不一定全部是普通文件,也可能包含大量目录或 socket。对已经缩小的目录进行文件大小和时间分析:
TARGET=/var/lib/app/tmp/failed

find "$TARGET" -xdev -type f -size -16k \
  -printf '%s\t%TY-%Tm-%Td %TH:%TM:%TS\t%p\n' 2>/dev/null \
  | head -100
这里的 -size -16k 表示查找小于约 16 KiB 的普通文件。命令只展示前 100 行,适合先观察命名规律。若需要按文件大小排序,可能需要较多临时空间,应谨慎执行。
重点观察:
.tmp、.part、.retry、.lock;普通 find 看不到已经删除的文件。如果进程打开文件后,文件名被删除,文件内容和 inode 在进程关闭文件描述符前仍可能占用空间和 inode。
使用 lsof 检查:
lsof +L1
示例输出:
COMMAND   PID USER   FD   TYPE DEVICE SIZE/OFF NLINK NAME
worker   18420 app     7w   REG  252,2  5242880     0 /var/log/app/job.log (deleted)
NLINK 为 0 且显示 (deleted),说明目录中已经看不到这个文件,但进程仍持有它。处理方式取决于服务:
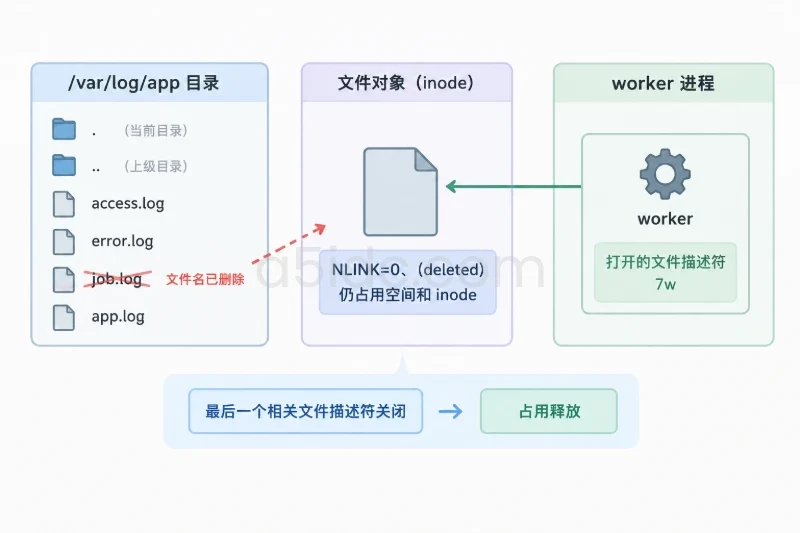
lsof +L1、df -h 和 df -i。重启服务会造成连接中断或任务重新调度,不能把它当作通用修复命令。如果服务由 systemd 管理,可以先查看状态和配置:
systemctl status app.service --no-pager
systemctl cat app.service
只有确认服务名和维护窗口后,才考虑:
systemctl restart app.service
如果是关键业务,应先备份配置、确认健康检查和回滚方式。对于单个正在增长的日志,直接删除日志文件未必能释放空间,因为进程仍可能持有旧文件描述符。
inode 耗尽本身不会直接等于 I/O 延迟,但存储拥塞会让清理任务、日志轮转和应用写入变慢,进一步造成临时文件堆积。可以在低峰执行:
iostat -xz 1 3
vmstat 1 5
如果系统没有 iostat,vmstat 仍可用于观察运行队列、内存和 I/O 等待。重点关注:
await:设备 I/O 平均等待时间;%util:设备繁忙程度;wa:CPU 等待 I/O 的比例;还可以查看日志占用情况:
journalctl --disk-usage
du -x -sh /var/log /var/lib 2>/dev/null
判断逻辑应保持区分:
当目录已经定位到 /var/lib/app/tmp/failed 之类的路径后,不要立即删除。应先回答三个问题:谁在写、哪些文件可以清理、删除后如何防止再次生成。
可以先查看目录属主、权限和最近文件:
TARGET=/var/lib/app/tmp/failed

stat "$TARGET"
find "$TARGET" -xdev -type f -printf '%u:%g %TY-%Tm-%Td %TH:%TM:%TS %p\n' \
  2>/dev/null | head -100
如果文件属主对应 app 用户,再检查该用户运行的服务、定时任务和进程:
ps -fu app
systemctl list-timers --all
grep -R "var/lib/app/tmp/failed" /etc/cron* /etc/systemd/system /usr/lib/systemd/system 2>/dev/null
grep 只用于查看配置,不要直接修改系统服务文件。若目录是由计划任务创建,应核对任务是否重复执行、清理命令是否失败、运行环境是否与交互式 Shell 不同。
可以建立一张简单的判断表:
| 观察结果 | 更可能的根因 | 下一步 |
|---|---|---|
| 单一目录 inode 数量占比很高,文件名带时间戳 | 应用日志、缓存或临时文件策略失控 | 查应用配置和保留周期 |
文件集中在 failed、retry、queue | 下游服务异常导致任务重试 | 查失败原因和重试上限 |
| 文件集中在上传分片目录 | 合并、回调或清理流程失败 | 查上传任务状态和超时清理 |
| 只有容器内报错,宿主机对应 overlay 层增长 | 容器可写层或临时目录问题 | 查容器挂载和运行时清理策略 |
df -i 正常但服务无法写入 | 权限、配额、只读挂载或服务沙箱 | 以服务用户执行写入测试 |
lsof +L1 有大量 deleted 文件 | 进程未重新打开或关闭文件 | 按服务支持方式 reload/restart |
| 目录数量正常但 I/O 等待很高 | 存储延迟或远程文件系统异常 | 查设备、NFS/CIFS 和内核日志 |
inode 已耗尽时,清理动作应从低风险、明确范围开始。删除操作不可逆,尤其不能直接执行以下类型的命令:
rm -rf /var/lib/app/*
这种写法可能删除有效数据、隐藏文件、锁文件或仍在使用的目录。正确做法是先暂停产生文件的任务,或至少降低写入速度,然后对明确的缓存或临时目录进行预览。
例如,确认 CACHE 确实是可重建缓存,并已获得业务确认后:
CACHE=/var/lib/app/cache

find "$CACHE" -xdev -type f -mtime +7 -print
预览结果符合预期后,仍需确认:
-xdev;确认后才考虑执行:
find "$CACHE" -xdev -type f -mtime +7 -delete
-delete 不是可回滚操作。若还需要删除空目录,应先人工检查目录范围,再单独处理,不要把目录删除和文件删除混在未经验证的通配符命令中。
如果根因是日志轮转,应修正日志策略并让应用重新打开日志,而不是长期依赖手工删除。若根因是临时文件,应补充成功、失败、超时和进程异常退出时的清理逻辑,并设置最大保留时间。若根因是队列积压,应优先处理任务失败原因,否则清理后仍会迅速重现。
清理或调整服务后,至少完成以下检查:
TARGET=/var/lib/app/tmp

df -hT -- "$TARGET"
df -i -- "$TARGET"
findmnt -T "$TARGET" -o TARGET,SOURCE,FSTYPE,OPTIONS
lsof +L1
然后用服务实际运行用户在受控目录进行一次创建和删除测试。下面的测试只针对指定目录生成一个带进程号的临时文件:
TEST_DIR=/var/lib/app/tmp
TEST_FILE="$TEST_DIR/.inode-check.$$"

(umask 077 && : > "$TEST_FILE") && rm -f -- "$TEST_FILE"
这条命令应在确认 TEST_DIR 是可写测试目录后执行。更严谨的方式是使用应用服务账号运行,避免 root 能创建而应用账号不能创建的误判:
sudo -u app sh -c '
TEST_FILE=/var/lib/app/tmp/.inode-check.$$
(umask 077 && : > "$TEST_FILE") && rm -f -- "$TEST_FILE"
'
验证结果应同时满足:
df -i 的 IFree 已增加,且不会持续快速下降;df -h 没有因为清理过程产生新的容量问题;ENOSPC、配额或只读错误;lsof +L1 中没有持续增长的 deleted 文件;如果只删除了文件但 inode 仍未释放,应重新检查是否删除了错误的挂载点、是否还有大量目录或软链接、是否存在其他热点目录,以及是否有进程继续持有 deleted 文件。
仅监控磁盘容量不足以覆盖这类故障。主机监控至少应同时采集:
使用 Prometheus Node Exporter 时,可以关注类似 node_filesystem_files_free、node_filesystem_files 和 node_filesystem_avail_bytes 的指标,并排除 /proc、/sys、/dev、容器临时挂载等不适合作为业务磁盘告警对象的文件系统。
告警阈值不应只设置一个“100%”告警。例如可以将 inode 使用率达到 80% 作为观察信号,90% 作为处理告警,95% 作为高优先级告警;具体阈值还要结合目录增长速度和业务写入速率调整。对每天增长数十万文件的目录,即使当前只有 70%,也可能比一个长期稳定在 90% 的目录更需要优先处理。
最终要解决的不是某一次 rm 操作,而是文件生命周期:谁创建文件、文件何时过期、失败后是否清理、服务重启后是否能恢复,以及文件系统是否适合承载这种数量级的小文件。通过 df -i 确认类型、du --inodes 缩小范围、服务和应用日志追踪写入者,再用恢复后的监控验证增长趋势,才能避免美国服务器上的 inode 耗尽反复出现。
对于日志、缓存和任务队列持续产生小文件的业务,A5数据提供美国物理服务器,涵盖常规Xeon与AMD EPYC等系列,可承载网站、数据库及容器应用。部分AMD配置配备双NVMe硬盘,为业务数据与高频写入目录的分盘规划提供硬件基础,也便于结合应用负载安排存储资源。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5517.html