香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


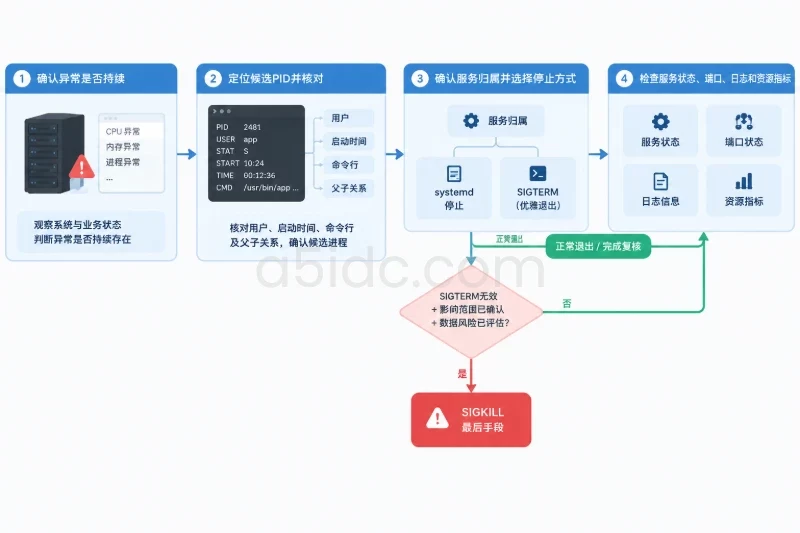
在已有 Linux 服务器上处理 CPU 飙高、内存持续增长、磁盘 I/O 等问题时,不要先按进程名执行 kill -9。更稳妥的做法是先确认主机和服务范围,再通过 ps、pidstat、vmstat 等命令定位持续占用资源的 PID,核对父子关系、服务归属和进程状态,最后优先使用服务管理器或 SIGTERM 让进程正常退出。
实际判断可以分成四步:先确认异常是否持续,再确认进程是否属于正常业务,随后选择针对单个服务的停止或重启方式,完成后检查服务状态、端口、日志和资源指标。只有在进程无法正常退出并且影响范围已确认时,才考虑使用 SIGKILL。
针对网站、业务后台、数据库和多任务计算等 Linux 运行场景,A5数据提供中国香港、美国、日本、韩国、中国台湾、新加坡、马来西亚等地区的物理服务器资源,覆盖 Xeon Gold、AMD EPYC、GPU、存储及多IP等产品系列,并配备 SSD、NVMe、大容量硬盘和不同带宽线路,为进程资源分析、服务运行和异常处理提供相应的硬件与网络基础。
以下命令以使用 procps 和 systemd 的常见 Ubuntu、Debian、Rocky Linux、AlmaLinux 等发行版为例。精简系统可能缺少 pidstat、pstree 或 iostat,需要先确认命令是否存在,不要直接假定工具已经安装。
先确认当前主机、系统版本、权限和 CPU 核数:
hostname
cat /etc/os-release
date
id
nproc
command -v systemctl
command -v pidstat
command -v pstree
生产环境操作前,至少记录以下信息:
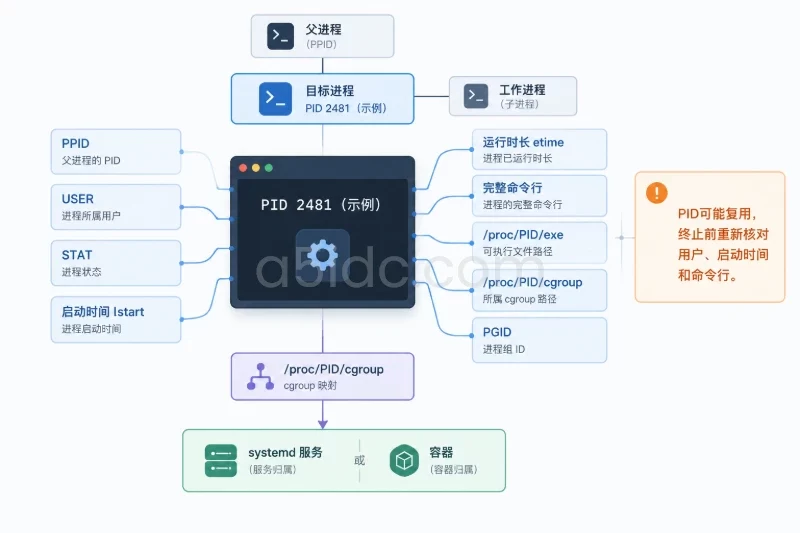
PID 会被系统复用。一个进程退出后,原来的 PID 可能很快分配给另一个进程,所以不能只凭历史告警中的 PID 执行终止命令。每次处理前都要重新检查 PID 的用户、启动时间和完整命令行。
还要注意区分以下对象:
systemctl stop 或应用提供的停止方式。先看主机整体状态,不要只盯着某一个进程。下面的命令可以快速区分 CPU、内存、I/O 或文件系统问题:
uptime
cat /proc/loadavg
nproc
free -h
vmstat 1 5
df -hT
df -ih
load average 表示一段时间内处于可运行状态或不可中断等待状态的任务数量,不能直接当作 CPU 百分比。可以结合 nproc 判断:例如 4 个逻辑 CPU 上,短时间的 load 2 通常不等同于 CPU 已经饱和;如果 load 长时间超过 CPU 数量,同时业务延迟升高,才更值得继续调查。
vmstat 重点观察:
r:等待运行的任务数。si、so:交换分区读写,持续增长通常说明内存压力较大。wa:等待 I/O 的时间比例。free、buff、cache:需要结合 free -h 的 available 一起判断,不能只看 free 数值。使用 ps 分别按 CPU 和常驻内存列出候选进程:
ps -eo pid,ppid,user,stat,%cpu,%mem,rss,vsz,etime,args --sort=-%cpu | head -n 21
ps -eo pid,ppid,user,stat,%cpu,%mem,rss,vsz,etime,args --sort=-rss | head -n 21
这里的 RSS 是进程实际驻留在内存中的规模,通常以 KiB 显示;VSZ 是虚拟地址空间大小,不能直接等同于物理内存消耗。%CPU 的计算方式与采样窗口有关,多线程进程在不同工具中可能出现超过 100 的结果,因此应结合逻辑 CPU 数量和持续采样判断。
如果系统安装了 sysstat,可以使用 pidstat 观察多个采样周期:
pidstat -u -r -d -p ALL 1 5
其中:
-u 查看 CPU 使用情况。-r 查看缺页和内存相关指标。-d 查看块设备 I/O。1 5 表示每秒采样一次,共采样 5 次。单次 ps 显示某个进程占用较高,不足以证明它异常。更可靠的判断是:资源使用连续多个周期偏高,并且与业务延迟、错误日志、可用内存下降或 I/O 等待增加同时出现。
确定候选 PID 后,先保存完整信息。下面以 2481 为示例,实际操作时替换为经过重新确认的 PID:
PID=2481

ps -p "$PID" -o pid=,ppid=,pgid=,sid=,user=,stat=,%cpu=,%mem=,rss=,vsz=,etime=,lstart=,wchan:24,args=
grep -E '^(Name|State|PPid|Uid|Threads|VmRSS|VmSwap):' /proc/"$PID"/status
cat /proc/"$PID"/cgroup
readlink -f /proc/"$PID"/exe
tr '\0' ' ' < /proc/"$PID"/cmdline
echo
如果进程在检查期间退出,/proc/PID 目录会消失,相关命令失败属于正常现象。此时应重新获取进程列表,不要继续对原 PID 发送信号。
重点检查以下字段:
| 字段或状态 | 关注点 | 常见判断 |
|---|---|---|
PPID | 父进程是谁 | 可判断是否由服务管理器、脚本或任务调度器启动 |
STAT | 当前进程状态 | R 表示运行,S 通常是休眠,D 多与不可中断 I/O 等待有关,Z 表示僵尸 |
RSS | 实际驻留内存 | 适合观察内存占用和增长趋势 |
VSZ | 虚拟地址空间 | 不能直接当作物理内存使用量 |
lstart、etime | 启动时间和运行时长 | 用于防止 PID 复用误判 |
wchan | 内核等待位置 | 可辅助判断进程正在等待什么 |
/proc/PID/exe | 实际可执行文件 | 可发现未知路径、异常路径或被替换的文件 |
/proc/PID/cgroup | 所属控制组 | 常用于映射 systemd 服务或容器 |
如果进程由 systemd 管理,先从 cgroup 或服务清单确认服务名称,再查看服务状态:
sudo systemctl status example.service --no-pager
sudo systemctl show example.service -p MainPID -p ActiveState -p SubState -p Restart -p TimeoutStopUSec
也可以通过进程树查看它是否派生了多个工作进程:
pstree -aps "$PID"
如果系统没有 pstree,使用 ps 查询父子关系:
ps -eo pid,ppid,user,stat,etime,args --forest
不要因为进程名看起来熟悉就直接处理。需要同时确认进程用户、可执行文件路径、启动参数、父进程和服务归属。某些程序会使用相同的通用名称运行,按名称批量执行 pkill 或 killall 可能误伤其他实例。
针对候选 PID,至少进行两到三轮采样。资源占用的判断标准应结合业务场景,以下数值只能作为排查起点,不能替代业务基线:
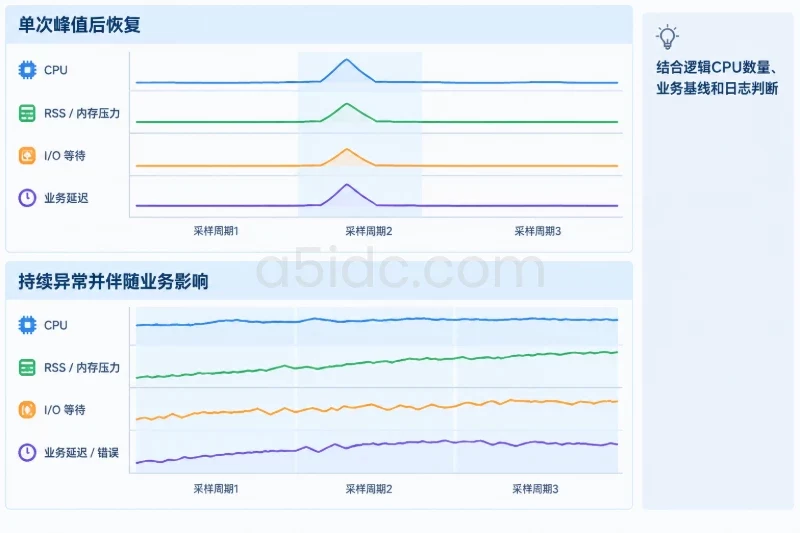
available 内存下降,交换分区读写增加,或者系统出现 OOM 记录。D 状态。使用 pidstat 观察单个进程:
pidstat -p "$PID" -u -r -d 5 3
没有 pidstat 时,可以使用批处理模式的 top:
top -b -d 5 -n 3 -p "$PID"
如果发现高 CPU 主要来自某一个线程,可以进一步查看线程级数据:
top -H -p "$PID"
高 CPU 不一定是异常。例如批量压缩、日志轮转、报表计算和数据索引任务可能在维护窗口内持续使用 CPU。相反,一个只负责低流量接口的进程突然占满多个核心,就需要结合应用日志、请求量和启动参数继续确认。
确认服务名称和影响范围后,优先执行优雅停止,而不是直接操作主 PID:
SERVICE=example.service

sudo systemctl status "$SERVICE" --no-pager
sudo systemctl stop "$SERVICE"
sudo systemctl is-active "$SERVICE"
sudo systemctl status "$SERVICE" --no-pager
systemctl stop 可能同时结束该服务 cgroup 中的多个进程,影响范围通常比对单个 PID 执行 kill 更明确,但也可能中断现有连接。对有状态服务,应先确认应用的关闭流程、数据落盘机制、备份或副本状态,并按照维护窗口执行。
如果业务允许重新启动,再执行:
sudo systemctl start "$SERVICE"
sudo systemctl is-active "$SERVICE"
sudo systemctl status "$SERVICE" --no-pager
不要把 systemctl restart 当作定位异常的第一步。重启会同时包含停止和启动,可能掩盖原始问题,也可能让尚未保存的数据来不及处理。若服务设置了自动重启策略,手工杀掉主 PID 后可能马上产生新的 PID,此时应回到服务状态和日志中判断,而不是重复终止新进程。
SIGTERM如果确认是一次性任务或手工启动的进程,先记录身份信息,再发送 SIGTERM:
PID=2481

ps -p "$PID" -o pid=,ppid=,user=,stat=,lstart=,args=
sudo kill -TERM "$PID"
sleep 5
ps -p "$PID" -o pid=,ppid=,user=,stat=,lstart=,args=
SIGTERM 会给应用执行清理和退出的机会,应用可以关闭文件、完成日志刷新或释放锁。进程消失后,不能把它恢复到原来的运行状态;这里的“回滚”只能通过应用的正常启动流程、配置备份和数据恢复机制完成。
如果进程仍然存在,先重新核对 PID 的启动时间、用户和命令行,确认它还是原来的进程。只有在以下条件同时满足时,才考虑强制终止:
SIGTERM 等待超过应用约定的关闭时间仍无效。确认后才执行:
sudo kill -KILL "$PID"
SIGKILL 不会给应用清理资源的机会,可能造成临时文件残留、锁未释放、未提交事务丢失或队列状态不一致。不要使用以下高风险方式代替确认过程:
# 不建议在生产环境直接执行
pkill -9 process-name
killall -9 process-name
按名称批量杀进程无法保证只命中目标实例。对于有多个工作进程的程序,也不要未经确认就向整个进程组发送信号。必须先核对 PGID、服务 cgroup 和进程树,确认进程组中没有其他业务。
先查看线程、任务计划和应用日志:
sudo journalctl -u example.service -n 100 --no-pager
top -H -p "$PID"
如果高 CPU 与已知批处理时间一致,且业务响应正常,优先调整任务调度、并发数或资源限制,而不是直接终止。若确实需要临时降低影响,可以在记录原始优先级后调整 nice 值;恢复时应还原到记录的原值。调整调度优先级只能缓解资源竞争,不能解决内存泄漏或死循环。
先确认是单个进程 RSS 增长,还是系统缓存、文件映射或多个进程共同造成:
free -h
vmstat 1 5
sudo journalctl -k -b --no-pager | grep -i -E 'oom|out of memory|killed process'
如果进程确实持续增长,记录采样数据、启动参数和业务请求情况,再按照应用的优雅重启流程处理。不要通过反复强制杀进程掩盖泄漏问题。涉及数据库或队列时,应优先确认数据一致性和恢复方案。
D 状态D 通常表示进程处于不可中断等待,常见原因包括本地磁盘、块设备、网络文件系统或底层存储响应异常。此时 SIGTERM 甚至 SIGKILL 也可能要等内核等待结束后才生效。
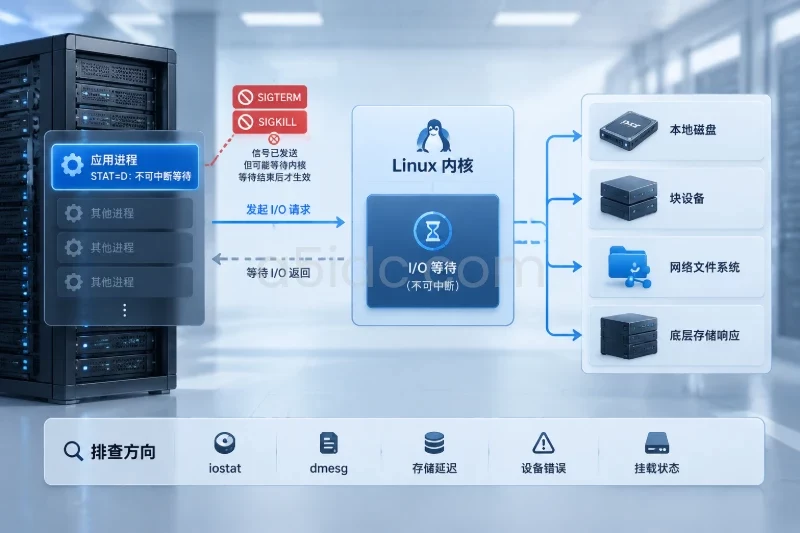
可以查看 I/O 和内核日志:
command -v iostat && iostat -xz 1 3
dmesg -T | tail -n 100
重点排查存储延迟、设备错误和挂载状态。不要连续重复发送强制信号,也不要为了让进程消失而直接卸载正在使用的文件系统。
Z 状态僵尸进程已经结束,只是父进程尚未回收其退出状态。杀死僵尸本身没有作用,应先确认父进程:
ps -p "$PID" -o pid=,ppid=,stat=,user=,args=
ps -p "$(ps -p "$PID" -o ppid=)" -o pid=,ppid=,stat=,user=,args=
通常应通过应用自身的重载、重启或修复父进程的回收逻辑解决。直接处理父进程可能导致同一服务下的其他任务中断,必须先确认影响范围。
如果刚终止的进程马上出现新 PID,说明它可能由 systemd、任务调度器、进程守护程序或容器管理器负责拉起。检查服务日志和重启策略:
sudo systemctl status example.service --no-pager
sudo journalctl -u example.service -n 100 --no-pager
sudo systemctl show example.service -p Restart -p MainPID
应停止或调整负责拉起它的上层管理对象,再处理根因。不要无限重复杀新 PID,否则既无法解决问题,也会丢失服务反复崩溃的重要日志。
对无法确认来源的进程,先保存证据,再决定是否终止:
PID=2481

sudo ps -p "$PID" -o pid,ppid,user,stat,lstart,etime,args
sudo readlink -f /proc/"$PID"/exe
sudo stat /proc/"$PID"/exe
sudo lsof -nP -p "$PID"
sudo ss -ntup
可以根据可执行文件路径使用发行版对应的包管理工具核对文件归属,例如 Debian 系使用 dpkg-query -S,RPM 系使用 rpm -qf。如果确认存在恶意行为,应按照安全事件流程保留日志、命令行、网络连接和文件信息,并结合主机隔离策略处理,不要先删除文件或清空日志。
进程停止或服务重启后,不能只以“PID 不见了”作为成功标准。至少检查以下项目:
sudo systemctl is-active example.service
sudo systemctl status example.service --no-pager
sudo journalctl -u example.service -n 100 --no-pager

uptime
free -h
vmstat 1 5
ss -lntp
对未托管进程,应使用原有的启动脚本、任务调度器或应用部署方式恢复,不要为了快速恢复而直接以 root 身份手工运行二进制文件。启动失败时,先检查配置文件、工作目录、环境变量、权限、依赖服务和端口占用。
如果此前修改过服务配置、启动参数或资源限制,应在修改前保留备份,并记录变更时间。systemd 单元或 drop-in 配置变更后需要执行:
sudo systemctl daemon-reload
回滚时恢复经过确认的旧配置,再次执行 daemon-reload,最后按服务启动流程验证。对数据库、消息队列和写入型应用,还要检查未完成事务、积压队列、数据文件和应用级健康检查,必要时使用备份或副本进行恢复。
以下为示例输出,用于说明判断过程,不代表某台服务器的实测结果:
$ ps -p 2481 -o pid,ppid,user,stat,%cpu,%mem,rss,etime,args
  PID  PPID USER STAT %CPU %MEM    RSS     ELAPSED COMMAND
 2481     1 app   R   168.4  3.1 1912048       42:18 /opt/orders/bin/worker --queue=order
该进程由 app 用户运行,已持续 42 分钟,RSS 约为 1.9 GiB,CPU 使用率较高。由于 CPU 数量、工具计算方式和业务任务类型尚未确认,不能仅凭这一行就终止进程。
继续采样:
$ pidstat -p 2481 -u -r -d 5 3
Average:      UID       PID    %usr %system  %CPU   CPU  Command
Average:     1001      2481   161.20    7.10 168.30     2  worker
如果同时发现订单处理延迟增加,且 /proc/2481/cgroup 显示它属于 orders-worker.service,下一步应检查该服务日志和队列状态,然后使用:
sudo systemctl stop orders-worker.service
停止后确认服务不再运行、队列没有异常丢失,再按照原有发布或启动方式恢复。若 stop 超时,不要立即改用 kill -KILL,应先查看服务的停止超时、应用日志和进程状态,确认是业务清理缓慢还是底层 I/O 阻塞。
SIGKILL 前已确认 SIGTERM 无效、影响范围可接受且数据风险已评估。本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5485.html