香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


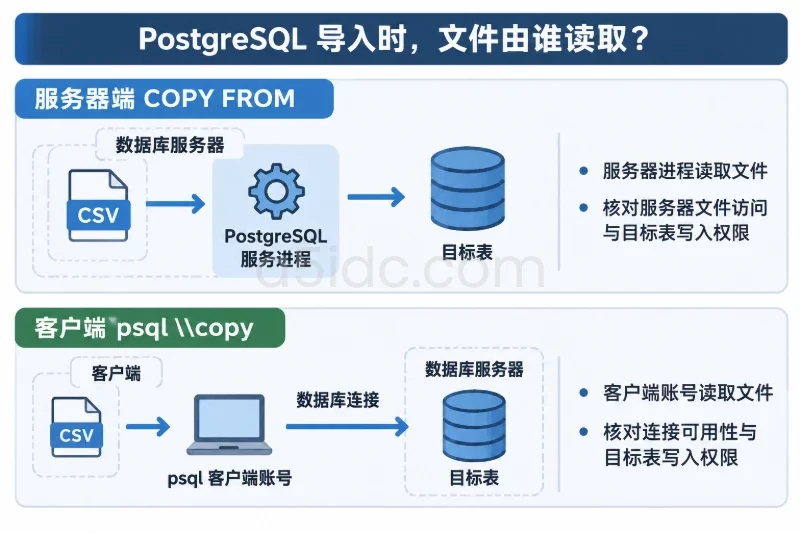
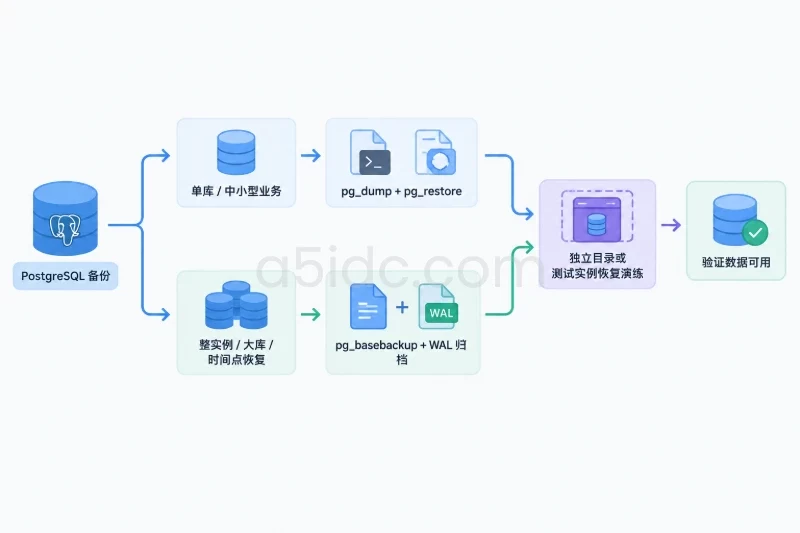
在已经运行 PostgreSQL 的 Linux 服务器上,备份工作的目标不是单纯生成一个 .dump 文件,而是明确“备份了哪些对象、多久生成一次、能够恢复到什么时间点,以及恢复后如何证明数据可用”。日常维护通常需要同时考虑逻辑备份、物理备份、WAL 归档和异地保留。
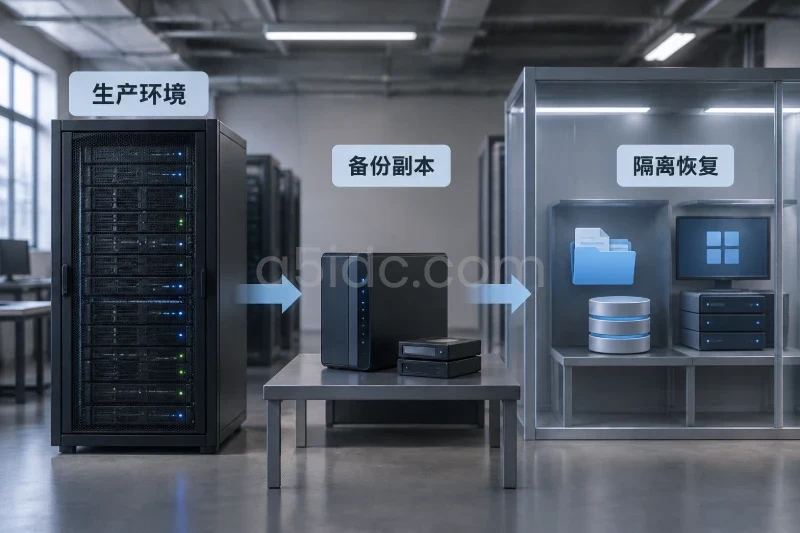
单库或中小型业务可以使用 pg_dump 配合 pg_restore;需要覆盖整个实例、缩短大库恢复时间或实现按时间点恢复时,应使用 pg_basebackup 加 WAL 归档。无论采用哪种方式,都要在独立目录或独立服务器上做一次恢复演练,不能只通过“备份命令执行成功”判断备份有效。
A5数据面向 PostgreSQL 等数据库业务提供中国香港、美国、日本等地区的物理服务器资源,覆盖 NVMe、SSD、较大内存及大容量机械硬盘方案,可为数据库实例、恢复验证环境和备份归档提供相应的计算与存储基础;结合不同地区、带宽和线路配置,也能匹配跨区域业务的部署需求。
不要直接假定服务名、数据目录和配置文件路径。Debian、Ubuntu、RHEL、Rocky Linux 等发行版的目录布局和 systemd 单元名称可能不同,先在现有环境中核对:
sudo -u postgres psql -Atqc "SELECT version();"
sudo -u postgres psql -Atqc "SHOW data_directory;"
sudo -u postgres psql -Atqc "SHOW config_file;"
sudo -u postgres psql -Atqc "SHOW hba_file;"
sudo -u postgres psql -Atqc "SELECT current_database(), current_user;"
检查服务状态时,可以先查找实际的服务名:
systemctl list-units --type=service | grep -Ei 'postgres|pgsql'
systemctl status postgresql
如果系统使用的不是 postgresql.service,后续的 systemctl start、systemctl stop 和 systemctl restart 都应替换为实际服务名。生产环境不要在未确认服务名称和数据目录的情况下执行停止、移动或覆盖操作。
还应确认备份执行用户。常见做法是使用操作系统用户 postgres 执行数据库备份,这样可以避免把数据库超级用户密码写入脚本。远程备份时使用密码文件,并将权限限制为 0600:
sudo -u postgres sh -c 'test -r ~/.pgpass && stat -c "%a %n" ~/.pgpass'
不同备份方式覆盖的对象并不相同。
| 备份对象 | 推荐方式 | 覆盖内容 | 注意事项 |
|---|---|---|---|
| 单个业务数据库 | pg_dump | 表、数据、索引、约束、触发器、数据库内对象 | 不包含角色和实例级配置 |
| 全部数据库及全局对象 | pg_dumpall 配合 pg_dump | 数据库、角色、表空间定义等 | 大库恢复时间通常较长 |
| 整个实例数据目录 | pg_basebackup | 全部数据库和物理数据文件 | 通常要求同一 PostgreSQL 大版本 |
| 时间点恢复所需的日志 | WAL 归档 | 基础备份之后持续产生的变更 | 必须保证归档连续且可读取 |
| 实例配置 | 单独复制或纳入配置管理 | postgresql.conf、pg_hba.conf 等 | 某些发行版会把配置放在数据目录之外 |
pg_dump 不会备份操作系统用户、数据库服务文件、外部挂载目录和应用程序配置。使用表空间时,还要记录表空间路径;逻辑恢复可以重新映射到其他位置,物理恢复则需要准备相应目录和权限。
备份频率应由业务能够接受的数据丢失量决定,而不是固定套用“每天一次”。
| 业务要求 | 可采用的策略 | 适用边界 |
|---|---|---|
| 最多接受一天的数据丢失 | 每日逻辑备份,保留 7 至 14 天 | 恢复时间可能随数据量增长 |
| 最多接受一小时左右的数据丢失 | 每小时逻辑备份,或基础备份加连续 WAL 归档 | 需关注备份窗口和 WAL 存储 |
| 需要恢复到误删前几分钟 | 基础备份加连续 WAL 归档 | 必须准确记录目标时间并持续验证归档 |
| 数据量较大且要求较短恢复时间 | 定期物理基础备份加 WAL 归档 | 恢复流程和版本约束更严格 |
一个常见的保留策略是:每日备份保留 7 至 14 份,每周备份保留 4 份,每月备份保留 6 至 12 份,同时在独立存储位置保留一份。具体数量应根据数据增长速度和存储容量计算。
例如,单份压缩逻辑备份约 30 GB,保留 14 份,仅逻辑备份就需要约 420 GB,另外还要预留 WAL、校验文件、临时文件和恢复过程产生的空间。这里的 GB 按十进制估算,即 1 GB 等于 1000 MB;实际文件系统显示可能采用不同口径。
pg_dump 会在数据库内部建立一致性快照。备份期间通常不需要停止业务写入,但与某些长时间运行的 DDL 可能发生锁等待。推荐使用自定义格式,便于使用 pg_restore 查看目录和并行恢复。
先准备一个不与 PostgreSQL 数据目录共用的备份目录。目录最好位于独立磁盘,并在备份完成后复制到异地存储:
sudo install -d -o postgres -g postgres -m 0700 /srv/pgbackup
sudo -u postgres test -w /srv/pgbackup
下面是单库备份示例,数据库名、目录和保留周期需要根据实际环境修改:
#!/usr/bin/env bash
set -Eeuo pipefail
umask 077

DB_NAME="appdb"
BACKUP_ROOT="/srv/pgbackup"
TIMESTAMP="$(date -u +%Y%m%dT%H%M%SZ)"
DEST="${BACKUP_ROOT}/${DB_NAME}-${TIMESTAMP}"

mkdir -p "$DEST"

pg_dump \
  --dbname="$DB_NAME" \
  --format=custom \
  --file="${DEST}/${DB_NAME}.dump" \
  --verbose

pg_dumpall \
  --globals-only \
  --file="${DEST}/globals.sql"

sha256sum \
  "${DEST}/${DB_NAME}.dump" \
  "${DEST}/globals.sql" \
  > "${DEST}/SHA256SUMS"

test -s "${DEST}/${DB_NAME}.dump"
test -s "${DEST}/globals.sql"

printf 'backup completed: %s\n' "$DEST"
脚本应以 postgres 用户执行:
sudo -u postgres /usr/local/sbin/backup-appdb.sh
globals.sql 用于保存角色、角色成员关系和表空间等全局对象。只保存数据库 dump 而不保存全局对象,恢复到新实例后可能出现对象所有者不存在、权限不匹配等问题。
如果需要备份多个数据库,可以先列出非模板数据库:
sudo -u postgres psql -Atqc \
  "SELECT datname FROM pg_database WHERE datallowconn AND NOT datistemplate ORDER BY datname;"
然后对每个数据库分别执行 pg_dump。这样恢复时可以单独恢复某个业务库,避免所有数据库共用一个较大的恢复过程。
可以使用 cron,也可以使用 systemd timer。使用 cron 时,建议用 flock 防止上一次备份尚未结束、下一次备份又启动:
15 2 * * * flock -n /var/lib/postgresql/appdb-backup.lock /usr/local/sbin/backup-appdb.sh >> /var/log/postgresql/appdb-backup.log 2>&1
定时任务并不等于监控。应对脚本退出码、备份文件更新时间、文件大小和校验结果进行告警。如果备份文件连续多天没有更新,或者备份耗时突然从几十分钟增加到数小时,都应视为异常。
本地保留周期清理必须在确认异地复制成功后进行。删除操作会影响本机历史恢复点,不能直接对生产数据目录执行。可以先预览待清理文件:
sudo -u postgres find /srv/pgbackup \
  -type f \
  -name '*.dump' \
  -mtime +14 \
  -print
确认文件已经在其他存储位置完成校验后,再按目录和保留策略清理。清理前要确认路径只指向备份目录,不要把 find 的范围写成 PostgreSQL 数据目录或整个挂载点。
对于数据量较大的实例,物理备份可以减少恢复时重新创建对象和索引的时间。示例使用 plain 格式,备份结果是一个可直接作为数据目录内容使用的目录:
sudo -u postgres pg_basebackup \
  --pgdata=/srv/pgbackup/base-$(date -u +%Y%m%dT%H%M%SZ) \
  --format=plain \
  --wal-method=stream \
  --progress \
  --checkpoint=fast
--checkpoint=fast 会更快触发检查点,可能带来短时 I/O 压力。业务高峰期可以去掉该参数,或者安排在低峰时段执行。--wal-method=stream 会在备份期间同步传输所需 WAL,避免基础备份完成后缺少恢复所需日志。
物理基础备份不适合直接跨 PostgreSQL 大版本恢复。恢复前要核对源端和目标端版本、操作系统架构、扩展版本、表空间路径以及配置文件位置。需要跨大版本迁移时,通常采用逻辑导出导入或经过验证的升级工具,而不是直接替换数据目录。
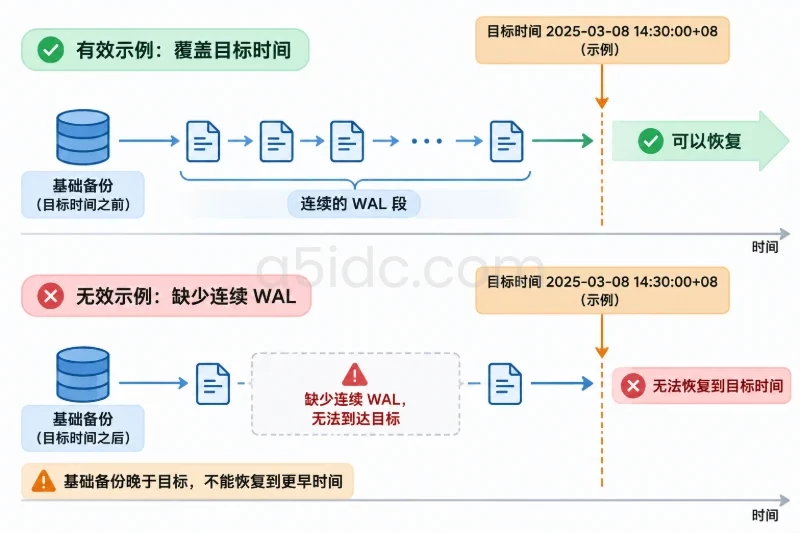
仅有一次基础备份,只能恢复到该基础备份对应的状态。要恢复到误操作前的某个时间点,还需要连续保存基础备份之后产生的 WAL。
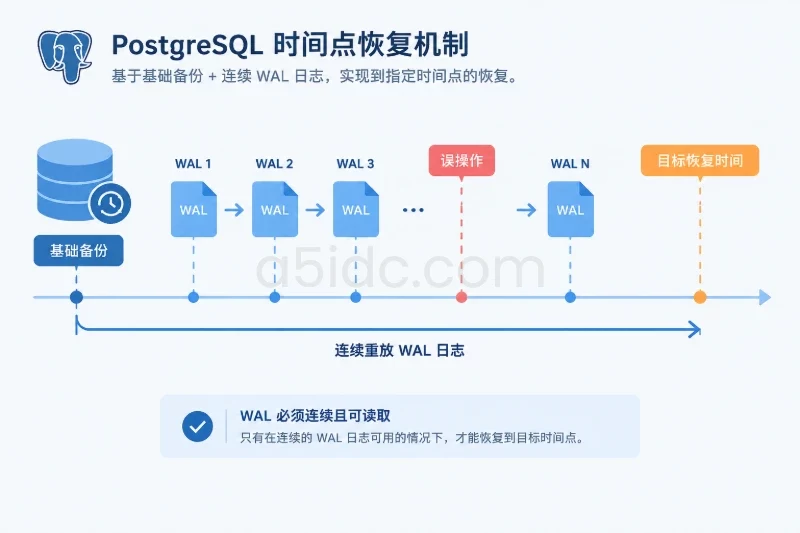
典型配置如下,归档目录必须位于独立磁盘或远端挂载位置,不能和数据库数据目录共用唯一存储设备:
wal_level = replica
archive_mode = on
archive_command = 'test ! -f /mnt/pgwal/%f && cp %p /mnt/pgwal/%f'
先创建目录并设置权限:
sudo install -d -o postgres -g postgres -m 0700 /mnt/pgwal
sudo -u postgres test -w /mnt/pgwal
archive_mode 和部分 WAL 相关参数可能需要重启服务才能生效,不能只执行 reload 就认为配置已经启用。修改前应记录原始配置,安排维护窗口,并确认归档目录具备足够容量。
配置加载后检查状态:
sudo -u postgres psql -x -c "
SELECT name, setting, context
FROM pg_settings
WHERE name IN ('wal_level', 'archive_mode', 'archive_command');
"

sudo -u postgres psql -x -c "
SELECT archived_count,
       failed_count,
       last_archived_wal,
       last_failed_wal,
       last_archived_time,
       last_failed_time
FROM pg_stat_archiver;
"
可以在低峰期切换一个 WAL 段,帮助检查归档链路:
sudo -u postgres psql -c "SELECT pg_switch_wal();"
如果 failed_count 持续增加,或者 last_archived_time 长时间不更新,不要继续依赖该归档链路进行时间点恢复。应先检查目录权限、磁盘空间、挂载状态和 archive_command 返回值。
备份命令退出码为 0 只是第一层检查,还应确认文件存在、大小合理、校验文件可以通过:
sudo -u postgres sha256sum -c \
  /srv/pgbackup/appdb-20250308T020000Z/SHA256SUMS
查看自定义格式备份是否包含预期对象:
sudo -u postgres pg_restore \
  --list \
  /srv/pgbackup/appdb-20250308T020000Z/appdb.dump \
  | sed -n '1,40p'
如果备份文件大小突然明显小于历史平均值,应检查是否误备份了错误数据库、是否使用了过滤参数,或者备份过程中发生了异常中断。不要只根据文件存在判断数据完整。
可以记录每次备份的开始时间、结束时间、文件大小、数据库总大小和 WAL 归档状态。例如:
sudo -u postgres psql -Atqc "
SELECT current_database(),
       pg_size_pretty(pg_database_size(current_database())),
       now();
"
恢复演练应在测试实例、临时虚拟机或独立容器中进行,不能直接覆盖生产库。先恢复全局对象,再创建空数据库:
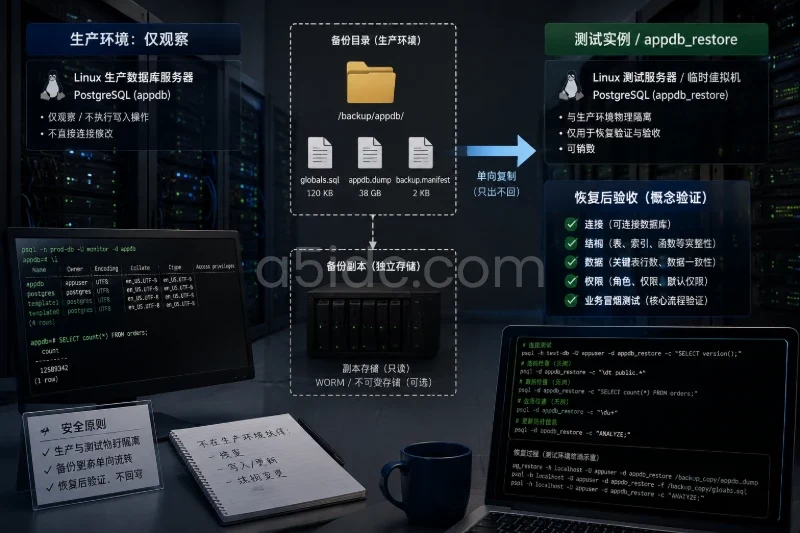
sudo -u postgres psql \
  --dbname=postgres \
  --set=ON_ERROR_STOP=1 \
  --file=/srv/pgbackup/appdb-20250308T020000Z/globals.sql

sudo -u postgres createdb \
  --template=template0 \
  appdb_restore
使用自定义格式恢复:
sudo -u postgres pg_restore \
  --dbname=appdb_restore \
  --exit-on-error \
  --verbose \
  --jobs=4 \
  /srv/pgbackup/appdb-20250308T020000Z/appdb.dump
--jobs=4 只是示例,应根据 CPU、磁盘和内存调整。并行恢复可能增加磁盘随机 I/O,不一定总比单线程快。
如果目标数据库已经存在,--clean --if-exists 会删除目标库中的同名对象,属于破坏性操作。只有在确认目标是专用恢复库、已经有额外备份并且接受覆盖范围时才使用。更稳妥的方式是创建全新的恢复数据库,不使用 --clean。
恢复完成后执行统计信息更新:
sudo -u postgres psql \
  --dbname=appdb_restore \
  --set=ON_ERROR_STOP=1 \
  --command="ANALYZE;"
可以从以下几个层面验证恢复结果:
示例查询如下,表名和字段需要替换成实际业务对象:
SELECT current_database(),
       current_user,
       pg_size_pretty(pg_database_size(current_database()));

SELECT count(*) AS order_count,
       max(updated_at) AS latest_update
FROM public.orders;

SELECT schemaname,
       sequencename,
       last_value
FROM pg_sequences
WHERE schemaname = 'public'
ORDER BY sequencename;

SELECT extname
FROM pg_extension
ORDER BY extname;
生产数据库在备份期间仍可能有持续写入,因此恢复库的行数与生产当前行数不一定完全相同。应使用备份时间点的业务基线进行比对,或者在演练时暂停写入后再做精确计数。
如果当前 PostgreSQL 版本提供 pg_amcheck,还可以对恢复库执行逻辑结构检查:
sudo -u postgres pg_amcheck \
  --database=appdb_restore \
  --progress
执行前先确认命令是否存在以及版本是否支持:
pg_amcheck --help
每次恢复演练都应记录:
这些记录用于判断实际 RTO 是否满足业务要求,也能暴露“备份能生成、但恢复过程过长”的问题。
先用 PostgreSQL 服务用户测试目录权限:
sudo -u postgres sh -c '
  test -r /srv/pgbackup &&
  test -w /srv/pgbackup &&
  echo backup-path-ok
'
不要通过 chmod 777 解决问题。备份文件可能包含敏感业务数据,目录应限制为数据库服务用户或专用备份用户访问。远程认证信息应放在权限为 0600 的密码文件中,不要写入命令行、cron 参数或公开日志。
pg_dump 需要获取一致性快照,某些 DDL 或长事务可能让它等待。可以查看当前会话:
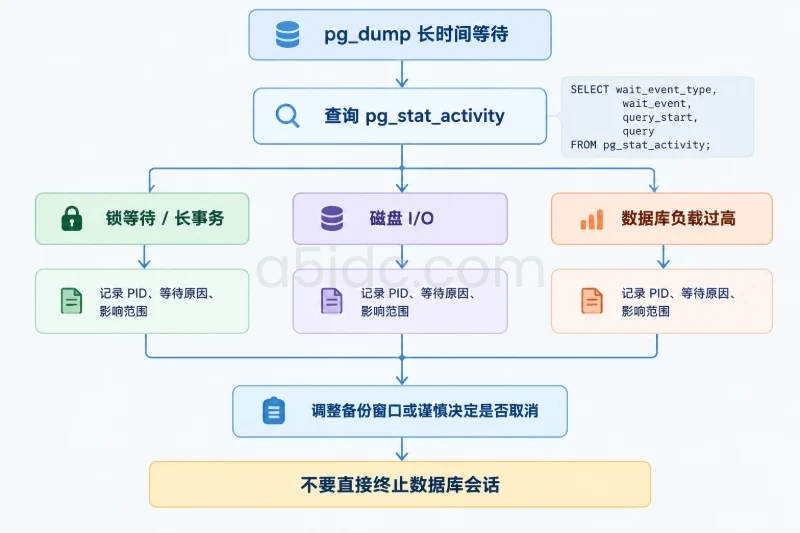
SELECT pid,
       usename,
       state,
       wait_event_type,
       wait_event,
       query_start,
       query
FROM pg_stat_activity
WHERE datname = 'appdb'
ORDER BY query_start;
先确认是锁等待、磁盘 I/O 还是数据库本身负载过高,再决定是否取消备份。直接终止数据库会话可能影响其他业务,应记录 PID、等待原因和影响范围。对于高峰期频繁发生的等待,应调整备份窗口或优化长事务,而不是反复强制终止。
常见原因是恢复顺序不正确、目标实例没有安装相应扩展,或者目标主机不存在原表空间路径。处理顺序如下:
globals.sql,确保角色和表空间定义存在;--no-owner;--no-owner 会改变对象归属,适合临时验证,不适合作为生产恢复的默认参数。
如果基础备份之后的 WAL 不完整,可能只能恢复到某个较早的有效时间点。不要手工跳过缺失 WAL,也不要在未验证前删除 recovery.signal 或直接提升实例。
应先检查:
pg_stat_archiver 中的失败次数和最后失败时间;如果无法补齐 WAL,应在恢复记录中明确可恢复到的最后时间点,并评估这段时间内的数据损失。
空间不足时,备份文件可能是残缺文件,不能继续作为有效备份使用。先查看空间和大文件:
df -h /srv/pgbackup /mnt/pgwal
du -xh --max-depth=2 /srv/pgbackup | sort -h | tail
清理前确认待删除对象属于备份目录,并且异地副本已经完成校验。不要删除 PostgreSQL 的 pg_wal 内容来释放空间;正在使用的 WAL 删除可能导致数据库无法启动或破坏恢复链路。
适合误删表、单库迁移、测试环境回滚或只需要恢复部分数据库对象的场景。建议先停止或切断测试应用连接,避免应用在恢复过程中写入目标库。
完整流程如下:
BACKUP_DIR="/srv/pgbackup/appdb-20250308T020000Z"

sudo -u postgres sha256sum -c "${BACKUP_DIR}/SHA256SUMS"

sudo -u postgres psql \
  --dbname=postgres \
  --set=ON_ERROR_STOP=1 \
  --file="${BACKUP_DIR}/globals.sql"

sudo -u postgres createdb \
  --template=template0 \
  appdb_restore

sudo -u postgres pg_restore \
  --dbname=appdb_restore \
  --exit-on-error \
  --verbose \
  --jobs=4 \
  "${BACKUP_DIR}/appdb.dump"

sudo -u postgres psql \
  --dbname=appdb_restore \
  --set=ON_ERROR_STOP=1 \
  --command="ANALYZE;"
确认恢复库通过连接、结构、权限和业务冒烟测试后,再决定是否切换应用连接。切换前要记录原连接配置;如果新库验证失败,应把应用连接恢复到原实例,而不是继续修改生产数据。
物理恢复会影响整个 PostgreSQL 实例,适用于整机故障、数据目录损坏或需要恢复全部数据库的场景。停止服务、移动数据目录和切换实例都属于高风险操作,必须先确认:
查出数据目录后,先停止实际服务。下面的命令仅适用于已确认服务名和路径的环境:
PGDATA="$(sudo -u postgres psql -Atqc 'SHOW data_directory;')"
printf 'PGDATA=%s\n' "$PGDATA"

sudo systemctl stop postgresql
不要直接删除原数据目录。可以将其改名保留,前提是父目录有足够空间:
sudo mv "$PGDATA" "${PGDATA}.before-restore-$(date -u +%Y%m%dT%H%M%SZ)"
sudo install -d -o postgres -g postgres -m 0700 "$PGDATA"
将已校验的 plain 格式基础备份复制到新数据目录:
sudo rsync -aH \
  /srv/pgbackup/base-20250308T020000Z/ \
  "$PGDATA/"
恢复到旧数据目录名称后,要检查目录所有者、外部配置文件、pg_hba.conf、表空间目录以及 SELinux 或 AppArmor 策略。先在验证环境启动,不要立即让业务接入。
如果要执行时间点恢复,在新数据目录中放置 recovery.signal,并配置可读取的 WAL 归档。PostgreSQL 12 及以后常见配置形式如下:
restore_command = 'cp /mnt/pgwal/%f %p'
recovery_target_time = '2025-03-08 10:20:00+00'
recovery_target_action = 'pause'
recovery_target_time 应明确时区,建议统一使用 UTC。启动后检查是否仍处于恢复状态:
sudo systemctl start postgresql

sudo -u postgres psql -x -c "
SELECT pg_is_in_recovery(),
       pg_last_wal_replay_lsn(),
       pg_last_xact_replay_timestamp();
"
当恢复到目标时间并暂停后,先执行数据和业务验证。验证实例如果只是用于检查,不要提升为主库。如果确认需要将其接替生产实例,再在维护窗口内执行提升,并同步修改应用连接、监控、备份任务和访问控制。
正式切换前至少保留以下回滚条件:
如果新实例验证失败,应停止应用写入并恢复原连接配置。不要在两个实例之间同时开放写入,否则容易形成数据分叉,后续无法简单合并。
pg_dump 或 pg_basebackup 的退出码、文件大小和 SHA-256 校验均正常。failed_count 没有持续增加,归档时间正常更新。本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5329.html