香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


进程监控里出现较大的 SHR,或 /proc/meminfo 中 Shmem 持续上升,并不等于发生了内存泄漏。共享页可能同时映射到多个进程,逐进程相加会重复计算;tmpfs、POSIX 或 System V 共享内存也会计入共享内存相关统计。判断是否异常,要同时看可用内存、交换活动、OOM 记录,以及占用是否持续增长。
排查时先区分“统计值看起来大”和“系统确实有内存压力”,再确认增长来自文件缓存、tmpfs/共享内存、进程映射还是容器限制。下面的命令以只读检查为主;示例数值仅用于说明判断方式,不代表某台实际服务器的检查结果。
先确认问题发生在宿主机、容器还是某个服务,并记录异常时间、业务负载和是否出现延迟、进程被杀等现象。相同的“共享内存偏高”,如果宿主机可用内存充足、服务正常,和容器已触及内存上限,处理方向完全不同。
free -h
grep -E '^(MemTotal|MemFree|MemAvailable|Buffers|Cached|Shmem|ShmemHugePages|SwapTotal|SwapFree):' /proc/meminfo
vmstat 1 5
cat /proc/swaps
重点看以下指标:
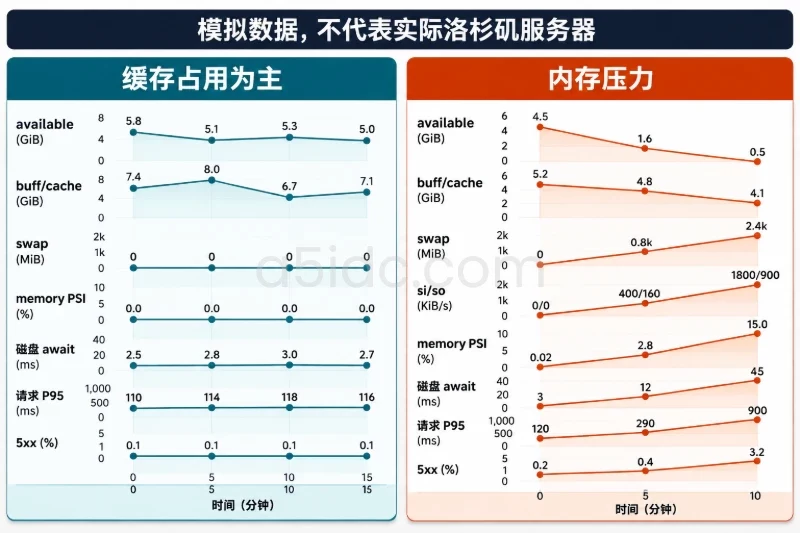
MemFree 更适合判断是否紧张。MemFree 很低不一定代表异常,内核会把空闲内存用于缓存。free 输出的各列简单相加,也不要将 shared 列理解为一块与 used 完全独立的内存。SwapFree 低不一定代表当前仍在剧烈换页。运行 vmstat 1 5 时重点观察后续采样行的 si、so;持续非零并伴随延迟,才更像正在发生交换压力。vmstat 的首行数据通常是开机以来的平均值。如果 MemAvailable 尚可、si/so 没有持续增长、没有 OOM 或明显性能下降,可以先判断统计口径和增长趋势,而不是立即清理共享内存。反过来,如果可用内存不断下降,并伴随交换、延迟或进程被杀,就需要继续定位占用来源。
| 观察到的现象 | 优先怀疑方向 | 下一步检查 |
|---|---|---|
Shmem 上升,某个 tmpfs 挂载点使用量也上升 | tmpfs 文件、共享内存对象或被删除但仍打开的文件 | 查看 tmpfs 挂载和使用量,检查 /dev/shm、进程文件描述符 |
Shmem 上升,但 /dev/shm 使用量不明显 | 其他 tmpfs、System V 共享内存、memfd 或容器内挂载 | 检查全部 tmpfs、ipcs、进程映射和容器 cgroup |
单个进程的 RSS 很高,但多个进程映射相同区域 | 共享页被 RSS 重复计数 | 查看 PSS、smaps_rollup 和映射文件 |
| 宿主机内存宽裕,容器或服务却 OOM | cgroup 内存上限或服务级限制 | 检查 memory.current、memory.max、memory.events |
内存问题与流量高峰相关,但 Shmem 不变 | 网络套接字缓冲区等内核内存,而非共享内存 | 查看 cgroup 的 sock 项和网络连接情况 |
| 某一服务的 PSS 或共享对象持续增长,负载回落后也不下降 | 服务或应用未释放映射、对象或缓存 | 对比进程映射、对象数量、服务指标和负载变化 |
Shmem 上升时,不要只检查 /dev/shm。tmpfs 可能挂载在 /run 或其他目录,容器也可能有自己的挂载;System V 共享内存、memfd 等对象也可能让目录用量无法解释全部变化。
findmnt -t tmpfs
df -hT /dev/shm /run
ipcs -m
ipcs -m -p
findmnt 用于列出 tmpfs 挂载,df 显示指定挂载点的容量和已用空间。若发现其他 tmpfs 挂载点,应针对该路径再运行 df -hT <路径>。/dev/shm 的容量上限不等于已占用量,也不能代表全机的共享内存总量。
ipcs -m 可查看 System V 共享内存段的大小、状态和附加数量;ipcs -m -p 可提供创建者及最近操作进程等线索。需要注意:
Shmem、进程映射和内存压力一起判断。nattch 为零或创建进程已经退出,不足以单独证明该段无用。共享内存段可能在进程退出后仍然存在。ipcs 显示的创建者或最近操作进程,不一定是当前所有使用者。如果 df 显示 tmpfs 用量明显低于预期,但 Shmem 仍很高,可能是其他挂载点、System V 段,或目录中已经删除但仍被进程打开的对象。可在安装了 lsof 的系统上检查:
sudo lsof +L1
该命令会列出仍被打开但已从目录中删除的文件。对于具体进程,还可以查看其文件描述符和映射:
ls -l /proc/1234/fd
grep -E '/dev/shm|memfd:|SYSV' /proc/1234/maps
将 1234 替换为目标 PID。/proc/<PID>/maps 中的路径可以帮助发现 /dev/shm、memfd 或 System V 映射,但映射存在不代表其中所有页面当前都驻留在内存中。
如果系统使用显式大页,也应区分普通共享内存和 hugetlb 大页:
grep -E '^(HugePages|Hugepagesize|Hugetlb|ShmemHugePages):' /proc/meminfo
大页相关字段的统计口径与普通内存不同,不能只凭 Shmem 一个数下结论。
top、ps 中的 SHR 或 RSS 适合筛查进程,但不适合直接相加后当作全机实际占用。多个进程映射同一页时,这一页可能分别计入每个进程的 RSS。PSS 会按映射进程数分摊共享页,通常更适合比较进程的实际内存贡献。
先找出 RSS 较高的进程:
ps -eo pid,ppid,user,comm,rss,vsz --sort=-rss | head
针对可疑 PID 查看汇总映射信息:
awk '/^(Rss|Pss|Shared_Clean|Shared_Dirty|Private_Clean|Private_Dirty):/' \
  /proc/1234/smaps_rollup
smaps_rollup 在较老的内核上可能不存在,可改为检查 /proc/1234/smaps。读取大量进程的 smaps 可能增加诊断开销,建议先筛选目标进程;权限不足时可在授权范围内提升读取权限。
判断时可以按以下方式推理:
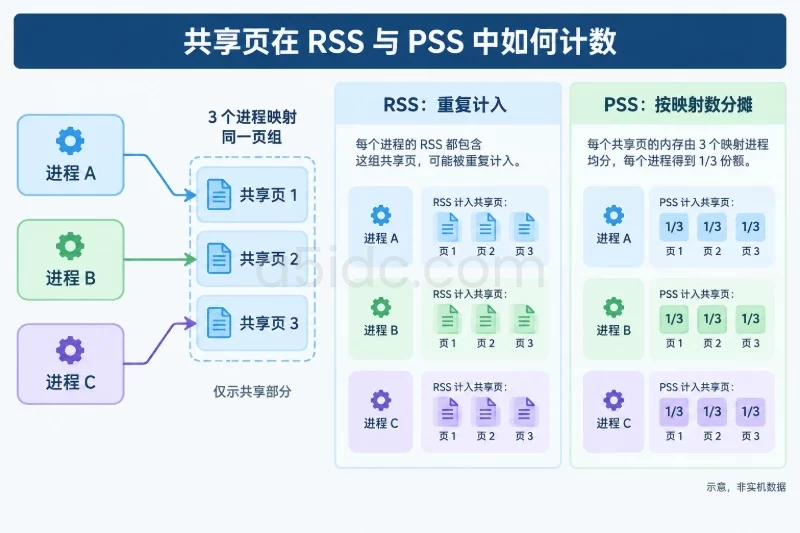
RSS 都很高,但它们的 PSS 明显低于各自的 RSS,且映射指向相同对象,说明共享页重复计数可能是主要原因。PSS、Private_Dirty 持续增长,更应检查该进程的私有分配,而不只是共享内存。Shared_Clean 或 Shared_Dirty 较高,只能说明有共享映射,不能单独证明这些页都属于 tmpfs 或发生了泄漏。容器内的 free -h 或 /proc/meminfo 不能总是准确反映它的内存上限。宿主机还有空闲内存,也不代表容器没有触及自己的限制。先查看进程所属 cgroup:
cat /proc/1234/cgroup
在 cgroup v2 的常见环境中,输出可能含有 0::/system.slice/example.service。若挂载点为 /sys/fs/cgroup,可据此检查对应目录;以下路径仅为示例:
CG=/sys/fs/cgroup/system.slice/example.service
cat "$CG/memory.current" "$CG/memory.max" "$CG/memory.events"
grep -E '^(anon|file|shmem|sock|file_mapped):' "$CG/memory.stat"
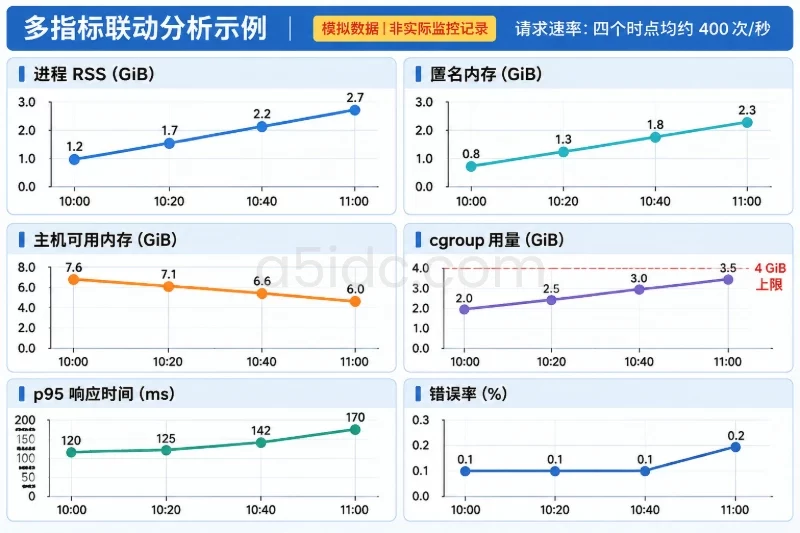
memory.current 是该 cgroup 当前计入的内存用量,memory.max 是上限;值为 max 表示未设置该项固定上限。memory.events 中的 max、oom、oom_kill 等计数如果在故障期间增加,说明限制或 OOM 事件值得重点调查。memory.stat 的 shmem 是 cgroup 内共享内存相关统计,file 与 shmem 等项目存在包含关系,不应把这些行机械相加。也可按服务名称查询 systemd 报告的内存值,再与 cgroup 文件核对:
systemctl show example.service -p MemoryCurrent -p MemoryMax
如果进程映射和 cgroup 内存都正常,但故障与网络流量高峰同步,检查是否误把网络套接字缓冲区当成了共享内存。cgroup 的 memory.stat 中若 sock 增长而 shmem 稳定,更应转向连接数、缓冲区和流量方向排查。套接字内存属于内核网络内存,不应直接归因于共享映射。
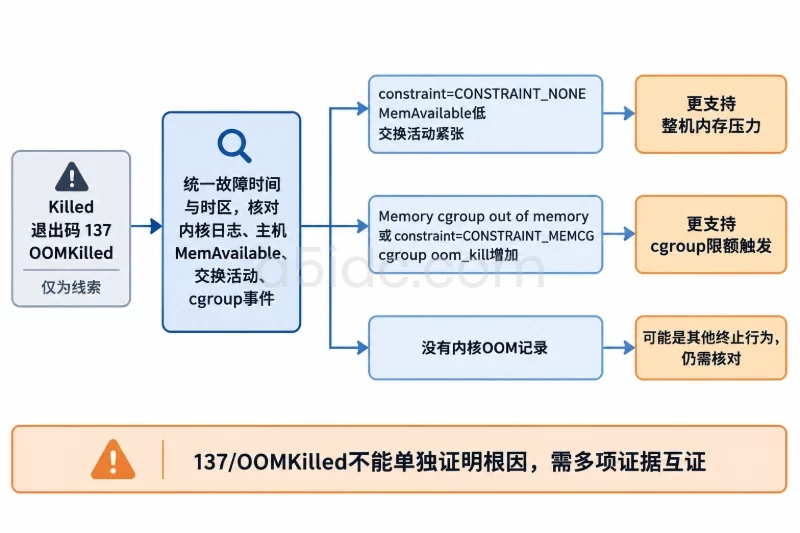
查看内核日志是否在异常时段记录过 OOM:
journalctl -k --since "1 hour ago" | grep -Ei 'out of memory|oom|killed process'
若系统没有 journalctl,或日志未保留,可在权限允许时检查:
dmesg -T | grep -Ei 'out of memory|oom|killed process'
宿主机 OOM 与 cgroup OOM 的证据不同。若日志指出某个容器进程被杀,而宿主机 MemAvailable 仍较高,应优先核对该容器的 memory.max 和 memory.events,而不是据此认定宿主机内存泄漏。
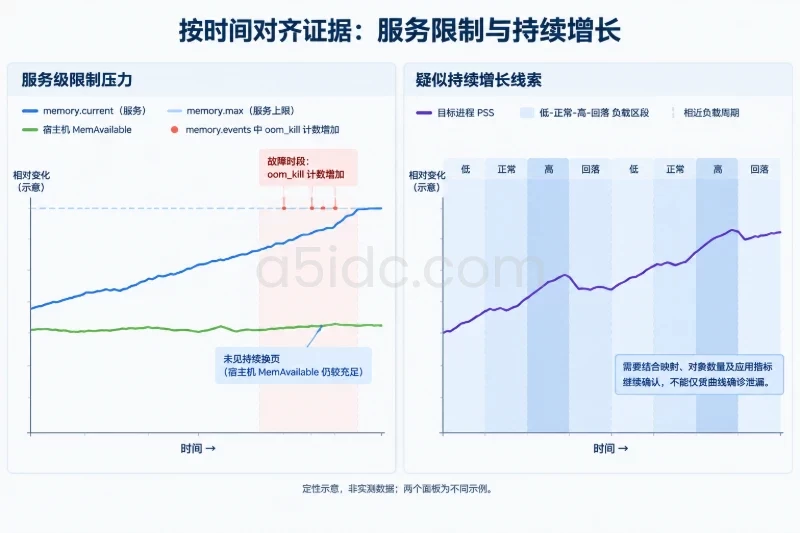
诊断的关键是把几项指标按时间对齐,而不是只比较某个瞬时数值:Shmem、tmpfs 使用量、System V 段、目标进程的 PSS、cgroup 用量,以及业务负载和 OOM 时间点。可以在固定采样间隔下记录这些数据,并覆盖低负载、正常负载和问题时段。
例如,某次模拟检查中宿主机仍有较多 MemAvailable,但某个服务 cgroup 的 memory.current 接近 memory.max,memory.events 的 oom_kill 在故障时增加,而宿主机没有持续换页。这组证据指向服务级内存限制,不能简单归因为全机共享内存泄漏。
另一个示例是:Shmem 持续增长,/dev/shm 用量却稳定,ipcs -m 显示一个长期存在的共享内存段,多个服务进程的映射都指向该段。此时应确认该对象的所有者、用途和生命周期,再检查应用是否按预期释放或复用它。不能因为创建进程已经退出,就直接假定该段可以删除。
判断内存泄漏时,重点看在相同或相近负载下是否持续单调增长,以及负载下降后占用是否仍不回落。一次高峰可能是正常缓存或业务峰值;多个周期都持续增长,并且能对应到某个进程的 PSS、tmpfs 对象数量或共享段变化,才是更有力的根因线索。应用的共享对象、文件描述符和内部缓存也可能在服务存活期间不断积累,需要结合应用自身的运行指标和日志分析。
找到原因并完成修复后,至少确认以下变化:
Shmem、tmpfs 使用量或目标进程 PSS 不再持续上升。memory.current 与其上限保持合理距离,memory.events 的 OOM 相关计数不再增加。MemAvailable、交换活动、服务延迟和进程状态恢复到该环境的正常范围。不要用清空缓存来验证是否存在泄漏。drop_caches 会改变系统缓存状态,但无法修复对象未释放或服务持续分配的问题;直接删除 System V 共享内存段也可能破坏正在使用该对象的进程。重启服务或删除对象即使暂时降低了占用,也只能作为受控处置,不能替代根因确认。
复发监控应至少覆盖 MemAvailable、Shmem、交换读写、进程 PSS、tmpfs 用量、cgroup memory.current 与 OOM 事件。阈值应结合服务器基线、服务内存上限和业务负载设置;例如,可将 cgroup 用量接近上限作为预警,将 OOM 计数增长作为需要立即处理的信号。与其只设一个固定的“共享内存过高”阈值,不如同时观察占用变化速度、持续时间和系统压力。
面对数据库、业务后台及多进程服务等需要关注内存资源的场景,A5数据提供中国香港、美国、日本等多地区物理服务器,产品覆盖不同CPU平台、内存容量及SSD/NVMe存储组合,可为共享内存相关服务、缓存和数据读写负载提供硬件资源基础;不同地区的网络线路选择也便于结合业务访问范围进行部署。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5287.html