香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


判断 Linux 软件 RAID 的元数据是否异常,不能只看 cat /proc/mdstat 是否显示阵列名称。mdstat 主要反映内核当前的运行状态,无法完整说明每个成员盘上的超级块、阵列 UUID、事件计数和设备角色。更可靠的判断需要把阵列状态与成员盘元数据交叉核对。
已组装阵列优先使用 mdadm --detail,未组装或需要逐块确认时使用 mdadm --examine。通常还要结合 lsblk、/proc/mdstat 以及必要的内核日志,判断是元数据不一致、阵列降级,还是设备名称变化、同步过程等正常现象。
Linux md 阵列会在成员设备上保存元数据,通常称为 md superblock。元数据中包含多个关键字段:
而 /proc/mdstat 展示的是内核当前是否组装阵列、阵列是否降级,以及是否正在恢复、重同步或一致性检查。
因此,下面几种现象不能直接画等号:
| 现象 | 能说明什么 | 不能单独说明什么 |
|---|---|---|
/proc/mdstat 显示 md0 | 内核当前识别到一个 md 阵列 | 每个成员的元数据都正确 |
mdadm --detail 显示 State : clean | 当前阵列没有记录中的活动同步或降级 | 磁盘没有硬件故障或数据没有静默错误 |
mdadm --examine 显示 UUID | 设备上存在可识别的 md 元数据 | 该设备当前一定属于正在运行的阵列 |
一个成员显示 linux_raid_member | 文件系统识别到 md 成员标记 | 成员一定健康,也不代表阵列已经组装 |
[UU] | 当前阵列需要的成员均处于在线状态 | 元数据、文件系统和业务数据全部正常 |
State : clean 是阵列运行层面的结果,不是对所有成员盘进行完整数据校验的结论。判断元数据是否异常,必须同时观察阵列级信息和成员级信息。
mdadm --detail 与 mdadm --examine 的区别两条命令的检查对象不同:
mdadm --detail /dev/md0:检查已经组装的阵列设备;mdadm --examine /dev/sdb1:直接读取某个成员设备上的 md 元数据;mdadm --detail --scan:列出当前已经组装的阵列配置摘要;mdadm --examine --scan:扫描可见设备上的 md 元数据并生成识别结果。如果 /dev/md0 不存在,mdadm --detail /dev/md0 报错并不等于成员盘没有元数据。此时应先识别块设备,再逐个检查可能的成员分区。
常见的 md 元数据版本包括 0.90、1.0、1.1 和 1.2。1.x 元数据通常会在输出中显示 Version : 1.2 等信息,但不同版本的超级块位置不同:
这会影响成员设备上其他数据的布局,也影响检查时应该选择整块磁盘还是分区。生产环境中常见的是在分区上创建阵列,例如 /dev/sda1、/dev/sdb1;也有阵列直接使用 /dev/sda、/dev/sdb。
因此不要根据设备名称猜测检查对象。先执行:
sudo lsblk -p -o NAME,PATH,SIZE,TYPE,FSTYPE,UUID,MOUNTPOINTS
如果输出显示:
NAME         SIZE TYPE FSTYPE            UUID                                 MOUNTPOINTS
/dev/md0     900G raid1 ext4             8d9f...                              /data
├─/dev/sda1  900G part linux_raid_member 6c4a...
└─/dev/sdb1  900G part linux_raid_member 6c4a...
那么应检查 /dev/sda1 和 /dev/sdb1,而不是只检查 /dev/sda 和 /dev/sdb。
同一个阵列的成员通常具有相同的阵列 UUID。Device Role 用来表示成员在阵列中的角色,例如 RAID1 中的活动设备 0 和活动设备 1。Events 是元数据中的事件计数,用来反映成员参与阵列更新的大致进度。
一个典型的 RAID1 成员元数据可能类似下面的示例:
/dev/sda1:
          Magic : a92b4efc
        Version : 1.2
      Raid Level : raid1
      Array Size : 976630336
    Device Size : 976630336
   Raid Devices : 2
  Used Dev Size : 976630336
     Update Time : Tue Jan 16 10:20:31 2024
           State : active
  Device Role : Active device 0
  Array State : AA
        Events : 1250
         UUID : 6c4a7e2b:91aa3b10:4c9d2d44:6f08a5c1
       Checksum : 8c2e9a11 - correct
检查时重点关注以下关系:
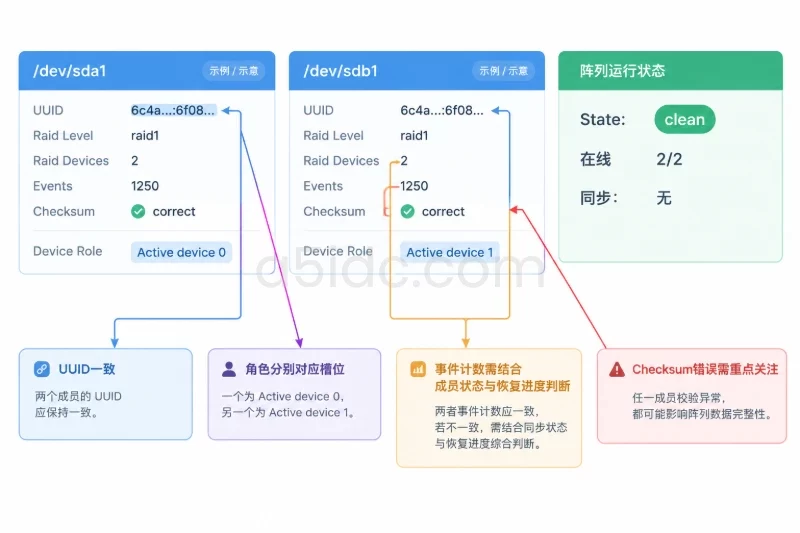
UUID 应一致;Raid Level 和 Raid Devices 应符合当前阵列设计;Device Role 不应出现无法解释的重复或缺失;Events 应结合成员状态、更新时间和是否正在恢复来判断;Checksum 如果明确显示错误,应视为重要异常信号;Device Size 或 Used Dev Size 不能小于阵列要求的有效成员大小;Array State 应与阵列当前运行状态相互印证。Events 不一定要求每次检查都完全相同。例如某个成员刚被重新加入阵列,或阵列正在进行恢复时,事件计数可能暂时落后。事件计数不同本身不能直接证明元数据损坏,但“计数明显落后 + 成员处于活动角色 + 阵列降级”通常需要进一步处理。
Array State 的字符不能脱离上下文解释在 mdadm --examine 输出中,Array State 可能出现类似:
Array State : AA
或者:
Array State : A_
通常可以把 AA 理解为两个成员均被记录为活动状态,把 A_ 理解为一个成员活动、另一个成员缺失。但不同 mdadm 版本和不同 RAID 级别的输出说明可能略有差异,具体字符含义应以该命令输出中的解释为准。
RAID5、RAID6 和 RAID10 的成员角色更复杂,不能简单把 AAA 或某个字符数量直接当作可用容量或容错数量。判断时应先读取 Raid Level、Raid Devices 和 Device Role,再结合阵列级状态。
系统重启后,SATA 设备可能从 /dev/sdb 变成 /dev/sdc,NVMe 设备也可能因硬件枚举顺序发生变化。设备名称变化本身不能证明成员盘被替换。
更适合用于长期核对的是:
ls -l /dev/disk/by-id/
ls -l /dev/disk/by-path/
如果设备的序列号、路径和元数据 UUID 均能对应,只是短设备名发生变化,通常属于设备枚举顺序变化。
同样,阵列设备显示为 /dev/md127 而不是 /dev/md0,也不一定代表元数据异常。名称可能受到自动组装规则、发行版配置和启动时发现顺序影响。应以 UUID、成员关系和运行状态为主要判断依据。
一个常见误判是直接检查文件系统所在的 /dev/md0:
sudo mdadm --examine /dev/md0
这不是逐个检查成员盘的正确方式。mdadm --examine 更适合读取成员设备,例如:
sudo mdadm --examine /dev/sda1
sudo mdadm --examine /dev/sdb1
如果阵列之上还有 LVM 或文件系统,层次可能是:
物理磁盘 → 分区 → md 阵列 → LVM → 文件系统
此时成员元数据在分区上,文件系统 UUID 则位于阵列设备或逻辑卷上。用错误层级检查,得到“没有 md superblock”并不能说明阵列元数据消失。
阵列刚组装、成员重新加入、系统异常关机或设备短暂离线后,可能进入 resync、recovery 或 check 状态。此时:
Events 可能暂时不同;Array State 可能尚未恢复到最终状态;/proc/mdstat 可能显示进度和剩余时间;这种情况需要判断同步是否有合理触发原因、进度是否前进、是否同时出现 I/O 错误。不能因为存在 recovery 就立即认定元数据损坏。
以下命令均属于读取或展示信息的操作,不会创建阵列、加入成员或清除超级块。建议先记录结果,再做进一步判断。
sudo lsblk -p -o NAME,PATH,SIZE,TYPE,FSTYPE,UUID,PARTUUID,MOUNTPOINTS
重点确认:
raid 类型;linux_raid_member;如果 lsblk 没有显示 linux_raid_member,也不要立即下结论。某些元数据版本、外部元数据容器或识别工具版本可能导致显示差异,后续应以 mdadm --examine 为准。
cat /proc/mdstat
一个运行正常的 RAID1 示例:
Personalities : [raid1]
md0 : active raid1 sdb1[1] sda1[0]
      976630336 blocks super 1.2 [2/2] [UU]
unused devices: <none>
重点看以下内容:
active raid1:内核已组装并运行该阵列;[2/2]:需要的两个成员当前均在线;[UU]:两个成员都处于在线位置;recovery、resync、check:是否正在执行同步或检查;faulty、removed、failed 等状态。降级示例:
md0 : active raid1 sda1[0]
      976630336 blocks super 1.2 [2/1] [U_]
这表示阵列设计需要两个成员,但当前只有一个成员在线。它属于阵列可用性异常或降级状态,不一定等同于超级块损坏,仍需检查缺失成员的元数据和硬件日志。
sudo mdadm --detail /dev/md0
如果系统显示的是 /dev/md127,应替换为实际路径:
sudo mdadm --detail /dev/md127
典型输出中的关键字段如下:
Version : 1.2
Raid Level : raid1
Array Size : 976630336
Raid Device : 2
Total Devices : 2
State : clean
Active Devices : 2
Working Devices : 2
Failed Devices : 0
Spare Devices : 0
可以按下面的标准初步判断:
| 输出字段 | 较正常的表现 | 需要关注的表现 |
|---|---|---|
Raid Level | 与设计一致 | 与预期不符,可能检查错阵列 |
Raid Devices | 与规划成员数量一致 | 数量不一致或识别不完整 |
State | clean 或正常活动状态 | degraded、recovering、failed |
Active Devices | 等于应在线成员数 | 小于设计数量 |
Working Devices | 与当前可工作的设备数相符 | 少于预期 |
Failed Devices | 0 | 大于 0 |
Spare Devices | 符合规划 | 备盘意外进入活动或失效状态 |
State : clean 是一个积极信号,但还需要逐块执行 --examine。因为阵列当前可能已经组装成功,某个成员却保留了旧阵列 UUID、较旧事件计数或异常角色信息。
根据第一步识别出的设备执行:
sudo mdadm --examine /dev/sda1
sudo mdadm --examine /dev/sdb1
也可以对多个已确认的成员逐个读取:
for dev in /dev/sda1 /dev/sdb1; do
    echo "===== $dev ====="
    sudo mdadm --examine "$dev"
done
重点对比:
Version 是否一致或符合阵列设计;Raid Level 是否一致;Raid Devices 是否一致;Array Size、Used Dev Size 是否接近;UUID 是否相同;Device Role 是否分别对应不同槽位;Events 是否存在明显落后;State 和 Array State 是否互相矛盾;Checksum 是否被标记为正确。如果需要便于脚本化或保存结果,可以使用:
sudo mdadm --examine --export /dev/sda1
该形式会输出键值对,适合批量比较。但字段名称和完整输出内容可能因 mdadm 版本不同而变化,不能假设所有发行版都提供完全相同的字段。
检查成员盘能识别到哪些阵列:
sudo mdadm --examine --scan
检查当前已经组装的阵列摘要:
sudo mdadm --detail --scan
两条命令的结果用途不同:
--examine --scan 偏向成员盘发现结果;--detail --scan 偏向当前运行阵列的配置摘要。如果前者能看到某个 UUID,而后者没有对应阵列,可能表示成员盘有元数据但阵列尚未组装,也可能表示设备当前不可用、路径不完整或属于旧阵列。此时不要直接使用强制组装命令,应继续核对所有成员。
对已存在的 /dev/md0,可以读取 sysfs 中的状态:
cat /sys/block/md0/md/array_state
cat /sys/block/md0/md/degraded
cat /sys/block/md0/md/sync_action
常见含义是:
array_state:阵列当前状态;degraded:缺失或不可用成员数量;sync_action:当前是 idle、resync、recover、check 等操作。部分系统还提供一致性检查计数:
cat /sys/block/md0/md/mismatch_cnt
mismatch_cnt 非零说明一致性检查发现了数据副本之间的差异,但它不是超级块校验结果,也不能单独说明哪块盘损坏。应结合 RAID 级别、检查操作类型、日志和备份情况判断。
必要时查看当前启动周期的内核日志:
sudo journalctl -k -b | grep -Ei 'md|raid|I/O error|ata|nvme'
也可以在部分系统中使用:
sudo dmesg -T | grep -Ei 'md|raid|I/O error|ata|nvme'
如果日志中出现设备重置、I/O error、链路中断、超时或介质错误,而元数据 UUID 和角色仍然一致,那么问题更可能在磁盘、控制器、线缆或供电层面,而不是 UUID 本身异常。
检查结果如下:
mdadm --detail:State : clean;Active Devices 等于 Raid Devices;Failed Devices : 0;/proc/mdstat 显示 [UU],没有异常恢复;Device Role 分别为 0 和 1;可以判断:从 mdadm 元数据和当前阵列状态看,没有发现明显异常。这个结论不等于磁盘健康检查和文件内容校验已经完成。
如果 mdstat 显示:
md0 : active raid1 sdb1[1] sda1[0]
      976630336 blocks super 1.2 [2/2] [UU]
      [=====>...............]  recovery = 27.4% ...
同时 mdadm --detail 显示 State : recovering,两个成员 UUID 相同,角色正确,日志中没有持续 I/O error,那么更可能是成员刚重新加入或系统正在完成同步。
此时应观察恢复进度是否持续变化,不要因为出现 recovering 就执行重新创建或清除元数据的操作。
如果两个成员都显示同一 UUID,但结果类似:
/dev/sda1:
  Device Role : Active device 0
  Events : 1250

/dev/sdb1:
  Device Role : Active device 1
  Events : 1190
并且阵列当前显示降级或正在恢复,那么 /dev/sdb1 可能是旧状态成员、曾经离线的成员或尚未完成同步的成员。此时应结合:
State 和 Array State;mdstat 的同步进度;不能只根据事件计数差异就执行 --add、--assemble --force 或清除超级块。
如果预期属于同一阵列的设备出现不同 UUID,或者输出明确显示:
Checksum : ... - incorrect
这属于高风险信号。可能原因包括:
在确认设备身份、备份和阵列拓扑之前,不要执行 mdadm --zero-superblock、mdadm --create、强制组装或覆盖式修复。这些操作可能破坏仍可用于恢复的数据和元数据,且回滚并不简单。
A5数据提供香港、日本等地区的物理服务器资源,覆盖SSD、NVMe及大容量企业级机械硬盘方案,可为Linux阵列承载的数据库、业务后台、文件存储、备份与归档场景提供硬件基础。香港存储系列配备多块大容量硬盘与H730控制器,日本部分方案则提供大容量HDD或多块SSD,并可结合不同地区的网络线路与服务器配置部署相应业务环境。
mdadm --examine 主要读取超级块,无法替代硬盘健康检查、坏道检查和持续 I/O 监控。磁盘可能能够正确返回超级块,但在大量读写时出现超时或介质错误。
RAID1、RAID5、RAID6 和 RAID10 的数据一致性机制不同。阵列显示在线,只能说明当前结构满足一定的组装和运行条件。若需要确认数据副本一致性,还要关注 check 结果、mismatch_cnt、文件系统检查策略和备份恢复能力。
某些硬件或固件环境可能使用 IMSM、DDF 等外部元数据形式。此时会出现容器、成员阵列等额外层级,mdadm --examine 的输出结构和判断方式可能不同。应先确认:
mdadm --version
sudo mdadm --help
再根据实际输出和发行版文档判断,不要把普通 RAID1 成员的字段解释直接套用到外部容器。
/etc/mdadm.conf 或发行版中的其他 mdadm 配置文件,主要用于启动时识别和组装。它可能过期、缺少新阵列记录,或者保留旧 UUID。判断当前状态时,应优先以:
/proc/mdstat;mdadm --detail;mdadm --examine;这几类实时或直接读取结果为准,再核对配置文件是否需要更新。
实际检查时,可以把结论分成三类:元数据关系正常、阵列运行降级但元数据尚可解释、元数据身份或校验存在高风险异常。只有第一类可以初步认为阵列信息没有明显问题;第二类需要观察同步、日志和硬件状态;第三类应先保留现场和数据,避免用创建、清除或强制组装命令覆盖原有信息。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5254.html