香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


云快照恢复为新磁盘后,先在云平台确认新磁盘已经创建并挂载到目标云主机,再在系统内识别实际设备名称、分区表和文件系统。不要直接假定新磁盘一定是 /dev/vdb,也不要在尚未确认设备的情况下执行格式化或写入操作。较稳妥的顺序是:识别磁盘 → 核对分区 → 判断文件系统层级 → 以只读方式临时挂载 → 验证数据 → 再决定是否长期挂载或切换业务。
如果恢复的是数据盘,通常不需要处理 GRUB、EFI 或启动顺序,重点是分区、文件系统、UUID 和 /etc/fstab。如果恢复的是系统盘,还要额外检查根分区、/boot、EFI 系统分区、LVM 或加密层,以及云主机当前使用 BIOS 还是 UEFI 启动模式。快照本身也不等于应用一致性备份,数据库、多块磁盘和正在写入的业务,需要单独核对备份范围与恢复时间点。
在控制台操作前,记录以下信息:
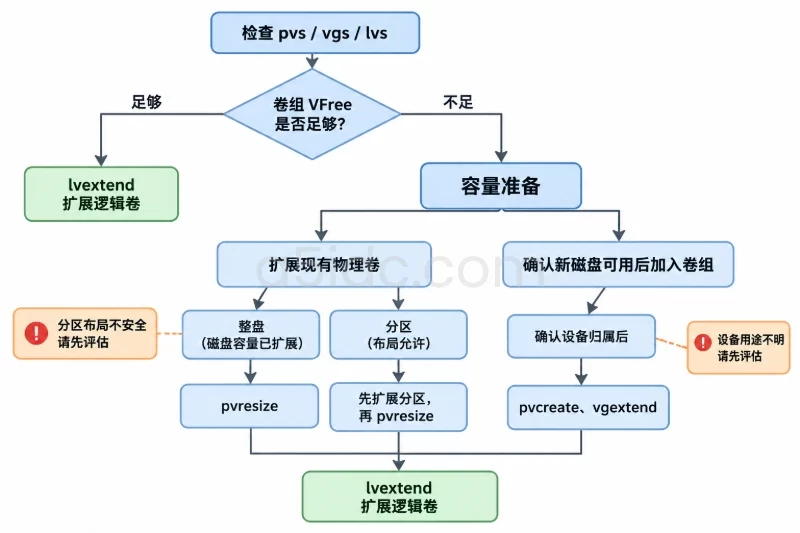
恢复新磁盘时,容量通常不能小于源磁盘。如果云平台允许从快照创建更大的磁盘,新增空间也不一定会自动出现在文件系统中,可能还需要后续扩展分区、LVM 逻辑卷和文件系统。扩容属于写入操作,应在数据验证完成、原磁盘仍可回退的前提下进行。
快照覆盖范围也要单独核对。单块磁盘快照只能保证该磁盘在某个时间点的块级状态,不能自动保证其他磁盘、数据库事务日志、对象存储文件或外部配置与它处于同一时间点。
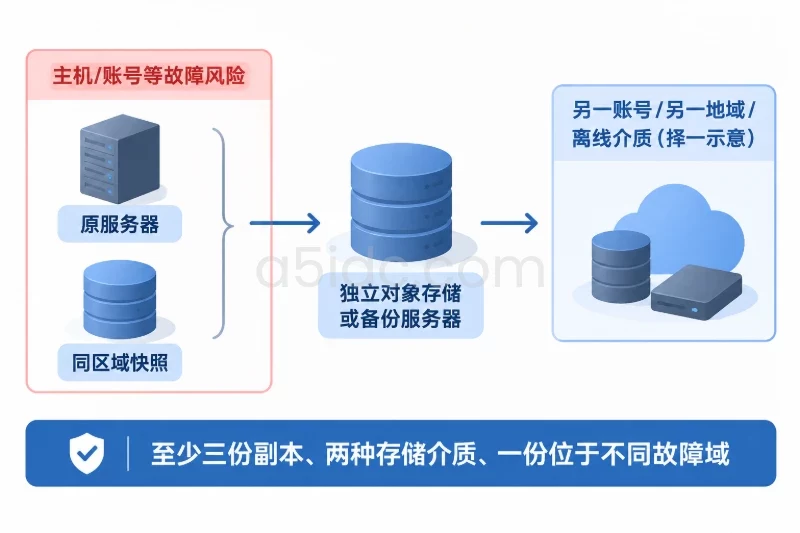
日常备份至少要明确五个维度:
| 项目 | 核对内容 | 对恢复挂载的影响 |
|---|---|---|
| 备份范围 | 系统盘、业务数据盘、数据库逻辑备份、配置和密钥是否分别覆盖 | 只恢复数据盘可能无法恢复完整业务 |
| 备份频率 | 按 RPO 确定快照或备份间隔 | 间隔越大,恢复后可能缺少更多业务数据 |
| 一致性 | 崩溃一致性、文件系统一致性或应用一致性 | 数据库可能需要日志回放或逻辑备份 |
| 保留周期 | 是否覆盖故障发现延迟和审计周期 | 最新快照不一定是正确的恢复点 |
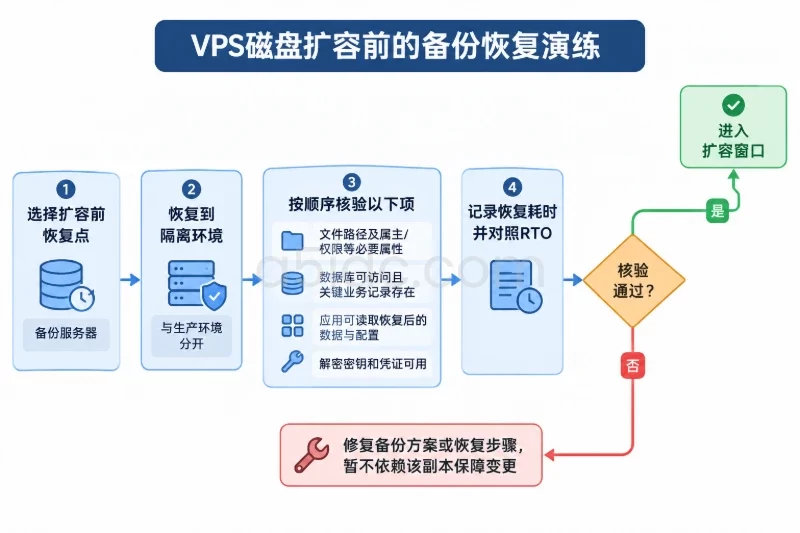
| 恢复演练 | 是否真正创建新磁盘并完成挂载、校验和业务启动 | 只确认“快照存在”不能证明可以恢复 |
对数据库而言,磁盘快照适合用于整体恢复或特定恢复点,但不能替代数据库自身的逻辑备份、归档日志或事务日志策略。创建快照前,尽量按照数据库类型执行刷盘、备份窗口或应用暂停;如果无法暂停,应明确这是崩溃一致性快照,并在恢复后执行数据库级别的完整性检查。
不要一开始就把恢复盘挂到生产目录,例如 /data、/var/lib/mysql 或 /var/lib/postgresql。挂载到已有目录后,原目录中的文件会被挂载点隐藏,容易误判“数据已经被替换”或“原数据丢失”。
可以先创建独立目录:
sudo mkdir -p /mnt/restore-disk
sudo chmod 700 /mnt/restore-disk
如果目录中已经存在重要文件,先确认目录内容并记录。创建挂载点不会改动恢复盘,但后续的 mount、fsck、扩容和 UUID 修改可能影响磁盘状态。
新磁盘附加后,先查看块设备、分区、文件系统和挂载点:
sudo lsblk -o NAME,PATH,SIZE,TYPE,FSTYPE,LABEL,UUID,PARTUUID,MOUNTPOINTS
再检查内核识别信息:
sudo blkid
sudo dmesg --ctime | tail -n 50
输出中重点区分以下对象:
TYPE=disk:整块磁盘,例如 /dev/vdc。TYPE=part:磁盘分区,例如 /dev/vdc1。TYPE=lvm 或 /dev/mapper/...:LVM 逻辑卷,不应直接把底层 PV 当作普通文件系统挂载。crypto_LUKS:加密容器,需要先解锁,再识别内部文件系统。linux_raid_member:软件 RAID 成员,不应直接挂载成员设备。FSTYPE=ext4、xfs、btrfs 等:可以根据文件系统类型选择挂载和检查命令。设备名可能因附加顺序变化。旧磁盘原来是 /dev/vdb,恢复盘可能变成 /dev/vdc,也可能使用云平台提供的持久化设备路径。后续命令应以 lsblk 和 blkid 的实际结果为准。
如果 lsblk 显示新磁盘没有分区,先不要执行 mkfs 或重新分区。使用只读查看命令确认分区表:
sudo fdisk -l /dev/vdc
sudo parted -s /dev/vdc print
需要确认:
/dev/vdc1、/dev/vdc2。/boot 分区、LVM 分区或加密分区。如果快照来源是一个直接格式化、没有分区表的数据盘,文件系统可能直接位于 /dev/vdc;如果来源磁盘采用分区布局,则通常应挂载 /dev/vdc1 或对应的逻辑卷,而不是整块 /dev/vdc。
可以用以下方式进一步确认签名:
sudo file -sL /dev/vdc
sudo file -sL /dev/vdc1
看到 data 不代表磁盘为空,可能是加密容器、LVM PV 或 RAID 成员。此时继续格式化会破坏恢复内容。
恢复盘不是任何情况下都能直接挂载。常见的层级顺序可能是:
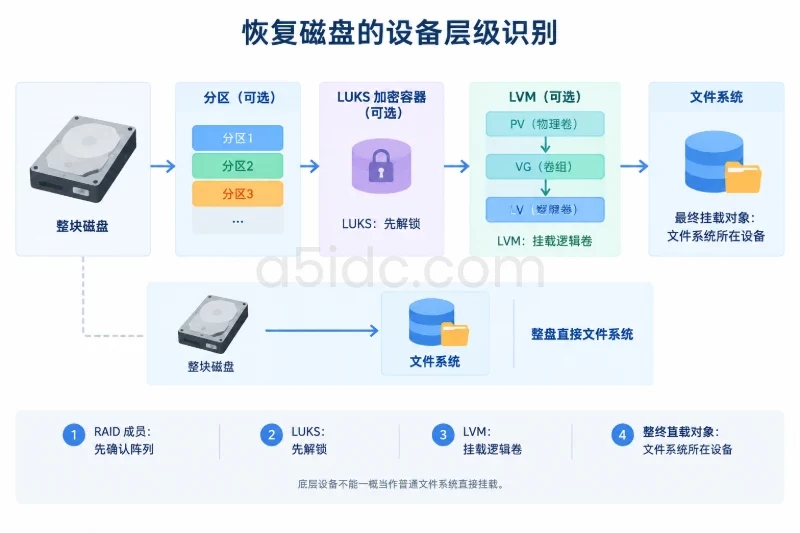
磁盘 → 分区 → LUKS 加密 → LVM PV/VG/LV → 文件系统
如果识别为 LUKS,先确认加密信息,并准备原有密钥:
sudo cryptsetup luksDump /dev/vdc2
确认密钥和设备无误后,可以以只读方式打开加密映射:
sudo cryptsetup open --readonly /dev/vdc2 restore_crypt
sudo lsblk -f
随后再检查 /dev/mapper/restore_crypt 或其下方的分区、LVM 设备。完成后关闭映射:
sudo cryptsetup close restore_crypt
如果来源使用 LVM,先查看 PV、VG 和 LV:
sudo pvs
sudo vgs
sudo lvs -a -o lv_name,vg_name,lv_attr,lv_size,devices
当恢复盘和原盘同时连接时,二者可能拥有相同的 VG 名称和 PV UUID。此时不要直接对所有 VG 执行激活,否则可能激活错误的卷或导致设备映射混淆。对于明确属于恢复盘的重复 VG,可在确认设备后使用发行版提供的克隆导入工具修改副本标识,例如:
sudo vgimportclone --basevgname vg_restore /dev/vdc2
sudo vgchange -ay vg_restore
sudo lvs -o lv_name,vg_name,lv_path,lv_size
vgimportclone 会改变恢复副本的 LVM 标识和名称,适合将副本作为独立卷使用,不适合在未确认设备时执行。若原 VG 已经不再连接,且确认没有同名卷冲突,再根据发行版和 LVM 版本执行激活。
如果识别为 linux_raid_member,先查看 RAID 元数据:
sudo mdadm --examine /dev/vdc1
不要因为只看到一个成员就使用 --force 组装 RAID。快照可能只覆盖了部分成员,也可能不同成员的快照时间不一致。应先确认所有成员、阵列级别、事件计数和快照时间点。
假设实际文件系统位于 /dev/vdc1,先以只读方式挂载:
sudo mount -o ro /dev/vdc1 /mnt/restore-disk
如果是 XFS,且恢复盘与原盘存在相同文件系统 UUID,临时读取副本时可能需要:
sudo mount -o ro,nouuid /dev/vdc1 /mnt/restore-disk
nouuid 只适合临时读取或验证副本。它不会修复 UUID 冲突,也不应直接作为长期生产挂载方案。
ext4 在需要避免日志回放时,可以使用:
sudo mount -o ro,noload /dev/vdc1 /mnt/restore-disk
这更适合证据保留或临时读取场景。如果快照处于崩溃一致性状态,完全禁止日志回放可能导致部分未完成事务不可见。恢复业务前应在副本上完成文件系统检查,并根据业务恢复策略决定是否允许文件系统修复。
如果挂载失败,不要立即改成读写模式,也不要先执行格式化。先检查错误信息和设备层级:
sudo findmnt /mnt/restore-disk
sudo dmesg --ctime | tail -n 80
临时挂载验证完成后,如果要将恢复盘作为正式数据盘使用,应优先使用文件系统 UUID,而不是固定设备名:
sudo blkid /dev/vdc1
示例 /etc/fstab 条目如下,UUID 需要替换为实际值:
UUID=7c2e8f31-5c88-4c8a-9d31-123456789abc /data_restore ext4 defaults,nofail 0 2
XFS 数据盘可以使用类似配置:
UUID=2b8f5d1a-8f3c-4b5b-b7d2-abcdef123456 /data_restore xfs defaults,nofail 0 0
添加前应备份当前配置:
sudo cp -a /etc/fstab /etc/fstab.bak.$(date +%Y%m%d%H%M%S)
先检查语法,再只挂载目标目录:
sudo findmnt --verify --verbose
sudo mkdir -p /data_restore
sudo mount /data_restore
sudo findmnt /data_restore
nofail 适合非关键数据盘,避免磁盘暂时不可用时阻塞系统启动。根分区、/usr 或关键启动分区不应仅靠 nofail 隐藏错误,否则可能把严重的启动问题变成后续运行故障。恢复盘确认是永久替换盘后,才考虑将临时目录改为正式目录。
数据盘恢复通常不需要复制启动文件。不要因为恢复盘中存在某些目录,就把它设置成启动盘。只有恢复系统盘、准备更换根磁盘或需要从恢复盘启动时,才检查以下内容:
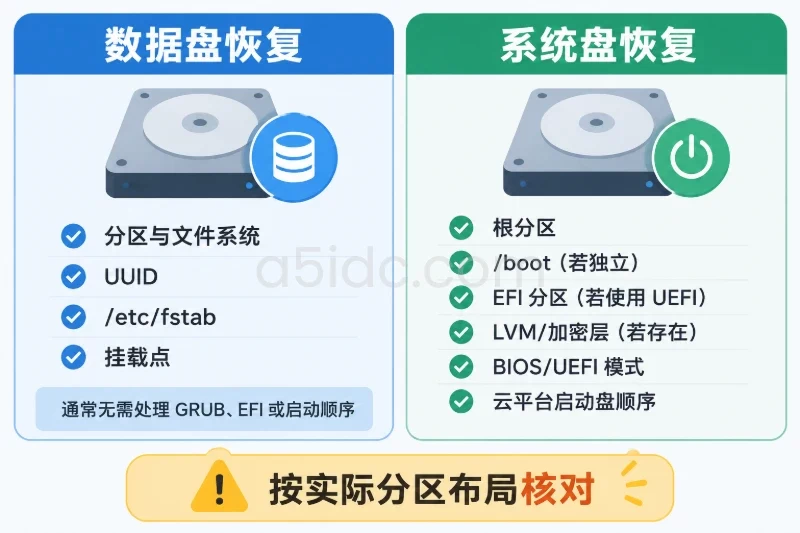
/boot 是否为独立分区。/boot/efi。/etc/fstab 中的 UUID、PARTUUID、设备路径是否对应新盘。在救援系统中,可以先把恢复后的根分区挂载到临时目录,仅读取配置:
sudo mkdir -p /mnt/root-recover
sudo mount -o ro /dev/mapper/vg_restore-root /mnt/root-recover
sudo sed -n '1,200p' /mnt/root-recover/etc/fstab
sudo lsblk -f
EFI 分区和 /boot 是否需要单独挂载,要根据原系统分区表判断。不要在不知道发行版、启动模式和设备布局的情况下直接执行 grub-install、重建 initramfs 或覆盖 EFI 文件。启动项修复应先保留旧系统盘,并在云平台提供的救援环境中完成,避免把尚可启动的原盘一起改坏。
挂载成功后,至少检查文件系统类型、容量、实际来源和读写状态:
findmnt -T /mnt/restore-disk -o TARGET,SOURCE,FSTYPE,OPTIONS
df -hT /mnt/restore-disk
lsblk -f
确认以下结果:
SOURCE 是恢复盘的目标分区、逻辑卷或加密映射,而不是原生产盘。FSTYPE 与源盘记录一致。ro。df 显示的总容量与快照来源大致一致。可以读取关键目录和文件:
sudo find /mnt/restore-disk -maxdepth 2 -type d | sort | head -n 50
sudo stat /mnt/restore-disk/path/to/important-file
sudo sha256sum /mnt/restore-disk/path/to/important-file
如果有备份时生成的校验清单,可以抽样比对文件哈希、大小、权限、属主、扩展属性和软链接。仅能列出目录不代表应用数据完整,数据库还需要使用数据库工具执行只读检查或日志恢复。
文件系统检查必须在卸载状态下进行,不能对已挂载的生产文件系统直接运行修复命令。先卸载:
sudo umount /mnt/restore-disk
ext4 可以先执行不修改磁盘的检查:
sudo e2fsck -fn /dev/vdc1
XFS 使用:
sudo xfs_repair -n /dev/vdc1
如果设备实际是 LVM 逻辑卷,应将命令目标替换为对应的逻辑卷,例如 /dev/mapper/vg_restore-lv_data。e2fsck 不适用于 XFS,xfs_repair 也不应套用到 ext4。只有在已有副本、确认目标设备、明确接受修复会改变磁盘内容的情况下,才执行不带只读参数的修复。
恢复检查应分为三层:
数据库文件恢复后,不要让恢复盘中的数据库实例与原实例同时使用同一端口、同一数据目录或同一业务身份。需要切换时,先停止原服务、保留原数据,再启动恢复实例,并明确记录当前使用的磁盘。
data常见原因包括:
处理顺序应是重新确认云平台的磁盘 ID、快照 ID 和恢复状态,再使用 lsblk、fdisk -l、blkid 和 file -sL 逐层判断。不要使用 mkfs“让磁盘可用”,因为它会覆盖原有文件系统元数据。
/dev/disk/by-uuid 挂载快照是源磁盘的块级副本,因此恢复盘可能与原盘拥有相同的文件系统 UUID。临时读取时,可以使用明确的设备路径,XFS 可结合 nouuid 只读挂载。
如果恢复盘要成为长期替换盘,应先卸载并确认旧盘不会再被系统使用,再修改副本 UUID:
sudo tune2fs -U random /dev/vdc1
ext4 使用 tune2fs,XFS 则需要使用对应的 xfs_admin 工具。修改 UUID 后,必须重新执行 blkid,并同步更新 /etc/fstab、启动配置或其他依赖该 UUID 的配置。UUID 修改属于写入操作,不能在未确认目标设备时执行,也不能把原生产盘当作目标。
bad superblock 或文件系统损坏先确认挂载的是正确层级:
/dev/vdc1,不是 /dev/vdc。确认层级后,在卸载状态下使用对应文件系统的非破坏性检查。若检查显示日志未完成、超级块异常或元数据损坏,应先保留原快照和当前副本,再创建一个新的副本进行修复。修复命令可能改变目录、日志和元数据,不能把它当作无风险读取操作。
先确认当前目录是否被其他挂载点覆盖:
findmnt -T /mnt/restore-disk
sudo du -xsh /mnt/restore-disk
sudo find /mnt/restore-disk -maxdepth 2 -type f | head
常见原因是挂载到了错误分区、快照创建时间早于数据写入、业务实际数据位于另一块磁盘,或者原目录本来就是挂载点。对多磁盘业务,需要按磁盘分别确认快照时间,不能只恢复其中一块就认为整个业务已经恢复。
恢复到另一台云主机后,文件的数字 UID/GID 可能与新主机上的服务账号不同。先查看数字身份和 ACL:
sudo stat -c '%n %u:%g %A' /mnt/restore-disk/path/to/file
sudo getfacl -p /mnt/restore-disk/path/to/file
不要直接执行 chmod -R 777 或 chown -R。这类操作会影响整个恢复目录,并可能破坏安全边界、特殊权限和应用所需的属主关系。应先确认目标服务账号、目录层级和 ACL 需求,只调整必要范围。
系统启动失败时,优先查看 /etc/fstab 中的 UUID、文件系统类型和挂载点。常见问题是:
/boot 或 EFI 分区没有按原布局挂载。/dev/vdb1。可从云平台控制台或救援环境启动,挂载根分区后修正配置。不要为了跳过启动问题而随意删除所有 fstab 条目;非关键数据盘可以评估使用 nofail,根分区和系统目录则应修复设备标识和依赖关系。
临时取数的推荐方式是:
如果需要复制大量文件,可以先进行演练或使用干运行方式检查差异。涉及覆盖目标文件时,必须先备份目标目录,避免把恢复盘中的旧版本直接覆盖当前有效数据。
正式切换通常会造成业务中断,应提前确认维护窗口、服务停止顺序和回滚动作。示例流程如下,服务名和目录需要替换为实际值:
sudo systemctl stop app.service
sudo umount /data
sudo mount /data
sudo findmnt /data
sudo systemctl start app.service
sudo systemctl status app.service --no-pager
执行前应完成以下保护措施:
/etc/fstab。如果切换后发现数据版本不正确或应用无法启动,回滚时停止服务、卸载恢复盘、恢复旧盘挂载配置,再启动服务。不要在新盘和旧盘之间反复读写同步,否则会让回滚点变得不清晰。
系统盘恢复不仅是“挂载根目录”。应先在非生产环境或救援环境核对分区表、根分区、/boot、EFI 分区和 LVM 映射,再将新盘设置为启动盘。原系统盘应暂时保留,云平台启动顺序和固件模式确认无误后再进行切换。
首次启动后,立即检查:
findmnt /
findmnt /boot
findmnt /boot/efi
lsblk -f
systemctl --failed
journalctl -b -p err..alert --no-pager
如果系统能启动但服务未恢复,应继续检查服务配置、网络地址、密钥权限和数据库恢复状态。启动成功只说明操作系统能够运行,不等于业务数据已经完整。
云快照恢复后的数据盘与系统盘,可对应到不同的服务器资源需求。A5数据提供香港、美国、日本等地区的物理服务器,涵盖常规建站、AMD计算及存储型配置,产品采用SSD、NVMe或大容量机械硬盘等存储方案,并提供不同的CPU、内存与网络组合,可用于承载网站、数据库、业务后台及文件存储等工作负载。
lsblk、blkid 和分区表检查,未误操作原生产盘。/etc/fstab 使用正确的 UUID,未依赖易变化的 /dev/vdX 名称。/boot、EFI 和启动模式。本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5161.html