香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


Compose文件里明明写了 depends_on 加上 condition: service_healthy,可应用容器启动时依然连不上数据库,日志里一串 Connection refused。这类问题的根源通常不是“健康检查没配”,而是配置写法、健康检查脚本本身、以及依赖生效范围三处中至少一处出了偏差。本文按由外到内的顺序,给出一条可复现的排查路径:先确认 Compose 是否真正识别了条件依赖,再验证健康检查命令在容器内能否通过,最后区分几种典型失败分支并逐一修复验证。
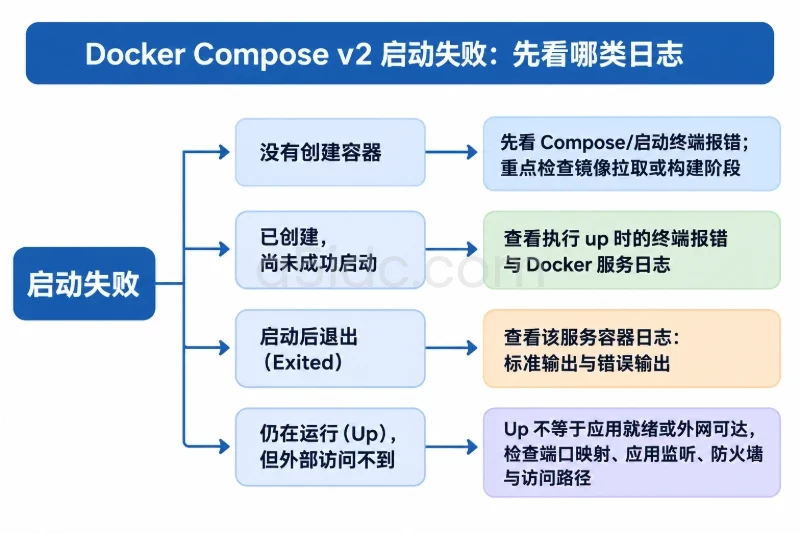
排查之前要明确一点:condition: service_healthy 生效时,被依赖的服务如果一直不健康,依赖方根本不会启动,而不是启动后报连接错误。所以先看现象属于哪一类:
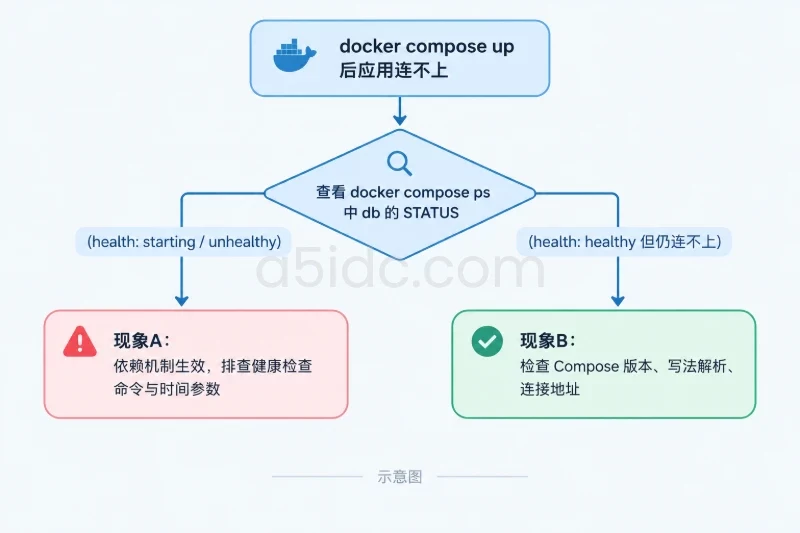
docker compose up -d 后应用容器一直卡在 Created 或 Waiting 状态,最后报 dependency failed to start: container xxx is unhealthy。这说明依赖机制在生效,问题出在被依赖服务的健康检查本身。service_healthy,这种情况在较新版本的 Compose 中不应发生,多数是版本过旧、配置写法未被解析,或应用连接的是错误地址。确认现象的命令:
docker compose ps
docker compose logs app --tail 50
docker compose ps 输出中的 STATUS 列是关键。如果被依赖服务显示 (health: starting) 或 (health: unhealthy),走现象A分支;如果显示 (health: healthy) 但应用还是连不上,走现象B分支。
另外用 docker compose config 检查 Compose 实际解析出的配置——这个命令输出的是合并、插值之后最终生效的 YAML,能直接暴露写法错误和环境变量问题:
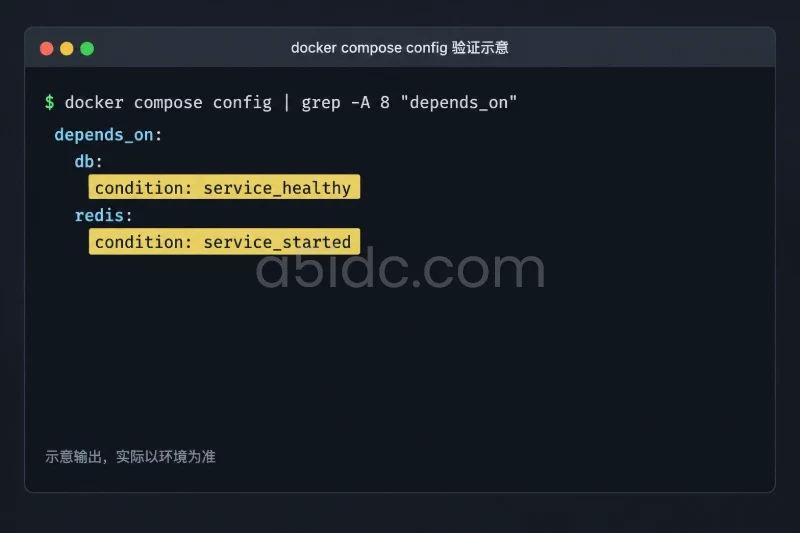
docker compose config | grep -A 8 "depends_on"
如果输出里没有 condition: service_healthy,说明配置根本没被识别,直接跳到后面的写法排查部分。
condition 是否被支持depends_on 的 condition: service_healthy 只在 Compose Specification(对应 Docker Compose V2,命令形式为 docker compose)下可靠工作。旧版 docker-compose 1.x 中,condition 曾在 3.x 版本 format 中被移除,很多网上流传的写法是从 2.x 格式复制来的,套在 version: "3" 文件里会被静默忽略或直接报错。
先确认当前使用的工具:
docker compose version
# V2 输出形如: Docker Compose version v2.24.5

docker-compose --version
# 旧版独立二进制,输出形如: docker-compose version 1.29.2
如果用的是 1.x 旧版且文件声明 version: "3",service_healthy 条件不会生效,应用容器只等依赖容器“启动”而不等“健康”,这正是现象B的常见成因。处理方式是升级到 Docker 自带的 Compose V2 插件,或改用不带 version 字段的现代写法(V2 会按 Compose Specification 解析)。
正确的结构是 depends_on 下的服务名缩进一级,condition 再缩进一级:
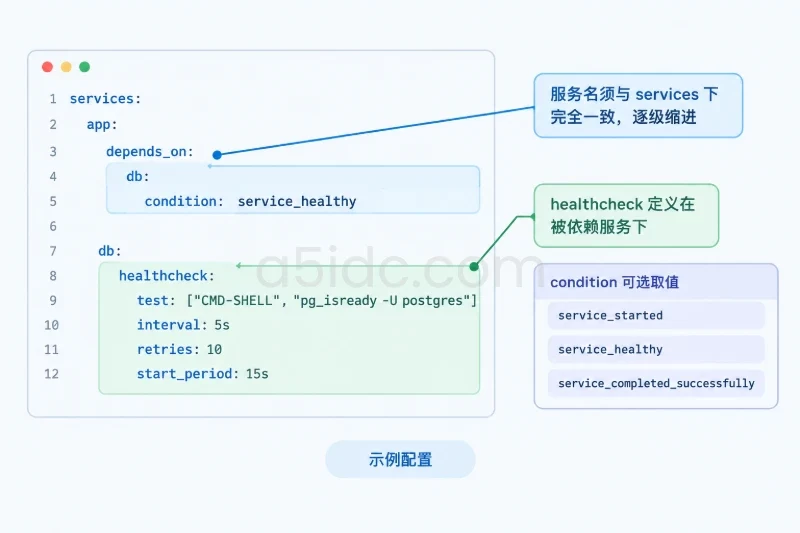
services:
  app:
    image: myapp:1.8
    depends_on:
      db:
        condition: service_healthy
      redis:
        condition: service_started
  db:
    image: postgres:16
    environment:
      POSTGRES_PASSWORD: example
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U postgres"]
      interval: 5s
      timeout: 3s
      retries: 10
      start_period: 15s
逐项核对:
depends_on 下的键必须和顶层 services 下的服务名完全一致,多一个空格或写成容器名都会导致解析偏差。docker compose config 的输出可以确认。condition 的三个取值。service_started 只等容器启动(默认行为),service_healthy 等健康检查通过,service_completed_successfully 等一次性任务容器以退出码 0 结束。把初始化脚本容器误用 service_healthy 等待,会永远卡住,因为短任务容器没有健康状态,应改用 service_completed_successfully。healthcheck 位置。必须定义在被依赖的服务(如 db)下,而不是依赖方。偶尔见到把健康检查写在应用服务上的情况,这不会产生任何等待效果。现象A分支下,被依赖服务的健康状态一直不是 healthy。此时进入容器手动执行健康检查命令,是最直接的验证方式:
docker exec -it <db容器名> pg_isready -U postgres
按退出码分三种结果:
pg_isready 指定了错误的用户名、数据库名,或 MySQL 的 mysqladmin ping 缺少认证参数导致返回异常。以 MySQL 8 为例,一个可用的写法是: healthcheck:
test: ["CMD", "mysqladmin", "ping", "-h", "127.0.0.1", "-uroot", "-p$MYSQL_ROOT_PASSWORD"]
interval: 5s
timeout: 3s
retries: 20
start_period: 30s
注意 -p$MYSQL_ROOT_PASSWORD 中间不能有空格,且该写法会把密码暴露在容器进程列表中,内部环境可接受,对外服务建议用 --defaults-extra-file 指向挂载的凭据文件。
curl(多数精简镜像都不带),导致 test: ["CMD", "curl", "-f", "http://localhost:8080/health"] 每次都以 127 退出,健康检查永远失败。这种情况在基于 Alpine 或 distroless 的镜像里很常见。用 docker exec <容器> which curl 验证;不存在就换镜像内置工具,如 wget、nc 或应用自带的探针命令。test: ["CMD", "pg_isready -U postgres"] 是一个典型错误:CMD 形式不做 shell 解析,整个字符串会被当成一个可执行文件名,找不到就失败。要么改用 CMD-SHELL:
test: ["CMD-SHELL", "pg_isready -U postgres"]
要么保持 exec 数组形式,把参数拆开:
test: ["CMD", "pg_isready", "-U", "postgres"]
需要环境变量插值、管道或逻辑判断时用 CMD-SHELL;简单命令优先用 exec 数组,少一层 shell 开销,也少一类引号错误。
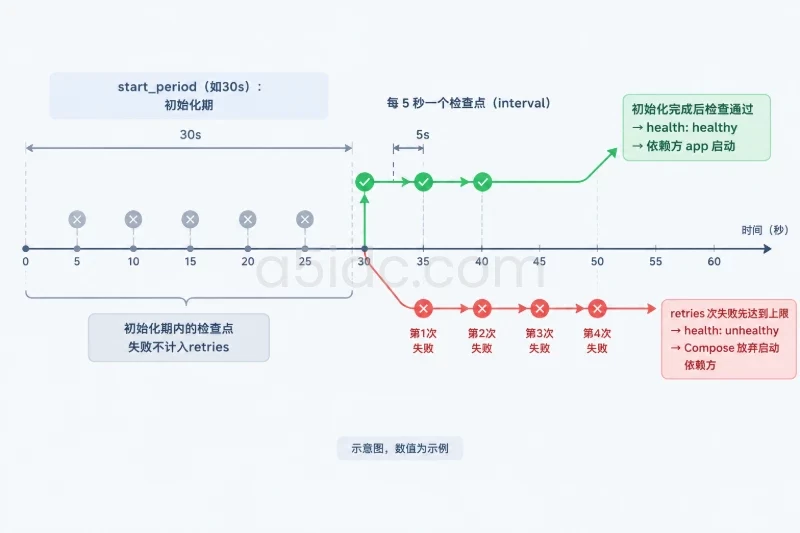
数据库类服务初始化往往比应用慢。interval、retries、start_period 组合出的等待窗口如果小于服务实际就绪时间,健康状态会先被判为 unhealthy,Compose 随即放弃启动依赖方。判断方法:
docker inspect --format='{{json .State.Health}}' <db容器名> | python3 -m json.tool
输出中的 FailingStreak 和最近的 Log 数组能看出检查是在稳定失败,还是前期失败后期成功。如果日志显示初始化期间失败、之后已能通过命令手动验证,但状态仍是 unhealthy,通常是 retries 太小——把 retries 提到 10 以上,并给数据库镜像设置 start_period(例如 30 秒),让初始化期间的失败不计入重试次数。
健康检查通过但应用仍连不上(现象B的另一种形态),问题通常不在 Compose 依赖,而在应用连接目标:
localhost 或 127.0.0.1。应用容器里的 localhost 指向应用自己,连接必然被拒。核对应用配置中数据库主机是否为服务名 db。ports 映射到宿主机的端口与容器间通信无关。数据库镜像内部监听 5432,即使 Compose 里映射成 15432:5432,应用容器内仍应连 db:5432。127.0.0.1,跨容器访问会被拒。MySQL 的 bind-address、Redis 的 bind 配置需要允许容器网段或设为 0.0.0.0(仅限内网环境并配合网络隔离)。可在应用容器内验证: docker exec -it <app容器名> sh -c 'nc -zv db 5432'
# 预期输出: Connection to db 5432 port [tcp/*] succeeded!
连接成功而应用仍报错,问题在应用侧凭据或驱动配置;连接失败则回头检查数据库监听地址和网络配置。
expose 与自定义网络。同一 Compose 文件的服务默认在同一网络中可直接互通,expose 只是声明性的,不加也能通。如果服务被划分到不同的 networks,依赖方和被依赖方必须在同一网络才能解析服务名。定位到原因后按分支修改,然后完整复测。以最常见的“健康检查命令不可用 + 时间窗口不足”组合为例,修改后:
# 重新构建并启动,观察等待行为
docker compose up -d
docker compose ps
预期结果:db 先进入 starting,十几到几十秒后转为 healthy,随后 app 才启动,且 docker compose logs app 中不再出现连接拒绝。为了确认依赖顺序确实生效,可以在 down -v 清理后重新 up,观察 docker compose up 前台输出中 db 的健康等待日志——V2 版本会明确打印 Container xxx Waiting 和 Container xxx Healthy。
如果改成了 retries: 20 这类更宽的时间参数,修复后建议保留观察一两个完整的重启周期:服务冷启动(机器刚开机、磁盘 IO 高)时初始化最慢,这个场景下健康检查是否稳定通过,比平时 up 一次通过更有参考价值。之后可以把 docker compose ps 纳入日常巡检输出,健康状态从 starting 长时间不动的服务就是下一个潜在问题点。
排查过程中涉及修改 bind-address、健康检查里的凭据参数这类配置,改动前备份原 Compose 文件和数据库配置,记录改动内容;验证失败需要回退时,恢复备份文件并 docker compose up -d 重建即可,数据库数据卷不受配置回退影响。
A5数据提供中国香港、美国、日本、韩国、中国台湾、新加坡及马来西亚等地区的物理服务器资源,覆盖常规建站、数据库、业务后台、接口服务与容器化应用场景。产品可结合AMD EPYC、Xeon Gold、NVMe存储、内存容量及不同网络线路进行资源组合,为Compose编排下的多服务部署、数据库依赖和持续运行提供硬件与网络基础。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5130.html