香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


启动阶段出现“卷组无法激活”时,影响范围可能从单个逻辑卷不可用,扩大到根文件系统、/var、数据库数据盘或整台服务器进入 emergency 模式。此时不能只根据 vgchange -ay 的一行报错判断原因,因为卷组激活依赖一条完整链路:底层设备必须出现,LVM 扫描策略必须允许识别,PV 与卷组元数据必须可读,设备映射和锁管理组件必须正常,最后 systemd 才能继续处理挂载和应用服务。
排查的核心是把“卷组不存在”“PV 未找到”“LV 已激活但挂载失败”和“LVM 已恢复但应用仍未启动”分开。先确认故障边界,再按设备扫描、元数据、设备映射、远程存储依赖、systemd 服务和应用层逐层缩小范围,比直接修改 LVM 配置或恢复旧元数据更安全。
LVM 卷组激活只负责创建或恢复 device-mapper 设备,例如 /dev/mapper/data-lv01。它不等同于文件系统挂载,也不等同于数据库或其他应用服务启动。
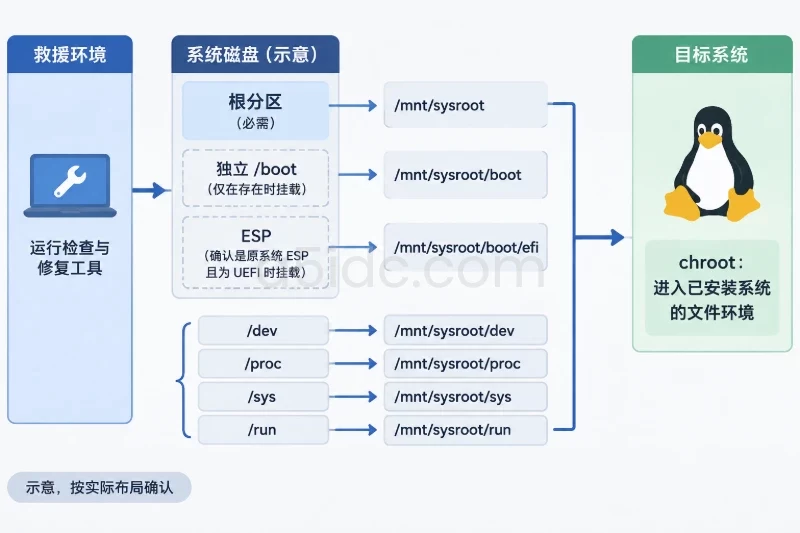
在救援模式或正常系统中,先以 root 权限采集基础状态。以下命令只读,不会修改卷组元数据:
sudo -i

lvm version
lsblk -e7 -o NAME,TYPE,SIZE,FSTYPE,UUID,MOUNTPOINTS
blkid
pvs -o pv_name,pv_uuid,vg_name,pv_attr,pv_size,pv_free
vgs -o vg_name,vg_uuid,vg_attr,pv_count,lv_count
lvs -a -o lv_name,vg_name,lv_attr,lv_size,devices
如果系统没有 sudo,可直接在 root shell 中执行后续命令。重点观察以下结果:
lsblk 中是否能看到预期磁盘、分区、软件 RAID 或多路径设备。pvs 是否能列出预期 PV,以及 PV 所属的 VG 是否为空。vgs 是否能看到目标卷组,pv_count 是否低于预期。lvs 是否能看到逻辑卷,但逻辑卷路径是否已经出现在 /dev/mapper/。可以用一个简单的结果关系判断故障位置:
| 观察结果 | 更可能的故障层 | 下一步 |
|---|---|---|
lsblk 看不到底层磁盘 | 硬件、虚拟磁盘、远程存储或内核设备层 | 检查内核日志、iSCSI、FC、RAID 或多路径 |
lsblk 能看到磁盘,pvs 看不到 PV | LVM 扫描过滤、设备文件或 PV 头部问题 | 检查 filter、global_filter、system.devices 和 PV UUID |
pvs 能看到 PV,但 vgs 看不到 VG | 元数据位置、设备不完整或扫描范围异常 | 检查 pvscan、元数据备份和缺失 PV |
VG 和 LV 都能看到,但 /dev/mapper 没有对应设备 | device-mapper、锁管理或激活策略 | 检查 dmsetup、内核模块和 LVM 服务 |
| LV 已出现,但启动仍失败 | 挂载、/etc/fstab、权限、文件系统或应用依赖 | 检查 systemd、挂载日志和应用日志 |
卷组启动失败通常可以拆成五个分支:
lvmlockd、集群锁或内核模块不满足激活条件。网络端口通常不是本地 LVM 的直接诊断项。只有在 PV 位于 iSCSI 等远程块存储上时,网络连接才属于设备依赖的一部分;LVM 本身不监听一个用于“激活卷组”的服务端口。不要因为某个应用端口未监听,就反向判断卷组一定没有激活。
lsblk 只说明当前系统看到了哪些块设备,还要结合内核日志判断设备是否曾经掉线、重置或被拒绝:
journalctl -k -b --no-pager
dmesg -T | tail -n 200
udevadm settle --timeout=30
lsblk -e7 -o NAME,KNAME,TYPE,SIZE,MODEL,SERIAL,FSTYPE,UUID,MOUNTPOINTS
可重点搜索以下类型的信息:
I/O error、UNC、medium error:底层介质或存储路径可能不稳定。rejecting I/O、device offline、timed out:设备已经出现过,但路径不可用。multipath、duplicate PV:同一个 PV 可能通过多个路径重复出现。udevd 或设备创建延迟:systemd 可能在设备节点尚未完成时提前进入后续阶段。如果设备刚恢复,先等待 udev 规则完成,再重新检查:
udevadm settle --timeout=60
pvscan
pvs
vgs
pvscan 没有发现 PV,并不一定表示 PV 元数据已经损坏。此时必须先确认设备路径是否正确,再检查 LVM 的扫描策略。
如果 PV 位于软件 RAID 上,先确认阵列是否已组装:
cat /proc/mdstat
mdadm --detail --scan
如果系统使用多路径,应优先使用 /dev/mapper/mpath* 或发行版配置的稳定路径,而不是直接把某一条 /dev/sdX 路径当作唯一设备。检查多路径服务和路径状态:
systemctl list-units --type=service --all | grep -E 'multipath|iscsi|mdadm|lvm'
multipath -ll
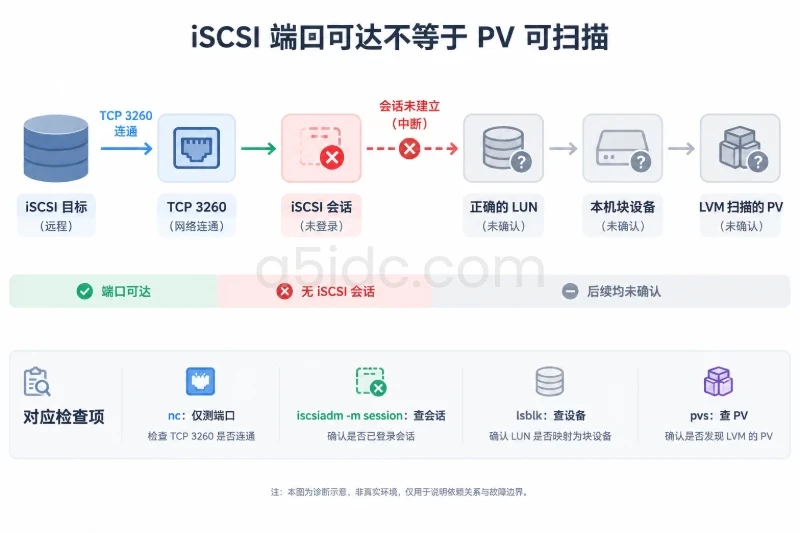
如果 PV 通过 iSCSI 提供,检查会话而不是只检查本地网卡:
iscsiadm -m session
ip route
在明确知道目标地址和端口的情况下,可以检查到 iSCSI 目标的 TCP 3260 连通性:
nc -vz <iscsi-target-address> 3260
nc 显示端口可达,只能说明网络路径和目标端口存在,不能证明本机已经登录正确的 iSCSI LUN。相反,端口可达但 iscsiadm -m session 没有会话,仍然不能进行可靠的 LVM 扫描。
LVM 可能主动忽略一个实际存在的设备。常见影响项包括:
/etc/lvm/lvm.conf 中的 filter。/etc/lvm/lvm.conf 中的 global_filter。/etc/lvm/devices/system.devices。先查看当前生效配置和设备文件状态:
lvmconfig --type current | grep -E '^[[:space:]]*(filter|global_filter|use_devicesfile)'
command -v lvmdevices
lvmdevices --list
如果 lvmdevices 不存在,说明当前 LVM 版本可能没有启用该机制;不要根据网上其他版本的命令直接修改配置。
判断逻辑如下:
lsblk 能看到设备,但 pvs 完全看不到任何 PV:优先怀疑过滤器、设备文件或设备路径。pvs 报告设备被拒绝或找不到:不要立即执行 pvcreate,先确认是否只是被扫描策略排除。如果确认是错误的 LVM 配置,修改前先保留副本,并记录修改前后的内容:
cp -a /etc/lvm/lvm.conf "/etc/lvm/lvm.conf.bak.$(date +%F-%H%M%S)"
配置修改只应放行已经核实的设备类型或路径。不要为了让 VG 出现而直接删除全部 filter 或 global_filter,因为这可能使系统扫描到不应访问的共享盘、重复路径或其他主机的 LVM 设备。若修改后结果更差,回滚方法是恢复备份文件,再重新执行 pvscan 和 vgs。
当设备已经出现,但卷组仍然无法激活时,重点看 PV 是否仍然带有原来的 UUID 和 VG 标识:
pvscan --cache
pvs -a -o pv_name,pv_uuid,vg_name,pv_attr,pv_size,pv_free
vgs -a -o vg_name,vg_uuid,vg_attr,pv_count,lv_count
lvs -a -o lv_name,vg_name,lv_attr,lv_size,devices
典型判断方式:
PV not found:某个卷组成员缺失,或者 LVM 根本没有扫描到对应设备。Volume group "data" not found:可能是 PV 未发现、设备过滤,也可能是 VG 元数据不在当前扫描范围内。pv_count 少于设计值:不能贸然使用“部分激活”,应先确认缺失 PV 是否包含关键 LV 数据。如果系统只缺少非关键 PV,某些场景可以使用部分激活,但这可能使文件系统或应用看到不完整的数据。除非明确知道缺失 PV 不承载目标 LV,且已经有可恢复方案,否则不要把 partial activation 当成正常修复手段。
LVM 通常会在 /etc/lvm/archive/ 和 /etc/lvm/backup/ 保存卷组元数据备份。它们只描述 LVM 结构,不是文件系统数据,也不是整块磁盘备份:
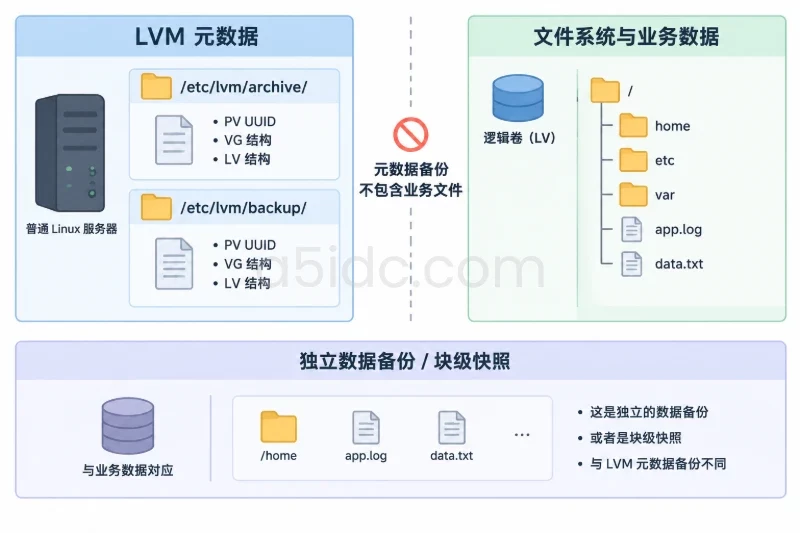
ls -l /etc/lvm/archive/
ls -l /etc/lvm/backup/
vgcfgbackup -f /root/vg-metadata-current.backup <vg-name>
只有在 VG 当前仍可见时,vgcfgbackup 才能生成当前状态的备份。执行前应确保目标目录位于可写且可靠的文件系统中。
如果日志提示元数据校验失败、VG 结构异常或 PV 头部不可读,可以先查看历史备份内容:
vgcfgrestore -l <vg-name>
vgcfgrestore 会覆盖 VG 元数据,属于高风险操作。执行之前至少需要满足以下条件:
不要用 pvcreate、vgcreate 或 pvremove“重新建立”一个看起来不存在的 PV 或 VG。它们可能覆盖原有 PV 头部,使后续元数据恢复更加困难。vgreduce --removemissing 也不能作为常规修复命令,它会改变卷组结构,只有在确认数据不再需要缺失 PV 时才可能考虑。
LVM 元数据可以正常显示,但逻辑卷仍可能无法创建设备节点。此时检查 device-mapper 和当前映射树:
lsmod | grep -E 'dm_mod|dm_crypt|dm_thin_pool'
dmsetup version
dmsetup ls --tree
dmsetup info
如果缺少 dm_mod,可以先确认内核是否提供该模块:
modinfo dm_mod
在确认模块来自当前运行内核、且系统允许动态加载的前提下,再考虑:
modprobe dm_mod
如果 modprobe 报模块不存在,应检查内核模块包、启动内核和发行版安装状态,不要手工创建 /dev/mapper 节点。设备节点由 device-mapper 和 udev 管理,直接 mknod 或修改节点权限不能解决激活问题。
不同发行版和版本的 systemd 单元名称可能不同,不要直接假设某个服务一定存在:
systemctl list-unit-files | grep -E 'lvm|multipath|iscsi|mdadm'
systemctl list-units --type=service --all | grep -E 'lvm|multipath|iscsi|mdadm'
systemctl --failed
常见服务包括:
lvm2-monitor.service:用于部分 LVM 监控和事件处理,不等于所有卷组激活动作。multipathd.service:多路径设备管理。iscsid.service 或 open-iscsi.service:iSCSI 会话管理,名称取决于发行版。mdmonitor.service 或其他 mdadm 相关单元:软件 RAID 监控。lvmlockd.service:共享卷组或集群锁管理场景才需要。找到实际存在的单元后再查看状态和日志:
systemctl status <actual-unit-name> --no-pager
journalctl -b -u <actual-unit-name> --no-pager
如果 vgs 显示卷组使用了集群锁,而 lvmlockd、sanlock 或 dlm 没有正常运行,单机上执行 vgchange -ay 可能会失败。此时应先确认该 VG 是否确实属于共享存储环境,不要在不了解锁模型的情况下切换锁类型或强制激活。
检查启动目标和设备等待情况:
systemctl status local-fs.target --no-pager
systemctl list-dependencies local-fs.target
systemd-analyze critical-chain local-fs.target
journalctl -b --no-pager | grep -Ei 'lvm|device-mapper|mount|dependency|timeout|failed'
如果日志显示:
/dev/mapper/... 超时:先确认对应 LV 是否存在,再回到 LVM 激活和设备扫描分支。Dependency failed for /mountpoint:可能是前置设备单元失败,也可能是 /etc/fstab 写错。查看挂载配置时,重点核对 UUID、LV 路径和文件系统类型:
findmnt --verify
cat /etc/fstab
findmnt
修改 /etc/fstab 前应先备份,修改后可以用 findmnt --verify 检查语法。不要在远程维护且没有控制台或备用登录通道时,直接删除关键挂载项;错误的启动挂载配置可能使系统再次进入 emergency 模式。
LVM 查询和激活一般需要 root 权限。先确认当前身份:
id
ls -ld /dev /dev/mapper
ls -l /dev/mapper
普通用户无法执行 pvs 或 vgchange,不代表卷组损坏。另一方面,不应通过 chmod 或 chown 长期修改 /dev/mapper 节点权限,因为这些节点通常由 udev 动态创建,重启或重新激活后会被重新管理。
如果 LVM 已激活、挂载也成功,但数据库或其他服务仍无法启动,应转向应用自身的日志和权限:
findmnt -o TARGET,SOURCE,FSTYPE,OPTIONS
systemctl status <application-service> --no-pager
journalctl -b -u <application-service> --no-pager
此时要检查的可能是:
端口检查只属于应用服务或远程存储连接的后续层次。例如:
ss -lntp
如果 LVM 设备已经存在,但应用端口没有监听,不能据此推断卷组激活失败。应以 findmnt、lvs、应用服务状态和应用日志分别确认各层状态。
完成信息采集并确认设备路径稳定后,可以按以下顺序恢复。已知卷组名称时,优先指定目标 VG,避免一次激活不相关的共享卷组:
udevadm settle --timeout=60
pvscan
vgs
vgchange -ay <vg-name>
lvs -a -o lv_name,vg_name,lv_attr,lv_size,devices
dmsetup ls --tree
每一步都要根据结果分支处理:
pvscan 仍看不到 PV:回到设备、远程存储和过滤器分支。vgs 能看到 VG,但 vgchange 报缺失 PV:确认缺失设备是否恢复,暂不删除缺失成员。vgchange -ay 成功,/dev/mapper 中出现 LV:LVM 层基本恢复,继续验证挂载。fstab、文件系统类型和挂载日志,不要重复执行 LVM 元数据恢复。对于重要数据,首次恢复后不宜立即以读写方式启动所有应用。可以先确认设备、文件系统和挂载点,再根据业务维护流程启动服务。文件系统检查工具必须在对应文件系统卸载后执行;不要对正在使用的根文件系统或数据库数据卷直接运行修复操作。
下面是用于判断方向的模拟日志,不代表任何特定环境的实测结果:
WARNING: Device for PV 3mK... not found or rejected by a filter.
Cannot change VG data to read/write
1 logical volume(s) in volume group "data" now active
Timed out waiting for device dev-mapper-data\x2dlv01.device
Dependency failed for /srv/data
可以按出现顺序判断:
system.devices 和多路径。vgs 和完整日志。fstab。真正的根因应由多项证据互相印证,例如“内核日志显示 LUN 超时”加上“iSCSI 会话消失”加上“pvs 缺少对应 PV”,而不是只凭一条 Volume group not found 就执行元数据恢复。
恢复后应建立与环境拓扑对应的监控点,而不是只监控应用端口:
pvs 发现数量不一致。/dev/mapper 中关键 LV 设备消失。local-fs.target、关键挂载单元或 LVM 相关服务进入 failed 状态。lvs -a -o lv_name,vg_name,lv_attr,lv_size,data_percent,metadata_percent
同时保留可访问的 LVM 元数据备份,并记录每个 VG 的预期 PV、是否使用多路径、是否依赖远程存储、是否属于集群锁环境。故障发生时,设备关系和依赖关系越清晰,越容易判断是“设备尚未回来”“扫描策略拒绝”“元数据不完整”还是“LVM 已恢复但 systemd 或应用仍未完成启动”。
A5数据提供香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器,覆盖NVMe、SSD与大容量企业级机械硬盘方案,并配备不同CPU、内存、带宽及多IP资源,可承载数据库、文件存储、备份归档和多任务业务。对于涉及LVM、RAID或多路径的服务器环境,这些硬件与地域网络资源可作为设备层、存储层和业务服务层的基础。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5118.html