香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


服务器上 netstat 或 ss 里的 CLOSE_WAIT 数量持续增长,几千甚至上万条压在监控图上,很多人第一反应是“网络出问题了”。但 CLOSE_WAIT 和网络延迟、丢包基本无关,它几乎总是指向一个确定的事实:对端已经发出 FIN 主动关闭了连接,本端应用程序收到了,但一直没有调用 close() 把自己的 socket 关掉。所以排查的核心不是查网络,而是先区分“应用代码没关”和“网络异常导致的假象”,再定位到具体的进程和调用路径。
下面按运维工程师现场排查的顺序展开:先确认现象和量级,再由外到内逐层收窄,最后给出两类根因对应的修复方向和复测方法。示例命令以常见的 Linux 发行版(CentOS、Ubuntu 等)为基准,模拟输出仅用于说明判断路径,实际数值以你的环境为准。
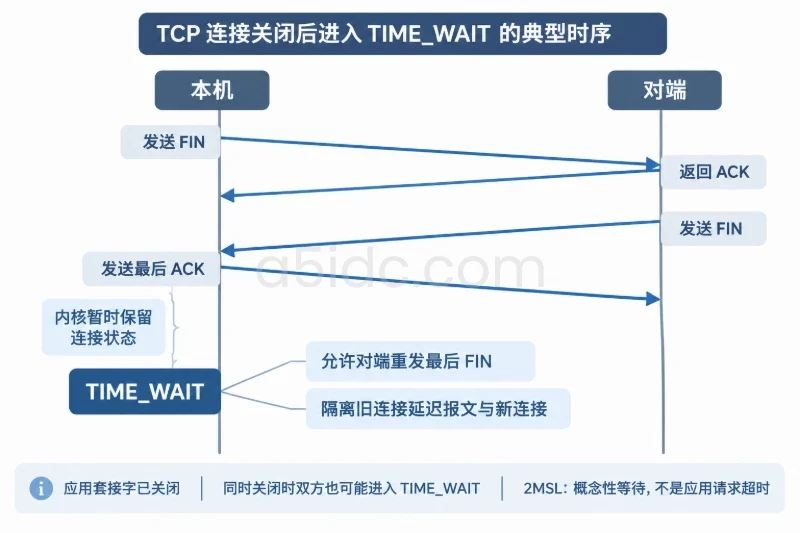
TCP 正常断开的四次挥手过程是:对端发 FIN,本端收到后进入 CLOSE_WAIT 并回复 ACK;本端随后调用 close(),才发出自己的 FIN 进入 LAST_ACK,最终关闭。CLOSE_WAIT 卡住的含义非常明确——本端应用没有执行最后那一步 close()。
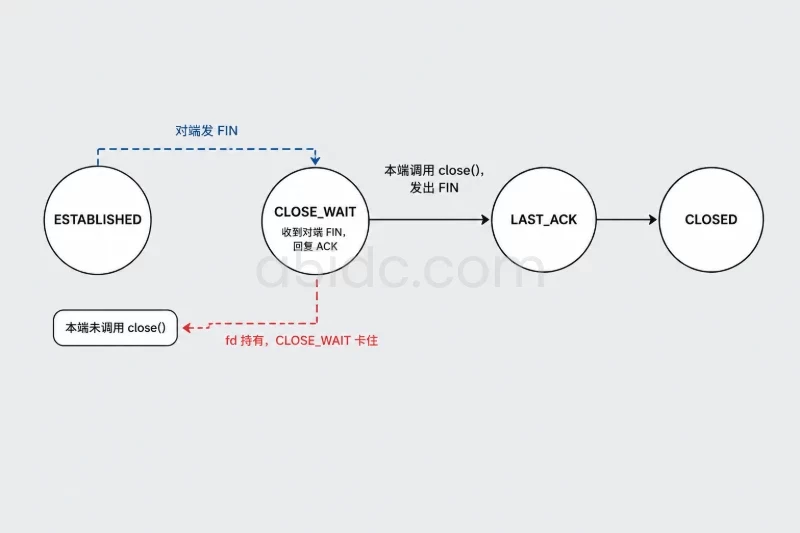
这里有两个关键判断:
ulimit -n 的限制时,进程会报 "Too many open files",新建连接、打开日志文件都会失败,这才是它真正的破坏力。先看量级和增长速度:
ss -ant state close-wait | wc -l
ss -antp state close-wait | head -20
第一条看总数,第二条看具体连接属于哪个进程(需要 root 权限,-p 才能显示进程名)。模拟一段输出:
CLOSE-WAIT 0      0        192.168.1.10:8080    203.0.113.7:52311  users:(("java",pid=2345,fd=881))
CLOSE-WAIT 0      0        192.168.1.10:8080    198.51.100.3:61290 users:(("java",pid=2345,fd=912))
确认三件事:数量级(几百条通常可观察,上万条通常已影响服务)、增长趋势(持续单调增长还是波动)、归属进程(nginx、java、node 还是其他)。这三个信息决定了后面的排查深度。持续单调增长且不回落,几乎可以排除网络抖动,是典型的应用未关闭。
虽然 CLOSE_WAIT 多数是应用问题,但排查要从低风险、非侵入的外层开始,避免一上来就重启进程。
对卡住的连接抓包验证。以 8080 端口为例:
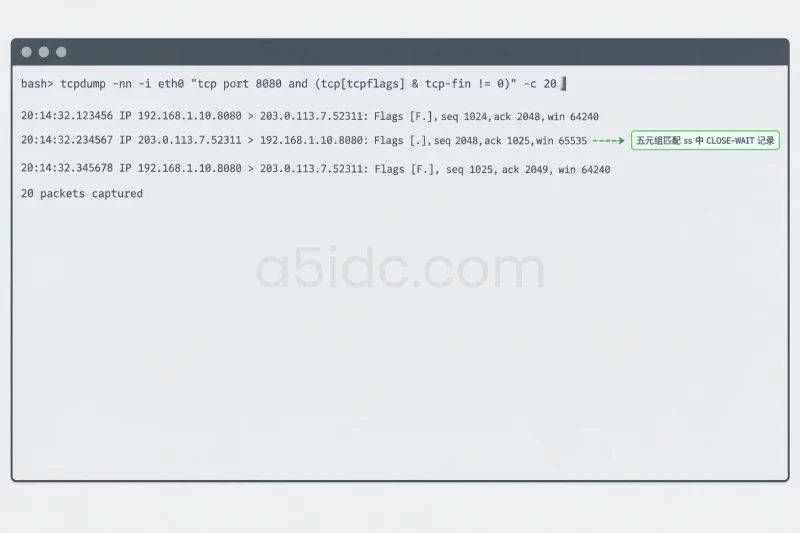
tcpdump -nn -i eth0 "tcp port 8080 and (tcp[tcpflags] & tcp-fin != 0)" -c 20
观察对应五元组的 FIN 报文到达时间,与本端 CLOSE_WAIT 连接的建立时间对比。两种结果:
极少数情况下,负载均衡器、NAT 网关的健康检查或连接回收策略会主动发 FIN 断开空闲连接,如果应用侧没有正确处理这类“被对端关闭”,CLOSE_WAIT 会规律性地增长。核对方法:
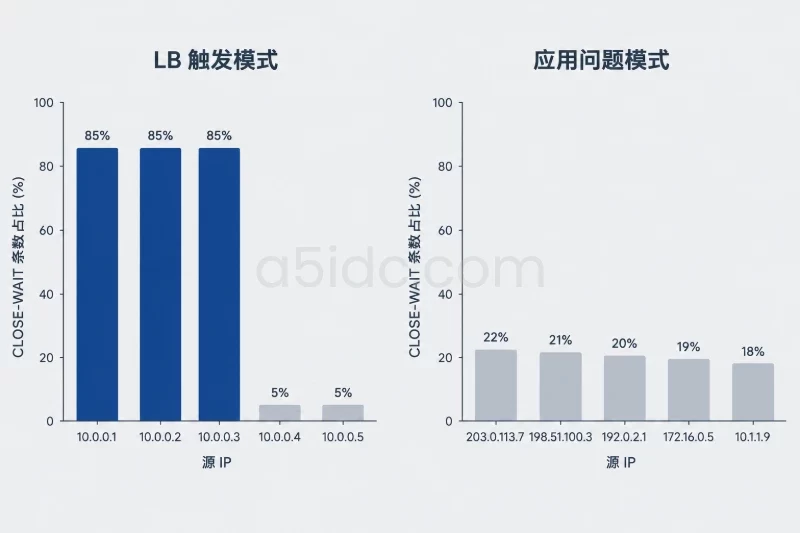
ss -ant state close-wait | awk '{print $4}' | sort | uniq -c | sort -rn | head 统计对端分布。如果对端分布分散、无周期规律、数量持续上涨,基本可以判定为应用侧问题。
定位到具体进程后,进一步收窄到代码路径:
ls /proc/2345/fd | wc -l
cat /proc/2345/limits | grep "open files"
如果 fd 数已接近上限,说明问题已经在产生实际影响,处理优先级提高。
Connection: close 或服务端主动断开的响应时,没有走关闭分支;应急处理是滚动重启问题进程,释放积压的 fd——这是低风险操作,但要在低峰期执行,并确认有多个实例轮流摘除流量。根治必须改代码或改连接池配置,重启只是把水位打回去,不改增长趋势。
真正由网络引起的 CLOSE_WAIT 相关问题很少,但存在两种形态:
ss -ant | awk '{print $1}' | sort | uniq -c 看完整状态分布,区分清楚 CLOSE_WAIT 和 LAST_ACK、FIN_WAIT。ip -s link show eth0 查看本端收发错误计数,配合 ss -ti state close-wait 看单条连接的定时器与重传信息。如果确认是链路丢包,排查方向转向交换机、网卡或机房线路,这与 CLOSE_WAIT 本身无关,属于并发问题。判断标准很直接:CLOSE_WAIT 状态下的 socket,责任在本端应用;网络问题影响的是进入和离开这个状态的过程,而不是这个状态本身。
代码修复或配置调整上线后,验证闭环这样做:
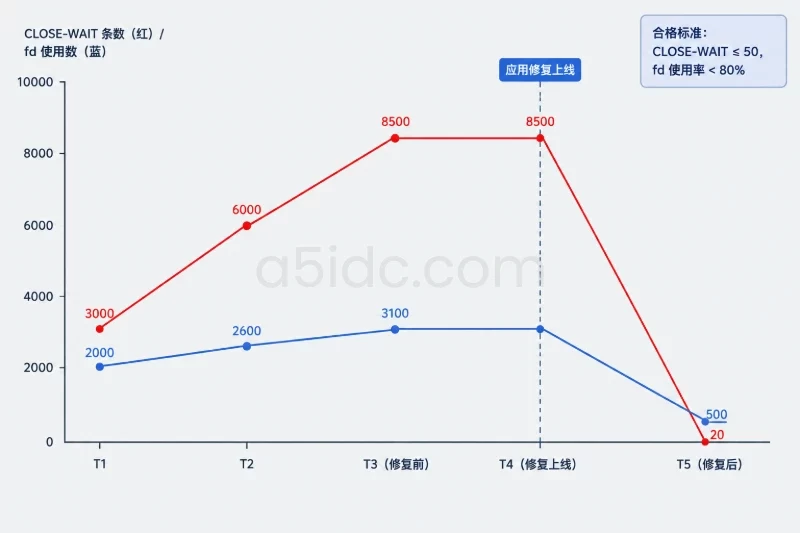
ss -ant state close-wait | wc -l
同时建议在监控里加上两个长期指标:各核心进程的 CLOSE_WAIT 数量和 fd 使用率,分别设置告警阈值(例如 CLOSE_WAIT 持续超过 500 告警,fd 使用率超 80% 告警)。A5IDC 的云服务器支持通过自定义监控脚本上报这类指标,配合定期巡检,多数堆积问题在影响业务之前就能被发现。
排查顺序回顾:先看状态分布和进程归属确认现象,再抓包和统计对端分布排除中间设备的周期性关闭,然后定位到进程和代码路径,最后用修复前后的数据对比完成闭环。记住核心结论:CLOSE_WAIT 增长,第一嫌疑人是应用程序没有关闭 socket,网络异常只是需要排除的少数分支。
针对接口服务、数据库和容器等长期运行场景,A5数据提供香港、美国、日本、韩国、中国台湾、新加坡、马来西亚等地区的物理服务器租用,覆盖Xeon Gold、AMD EPYC、NVMe存储及不同带宽线路。多地区与网络资源组合可承载分布式业务和跨区域访问,CPU、内存与磁盘配置也为连接密集型应用、日志留存和多任务运行提供基础。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5113.html