香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


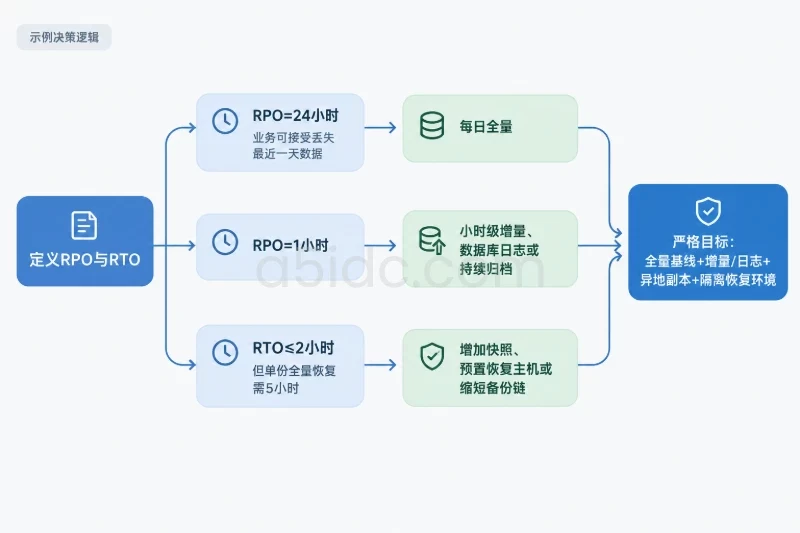
在已有美国服务器上安排全量备份,不能只看“每天执行一次”这一项。应先根据可接受的数据丢失量(RPO)、恢复时限(RTO)、数据增长速度和备份窗口确定频率:小规模业务且备份能在低峰期完成时,可以每天执行一次全量;数据量较大或写入频繁时,通常采用每周全量、每日增量,并为数据库追加日志归档;核心数据库则应保留定期全量基线和连续的事务日志。
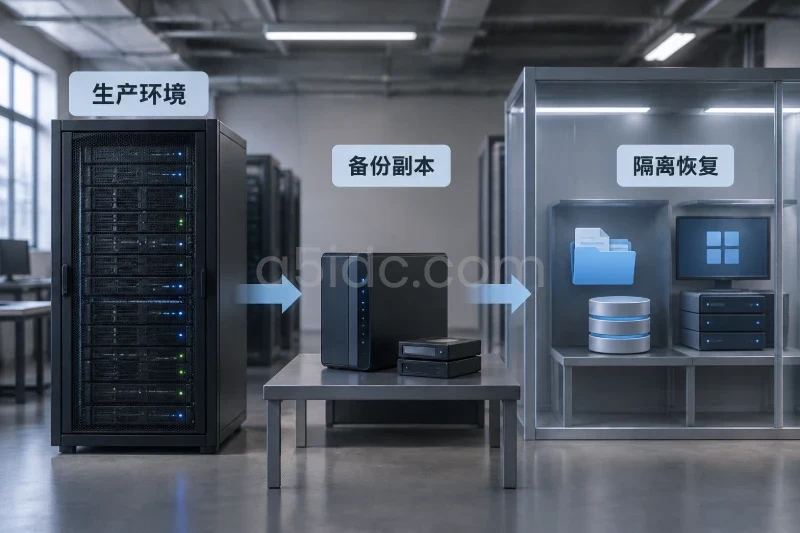
保留周期建议按“每日、每周、每月”分层设置,例如保留7~14个每日备份、4~8个每周备份、6~12个每月备份,同时至少保留一份不在原服务器本机或同一存储故障域中的副本。备份任务完成不等于可以恢复,必须定期在隔离环境中恢复文件、数据库或整机镜像,记录恢复耗时、可恢复时间点和业务校验结果。
RPO表示发生故障后最多允许丢失多长时间的数据,RTO表示从开始恢复到业务可用所需的时间。
例如:
全量备份的时间点也会影响实际数据损失。假设每日全量在02:00 UTC完成,服务器在20:00 UTC发生故障,如果没有增量或日志,理论上可能需要回退到当天02:00的备份,数据损失接近18小时。若数据库日志每5分钟归档一次,恢复点可以推进到故障前较近的时间,但仍要扣除日志传输延迟和损坏部分。
备份范围应以“重建业务所需的完整对象”为准,而不只是 /var/www 或某个数据库目录。
| 对象 | 需要纳入的内容 | 适合的备份方式 | 验证重点 |
|---|---|---|---|
| 业务文件 | 网站目录、上传文件、用户附件、任务生成文件 | 文件级全量、存储快照或备份客户端 | 文件数量、权限、随机文件可打开 |
| 数据库 | 数据表、索引、存储过程、触发器、事件、用户权限配置 | 数据库原生导出、物理备份、日志归档 | 能否启动、表和记录是否完整 |
| 操作系统配置 | Nginx、PHP、系统服务、定时任务、挂载配置 | 配置文件备份、整机镜像 | 服务能否按原端口启动 |
| 容器环境 | 数据卷、Compose文件、环境变量、镜像版本信息 | 数据卷备份加配置备份 | 容器启动后能否读取原数据 |
| 证书和密钥 | TLS证书、应用密钥、数据库凭据、加密密钥 | 加密后独立保存 | 恢复后能否解密和连接依赖服务 |
| 监控与任务 | 备份脚本、告警规则、日志归档、恢复脚本 | 配置仓库或独立备份 | 任务可重新执行、告警能触发 |
数据库数据目录不能简单当作普通文件复制。在线复制可能得到不一致的数据页,尤其是在存在事务写入、缓存延迟或多个数据文件时。文件系统快照也可能只是崩溃一致性快照,不一定达到应用一致性。
美国服务器可能使用UTC、美国东部时间或其他时区。任务调度、日志时间和恢复点必须统一,否则容易出现“监控显示已经备份,实际查看的是另一天文件”的问题。
Linux环境可以先核对当前设置:
timedatectl status
timedatectl show -p Timezone --value
date -u
建议服务器、备份平台和监控系统统一使用UTC,并在任务名称中直接写明UTC时间,例如:
full-backup-2025-01-15T02:00:00Z
如果必须使用本地时间,应明确处理夏令时切换。不要只依据“每天凌晨2点”判断任务是否按计划执行,因为切换日期可能出现重复或缺失的本地时间。
当已用数据量较小、每日变化量不高,并且全量备份能在业务低峰窗口内完成时,可以采用每日全量。
适用条件通常包括:
例如,已用数据量约150GB,压缩后备份文件约90GB,每晚执行一次全量,保留14个每日恢复点,并额外保留每月归档,操作相对直观。即使某一天的备份损坏,也可以切换到前几天的完整副本。
当数据量达到数百GB甚至数TB时,每日全量可能占用过长备份窗口。常见做法是每周执行一次全量,其他日期执行增量或差异备份。
一种示例安排如下:
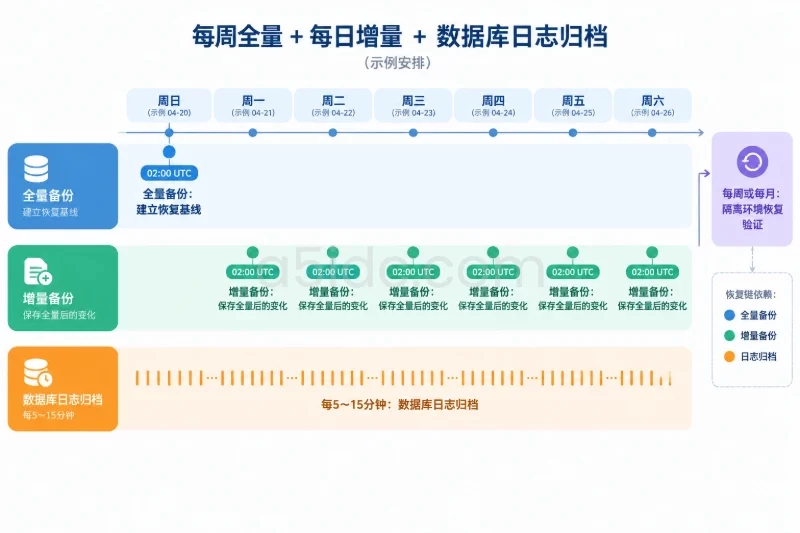
| 时间 | 任务 | 作用 |
|---|---|---|
| 周日02:00 UTC | 全量备份 | 建立新的恢复基线 |
| 周一至周六02:00 UTC | 增量备份 | 保存全量之后发生的变化 |
| 每5~15分钟 | 数据库日志归档 | 缩短数据库可接受的数据丢失时间 |
| 每周或每月 | 隔离环境恢复 | 验证全量、增量和日志链是否可用 |
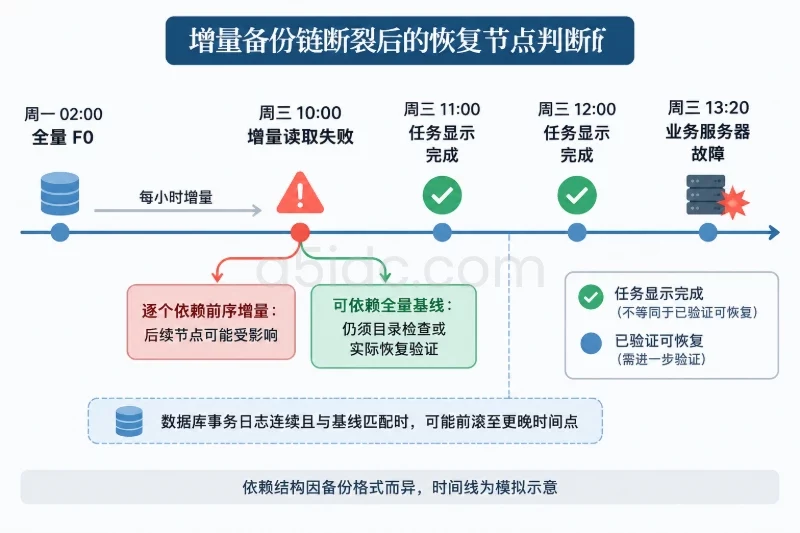
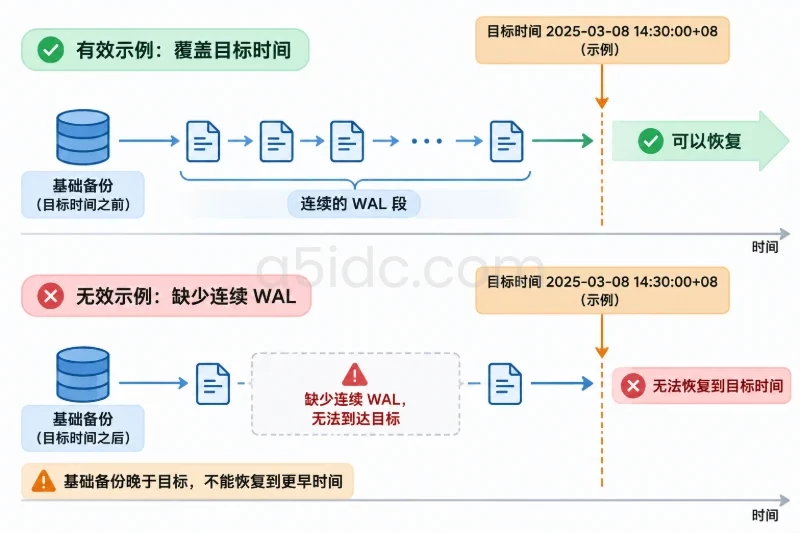
增量链必须完整保存。删除某个全量备份前,要先确认依赖它的增量文件和日志已经过期,否则备份目录看起来有文件,实际却无法恢复到目标时间点。
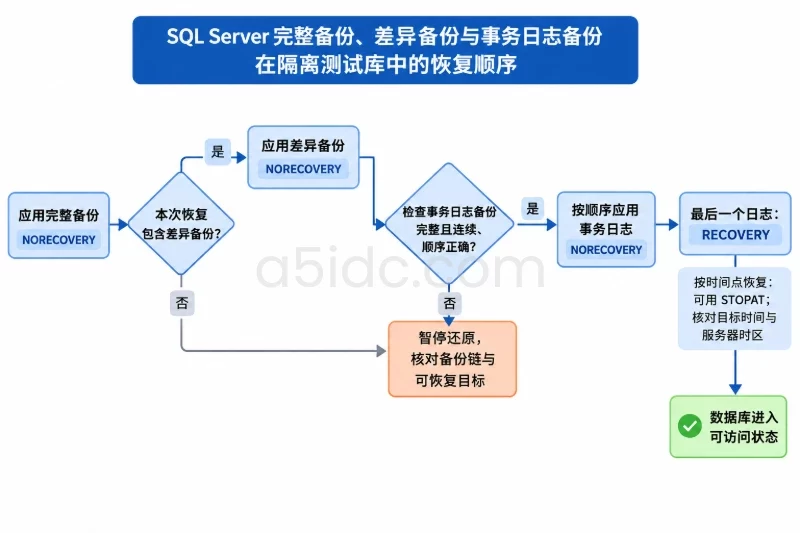
如果使用差异备份,恢复时一般只需要最近一次全量和最近一次差异,恢复步骤较少,但每日差异文件会逐渐变大。选择增量还是差异,应结合备份窗口、恢复时间和存储成本判断。
对订单、支付、库存、工单等持续写入的数据库,仅保留每日全量通常不足以满足业务要求。可以根据数据库类型配置:
数据库日志必须和全量备份建立对应关系。恢复时不仅要知道“哪一份全量可用”,还要知道这份全量之后的日志从哪里开始、到哪里结束,是否存在缺失或重复。
不要只用文件大小除以小时数,要把字节转换为比特,再换算为网络速率。
假设需要传输600GB十进制数据,要求在4小时内完成:
这是不包含加密、压缩、协议和磁盘开销的理论速率。实际规划时可增加约20%~30%的余量,备份通道最好按400~450Mbps左右的可用能力评估。
如果一份1TB的全量备份只能使用200Mbps的持续带宽,理论传输时间为:
1TB × 8 × 1000 ÷ 200Mbps ÷ 3600 ≈ 11.1小时
实际时间还会受读取速度、压缩效果、网络抖动和备份端限速影响。此时不宜直接把任务改成每日全量,而应考虑本地快照、增量传输或数据库日志归档。
可以先使用以下典型策略,再根据合规、业务价值和存储容量调整:
保留周期应覆盖“发现问题的时间”。如果数据库错误数据在两周后才被发现,只保留最近7天的备份就无法回到错误发生前。对重要业务,月度备份和长期归档的价值通常高于单纯增加几个每日副本。
假设源数据已用空间为800GB,压缩后每份全量约480GB,保留7份每日、4份每周、12份每月,且备份系统没有跨副本去重,则需要:
7 + 4 + 12 = 23份
480GB × 23 = 11,040GB
按十进制计算约为11.04TB,还没有计入临时文件、日志、校验清单和增长余量。如果备份系统支持去重,实际占用可能低于这个结果,但不能在没有测试数据的情况下直接按理想去重率规划。
建议至少预留20%~30%的增长空间,并监控:
服务器本地磁盘、同一台宿主机上的附加卷、同一存储池或同一云账户中的副本,不能单独视为灾难恢复备份。服务器被删除、账号被误操作、存储池损坏或勒索软件获得管理权限时,这些副本可能同时失效。
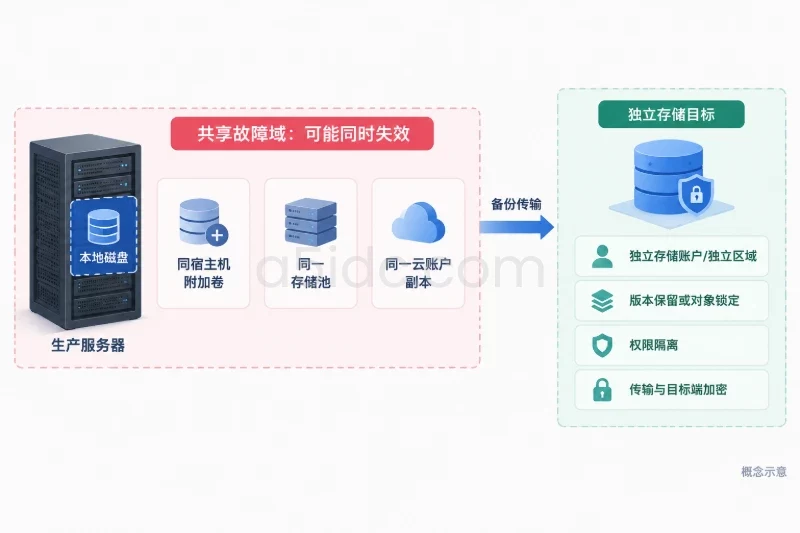
至少应保留一份:
美国服务器的备份位置还要结合业务合规和数据流转要求。如果数据需要留在美国,可选择美国境内的独立区域或独立存储账户;如果允许跨区域保存,则应在恢复延迟、跨区域传输费用和合规要求之间取舍。
执行前检查以下内容:
以Linux环境中的示例数据库为例,MySQL可以使用一致性导出参数:
mysqldump \
  --single-transaction \
  --routines \
  --events \
  --triggers \
  --hex-blob \
  --databases appdb \
  > /backup/appdb-$(date -u +%Y%m%dT%H%M%SZ).sql
--single-transaction主要适用于InnoDB等支持事务一致性读取的表。若数据库中包含MyISAM等非事务表,导出过程可能需要锁表,必须先评估对写入业务的影响,不应直接照搬到生产环境。
PostgreSQL可以使用自包含格式导出:
pg_dump \
  --format=custom \
  --file=/backup/appdb-$(date -u +%Y%m%dT%H%M%SZ).dump \
  appdb
导出前应确认数据库版本、扩展、角色和权限是否需要单独保存。只导出业务库而不保存角色、扩展或连接配置,可能导致数据恢复后应用仍无法正常启动。
普通文件可以通过备份工具读取,但正在写入的上传文件、缓存文件和应用生成文件可能处于中间状态。对重要业务目录,应采用以下方式之一:
整机镜像或云硬盘快照便于快速恢复系统,但快照本身不一定包含独立副本,也不一定具备数据库应用一致性。快照完成后仍要复制到独立存储,并通过实际恢复验证其可启动性。
“任务进程退出”只能说明程序结束,不能证明备份可用。每次全量任务至少检查:
对文件型备份,可以对清单或归档文件生成校验值:
sha256sum /backup/appdb-20250115T020000Z.dump \
  > /backup/appdb-20250115T020000Z.dump.sha256

sha256sum --check /backup/appdb-20250115T020000Z.dump.sha256
校验和只能证明文件在校验时没有发生变化,不能证明数据库内容一定可用,因此仍需进行恢复测试。
恢复验证可以分为三层:
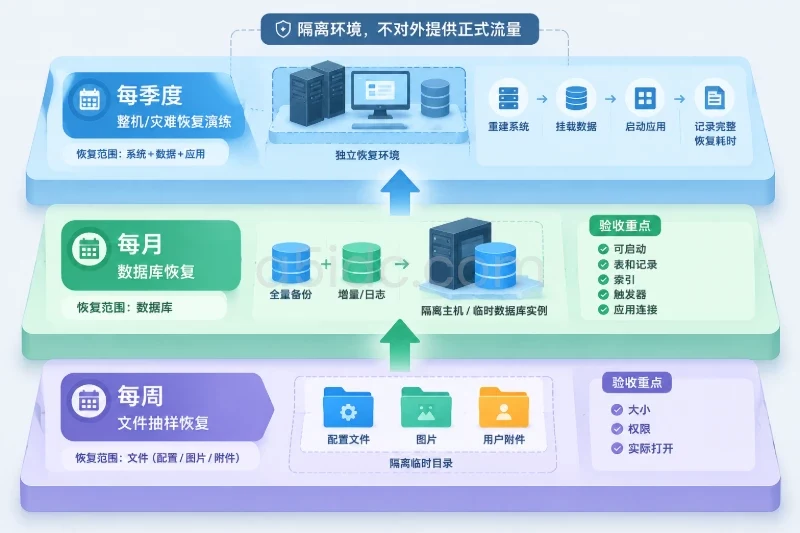
从最近一次全量备份中随机选择配置文件、图片和用户附件,恢复到临时目录,检查文件大小、权限和实际打开结果。
在隔离主机或临时数据库实例中恢复一份全量备份,再应用所需的增量或日志。检查数据库能否启动、表数量、关键记录、索引、触发器和应用连接。
使用不依赖生产主机的恢复环境,重建系统、挂载数据、启动应用,并在不对外提供正式流量的情况下完成业务验证。若业务有严格RTO,应记录从获取备份到应用可用的完整耗时。
PostgreSQL自定义格式备份可以先查看对象清单:
pg_restore --list /backup/appdb-20250115T020000Z.dump
恢复到临时数据库时,目标必须是隔离实例或专用数据库,不能把测试恢复命令直接指向生产数据库。数据库删除、覆盖或重建属于高风险操作,执行前应再次确认目标名称、连接地址和当前备份状态,并保留恢复前的快照或原始数据。
每次恢复演练都应记录:
如果只验证“文件能下载”,没有验证应用、数据库和密钥,不能认为恢复链条完整。
| 异常表现 | 常见原因 | 处理方法 |
|---|---|---|
| 备份大小突然变小 | 路径未挂载、权限变化、目录被排除 | 先暂停清理任务,核对挂载点、清单和排除规则 |
| 任务超时 | 数据增长、网络限速、备份窗口不足 | 检查读取速率和传输速率,调整窗口或改为增量 |
| 数据库导出失败 | 锁等待、空间不足、版本或权限问题 | 查看数据库日志,释放临时空间,核对账号权限,不直接反复重试 |
| 快照长期处于进行中 | 存储侧故障、写入压力过高 | 评估快照对IO的影响,保留当前可用副本,再按平台流程取消 |
| 校验和不一致 | 上传中断、对象损坏、重复覆盖 | 标记该副本不可恢复,从源端重新生成并上传 |
| 备份存在但无法恢复 | 数据库不一致、密钥缺失、日志链断裂 | 切换到上一份已验证副本,补齐密钥和日志,再重新演练 |
| 目标空间不足 | 保留策略过长或增长超出估算 | 不要直接删除最近备份,先清理已过期且不被依赖的副本,并调整容量 |
| 恢复后应用无法启动 | 配置、权限、扩展或证书未纳入备份 | 对照清单补齐依赖,在隔离环境再次恢复 |
处理异常时要保留最近一份已验证成功的恢复点。不能因为新备份失败,就立刻删除旧备份;也不能为了释放空间,直接删除未确认依赖关系的全量或日志文件。
若需要删除损坏副本或覆盖恢复目录,应先确认:
遇到误删、数据损坏或服务器不可用时,不要立即在原服务器上覆盖恢复。建议按以下顺序操作:
停止服务、冻结写入和覆盖数据都会影响业务,必须确认应用范围、连接对象和回滚方式。特别是数据库恢复,不能在未确认目标实例的情况下执行删除、重建或覆盖操作。
恢复环境建议与原生产环境隔离,至少完成以下工作:
如果原服务器仍可用,优先采用“恢复到新环境后切换流量”的方式,回退时可以将流量切回旧环境。若只能在原机恢复,应先保留原数据目录或快照,并为恢复目录使用明确的新名称,避免误删无法回退。
围绕美国业务的数据恢复与重新部署,A5数据提供美国物理服务器,涵盖常规Xeon、AMD EPYC及多IP等系列,部分配置搭配大容量内存和NVMe存储,可为数据库、业务后台及恢复环境提供计算与存储资源。不同配置和线路可对应不同业务负载与网络需求,便于将恢复后的服务部署在美国节点。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5038.html