香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


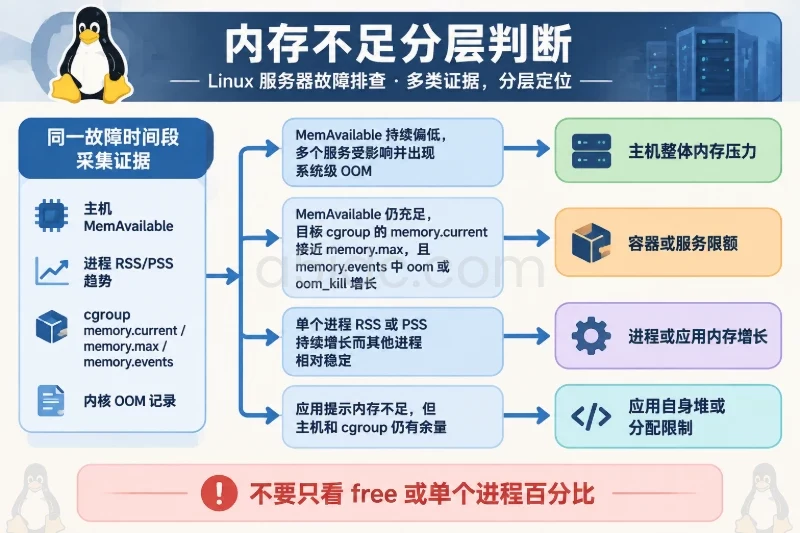
在香港服务器上设置容器内存限制,不能简单按“服务器有多少内存”或“容器当前用了多少内存”决定。更可靠的做法,是把内存限制看成一个故障边界:在同一时间窗口内,同时观察容器内存、应用堆或进程常驻内存、CPU、磁盘 I/O、网络延迟、请求响应时间、错误率和重启事件,再判断是限额不足,还是应用内存持续增长。
限额不足通常表现为流量或并发升高后,内存快速接近上限,随后出现 OOM、容器重启、请求延迟上升;负载下降后,内存基线能够回落。内存泄漏则更像一条持续上升的曲线:即使请求量恢复、应用进入空闲期,进程内存或堆中存活对象仍不能回到原来的水平。两种问题都可能导致“内存接近 100%”,但关联指标和复测结果不同。
容器内存限制一般由 cgroup 执行,限制范围不只包括应用代码使用的堆内存,还可能包括:
因此,不能把应用的堆上限直接设置成容器的全部内存。例如,容器限制为 1 GiB 时,Java 堆设置为 1 GiB,仍可能因为线程栈、元空间、直接内存和运行时开销触发 OOM。
Kubernetes 中的 requests.memory 主要用于调度和资源保障,limits.memory 才是容器运行时的内存上限。Docker 或 Docker Compose 中则直接通过内存参数设置限制。两者不能混为一谈。
可以用下面的估算方式建立初始值:
容器内存限制 ≈ 稳态工作集 + 业务峰值增量 + 同容器其他进程开销,再预留约 15%~30% 的缓冲
例如,一个应用在稳定负载下占用约 420 MiB,促销或批量请求时增加约 160 MiB,同容器内还有约 80 MiB 的辅助进程开销:
| 项目 | 估算值 |
|---|---|
| 稳态工作集 | 420 MiB |
| 业务峰值增量 | 160 MiB |
| 辅助进程开销 | 80 MiB |
| 预计峰值 | 660 MiB |
| 20% 缓冲 | 132 MiB |
| 计算结果 | 792 MiB |
| 可选初始限制 | 1 GiB |
这里的 1 GiB 只是示例,不是所有应用都适用的固定值。对于 Kubernetes,辅助容器通常有独立的资源限制,应该分别估算;对于 Docker 中的同一容器,多个进程则共同占用这一个限制。
Docker 运行容器时,可以同时设置硬限制和相对柔性的预留值:
docker run -d \
  --name app \
  --memory=1g \
  --memory-reservation=768m \
  --memory-swap=1g \
  example/app:stable
--memory=1g 表示硬内存限制,--memory-reservation=768m 可作为主机内存紧张时的参考值。--memory-swap=1g 将内存和交换空间总量设置为相同值,通常表示不额外使用 swap。实际是否存在 swap,还要看香港服务器主机和服务商的配置。
Docker Compose 的独立运行模式可以使用 mem_limit:
services:
  app:
    image: example/app:stable
    mem_limit: 1g
    mem_reservation: 768m
    restart: unless-stopped
deploy.resources 主要用于 Swarm 等编排场景,不能默认认为在所有普通 Compose 启动方式中都会生效。修改内存限制通常需要重建或重启容器,应提前确认连接中断、缓存丢失和短暂不可用的影响,并保留原配置作为回滚版本。
apiVersion: apps/v1
kind: Deployment
meta
  name: app
spec:
  replicas: 2
  selector:
    matchLabels:
      app: app
  template:
    meta
      labels:
        app: app
    spec:
      containers:
        - name: app
          image: example/app:stable
          resources:
            requests:
              memory: "768Mi"
            limits:
              memory: "1Gi"
requests.memory 为 768 MiB、limits.memory 为 1 GiB,并不意味着应用会一直得到 768 MiB,也不代表使用量达到 768 MiB 就会被杀死。真正的 OOM 边界通常是 limits.memory。
如果 Pod 中包含日志、代理或监控 sidecar,还应分别查看每个容器的内存使用量。一个容器触发 OOM,不一定代表整个 Pod 中的所有进程都发生了泄漏。
单次查看 docker stats 或 kubectl top pod 只能回答“此刻用了多少”,不能回答“为什么增长”。建议先建立可对比的观察窗口:
观察窗口中至少应保留以下指标:
| 维度 | 应观察的指标 | 主要用途 |
|---|---|---|
| 容器内存 | 当前使用量、工作集、RSS、内存上限 | 判断是否接近 cgroup 边界 |
| 内存事件 | oom、oom_kill、max、压力事件 | 判断是否真的触发限制 |
| 应用运行时 | 堆使用、GC 次数、GC 后存活量、线程数 | 识别堆增长或回收失败 |
| CPU | 使用率、限流时间、负载、上下文切换 | 排除 CPU 或 CPU throttling |
| 磁盘 I/O | I/O 等待、延迟、队列、设备利用率 | 排除日志、缓存或数据库写入阻塞 |
| 网络 | RTT、重传、丢包、连接数、连接队列 | 排除香港服务器到客户端或数据库链路问题 |
| 应用 | 吞吐量、P95/P99、超时、5xx、业务队列 | 确认用户侧影响 |
| 数据库 | 查询延迟、锁等待、连接池、CPU、慢查询 | 排除数据库成为真正瓶颈 |
“内存达到 90%”本身不是结论。若内存主要是可回收页缓存,且应用延迟、OOM 事件和压力指标没有恶化,处理方式可能与匿名内存持续增长完全不同。
限额不足通常与并发、请求体积、批处理规模或缓存峰值同时出现。典型时间关系如下:
memory.max 或容器限制;OOMKilled、oom_kill 或容器重启;下面是一组用于说明判断方法的模拟监控数据,并非实际服务器监控结果:
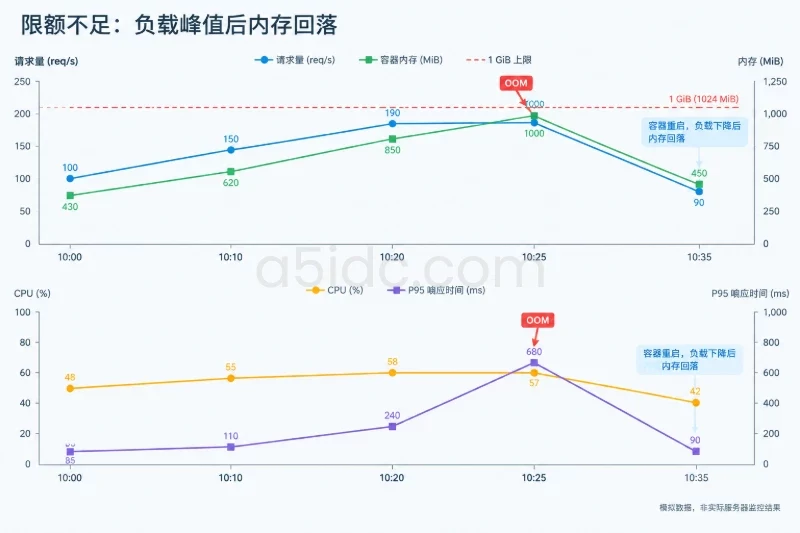
| 时间 | 请求量 | 容器内存 | CPU | P95 响应时间 | OOM/重启 |
|---|---|---|---|---|---|
| 10:00 | 100 req/s | 430 MiB | 48% | 85 ms | 无 |
| 10:10 | 150 req/s | 620 MiB | 55% | 110 ms | 无 |
| 10:20 | 190 req/s | 850 MiB | 58% | 240 ms | 无 |
| 10:25 | 200 req/s | 1000 MiB / 1 GiB | 57% | 680 ms | 发生 OOM |
| 10:35 | 90 req/s | 450 MiB | 42% | 90 ms | 容器重启 |
这组数据中,内存峰值与请求量同步,CPU 没有明显打满,磁盘和网络也没有异常。若流量下降后内存回落,且相同请求再次进入时仍重复出现这个模式,优先判断为峰值内存不足、并发队列过大或单次请求占用过高。
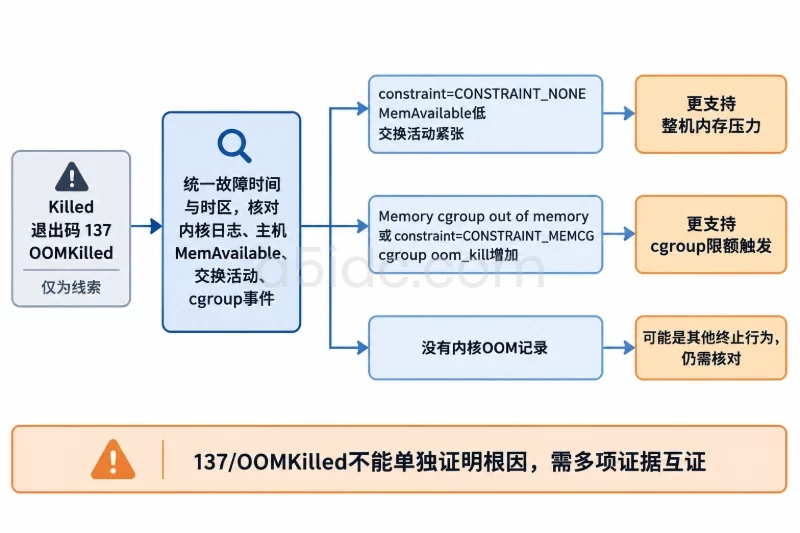
但不能仅凭退出码 137 认定是内存限制问题。137 代表进程收到 SIGKILL,也可能来自主机 OOM、人工终止或其他外部操作,需要结合容器状态、内核日志和编排平台事件确认。
内存泄漏不一定会在瞬间达到上限,关键在于相同工作量下的“周期基线”是否不断抬高。典型表现包括:
例如,下面的数字构成一组典型的模拟趋势:
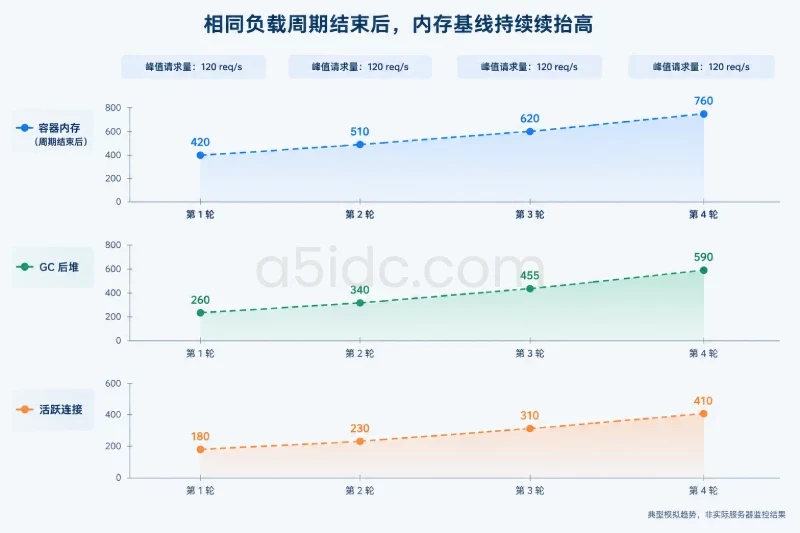
| 压测周期 | 峰值请求量 | 周期结束后的内存 | GC 后堆 | 活跃连接 |
|---|---|---|---|---|
| 第 1 轮 | 120 req/s | 420 MiB | 260 MiB | 180 |
| 第 2 轮 | 120 req/s | 510 MiB | 340 MiB | 230 |
| 第 3 轮 | 120 req/s | 620 MiB | 455 MiB | 310 |
| 第 4 轮 | 120 req/s | 760 MiB | 590 MiB | 410 |
如果请求量、请求类型和并发量基本相同,但 GC 后堆、连接数和周期结束内存持续上升,就不能只增加容器限制。应进一步检查全局缓存、未关闭连接、消息队列积压、监听器重复注册、对象引用和第三方库的本地内存。
日志写入、临时文件、数据库导入和大文件读取可能使文件页缓存增加。此时容器内存显示变高,但不一定是应用对象泄漏。判断时应同时观察:
memory.events 是否出现 oom 或 oom_kill;若主要是文件缓存,I/O 指标通常也会有变化;若主要是应用堆或本地内存泄漏,RSS、运行时堆、对象数或连接数更容易呈现持续斜率。
内存接近上限时,应用可能变慢,但“变慢”不等于“内存是根因”。应使用联动指标排除替代解释。
| 候选瓶颈 | 同时出现的现象 | 验证重点 |
|---|---|---|
| CPU | CPU 使用率长期接近配额,运行队列增加,CPU 限流时间上升;内存未持续接近上限 | 查看进程 CPU、容器 CPU throttling、主机负载 |
| 磁盘 I/O | I/O 等待、设备延迟和队列升高,日志或数据库写入变慢;内存可能因缓存增加 | 查看 await、util、队列长度和进程读写 |
| 网络 | 香港服务器本地 CPU、内存正常,但客户端 RTT、重传或连接等待升高 | 分开看客户端到服务器、服务器到数据库的链路 |
| 应用逻辑 | CPU、内存不高,但应用队列、锁、线程池或连接池达到上限 | 查看线程池、连接池、队列长度和接口分位延迟 |
| 数据库 | 应用请求等待数据库,数据库 CPU、锁等待、查询延迟或连接数升高 | 对齐应用请求时间与数据库查询时间 |
| 内存限制 | 工作集快速接近上限,伴随 OOM 事件、重启或内存压力 | 查看 cgroup 事件、容器状态和回落情况 |
例如,香港服务器上的接口 P99 从 200 ms 增加到 2 秒,但容器内存保持 500 MiB、CPU 只有 35%,数据库查询延迟从 40 ms 增加到 1.5 秒,那么优先检查数据库锁、慢查询和连接池,而不是立即提高容器内存。
反过来,如果数据库、磁盘和网络均稳定,容器内存从 600 MiB 持续接近 1 GiB,并且发生 oom_kill,内存限制才更可能是直接瓶颈。
Docker 环境可以先确认 cgroup 版本和容器当前状态:
docker info --format '{{.CgroupVersion}}'
docker stats --no-stream app
docker inspect -f 'Memory={{.HostConfig.Memory}} MemoryReservation={{.HostConfig.MemoryReservation}}' app
docker inspect -f 'OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}}' app
docker events --since 30m --filter container=app
如果主机和容器使用 cgroup v2,并且容器内可以读取 cgroup 文件,可进一步查看:
docker exec app sh -c '
for f in memory.current memory.max memory.events; do
  echo "== $f =="
  cat "/sys/fs/cgroup/$f" 2>/dev/null || true
done
'
memory.max 显示 max 时,表示该层级没有设置有限的硬上限。memory.events 中的 oom 或 oom_kill 需要结合采样时间和重启记录判断,不能脱离时间窗口单独解读。cgroup v1 的路径和字段不同,若读取不到这些文件,应以 Docker 状态和监控系统为准,不要直接套用 v2 路径。
主机侧可以使用以下只读命令辅助判断 CPU、内存和 I/O:
free -h
vmstat 1 5
iostat -xz 1 5
这些工具可能未预装。缺少工具时,应先确认发行版和监控代理的采集方式,不要为了临时排查直接修改生产环境软件源或安装大量组件。
Kubernetes 环境重点查看容器状态、资源配置和节点事件:
kubectl describe pod POD_NAME -n NAMESPACE
kubectl top pod POD_NAME -n NAMESPACE --containers
kubectl get pod POD_NAME -n NAMESPACE -o jsonpath='{range .status.containerStatuses[*]}{.name}{" reason="}{.lastState.terminated.reason}{" restart="}{.restartCount}{"\n"}{end}'
kubectl top 依赖 Metrics Server 或其他指标组件。如果没有实时指标,不能把命令无输出理解为内存正常。describe pod 中的 OOMKilled、重启原因、节点内存压力和事件时间,需要与应用响应日志对应起来。
可以按下面的条件做初步归类:
| 观察结果 | 更可能的解释 | 下一步 |
|---|---|---|
| 内存随并发升高,接近上限后 OOM;流量下降后回落 | 容器限额不足或峰值工作集过大 | 在保留安全余量的前提下提高限制并复测 |
| 相同压测周期结束后的内存基线持续上升 | 内存泄漏、缓存无界增长或资源未释放 | 分析堆、RSS、连接、线程、文件描述符和队列 |
| 内存高但主要是页缓存,未出现 OOM,I/O 同步升高 | 文件缓存或 I/O 压力 | 检查日志、临时文件、数据库读写和存储性能 |
| 内存稳定,CPU 配额和限流时间升高 | CPU 瓶颈 | 检查计算热点、并发模型和 CPU 配额 |
| 内存和 CPU 正常,数据库等待显著增加 | 数据库或连接池瓶颈 | 查看慢查询、锁、连接数和数据库资源 |
| 服务端指标正常,客户端 RTT、重传或超时升高 | 网络路径或对端链路问题 | 分开测量客户端到香港服务器、服务器到依赖服务的延迟 |
如果初步判断是限额不足,可以只调整一个变量,例如将限制从 768 MiB 调整到 1 GiB,同时保持镜像、应用参数、并发和请求数据不变。修改前应保存当前配置,确认是否需要滚动更新,并准备恢复原限制的回滚方案。
复测时重点比较:
如果限制从 768 MiB 提高到 1 GiB 后,OOM 消失、内存基线稳定、响应时间恢复,原先更像峰值容量不足。如果只是从 20 分钟后 OOM 延迟到 40 分钟,且每轮结束后的内存仍持续上升,则更像泄漏或无界缓存,继续提高限制只能延后故障。
应用自身也应给运行时留出空间。以 1 GiB 容器为例,Java 堆、Node.js old space 或其他运行时堆不宜直接占满 1 GiB;还要为本地内存、线程、连接和日志缓冲预留空间。现代 JDK 可以使用容器感知的内存比例参数,但仍需结合 JDK 版本和应用线程数验证;Node.js 的 --max-old-space-size 也只是限制 old space,不会覆盖所有本地内存。运行时参数、容器限制和业务并发应一起复测。
为了避免再次被单一内存曲线误导,建议在同一个监控面板或同一份排查记录中固定保留这组指标:
oom、oom_kill、容器重启和 Kubernetes 事件;当这些指标共享同一时间轴时,才能把“内存接近上限”进一步拆解为限额不足、内存泄漏、页缓存增长、CPU 限流、磁盘阻塞、网络抖动、应用队列或数据库等待。内存限制的合理值也应在这样的复测结果上调整,而不是根据一次瞬时使用量直接设定。
围绕容器化网站、业务后台、数据库与多任务服务,A5数据提供中国香港及美国、日本等地区的物理服务器资源,覆盖Xeon Gold、AMD EPYC等平台,并配备不同容量内存、SSD或NVMe存储及相应线路。香港部分方案提供64GB、128GB等内存配置,可为容器运行时、数据库缓存和并行服务提供更充足的硬件资源基础;跨地区业务也可结合访问区域选择对应服务器方案。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/5001.html