香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


Redis配置了maxmemory和淘汰策略,并不代表页面、对象或查询缓存就一定能保持稳定命中。真正影响体验的是:内存不足时哪些键会被删除、删除后业务是否允许重新计算、缓存内容是否能够接受过期,以及淘汰动作会不会把请求压力重新推向数据库。
在Linux服务器上,Redis缓存数据通常至少分为三类:可以丢失并重新生成的页面或查询结果、丢失后会影响登录或限流的状态数据、不能被缓存淘汰机制随意删除的队列和业务记录。前一类适合使用allkeys-lru或allkeys-lfu,后两类更适合独立实例配合noeviction,再用TTL、显式删除或长度控制管理生命周期。数据类型本身不是决定因素,关键在于一个Redis键被淘汰后,业务能否接受这个结果。
A5数据提供中国香港、美国、日本、韩国、中国台湾、新加坡和马来西亚等地区的物理服务器租用资源,覆盖常规建站、AMD计算、存储及多IP、不同带宽线路方案。面向Redis缓存、数据库与业务后台,可结合大内存配置、SSD或NVMe存储承载缓存实例及相关服务,并依托多地区资源布局不同访问区域的业务节点。
maxmemory不是Linux进程的全部内存maxmemory表示Redis用于数据和相关内存管理的逻辑上限,但Linux看到的进程常驻内存还可能包括:
因此,8 GiB物理内存的Linux服务器,不能简单地把maxmemory设成8 GiB。一个用于说明容量关系的估算是:
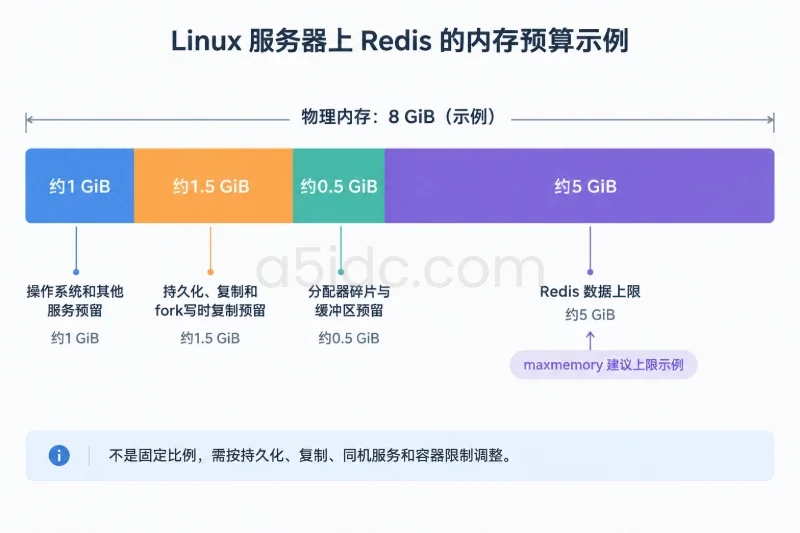
这只是容量规划示例,不是固定比例。如果Redis没有持久化、没有副本,或者服务器只运行Redis,预留项可以减少;如果同一台服务器还运行Web服务、数据库或容器,预留空间则应增加。
当maxmemory过低时,Redis会频繁淘汰,缓存命中率下降,后端数据库查询量上升;当它过高时,Linux可能先出现内存回收、swap、cgroup OOM或Redis进程被系统终止。前者表现为“缓存一直在换入换出”,后者表现为“Redis看起来没有达到上限,却发生了系统级内存压力”。
Redis的淘汰策略通常以key为单位。一个Hash包含十万用户字段,一个List包含大量任务,一个Stream保存多天事件,淘汰时都可能作为一个整体被删除,而不是从中挑选一个字段或一条成员记录。
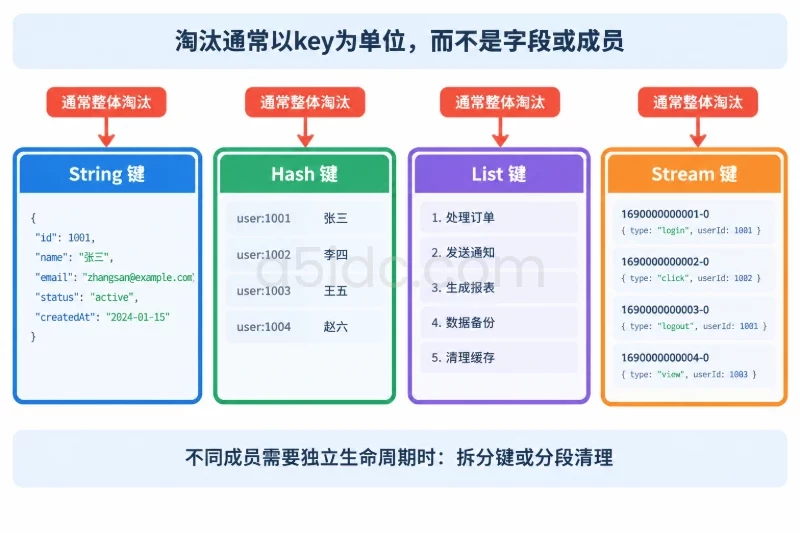
这会直接影响数据结构设计:
如果业务希望不同成员拥有独立生命周期,就不能只依赖一个大键配合全局淘汰策略。可以考虑拆分键、使用独立缓存键,或采用业务层面的分段和显式清理。拆分也会增加键数量、索引开销和网络请求次数,不能只看淘汰粒度而忽略访问成本。
EXPIRE、SET EX等设置的是键的最长存活时间。它们主要解决数据新鲜度和自动清理问题,不保证键在到期瞬间被精确删除,也不代表Redis会优先删除最不重要的数据。
需要区分两种删除原因:
maxmemory-policy选择键删除。如果查询结果必须在5分钟后失效,TTL是必要条件;但如果Redis在第2分钟就发生内存淘汰,TTL并不能阻止它提前消失。反过来,如果内存一直充足,TTL也不会让数据在业务更新时立即失效,因此数据更新场景仍需要显式删除、版本号或依赖关系失效。
noeviction适合不能被静默删除的数据noeviction不会因为内存压力主动删除普通键。当写入需要更多内存时,Redis可能返回内存不足错误,读取通常不受同样方式影响。
它适合以下数据:
但noeviction不是“没有风险”。内存打满后,新的写入会失败,应用必须能够识别错误并采取降级、拒绝请求、转入持久队列或告警处理。若应用把Redis写入失败当成普通缓存未命中,可能造成更隐蔽的数据问题。
allkeys-lru适合访问热度与近期访问相关的缓存allkeys-lru允许在所有键中选择较久未访问的键淘汰,适用于:
Redis中的LRU通常是近似实现,不会为每个键维护完整的全局排序。它会从若干候选键中选择较久未使用者,因此maxmemory-samples会影响选择精度。候选样本较少,CPU开销较低,但淘汰结果更粗略;样本增加,选择通常更接近真实LRU,同时会增加淘汰时的CPU成本。
allkeys-lfu适合长期热点比较稳定的缓存allkeys-lfu根据访问频率保留高频键,更适合热点对象、常用查询和访问分布长期偏斜的场景。例如少数商品、配置对象或查询条件会被大量重复读取,LFU比单纯看最近访问时间更能保留这些键。
LFU也有边界:
lfu-decay-time会影响旧访问记录衰减速度,过慢会导致历史热点滞留,过快又可能接近短期访问统计。因此,LFU不等于“永久保留重要数据”。它只是在容量有限时,帮助Redis按照访问频率做出更有利于命中率的选择。
volatile-*只在带TTL的键中选择volatile-lru、volatile-lfu和volatile-random只会从设置了过期时间的键中选择。如果一部分缓存键忘记设置TTL,它们不会进入候选集合,内存压力可能最终转化为写入错误。
这类策略适用于同一Redis实例中存在少量不可淘汰数据,同时所有缓存数据都具有清晰TTL的场景。例如:
volatile-ttl按照剩余TTL较短的键优先淘汰。它只有在“TTL本身就代表业务优先级”时才合理。如果TTL只是数据新鲜度要求,那么剩余时间短不代表数据价值低。一个刚写入、必须保留到活动结束的短TTL缓存,可能反而比一个长TTL的普通对象更重要。
allkeys-random或volatile-random适合键价值接近、访问分布均匀,或者业务不希望维护热度信息的场景。对热点明显的页面和查询缓存使用随机淘汰,通常会牺牲命中率。
maxmemory-samples、lfu-log-factor和lfu-decay-time都属于优化参数,不应先于业务数据分类进行调整。优先级应当是先选择正确的策略,再根据淘汰频率、CPU占用和命中率调整采样与衰减参数。
下表给出常见数据类型和缓存层级的对应关系。表中的策略是选择起点,最终仍需由数据丢失影响和访问分布验证。
| 数据或场景 | 常见Redis类型 | 可接受的淘汰方式 | 生命周期与失效重点 | 主要风险 |
|---|---|---|---|---|
| 页面片段、接口响应、查询结果 | String | allkeys-lru或allkeys-lfu | TTL加主动失效,必要时加入随机抖动 | 淘汰后回源,可能造成请求突增 |
| 对象缓存、配置副本 | String或Hash | 可重建时使用allkeys-lru;热点稳定时评估allkeys-lfu | 对象更新时删除或版本切换 | Hash大键被整体淘汰 |
| 登录会话、临时授权状态 | String或Hash | 独立实例配合noeviction更稳妥 | TTL、续期和主动注销 | 淘汰可能造成用户退出或权限判断异常 |
| 限流计数、幂等键 | String或Hash | 通常不应依赖普通缓存淘汰 | 固定窗口TTL或滑动窗口清理 | 淘汰可能导致限流失效或重复执行 |
| 任务队列、延迟队列 | List、Sorted Set或Stream | noeviction,由业务控制长度和保留期 | 显式确认、消费、归档或截断 | 整个队列键被删除 |
| 标签集合、成员关系、排行榜 | Set或Sorted Set | 仅在可重建时使用LRU/LFU | 数据变更时主动同步或重建 | 部分业务关系失效后影响查询 |
| 全页面或边缘响应缓存 | 通常不优先放Redis | 由CDN或反向代理按HTTP缓存规则处理 | Cache-Control、版本和回源策略 | 将边缘缓存问题全部转移给Redis |
完整页面或静态响应更接近HTTP缓存和边缘缓存问题,重点是响应头、缓存键、回源规则和发布失效。Redis更适合承担页面片段、接口结果、对象副本或查询结果缓存。
如果确实把完整页面放入Redis,String配合allkeys-lru或allkeys-lfu可以工作,但仍需要处理发布失效和缓存击穿。Redis淘汰只能说明“空间不够时删除谁”,不能保证页面内容在业务更新后立即变新。
查询结果通常具有以下特征:
对热点稳定的查询,allkeys-lfu通常值得评估;对访问波动明显、短时间内热点快速变化的查询,allkeys-lru可能更容易适应。无论选择哪一个,都应配合TTL和数据更新后的主动失效。
TTL不宜全部设置成同一个整齐的时间。例如大量查询结果同时写入、同时在10分钟后过期,可能造成回源请求同时增加。可以在业务允许的范围内加入少量随机抖动,并对高成本查询增加请求合并或短时互斥。
一个Hash或String对象即使访问频率不高,重建成本也可能很大。如果它被淘汰后需要多次数据库查询、远程接口调用或复杂计算,单纯使用LFU并不能完整表达业务价值。
对象缓存可以按以下方式判断:
会话数据即使能够重新登录,也不代表随机淘汰是可接受的用户体验。限流计数一旦被淘汰,可能让请求绕过原有阈值;幂等键被淘汰,可能让重复请求再次执行;队列键被删除,则可能造成任务丢失。
这些数据更适合与普通缓存分开部署。需要注意,Redis逻辑数据库并不能提供独立的maxmemory和独立淘汰策略。把cache:<em>放在DB 0、session:</em>放在DB 1,仍然共享同一个实例的内存上限和淘汰行为。若必须隔离,应使用不同Redis实例、进程或独立的托管资源,并分别规划Linux内存和监控。
可以通过INFO memory观察逻辑内存与进程常驻内存的差异:
redis-cli INFO memory
redis-cli INFO stats
重点关注used_memory、used_memory_rss、maxmemory、mem_fragmentation_ratio等字段。used_memory接近maxmemory时,Redis已经面临淘汰或写入拒绝;used_memory_rss明显更高时,说明Linux实际占用还受到碎片、分配器和其他缓冲区影响。
开启RDB、AOF重写或主从复制时,应额外观察fork期间的内存峰值。写时复制会让父进程和子进程共享未修改页面,但业务持续写入时,修改过的页面可能产生额外副本。此时即使Redis数据量没有明显增长,RSS也可能上升。
只看evicted_keys无法判断策略是否合适。淘汰很多,可能是容量确实不足,也可能是TTL过短、键空间设计不合理或策略不适合热点分布。应同时观察:
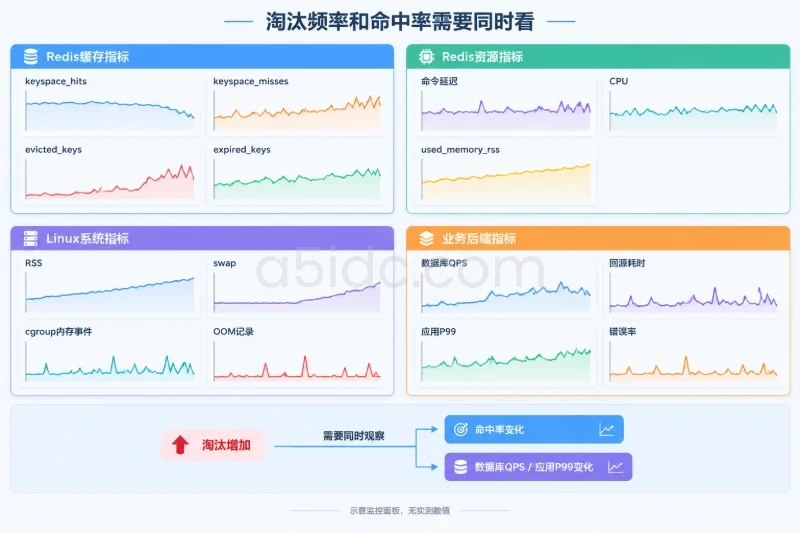
keyspace_hits与keyspace_misses;evicted_keys与expired_keys;如果淘汰增加后命中率几乎不变,说明被删数据可能本来就很少再次访问;如果淘汰增加伴随数据库QPS和应用P99延迟上升,则需要优先增加容量、改善策略或减少无效缓存,而不是简单提高淘汰速度。
一个被大量请求的热点键可能造成单线程处理压力,即使它没有被淘汰也会影响延迟。一个特别大的Hash、Set或JSON键则会降低淘汰粒度:Redis可能为了释放一块较大的内存而删除整个业务对象,但删除和重建本身也可能造成延迟抖动。
可以对抽样键查看占用:
redis-cli MEMORY USAGE 'cache:item:1001'
redis-cli --scan --pattern 'cache:*' | head -n 20
不要在生产环境使用KEYS *来做全量核对。抽样时应结合键类型、访问频率、TTL和重建成本,而不是只按字节数判断是否需要拆分。
每个键空间至少应回答四个问题:
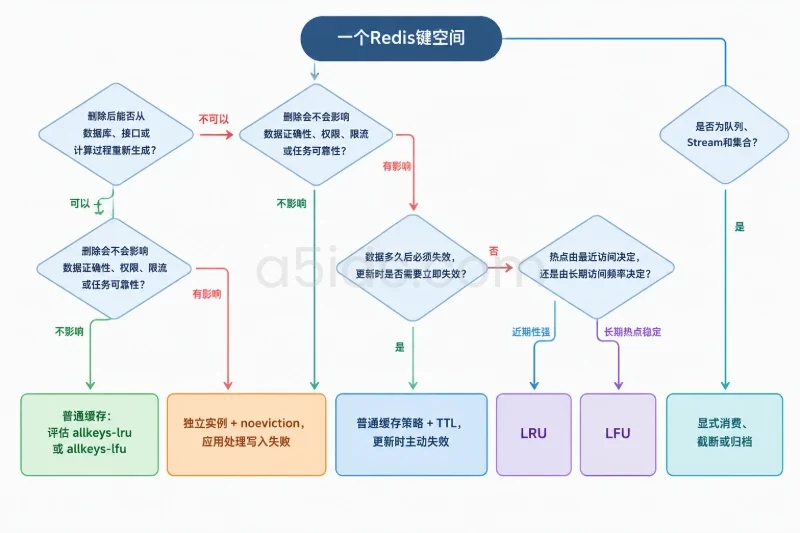
据此可以形成简单分类:
allkeys-lru或allkeys-lfu;noeviction,应用处理写入失败;在测试环境或独立实例中,使用接近生产的键大小、TTL分布和访问比例回放一段代表性流量,至少比较:
例如,查询结果在访问高峰期具有稳定热点,可以比较allkeys-lru和allkeys-lfu;如果流量每天都在快速切换,则应重点观察LFU衰减是否及时,而不是只看某一小时的命中率。
下面是一个缓存专用Redis实例的示例配置,数值仅用于说明参数关系:
maxmemory 5gb
maxmemory-policy allkeys-lfu
maxmemory-samples 10
lfu-log-factor 10
lfu-decay-time 60
其中lfu-decay-time 60表示以分钟为单位的示例衰减周期,并不代表所有查询缓存都应使用60分钟。访问热点变化快的场景需要更快衰减,长期稳定的热点则可能需要更慢衰减。若业务更依赖近期访问,可以把策略改为allkeys-lru,而不是同时堆叠大量LFU参数。
对不能被随机删除的独立实例,策略可以从以下方向开始评估:
maxmemory 5gb
maxmemory-policy noeviction
使用前应保存原配置,并确认应用能够处理内存不足写入错误。修改maxmemory或maxmemory-policy会立即改变实例的写入和淘汰行为,生产环境应先在测试或隔离实例验证,保留旧值作为回退配置。若实例启用了持久化或复制,还要把重写、同步期间的内存峰值纳入回退和容量判断。
可以抽样检查缓存键的TTL:
redis-cli TTL 'cache:item:1001'
redis-cli TYPE 'cache:item:1001'
redis-cli CONFIG GET maxmemory
redis-cli CONFIG GET maxmemory-policy
redis-cli CONFIG GET maxmemory-samples
如果使用volatile-lru、volatile-lfu或volatile-ttl,重点检查缓存键是否真的普遍带有TTL。返回-1意味着键没有设置过期时间,返回-2通常表示键不存在或已经过期。对于采用volatile-*的实例,长期存在的无TTL缓存键可能成为淘汰策略无法处理的内存占用。
最终验收不应只问“Redis有没有报错”,而应问:
可以按照“业务后果—生命周期—访问模式—内存边界”的顺序确定配置,而不是先从网上复制一组Redis参数:
maxmemory,并为峰值预留空间。这样设置出来的Redis缓存策略,才是从页面、对象、查询、会话或队列的业务属性反推参数,而不是让所有数据共享一个看似统一、实际风险不同的淘汰规则。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/4909.html