香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


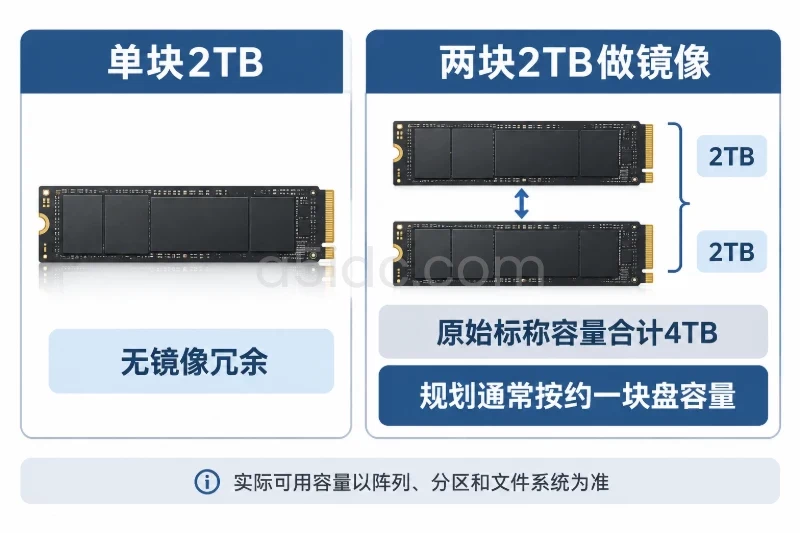
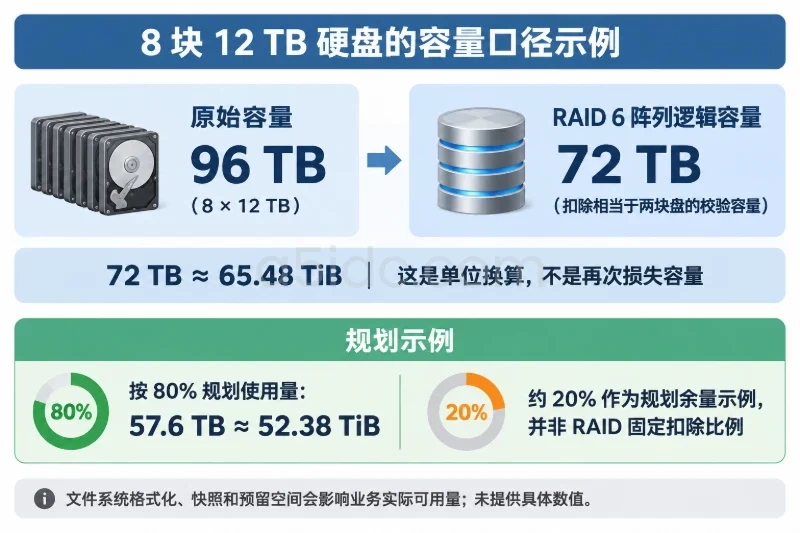
四块14TB企业级机械硬盘装进香港服务器后,裸容量是56TB,但真正可用于业务数据的空间取决于阵列级别、文件系统开销、快照与日志占用,以及必须保留的增长余量。以十进制容量计算,RAID10和RAID6的标称可用容量约为28TB,RAID5约为42TB;如果业务包含大量随机写入或数据库请求,通常优先在RAID10与RAID6之间取舍,而不是单纯追求RAID5的高容量。
容量规划还要结合并发量、请求类型、数据增长速度和备份窗口。四块大容量机械盘适合文件、归档、媒体、备份中转和读多写少的数据集;如果香港服务器承载高并发数据库、虚拟机或大量小文件写入,硬盘容量可能还未用满,随机IOPS、写入延迟和重建时间就已经成为瓶颈。
针对文件、归档、媒体和备份中转等大容量存储场景,A5数据提供香港存储系列物理服务器,包含四块14TB企业级机械硬盘与H730控制器等配置,为阵列规划和数据分层提供硬件基础。结合香港机房资源及不同服务器配置,企业可将大容量数据存储与网站、业务后台等应用部署在相应的物理服务器上。
四块硬盘的计算基础如下:
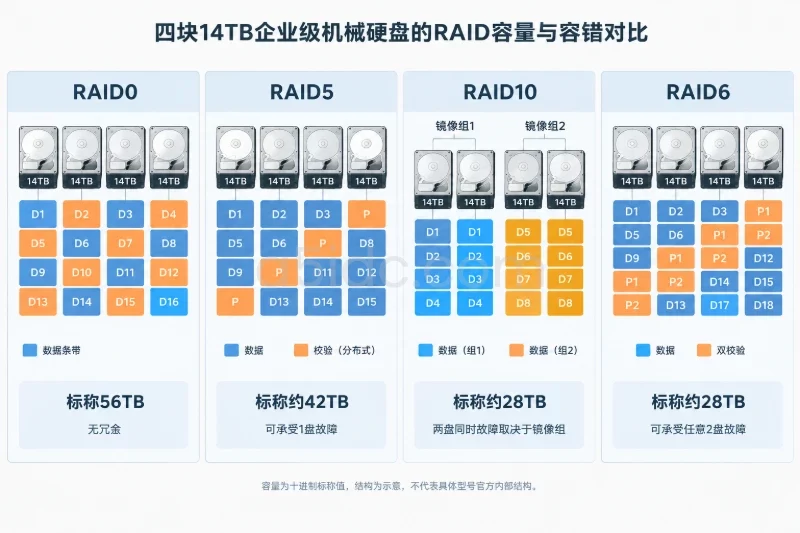
| 阵列方案 | 计算方式 | 标称可用容量 | 约合TiB | 可承受的硬盘故障 |
|---|---|---|---|---|
| RAID0 | 14TB × 4 | 56TB | 50.93TiB | 无冗余,任意一盘故障可能导致阵列不可用 |
| RAID5 | 14TB × 3 | 42TB | 38.20TiB | 可承受一块硬盘故障 |
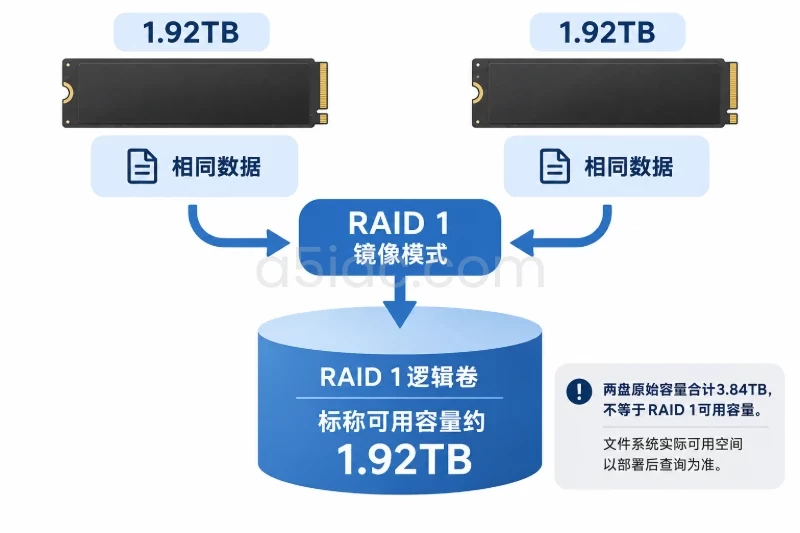
| RAID10 | 14TB × 2 | 28TB | 25.46TiB | 至少可承受一块;两块是否同时可用取决于是否来自不同镜像组 |
| RAID6 | 14TB × 2 | 28TB | 25.46TiB | 可承受任意两块硬盘故障 |
RAID0不适合作为正式业务数据阵列,除非数据本身可以随时重建,并且服务器中没有需要长期保留的唯一数据。对四块14TB机械盘来说,实际需要比较的是RAID5、RAID10和RAID6。
假设文件系统、阵列元数据和管理开销合计按5%预留,同时保留25%的空闲空间用于增长、临时文件、快照和性能缓冲,可以得到一个较适合容量规划的参考值:
| 阵列方案 | 标称容量 | 扣除约5%系统开销后 | 按保留25%空闲计算的业务写入上限 |
|---|---|---|---|
| RAID5 | 42TB | 约39.9TB | 约29.9TB |
| RAID10 | 28TB | 约26.6TB | 约20.0TB |
| RAID6 | 28TB | 约26.6TB | 约20.0TB |
这里的“业务写入上限”是容量规划估算,不是厂商对具体文件系统的固定承诺。数据库、虚拟化平台和快照型文件系统可能需要保留更多空间。例如,数据库日志、临时表、WAL或binlog集中增长时,20%至25%的空闲比例可能仍然不够;而长期归档、只读媒体文件的空间要求则可能更接近容量上限。
如果服务器控制器或文件系统采用二进制单位显示,界面可能看到约24TiB,而不是28TB。采购、交付和监控时应明确使用TB还是TiB,避免把制造商标称容量与操作系统显示容量直接对比。
容量只回答“能放多少数据”,并不能回答“能否及时处理请求”。在容量规划中,至少要把业务拆成并发、请求速率、单次请求的存储操作、数据增长和峰值持续时间五个变量。
并发连接数只是同时处于请求处理过程中的连接数量,实际磁盘压力更接近下面的关系:
有效随机IOPS ≈ 每秒请求数 × 每个请求产生的随机IO次数 × 未命中缓存的比例 + 后台任务IO
例如,1000个并发请求并不一定产生1000 IOPS:
机械硬盘在随机小块读写场景中,通常只能以“百级IOPS”作为早期估算起点,具体数值会受到磁盘型号、转速、队列深度、访问块大小、RAID控制器和缓存命中率影响,不能直接作为香港服务器的承载保证。
| 业务类型 | 主要存储特征 | 更关注的指标 | 阵列倾向 |
|---|---|---|---|
| 图片、视频、安装包、备份文件 | 大文件、顺序读写较多 | 吞吐量、网络带宽、容量 | RAID6或RAID5 |
| 网站上传、下载和文件托管 | 读请求多,写入具有峰值 | 并发读、网络出口、目录和索引性能 | RAID6、RAID10,取决于写入比例 |
| 数据库、订单、检索索引 | 小块随机读写、同步写较多 | IOPS、写延迟、队列深度、fsync延迟 | RAID10,必要时使用SSD层 |
| 虚拟机和容器混合负载 | 多个系统同时随机访问 | 95/99分位延迟、IOPS、突发能力 | RAID10更容易控制延迟 |
| 日志、冷数据、长期归档 | 写入规律,读取不频繁 | 容量、故障保护、重建风险 | RAID6更适合容量与容错平衡 |
如果请求量只在白天短时升高,不能只用全天平均值规划。应分别记录日常值、峰值、峰值持续时间和后台任务同时运行的情况。平均每秒100次请求,但每次请求包含多次随机写入,可能比平均每秒500次顺序读取更容易让四块机械盘达到瓶颈。
四块14TB硬盘能否按计划工作,不只取决于硬盘本身,还取决于服务器控制器和背板:
没有掉电保护的写回缓存,可能在断电时造成已确认写入丢失或文件系统损坏。若无法确认缓存保护状态,容量规划时应优先采用更保守的写入策略,而不是只看测试中的峰值速度。
如果四块硬盘全部加入阵列,就没有额外的专用热备盘。硬盘出现故障后,需要准备同规格替换盘,并等待阵列重建。
也可以拿出一块硬盘作为热备,但这样会改变有效容量和阵列结构。例如,三块盘组成RAID5、另一块作为热备时,不能继续按四盘RAID5的42TB估算。RAID10也不适合简单地把四盘中的一块单独划作热备,因为镜像组需要成对规划。
对于14TB这种大容量机械盘,重建时间可能较长。重建期间阵列性能会下降,剩余硬盘的读写负载也会增加。重建时间取决于实际吞吐、前台业务IO、控制器策略和盘面状态,不能只按硬盘顺序读速度计算。
香港服务器的阵列容量计算与其他地区没有本质区别,但跨地域备份需要额外考虑网络带宽、传输时段、出口费用和备份目标端的写入速度。
以十进制10TB数据通过1Gbps链路传输为例,理论传输时间为:
10TB × 8 × 1000 ÷ 1000Mbps = 80,000秒,约22.2小时
这是理想线速结果。若实际有效带宽只有理论值的50%至80%,传输时间大约为28至44小时,还没有计入加密、校验、并发限速和目标端写入开销。因此,若业务要求每天完成跨地域备份,不能只看本地阵列是否还有空间,还要验证备份窗口是否足够。
RAID也不能替代备份。硬盘故障时RAID可以维持一定程度的连续运行,但误删除、应用程序写坏、勒索软件、文件系统损坏或整台服务器故障仍可能影响阵列中的全部数据。
四盘RAID10的标称容量约为28TB,与RAID6相同,但读写路径不同:
RAID10适用于请求延迟敏感、写入频繁、数据量在约20TB规划上限以内的业务。如果数据已经接近28TB标称容量,RAID10的容量优势不足,应优先重新规划数据分层或扩充盘位,而不是把阵列长期写到接近满载。
四盘RAID6同样约有28TB标称可用容量,但其中两块盘用于双校验。它可以承受任意两块硬盘同时故障,适合以下情况:
RAID6并不是“性能更高的RAID10”。双校验会增加写入计算和写放大,尤其是小块随机写、同步写和高并发更新场景。对于文件下载、媒体库、备份文件等读多写少业务,RAID6通常更容易发挥容量和容错价值。
RAID5可以提供约42TB标称容量,是四种常见方案中容量利用率较高的一种,但它只能承受一块硬盘故障。14TB硬盘发生故障后,重建期间阵列处于降级状态,如果又有另一块盘故障或出现不可恢复读取错误,数据风险会明显增加。
RAID5可以考虑用于:
如果数据是唯一副本,或者业务对重建期间的可用性和数据安全要求较高,不建议仅为了多出约14TB标称容量而使用RAID5。
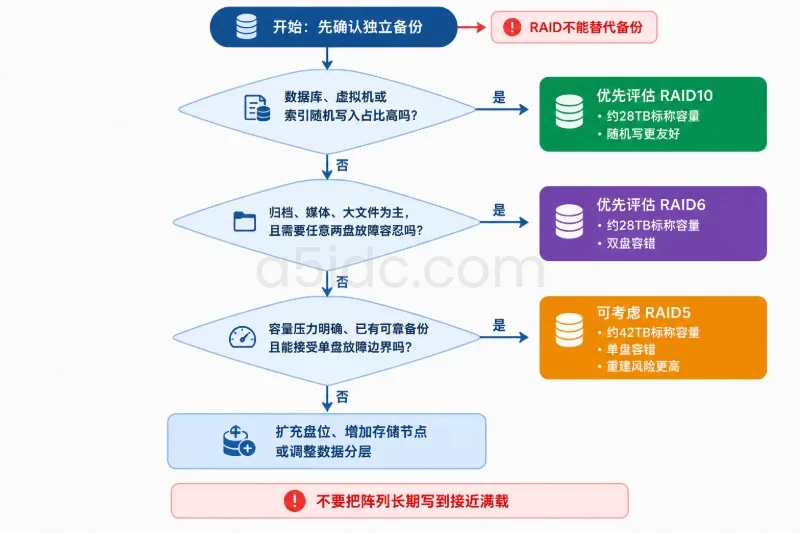
可以按以下顺序判断:
容量预测可以使用下面的关系:
未来业务数据量 = 当前业务数据量 + 月均净增长量 × 预测月数 + 额外保留数据
如果增长是按比例计算,则使用:
未来业务数据量 = 当前业务数据量 × (1 + 月增长率) 的预测月数次方
“额外保留数据”包括数据库日志、临时文件、索引、快照、缩略图、回收站、版本保留和未及时清理的上传文件。备份副本如果放在独立存储上,应单独规划;如果也放在同一阵列中,则必须计入容量,但这种做法不能提供整机故障保护。
假设某业务的规划条件如下:
12个月后的业务数据为:
8TB + 0.5TB × 12 = 14TB
加入15%的额外数据后:
14TB × 1.15 = 16.1TB
为了同时保留5%的系统开销和25%的空闲空间,需要的阵列标称容量约为:
16.1TB ÷ 0.95 ÷ 0.75 ≈ 22.6TB
在这个条件下,四盘RAID10或RAID6的28TB标称容量可以覆盖规划周期,但实际还要观察增长是否稳定。
如果当前数据为14TB、月均增长为0.8TB,同样按12个月和15%的额外空间计算:
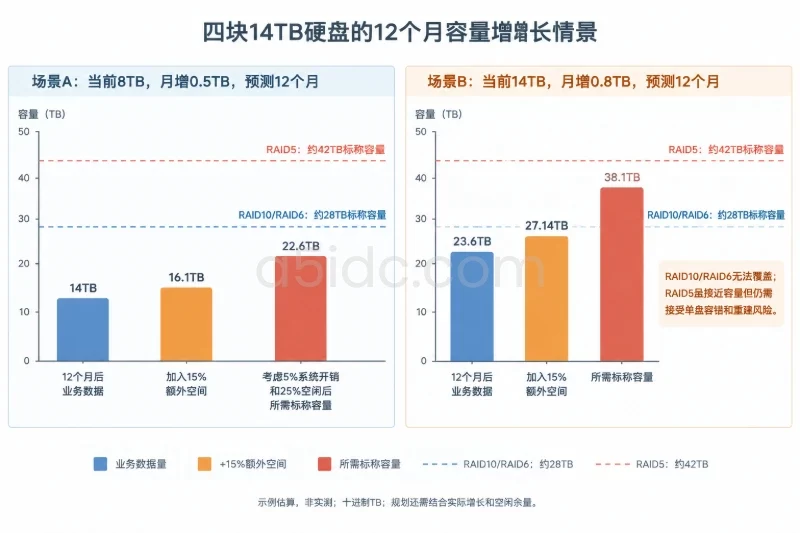
14TB + 0.8TB × 12 = 23.6TB
23.6TB × 1.15 = 27.14TB
27.14TB ÷ 0.95 ÷ 0.75 ≈ 38.1TB
此时RAID10和RAID6都无法在合理余量下覆盖未来12个月,RAID5虽然有42TB标称容量,但需要接受单盘故障边界、重建风险和随机写性能限制。若业务重要性较高,更合理的做法是增加盘位、使用更大容量硬盘、拆分冷热数据,或把归档数据迁移到独立存储。
以下情况会让月均增长失真:
因此,容量预测应同时看30天、90天和峰值周期。至少保留一条“过去90天净增长曲线”,再用峰值周或峰值月修正结果,而不是只用某一天的剩余空间决定是否扩容。
购买香港服务器时,建议将以下内容写入配置确认或交付验收范围:
| 核对项目 | 需要确认的内容 | 验证方式 |
|---|---|---|
| 硬盘规格 | 单盘标称14TB、接口类型、转速、扇区格式 | 查看硬盘识别信息和交付清单 |
| 盘位与背板 | 是否有四个可用盘位,是否支持热插拔 | 查看服务器型号、背板和面板状态 |
| 控制器 | 是否支持目标RAID级别和14TB硬盘 | 查看控制器型号、固件和管理界面 |
| 写缓存 | 是否有电池或闪存保护,当前缓存策略是什么 | 检查控制器状态,不只看配置截图 |
| 阵列状态 | 是否为Optimal,是否存在降级、预测故障或后台重建 | 查看控制器管理界面和系统告警 |
| 逻辑卷 | 实际呈现容量是多少,是否使用GPT | 查看操作系统磁盘和分区信息 |
| 健康状态 | SMART、温度、错误计数和介质错误 | 通过控制器透传工具或厂商管理工具查看 |
| 告警机制 | 硬盘故障、阵列降级、重建失败是否通知管理员 | 做告警路径验证,不直接拔盘测试生产阵列 |
| 备份条件 | 是否有独立备份位置和恢复测试安排 | 核对备份目标、保留周期和恢复时间 |
如果四块硬盘不是完全相同容量,阵列通常会按最小容量参与计算;即使标称容量相同,不同型号的固件、扇区格式和性能差异也可能影响兼容性。不能只根据“都是14TB”就判断可以无条件混用。
可以在Linux系统中用只读方式查看基础设备信息和文件系统占用:
lsblk -o NAME,SIZE,TYPE,MODEL,SERIAL
df -hT
iostat -x 60
其中,df -hT用于查看文件系统容量,iostat -x 60用于观察设备利用率、等待时间和队列变化。硬件RAID下,操作系统可能只看到一个逻辑卷,具体硬盘健康状态仍应通过RAID控制器的管理工具查看。不同厂商工具名称和参数并不统一,不应直接套用不确定的控制器命令。
扩容不应等到文件系统接近100%才开始。可以先设置一组初始阈值,再根据业务基线调整:
| 监控指标 | 观察区间 | 建议动作 |
|---|---|---|
| 文件系统或存储池使用率 | 低于65% | 保持日常监控,记录30天和90天增长率 |
| 文件系统或存储池使用率 | 65%至70% | 检查快照、日志和临时文件,开始估算达到75%的时间 |
| 文件系统或存储池使用率 | 达到70%且持续增长 | 启动扩容或数据迁移评估,避免继续新增长期保留数据 |
| 文件系统或存储池使用率 | 达到80% | 执行扩容、分层或归档计划;不再把临时空间当作长期容量 |
| 文件系统或存储池使用率 | 达到90%及以上 | 进入紧急处理,优先清理可确认的临时数据并限制非必要写入 |
| 磁盘利用率和队列 | 利用率持续超过70%至80%,且等待时间同步升高 | 判断是否为随机IO瓶颈,不要只通过增加容量解决 |
| 应用写延迟 | 95或99分位持续超过业务SLA,或达到平时基线的两倍 | 优先检查RAID写放大、缓存策略和机械盘随机写能力 |
| 阵列状态 | 出现Degraded、预测故障或重建失败 | 立即处理硬盘与备份,不等待容量阈值 |
| 备份任务 | 连续超过备份窗口,或恢复点无法按计划完成 | 调整带宽、备份目标和数据分层,同时重新评估阵列压力 |
| 增长预测 | 按90天增长率计算,预计90天内达到75%至80% | 提前采购硬盘、迁移数据或更换存储架构 |
这里的75%至80%不是所有业务的固定标准。数据库、虚拟机和快照密集型环境可能需要在60%至70%就启动扩容;主要存储不可变归档文件的环境,可以根据写入稳定性和备份策略设定不同阈值。
最终选择可以归纳为:四块14TB硬盘如果重点是随机IO和低延迟,优先评估约28TB标称容量的RAID10;如果重点是归档、媒体和双盘故障容忍,优先评估RAID6;如果容量需求接近30TB、业务写入较轻且已有独立备份,才考虑RAID5。无论采用哪种阵列,都应以未来12个月的数据增长、峰值请求、重建风险和扩容周期共同确定容量,而不是按56TB裸容量直接分配给业务。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/4800.html