香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


接口突然返回 502,监控显示应用进程消失,几秒后又被自动拉起——在香港服务器上遇到这类现象,先不要把原因归到网络或机房。定位故障代码的有效路径是:用访问日志确认受影响请求,用应用日志和系统日志锁定退出时间、PID及退出原因,再用同一次崩溃的核心转储、程序文件和调试符号还原调用栈。
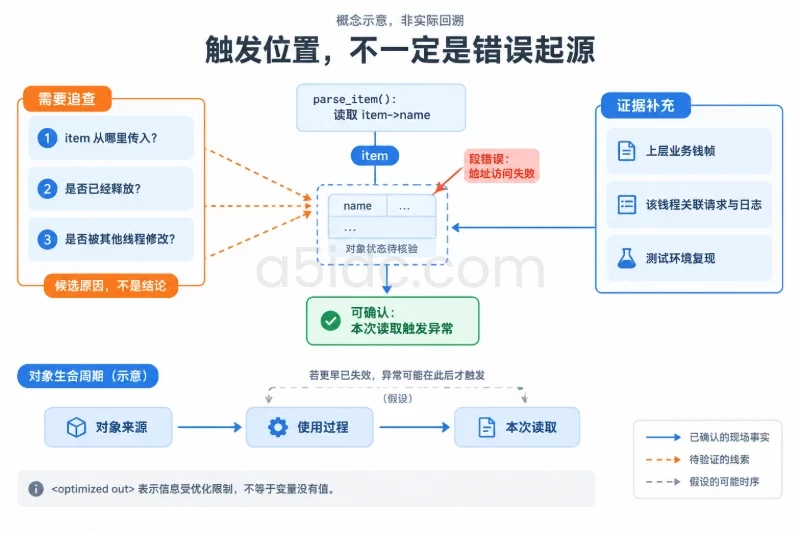
核心转储(core dump)保存的是进程异常终止时的内存、线程和寄存器等现场。它可以帮助找到“在哪个函数、哪一行触发异常”,但不一定直接指出“哪一行最早制造了错误”。例如,堆内存被提前破坏,程序可能直到下一次释放内存才崩溃,因此必须把调用栈与请求、版本和时间线一起分析。
以下命令以使用 systemd 管理服务的 Linux 服务器为例,服务名使用 app.service,执行前应替换为实际名称。核心转储分析主要适用于 C/C++、原生扩展及其他产生原生崩溃的进程;Java、Go等运行时还应结合各自的异常报告、panic日志或堆转储,不能混为一种文件。
先做只读检查,不重启、不改参数:
cat /etc/os-release
systemctl status app.service --no-pager -l
systemctl show app.service \
  -p MainPID -p NRestarts -p Result \
  -p ExecMainCode -p ExecMainStatus -p LimitCORE
status在服务失败时可能返回非零退出码,不代表查询命令本身出了问题。重点看以下信息:
| 观察结果 | 可能含义 | 下一步 |
|---|---|---|
| 进程存在,但请求超时或502 | 阻塞、依赖异常、监听地址错误,未必崩溃 | 检查访问日志、监听端口和应用线程状态 |
code=dumped, status=11/SEGV | 进程因段错误终止,并进入核心转储处理流程 | 查找是否实际保存了可用core |
status=6/ABRT | 程序或运行库主动中止 | 查断言、内存分配器报错及调用栈 |
status=9/KILL | 收到不可捕获的终止信号 | 查OOM、人工操作、容器或管理器事件 |
| 正常退出后被重新启动 | 可能是发布、定时任务或退出逻辑 | 查部署记录和服务生命周期日志 |
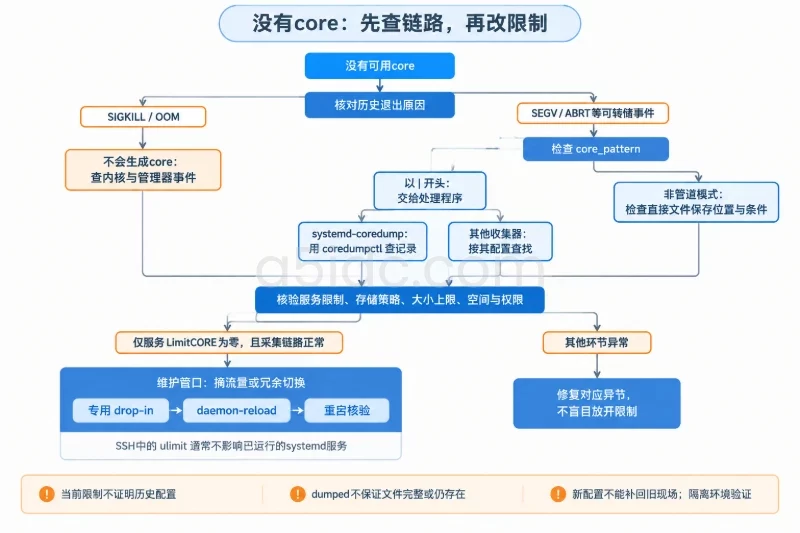
退出信号与核心文件是两回事。 SIGKILL不会生成核心转储;出现dumped也不保证磁盘上仍有完整文件,保存可能被容量策略拒绝,或文件已被清理。
自动重启后,MainPID通常已经变成新进程。分析时应使用历史日志里的崩溃PID,而不是当前PID。
香港业务常使用 UTC+8,但服务器、容器和日志平台可能采用UTC。地区不决定系统时区,先核验:
timedatectl status
date --iso-8601=seconds
建议分析时统一换算为UTC,并保留日志原始时区。以下用一个示例故障窗口查询服务日志和内核日志:
sudo journalctl -u app.service --utc \
  --since "2026-04-12 02:14:00 UTC" \
  --until "2026-04-12 02:17:00 UTC" \
  -o short-iso-precise --no-pager

sudo journalctl -k --utc \
  --since "2026-04-12 02:14:00 UTC" \
  --until "2026-04-12 02:17:00 UTC" \
  -o short-iso-precise --no-pager
预期是把故障前后几分钟的记录收拢,而不是在整天日志里搜索一个error。如果窗口内完全没有记录,应核对时区、日志是否持久化、服务是否写入独立文件,以及故障是否发生在其他实例。
若前端使用Nginx,访问日志重点查看:
request_time、upstream_response_time及upstream_status,前提是当前日志格式已记录这些字段。错误日志中的upstream prematurely closed connection表示上游在响应完成前关闭连接;connect() failed (111: Connection refused)表示连接时没有可用监听者。两者都可能伴随应用退出,但只能证明入口与上游之间发生了什么,不能单独证明是哪段代码崩溃。
如果现有日志没有请求ID,不要为了调查已经发生的事故立即修改生产配置。先使用时间、上游实例和请求路径关联;新增字段可在后续变更窗口完成,经过配置测试后再加载。
应用日志关注崩溃前最后一批记录中的PID、线程ID、请求ID、版本号、断言和异常信息。日志可能因缓冲而未写出,因此“最后一行”不一定就是故障操作。
内核日志则重点找:
segfault:发生非法内存访问;Out of memory、Killed process:内存不足导致进程被杀;下面是一条示例时间线,并非读者服务器上的实际结果:
| UTC时间 | 记录 | 判断 |
|---|---|---|
| 02:15:31.420 | 请求ID r-82进入实例A | 记录故障入口 |
| 02:15:31.426 | 应用PID 18420开始解析数据 | 找到处理阶段 |
| 02:15:31.431 | 内核记录PID 18420发生segfault | 确认进程异常 |
| 02:15:31.433 | Nginx记录上游连接提前关闭 | 解释请求失败 |
| 02:15:32.010 | systemd启动新PID 18503 | 解释服务恢复 |
这种关联比“同一分钟出现了几条错误”更可靠。若香港服务器同时出现跨境请求延迟,应把网络延迟与进程退出分别取证;网络异常可能触发程序中的错误处理缺陷,但不能直接等同于崩溃根因。
先检查服务器使用哪种处理方式:
command -v coredumpctl
cat /proc/sys/kernel/core_pattern
core_pattern以|开头时,表示内核把转储交给处理程序,不是直接写到该字符串对应的文件路径。如果指向systemd-coredump,可以继续使用下面的命令;若指向其他收集器,应按其配置查找记录,不能直接套用。
sudo coredumpctl \
  --since "2026-04-12 02:14:00 UTC" \
  --until "2026-04-12 02:17:00 UTC" list

sudo coredumpctl \
  --since "2026-04-12 02:14:00 UTC" \
  --until "2026-04-12 02:17:00 UTC" info 18420
核对时间、PID、可执行文件路径、信号、文件是否存在,以及是否被截断。PID可能复用,所以应同时限定时间窗口并核对程序身份。
core可能包含密码、令牌、业务请求和用户数据。导出前确认磁盘空间,使用受限目录;不要上传到公开工单附件或不受控的文件分享服务。以下命令在授权的root会话中执行:
umask 077
workdir=$(mktemp -d /var/tmp/app-core.XXXXXX)
printf '%s\n' "$workdir"
df -h "$workdir"

coredumpctl \
  --since "2026-04-12 02:14:00 UTC" \
  --until "2026-04-12 02:17:00 UTC" \
  --output="$workdir/core.18420" dump 18420
预期结果是在该目录得到转储文件。提示“文件不存在”时,可能只保留了元数据;提示截断或读取失败时,不能把它当成完整现场。分析完成后应按数据保留策略清理,仅删除本次确认的文件,不使用宽泛通配符。
systemctl show app.service -p LimitCORE

pid=$(systemctl show app.service -p MainPID --value)
if [ "$pid" -gt 0 ]; then
  sudo grep -i "core file" "/proc/$pid/limits"
fi
当前进程的限制只能说明现在的配置,不能反推出崩溃时一定相同。还应检查收集器的存储策略、大小上限、可用空间及服务用户权限。
在SSH终端执行ulimit -c unlimited,通常不会改变已由systemd启动的服务。若确认采集链路正常,仅服务限制为零,可在维护窗口添加专用drop-in:
# /etc/systemd/system/app.service.d/90-core-debug.conf
[Service]
LimitCORE=infinity
编辑前确认该文件不存在;若已有同名文件,先备份并核对用途,不直接覆盖。修改后执行:
sudo systemctl daemon-reload
sudo systemctl restart app.service
systemctl show app.service -p LimitCORE
重启会中断该实例上的请求,应先摘流量或使用冗余实例。infinity只是解除服务层限制,不代表收集器会无限保存;仍需核验容量策略,避免大进程或反复崩溃占满磁盘。
若这次新增文件需要回滚,可将它改名为不以.conf结尾的文件,再执行daemon-reload并在维护窗口重启。若修改的是既有配置,则恢复备份。不要在生产环境主动发送崩溃信号测试采集,应在隔离环境验证。
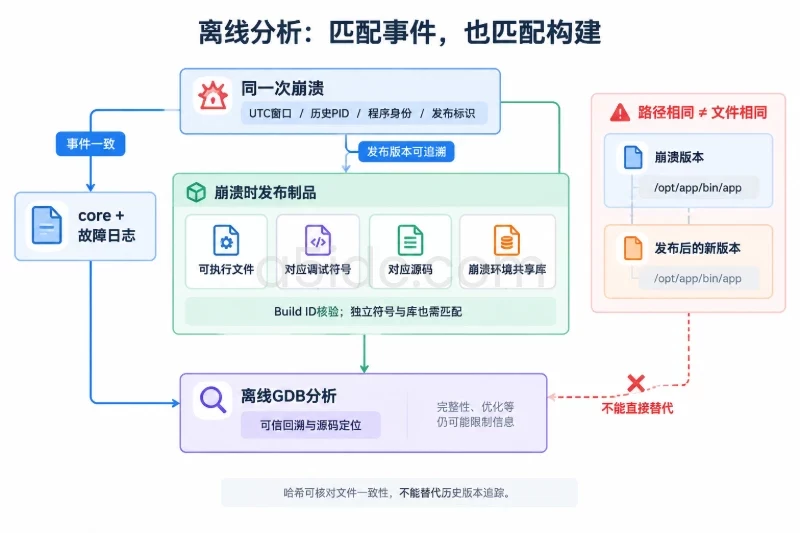
至少准备以下材料:
路径相同不代表文件相同。发布后,/opt/app/bin/app可能已经被替换,应优先取对应发布制品,并用Build ID核对:
file /path/to/release/app
readelf -n /path/to/release/app
共享库和独立符号文件也应匹配。哈希可以证明两份文件是否一致,但无法替代对历史版本的追踪。后续构建可保留生产优化参数,同时生成并归档调试符号;不应为了得到行号,临时把生产服务整体改成无优化构建。
以下使用GDB分析可信来源的现场文件,不附加到线上进程:
gdb -q /path/to/release/app /path/to/core.18420
进入后先执行只读检查:
set pagination off
info files
info sharedlibrary
info threads
thread apply all bt
bt full
frame 0
info args
info locals
list
info registers
GDB通常会提示终止信号,并选择故障线程。thread apply all bt用于观察所有线程;frame 0查看直接触发异常的位置,再逐层切换到上层业务栈帧。
若大量帧显示??,先检查符号和共享库是否匹配,不要立即认定栈被破坏。离线库位于镜像副本中时,可按实际目录设置:
set sysroot /path/to/rootfs
set solib-search-path /path/to/matching-libs
set debug-file-directory /path/to/debug-symbols
设置后重新核对库加载情况。不要为了消除提示随意使用分析机上的同名库,否则可能得到误导性的栈和行号。
| 分析结果 | 更合理的排查方向 |
|---|---|
| 业务函数直接解引用空指针 | 查初始化失败、空值分支及对象生命周期 |
崩溃落在memcpy等函数 | 向上查看调用者,核对地址、长度和缓冲区边界 |
| 出现double free或堆损坏提示 | 查重复释放、越界写、释放后使用;触发点可能晚于破坏点 |
在断言或abort路径退出 | 对照应用日志确认断言条件为何失败 |
| 栈混乱或回溯提前中断 | 排除符号不匹配、优化影响和转储不完整,再考虑栈破坏 |
| 内核明确记录OOM且无core | 转向内存曲线、容器限制及分配行为,不能靠core定位 |
例如,回溯显示parse_item()中的item->name读取触发段错误,只能确认该地址访问失败。还需检查item来自哪里、是否已释放、是否被另一个线程修改,并把该线程对应的请求与故障日志关联。优化构建下部分变量可能显示<optimized out>,这是信息限制,不是变量没有值。
涉及越界、释放后使用或竞态时,可在测试环境使用AddressSanitizer或ThreadSanitizer等工具复现。它们会改变资源开销和时序,不应未经评估直接替换生产构建。
修复应针对已经形成证据链的问题:如果对象在失败分支中未初始化,应完善该分支;如果是共享对象生命周期竞态,仅增加一次空指针判断通常不足以解决问题。
上线前,把故障请求形态、并发条件和依赖失败情形转成回归测试,避免把生产敏感数据直接复制到测试环境。容器中的故障还要记录容器ID、镜像摘要及宿主机对应PID,不能混用容器PID与宿主机PID。
验证至少包含三个层面:
短时间没有崩溃不能证明低频竞态已经消除。观察周期应结合原发生频率和业务峰值确定,并保留版本、日志时间线和core指纹之间的关联。临时开启的采集配置也应在调查结束后复核,控制留存时间和磁盘使用,让下一次异常能够留下足够现场,而不是让诊断数据成为新的故障来源。
围绕香港应用服务的运行与故障分析,A5数据提供Xeon Gold、AMD EPYC等物理服务器方案,以多档内存及SSD、NVMe存储承载业务后台、数据库和接口服务,也为独立分析环境中的转储读取、符号加载与多线程调试提供硬件基础。香港存储系列可用于集中留存核心转储、历史程序版本和日志归档,CN2与国际带宽方案则覆盖不同访问方向的网络资源需求。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/4123.html


