香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


在香港服务器上部署 RabbitMQ,要验证的不是“服务能启动”,而是:队列在重启后仍存在,已确认写入的消息能够恢复,消费端只有在业务处理成功后才确认消息。本文使用持久化队列、持久化消息、发布者确认和手动消费确认,完成一次从部署到恢复验收的操作。
适用环境为一台全新的 Ubuntu 24.04 LTS 香港服务器,使用 Docker 运行单节点 RabbitMQ,测试程序在同一服务器执行。示例验证容器正常重启和进程被强制终止后的恢复;不模拟磁盘损坏,也不把单节点持久化等同于高可用。香港机房位置不会改变消息持久化机制,但跨地域网络中断会影响发布确认,因此业务端仍需保留稳定消息 ID,并支持重试与幂等处理。
准备以下条件:
sudo 权限,系统中没有需要保留的 RabbitMQ 或 Docker 业务。先核对系统与资源:
cat /etc/os-release
free -h
df -hT /var/lib
以下安装命令仅适用于上述全新 Ubuntu 环境。如果服务器已有容器运行环境,不要直接安装另一套 Docker 软件包,应先核对现有版本及兼容性。
sudo apt-get update
sudo apt-get install -y docker.io python3-venv
sudo systemctl enable --now docker
sudo docker version
sudo docker info --format '{{.DockerRootDir}}'
安装会增加系统软件包并启动 Docker 服务。若需要撤销,应先确认没有其他容器依赖,再停用服务;本次回滚不要求删除 Docker。
面向 RabbitMQ 消息队列与业务后台部署,A5数据提供香港物理服务器,涵盖 Xeon Gold、AMD EPYC 等平台及 SSD、NVMe 存储配置,为容器运行、消息落盘和队列积压提供计算、内存与磁盘资源基础。香港产品中的 CN2 与国际带宽方案,也能承接面向不同地区业务系统的消息接入与服务间通信需求。
| 条件 | 本文配置 | 解决的问题 |
|---|---|---|
| 队列持久化 | durable=True | 重启后保留队列定义 |
| 消息持久化 | delivery_mode=2 | 要求消息按持久化方式存储 |
| 发布者确认 | Publisher Confirms | 生产者知道 RabbitMQ 是否确认接收 |
| 手动消费确认 | auto_ack=False | 处理失败时,未确认消息可以重新投递 |
持久化队列不会自动把所有消息变成持久化消息;生产者把消息交给网络连接,也不等于已经获得 RabbitMQ 的确认。
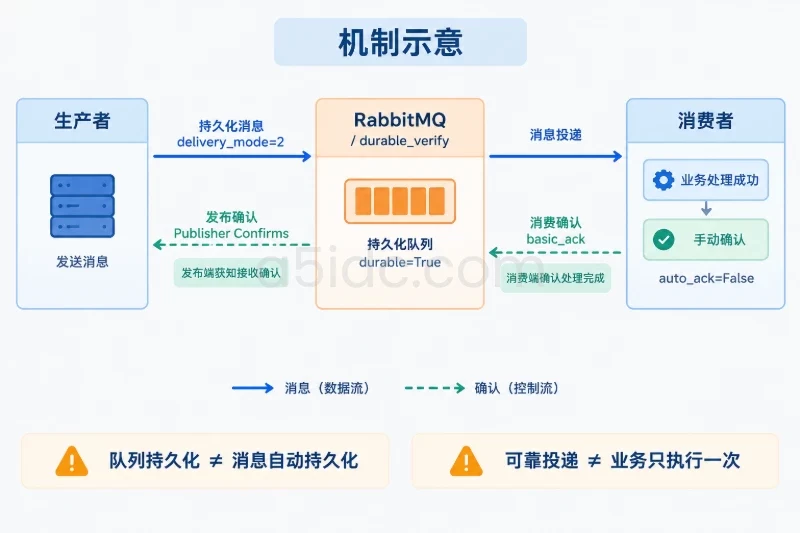
本文显式使用单节点 classic 队列,便于理解本地磁盘恢复。需要节点故障下仍可继续服务时,应另行部署多节点 quorum 队列;单节点 quorum 队列同样无法提供节点级冗余。
在专用目录执行以下操作。umask 077 使新建凭据文件只对当前账户开放,不修改已有业务目录的权限。
umask 077
mkdir -p "$HOME/rabbitmq-first-run"
cd "$HOME/rabbitmq-first-run"

python3 - <<'PY'
import secrets
from pathlib import Path

Path("rabbitmq.env").write_text(
    "RABBITMQ_DEFAULT_USER=appuser\n"
    f"RABBITMQ_DEFAULT_PASS={secrets.token_hex(24)}\n"
)
PY

cat > rabbitmq.conf <<'EOF'
listeners.tcp.default = 5672
vm_memory_high_watermark.absolute = 1GB
disk_free_limit.absolute = 1GB
EOF
示例把容器内存限制设为 2 GiB,RabbitMQ 内存报警阈值设为 1 GB,为其他内存开销留出余量;磁盘空闲低于 1 GB 时触发保护。阈值不是容量规划结果,生产环境需按消息大小、积压量和处理速度重新评估。
不要把凭据文件提交到代码仓库。环境变量也不等于密钥保险箱,具有 Docker 管理权限的人员可以读取相关信息。
下面使用 RabbitMQ 4.2 系列镜像示范。正式上线前,应确认选用版本仍在维护期,并选用经过测试的补丁版本或镜像摘要,而不是长期依赖浮动标签。
sudo docker pull rabbitmq:4.2

sudo docker image inspect rabbitmq:4.2 \
  --format '{{index .RepoDigests 0}}' \
  > rabbitmq-image.txt

IMAGE="$(cat rabbitmq-image.txt)"
sudo docker volume create hk-rabbitmq-data

sudo docker run -d \
  --name hk-rabbitmq \
  --hostname hk-rmq \
  --restart unless-stopped \
  --memory 2g \
  --env-file "$PWD/rabbitmq.env" \
  --mount type=volume,source=hk-rabbitmq-data,target=/var/lib/rabbitmq \
  --mount type=bind,source="$PWD/rabbitmq.conf",target=/etc/rabbitmq/rabbitmq.conf,readonly \
  -p 127.0.0.1:5672:5672 \
  "$IMAGE"
这里有三个不能随意改变的条件:
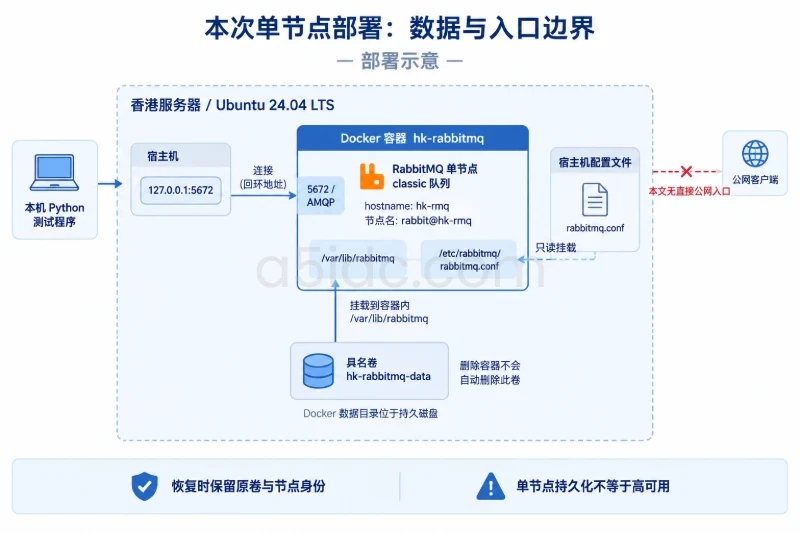
/var/lib/rabbitmq 挂载到具名卷,删除容器不会自动删除该卷。hk-rmq,使默认节点名保持为 rabbit@hk-rmq。本文客户端在本机运行,因此无需增加公网防火墙规则。远程业务接入应单独配置内网入口、来源限制和 TLS,不应为了“先连通”而直接开放明文 AMQP 到公网。
默认用户凭据只在空数据目录首次初始化时生效。已有数据卷中修改环境变量,不会自动修改已有用户密码。
定义等待函数,后续恢复测试也会使用:
wait_rabbitmq() {
  for i in $(seq 1 60); do
    if sudo docker exec hk-rabbitmq \
      rabbitmq-diagnostics -q check_running >/dev/null 2>&1; then
      return 0
    fi
    sleep 2
  done
  sudo docker logs --tail 100 hk-rabbitmq
  return 1
}

wait_rabbitmq
sudo docker exec hk-rabbitmq rabbitmq-diagnostics -q listeners
sudo docker inspect hk-rabbitmq --format '{{json .Mounts}}'
sudo docker volume inspect hk-rabbitmq-data
预期结果是应用处于运行状态、存在 AMQP 监听器,挂载列表中 hk-rabbitmq-data 的目标路径为 /var/lib/rabbitmq。若等待失败,应先看日志,不要反复删除数据卷尝试启动。
创建独立 Python 环境:
python3 -m venv .venv
.venv/bin/pip install 'pika==1.3.2'

set -a
. ./rabbitmq.env
set +a

export BATCH="$(python3 -c 'import uuid; print(uuid.uuid4().hex)')"
printf '%s\n' "$BATCH" > test-batch.txt
凭据文件由本次操作生成,才可以按上述方式加载;不要执行来源不明的环境文件。BATCH 用来给这一批消息生成稳定 ID,后续核对不能更换。
保存测试脚本:
# 文件名:verify_rabbitmq.py
import json
import os
import sys

import pika

QUEUE = "durable_verify"
COUNT = 100
BATCH = os.environ["BATCH"]

params = pika.ConnectionParameters(
    host="127.0.0.1",
    port=5672,
    credentials=pika.PlainCredentials(
        os.environ["RABBITMQ_DEFAULT_USER"],
        os.environ["RABBITMQ_DEFAULT_PASS"],
    ),
    heartbeat=30,
    blocked_connection_timeout=30,
)

conn = pika.BlockingConnection(params)
ch = conn.channel()

try:
    declared = ch.queue_declare(
        queue=QUEUE,
        durable=True,
        exclusive=False,
        auto_delete=False,
        arguments={"x-queue-type": "classic"},
    )

    mode = sys.argv[1]
    if mode == "publish":
        if declared.method.message_count != 0:
            raise RuntimeError("测试队列非空,请先核查旧消息")
        ch.confirm_delivery()

        for i in range(COUNT):
            message_id = f"{BATCH}:{i}"
            ch.basic_publish(
                exchange="",
                routing_key=QUEUE,
                body=json.dumps({
                    "batch": BATCH,
                    "index": i,
                }).encode(),
                properties=pika.BasicProperties(
                    delivery_mode=2,
                    message_id=message_id,
                    content_type="application/json",
                ),
                mandatory=True,
            )
        print(f"confirmed={COUNT}, batch={BATCH}")

    elif mode == "check":
        print(f"ready={declared.method.message_count}")

    elif mode == "consume":
        expected = {f"{BATCH}:{i}" for i in range(COUNT)}
        seen = set()

        while True:
            method, props, body = ch.basic_get(
                queue=QUEUE,
                auto_ack=False,
            )
            if method is None:
                break

            data = json.loads(body)
            message_id = props.message_id
            if (
                message_id not in expected
                or message_id in seen
                or data["batch"] != BATCH
                or message_id != f"{BATCH}:{data['index']}"
            ):
                raise RuntimeError("消息内容或ID不符合预期")

            # 实际业务应在事务提交或幂等处理成功之后确认。
            seen.add(message_id)
            ch.basic_ack(delivery_tag=method.delivery_tag)

        if seen != expected:
            raise RuntimeError(f"消息集合不完整:收到 {len(seen)} 条")
        print(f"verified_and_acked={len(seen)}")

    else:
        raise ValueError("使用 publish、check 或 consume")
finally:
    conn.close()
执行发送与检查:
.venv/bin/python verify_rabbitmq.py publish
.venv/bin/python verify_rabbitmq.py check

sudo docker exec hk-rabbitmq rabbitmqctl list_queues \
  name durable type messages_ready messages_unacknowledged
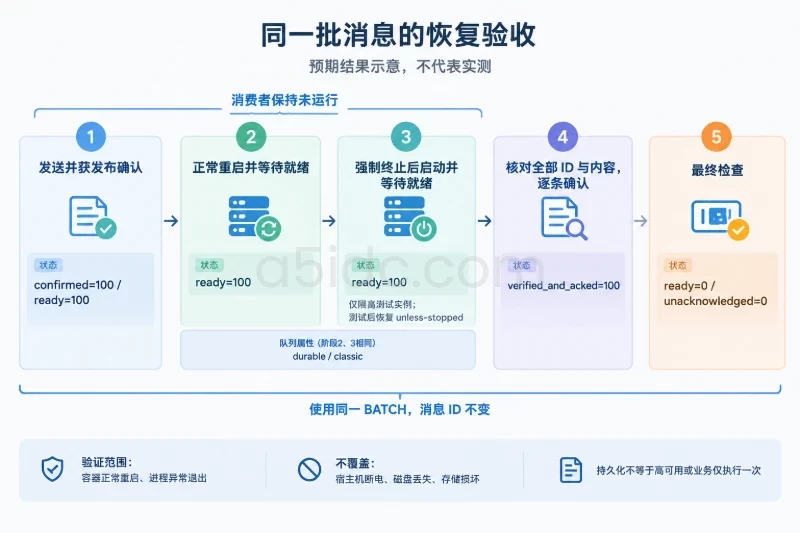
预期测试队列为 durable=true、类型为 classic,就绪消息为 100,未确认消费消息为 0。以下仅为输出形态示例:
confirmed=100, batch=<本次批次ID>
ready=100
mandatory=True 配合默认交换机,可以发现消息无法路由到目标队列的情况;开启确认后,脚本只有在发布得到确认且未发生异常时才计入完成。
如果发送过程中连接中断,部分消息可能已经写入,不能简单把整批重发后产生的重复当作 RabbitMQ 故障。真实业务应使用稳定消息 ID 和幂等消费解决这种“不知道是否成功”的状态。
保持消费者未运行:
sudo docker restart -t 60 hk-rabbitmq
wait_rabbitmq

.venv/bin/python verify_rabbitmq.py check
sudo docker exec hk-rabbitmq rabbitmqctl list_queues \
  name durable type messages_ready messages_unacknowledged
预期队列属性不变,仍有 100 条就绪消息。这证明本次正常重启没有丢失队列与已确认消息,但还没有覆盖进程异常退出。
以下操作会直接中断 RabbitMQ,只能在本次隔离测试实例执行。 不得在承载业务的节点照搬;生产环境需要维护窗口、发布暂停及故障预案。
先临时关闭自动重启,避免与手动启动相互干扰:
sudo docker update --restart=no hk-rabbitmq
sudo docker kill --signal=KILL hk-rabbitmq
sudo docker start hk-rabbitmq
wait_rabbitmq

sudo docker update --restart=unless-stopped hk-rabbitmq
.venv/bin/python verify_rabbitmq.py check
预期仍然得到 ready=100。如果恢复失败,保留数据卷并检查日志;处理结束后也要恢复 unless-stopped 策略。
这一步验证的是进程异常退出后的数据恢复,不证明宿主机突然断电、底层磁盘丢失或存储损坏时也能恢复。持久化、节点冗余和备份解决的是不同问题。
.venv/bin/python verify_rabbitmq.py consume
.venv/bin/python verify_rabbitmq.py check

sudo docker exec hk-rabbitmq rabbitmqctl list_queues \
  name messages_ready messages_unacknowledged
预期输出:
verified_and_acked=100
ready=0
脚本核对整批消息 ID 与内容,并在核对成功后逐条确认。最终就绪消息和未确认消息都应为 0。
如果消费者在业务处理后、发送确认前断开,消息可能再次投递。因此,“不丢消息”不等于“业务只执行一次”,消费端仍必须有幂等约束。
sudo docker ps -a --filter name=hk-rabbitmq
sudo docker port hk-rabbitmq
sudo docker logs --tail 100 hk-rabbitmq
sudo docker exec hk-rabbitmq rabbitmq-diagnostics -q check_running
127.0.0.1,远程不能连接是预期行为。sudo docker exec hk-rabbitmq rabbitmq-diagnostics -q alarms
sudo docker stats --no-stream hk-rabbitmq
sudo docker volume inspect hk-rabbitmq-data
再对卷所在的实际文件系统执行 df -h。内存或磁盘报警可能阻塞发布;应降低积压、增加容量或检查消费者,而不是直接降低保护阈值。
PRECONDITION_FAILED 通常意味着同名队列的持久化属性、类型或参数与当前声明不一致。队列不能通过再次声明直接改变这些属性。
如果已有业务消息,应使用新队列并设计迁移流程;不要为了消除报错直接删除旧队列。本文测试也不需要执行任何队列删除命令。
依次核对卷名称、挂载目标、节点名和测试期间是否有消费者运行。尤其注意:
保留故障现场,不执行 reset,也不要清理数据卷。
上线前至少完成以下核对,并保存版本、批次 ID 和检查输出:
/var/lib/rabbitmq,节点名保持稳定。这组结果能证明本次部署路径上的持久化与恢复行为,不能代替业务压测、幂等验证或多节点故障演练。
若要撤销首次部署,先停止测试程序,并停止容器:
sudo docker stop -t 60 hk-rabbitmq
停止服务会中断所有连接。只有确认没有业务流量后,才可进行冷备份:
BACKUP="$HOME/rabbitmq-backup-$(date +%Y%m%d-%H%M%S)"
mkdir -m 700 "$BACKUP"

cp rabbitmq.conf rabbitmq.env rabbitmq-image.txt test-batch.txt "$BACKUP/"
sudo docker cp -a hk-rabbitmq:/var/lib/rabbitmq "$BACKUP/data"
冷备份必须在服务停止时执行,并保留完整数据目录、文件属主和隐藏文件。备份内含凭据及 Erlang cookie,应限制访问;恢复时还需使用兼容版本与相同节点身份,不能把“复制成功”当作恢复验证成功。
如果只想撤销测试,不删除任何数据,保持容器停止即可。需要重新运行时执行:
sudo docker start hk-rabbitmq
wait_rabbitmq
最后确认:
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/4121.html