香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


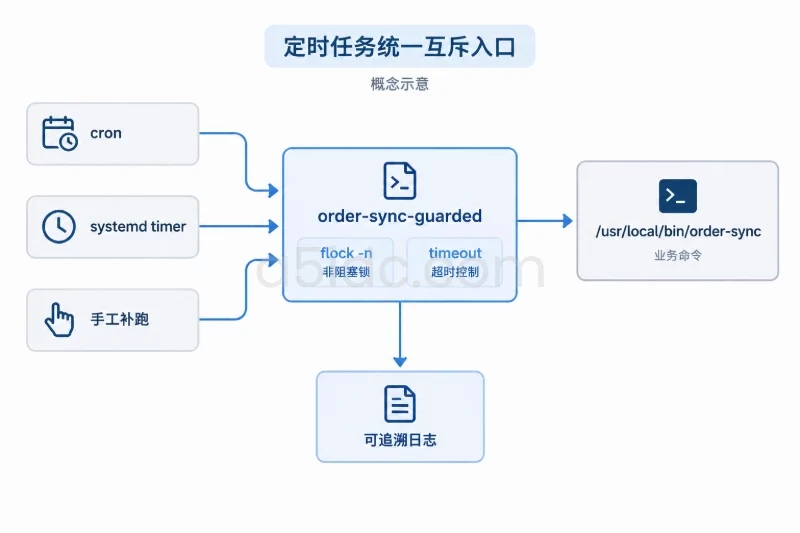
在已有香港服务器上维护定时任务,避免重叠执行的关键不是简单把执行间隔调大,而是让所有启动入口都经过同一个互斥控制层,并同时明确“任务正在运行时,新的调度应该跳过、排队还是合并”。推荐使用单一调度器、flock 文件锁、执行超时、幂等业务处理和可追溯日志配合实现。
香港服务器的物理位置不等于服务器使用香港时区。上线前应先确认系统时区、任务调度器时区和业务时间窗口是否一致,再检查是否存在重复配置的 cron、systemd timer 或控制面板任务。否则,即使加了锁,也可能出现大量“跳过执行”或错过业务窗口的情况。
A5数据提供中国香港物理服务器租用,覆盖入门建站、Xeon Gold与AMD EPYC等配置,并配备SSD或NVMe存储及不同内存规格,可承载业务后台、数据库、接口服务和多任务计算。结合CN2与国际带宽线路,香港服务器能够为定时任务脚本、日志记录及相关业务进程提供稳定的运行资源基础;同时,A5数据也提供美国、日本、新加坡等地区的物理服务器,满足多节点业务的部署需求。
不要直接修改现有 crontab。先保存当前配置,并确认同一个任务是否已经被多个调度器管理。
crontab -l
sudo crontab -l
sudo grep -R "order-sync\|report-job\|backup-job" /etc/cron.d /etc/cron.daily /etc/cron.hourly /etc/cron.weekly 2>/dev/null
systemctl list-timers --all
上面的 order-sync、report-job 和 backup-job 只是示例关键词,应替换成实际脚本名、服务名或业务命令。还需要检查面板、部署脚本和应用自身的计划任务,避免只检查系统级 cron,却遗漏应用内部调度。
同时确认任务由哪个用户执行:
ps -eo user,pid,ppid,lstart,cmd --sort=lstart | grep -E "order-sync|report-job" | grep -v grep
systemctl cat order-sync.service 2>/dev/null
执行账户会影响以下内容:
不要为了方便把任务改成 root 用户运行。若现有任务使用 app、deploy 或其他专用账户,应沿用该账户,并为锁目录和日志目录单独授予必要权限。
先查看服务器的时间状态:
timedatectl
date -Is
如果业务要求每天香港时间凌晨 2 点执行,日志中应能明确看到对应的时间偏移,例如:
2025-03-08T02:00:04+08:00 result=started task=order-sync
如果系统采用 UTC,而任务又按照本地时间理解,cron 和 systemd timer 的配置含义可能不同。不要直接修改系统时区来“修正”单个任务,因为其他应用、日志、数据库和证书任务可能也依赖当前时区。优先在调度器层明确时区,并用调度器提供的校验命令确认下一次触发时间。
设任务计划间隔为 T,一次正常执行的典型耗时为 R,超时上限为 W。当 R 接近或超过 T 时,任务就有重叠可能。例如:
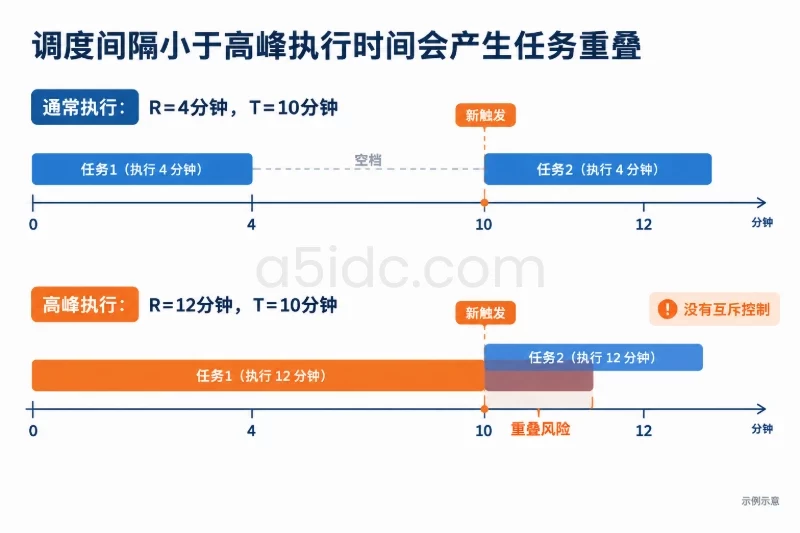
这种情况下,单纯依赖 cron 会在第 10 分钟再次启动任务。数据库同步、批量发送、账单生成和备份任务尤其容易因重复执行造成重复写入、重复扣费、重复通知或文件覆盖。
还要把重试时间计算进去。如果任务失败后由外层脚本重试两次,实际占用时间可能是:
总执行时间 = 第一次执行时间 + 第一次失败后的等待时间 + 第二次执行时间 + 第二次失败后的等待时间 + 第三次执行时间
因此,不能只按平时成功运行的耗时判断是否会重叠。
防止进程同时运行,不等于自动解决了任务遗漏。应先确定任务在前一次执行尚未结束时的处理方式。
| 策略 | 新触发到来时的处理 | 适用任务 | 主要风险 |
|---|---|---|---|
| 跳过 | 记录一次跳过,不启动新进程 | 读取当前状态、缓存刷新、周期性汇总 | 可能遗漏某个时间窗口 |
| 排队 | 将待执行窗口记录下来,前一次结束后继续执行 | 每个时间窗口都必须处理的账务、同步任务 | 队列积压 |
| 合并 | 多个待执行窗口合并为一次处理 | 只关心最新状态的同步任务 | 需要业务逻辑支持合并 |
| 替换 | 停止旧任务,启动新任务 | 少数只关心最新结果的计算任务 | 可能留下半成品或部分写入 |
多数“同步当前数据”类任务可以采用跳过或合并;账单、结算、逐小时统计和需要完整处理每个窗口的任务,不应简单采用跳过策略。锁只负责控制并发,不能替代业务侧的补偿和追账逻辑。
以下以执行用户 app 和任务名称 order-sync 为例。执行前先确认账户名称,不要直接套用。
id app
command -v flock
command -v timeout
如果当前任务确认由 app 用户执行,可以准备目录:
sudo install -d -o app -g app -m 0750 /var/lib/myapp/locks
sudo install -d -o app -g app -m 0750 /var/log/myapp
如果目录已经存在,应先检查目录所有者和其中的文件。直接修改所有权可能影响其他程序,尤其是日志轮转、部署脚本和应用进程。锁文件本身不保存“任务是否正在运行”的业务状态,flock 使用的是内核文件锁,因此不应在发现任务异常后随意删除锁文件。
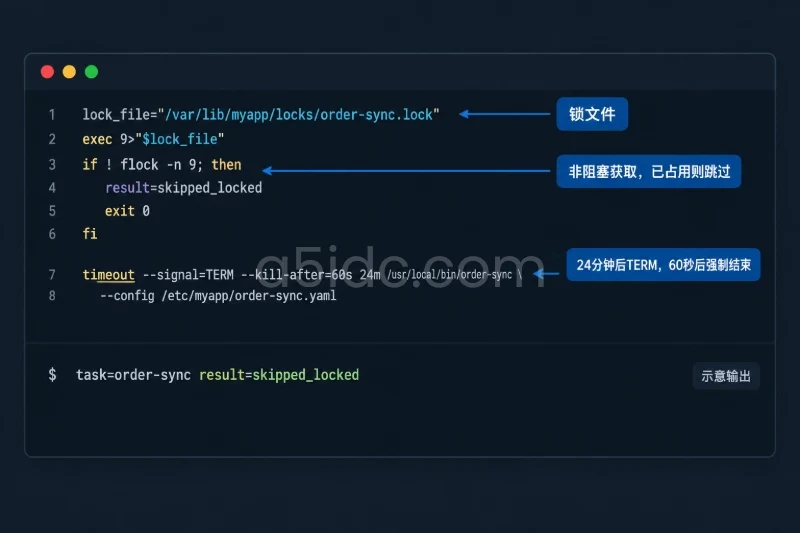
创建 /usr/local/sbin/order-sync-guarded,让 cron、systemd timer 和手工补跑都调用这个入口:
#!/usr/bin/env bash
set -Eeuo pipefail
umask 027

task_name="order-sync"
lock_file="/var/lib/myapp/locks/${task_name}.lock"
log_file="/var/log/myapp/${task_name}.log"
config_file="/etc/myapp/order-sync.yaml"

exec >>"$log_file" 2>&1

timestamp() {
    date -Is
}

printf '%s task=%s event=triggered\n' "$(timestamp)" "$task_name"

# 文件描述符 9 会在脚本结束时自动释放。
exec 9>"$lock_file"

if ! flock -n 9; then
    printf '%s task=%s result=skipped_locked\n' "$(timestamp)" "$task_name"
    exit 0
fi

printf '%s task=%s result=started pid=%s\n' "$(timestamp)" "$task_name" "$$"

# 24 分钟后先发送 TERM,等待 60 秒仍未退出再强制结束。
if timeout --signal=TERM --kill-after=60s 24m \
    /usr/local/bin/order-sync --config "$config_file"; then
    printf '%s task=%s result=success\n' "$(timestamp)" "$task_name"
    exit 0
else
    rc=$?
    printf '%s task=%s result=failed exit_code=%s\n' "$(timestamp)" "$task_name" "$rc"
    exit "$rc"
fi
赋予脚本执行权限,并确认文件内容和权限:
sudo chown root:root /usr/local/sbin/order-sync-guarded
sudo chmod 0750 /usr/local/sbin/order-sync-guarded
sudo -u app test -x /usr/local/sbin/order-sync-guarded
sudo -u app test -w /var/lib/myapp/locks
sudo -u app test -w /var/log/myapp
这里的 flock -n 是非阻塞模式。当前已有任务持有锁时,新触发会立即记录 skipped_locked 并退出,而不会排队等待。这样可以避免调度器积累大量处于等待状态的进程。
锁文件不要在故障处理中直接删除。即使文件仍然存在,只要持锁的进程已经退出,下一次 flock 仍然可以正常获取锁。删除锁文件反而可能使新进程锁住新文件,而旧进程仍然持有旧文件的锁,造成两个任务同时运行。
如果系统已经使用 systemd,通常可以用 systemd timer 管理周期任务。先创建服务文件 /etc/systemd/system/order-sync.service:
[Unit]
Description=Run order synchronization with a concurrency guard
After=network-online.target
Wants=network-online.target

[Service]
Type=oneshot
User=app
Group=app
ExecStart=/usr/local/sbin/order-sync-guarded
TimeoutStartSec=25min
再创建 /etc/systemd/system/order-sync.timer:
[Unit]
Description=Schedule order synchronization

[Timer]
OnCalendar=*-*-* 02:00:00 Asia/Hong_Kong
Persistent=true
AccuracySec=1min
Unit=order-sync.service

[Install]
WantedBy=timers.target
这个示例表示每天香港时间 2 点触发。Persistent=true 表示服务器在计划时间关机或停止服务后,恢复运行时可能补触发一次。对于备份、账务和必须处理的时间窗口,这通常有价值;对于只需要最新状态的刷新任务,可以结合业务要求改为不补跑,避免恢复后突然产生大量任务。
在启用前,先验证服务文件和时间表达式:
sudo systemd-analyze verify \
    /etc/systemd/system/order-sync.service \
    /etc/systemd/system/order-sync.timer

systemd-analyze calendar '*-*-* 02:00:00 Asia/Hong_Kong'
确认输出的下一次触发时间正确后,再加载并启用:
sudo systemctl daemon-reload
sudo systemctl enable --now order-sync.timer
systemctl list-timers order-sync.timer
不要在 systemd timer 已经启用的同时,再保留相同任务的 cron。更换调度器前,应先记录旧配置,确认当前没有任务运行,再停用旧入口。停用动作可能改变任务触发行为,执行前应检查对应 unit 名称,不要使用不明确的批量停止命令。
如果现有环境只能使用 cron,也应让 cron 调用同一个包装脚本:
0 2 * * * /usr/local/sbin/order-sync-guarded
cron 通常使用 cron 守护进程的系统时区,具体行为取决于发行版和 cron 实现。需要香港时间时,应先查阅当前系统的 cron 配置和帮助文档;如果版本对 CRON_TZ 支持明确,也可以在当前用户的 crontab 中使用:
CRON_TZ=Asia/Hong_Kong
0 2 * * * /usr/local/sbin/order-sync-guarded
不确认实现是否支持时,不要仅凭配置格式判断结果。可以改用已验证过时区表达式的 systemd timer,或者根据服务器当前时区换算计划时间,并把换算结果记录在配置变更单中。
定时任务的脚本、服务文件、timer 文件和业务配置应纳入版本管理。密码、令牌等敏感值不要直接提交到代码仓库,可以在服务器上使用权限受限的环境文件或密钥管理方式。
变更前先备份当前文件:
backup_dir="/var/backups/order-sync/$(date +%Y%m%d-%H%M%S)"

sudo install -d -m 0700 "$backup_dir"
sudo cp -a /usr/local/sbin/order-sync-guarded "$backup_dir/"
sudo cp -a /etc/systemd/system/order-sync.service "$backup_dir/"
sudo cp -a /etc/systemd/system/order-sync.timer "$backup_dir/"

sha256sum \
    /usr/local/sbin/order-sync-guarded \
    /etc/systemd/system/order-sync.service \
    /etc/systemd/system/order-sync.timer
如果任务原本由 cron 管理,还应保存对应用户的 crontab:
crontab -l > "$backup_dir/app.crontab"
sudo crontab -l > "$backup_dir/root.crontab"
备份文件中可能包含路径、内部服务名或其他敏感信息,应限制目录权限,并避免直接上传到公开仓库。
更新脚本或 systemd 配置时,先在临时路径完成检查,再覆盖正式文件。对于服务文件,替换后必须执行 systemctl daemon-reload;仅修改文件而不 reload,运行中的 systemd 仍可能使用旧配置。
推荐的变更顺序是:
systemd-analyze verify 检查 unit。daemon-reload。如果只是修改执行时间,通常不会影响当前已启动的业务进程;如果修改锁路径、执行账户、超时时间或实际命令,则可能改变并发控制和任务结果,应按高风险变更处理。
systemd 环境可以使用以下命令检查:
systemctl status order-sync.timer --no-pager
systemctl list-timers --all | grep order-sync
systemctl show order-sync.service \
    -p ActiveState \
    -p SubState \
    -p Result \
    -p ExecMainStatus

tail -n 50 /var/log/myapp/order-sync.log
正常情况下,日志应能区分至少四种结果:
2025-03-08T02:00:00+08:00 task=order-sync event=triggered
2025-03-08T02:00:00+08:00 task=order-sync result=started pid=18420
2025-03-08T02:04:18+08:00 task=order-sync result=success
如果发生重叠触发,应看到类似记录:
2025-03-08T02:10:00+08:00 task=order-sync event=triggered
2025-03-08T02:10:00+08:00 task=order-sync result=skipped_locked
skipped_locked 不是业务成功。它只表示互斥控制生效。监控系统应统计跳过次数,并根据任务策略决定是否告警。如果任务要求每个时间窗口都处理,就需要把跳过的时间窗口写入待处理记录,而不是仅输出一行日志。
任务运行期间,可以从进程和日志两个角度确认是否只有一个执行实例:
ps -eo pid,ppid,user,etime,stat,cmd | grep -E "order-sync|order-sync-guarded" | grep -v grep
lslocks | grep -E "order-sync|myapp"
重点检查:
如果任务每 10 分钟运行一次,而连续多次执行耗时达到 9 分钟以上,应提前调整策略。即使目前没有出现双进程,也可能在流量高峰或外部接口变慢时重叠。
文件锁只能控制同一台服务器上经过同一锁文件的进程。它不能防止以下情况:
因此,业务动作本身还应具备幂等控制。例如,以“业务日期加时间窗口”作为唯一处理键,在数据库事务中记录执行状态;重复收到相同处理键时,返回已处理结果,而不是再次写入。涉及文件生成时,可以先写入临时文件,校验成功后再原子改名,避免任务中断留下半成品。
skipped_locked先确认是否确实有任务正在运行:
systemctl status order-sync.service --no-pager
ps -eo pid,ppid,user,etime,stat,cmd | grep -E "order-sync|order-sync-guarded" | grep -v grep
如果存在正常运行的进程,不要删除锁文件,也不要立即启动第二个实例。等待任务结束,检查它是否在超时时间内完成。
如果日志显示锁被占用,但没有对应进程,通常是检查方式不完整,或者任务已退出而下一次触发已经重新获取了锁。flock 的内核锁会随持锁进程释放,孤立的锁文件本身不会永久阻止任务。应检查实际锁持有者和任务日志,而不是根据文件是否存在判断故障。
超时处理可能中断数据库操作、文件写入或外部接口调用。先确认任务是否支持安全终止,以及业务操作是否具有事务性。
systemd 管理的任务可以执行:
sudo systemctl stop order-sync.service
该命令会影响当前正在运行的任务,可能留下部分处理结果。执行前应记录当前 PID、日志最后一行和业务处理窗口;停止后应检查数据库事务、临时文件和外部接口状态。不要使用宽泛的 killall 或按模糊关键词批量终止进程,以免误伤其他服务。
如果进程没有响应,才在确认 PID、影响范围和恢复方案后发送终止信号。强制终止前,应先保留日志和运行状态信息。任务重新启动后,优先使用同一个包装脚本,而不是直接运行真实业务命令。
锁释放只表示进程结束,不代表业务成功。先查看退出码和失败位置:
systemctl show order-sync.service -p Result -p ExecMainStatus
tail -n 100 /var/log/myapp/order-sync.log
排查顺序可以按以下方式进行:
手工补跑示例:
sudo -u app /usr/local/sbin/order-sync-guarded
这会真正执行任务,不是模拟检查。若应用本身提供 --dry-run、测试环境或指定时间窗口参数,应优先使用其官方支持的测试方式。没有幂等能力的任务,不要为了验证锁而连续启动多次。
如果已经出现两个实例同时处理同一个业务窗口,不要只重启服务。应先停止继续触发的入口,保存两次执行的日志、PID、开始时间和处理范围,再核对:
数据库回滚、数据修复和补偿操作会直接影响业务数据,执行前应备份相关数据或使用已有恢复点,并在低风险窗口验证 SQL 和影响行数。不要把“重新运行一次”当作通用回滚方法,因为许多任务的重跑会再次产生副作用。
flock 只对同一台主机、同一个锁文件有效。如果香港服务器后面还有备用节点、弹性实例或多台 worker,必须改成以下方案之一:
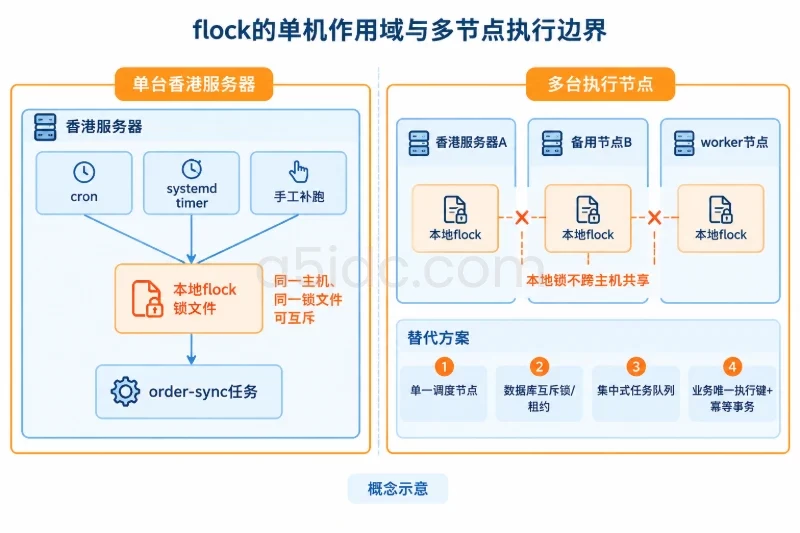
分布式租约不能只设置一个固定 TTL。任务运行时间超过 TTL 后,第二台服务器可能误以为锁已失效并开始执行。更稳妥的方式是让持有者定期续租,并为每次租约生成唯一 owner token;业务提交时校验 token,防止旧实例在失去锁后继续写入。
如果当前只有一台香港服务器,不必为了“分布式”而额外引入复杂组件。先把单机调度入口、锁、日志和业务幂等做好,再根据实际扩展架构。
定时任务的恢复至少分为三层,不能混为一谈。
如果更新后出现语法错误、时间错误或任务无法启动,可以恢复变更前的服务文件和脚本:
sudo cp -a /var/backups/order-sync/20250308-010000/order-sync-guarded \
    /usr/local/sbin/order-sync-guarded

sudo cp -a /var/backups/order-sync/20250308-010000/order-sync.service \
    /etc/systemd/system/order-sync.service

sudo cp -a /var/backups/order-sync/20250308-010000/order-sync.timer \
    /etc/systemd/system/order-sync.timer

sudo chmod 0750 /usr/local/sbin/order-sync-guarded
sudo systemctl daemon-reload
sudo systemctl restart order-sync.timer
示例中的备份目录应替换成实际生成的目录。恢复后必须重新检查下一次触发时间,并确认没有旧 cron 与新 timer 同时运行。restart 可能重新计算补跑行为,启用 Persistent=true 的 timer 尤其需要检查是否立即产生补触发。
如果调度正常,但业务程序更新后失败,应回滚业务程序或配置版本,而不是反复修改锁脚本。回滚完成后,先检查:
配置回滚不会自动撤销已经写入的数据。对于数据库、对象存储、账单和通知类任务,应根据实际业务使用事务回滚、备份恢复、反向补偿或人工核对。恢复前记录影响范围,恢复后验证数据数量、唯一键、状态字段和外部系统结果。
systemd-analyze verify 和 systemd-analyze calendar 检查配置。skipped_locked,而不是启动第二个实例。本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/4018.html