香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


在已经运行的香港服务器上配置自动化工作流时,建议把“执行任务”“失败重试”“告警通知”和“回滚入口”分开处理:工作流本身负责完成部署或配置变更,执行包装器负责控制超时与重试,systemd timer 负责定时触发,告警模块负责把最终失败、重试中和恢复结果发送出去。
香港服务器的地域不会改变 systemd、Ansible 或定时任务的基本机制,但需要确认服务器时区、DNS、出站 HTTPS、时间同步和执行账号权限。下面以已有 Ubuntu 22.04/24.04、systemd 和 Ansible 工作目录为例,不重复安装系统或初始化业务程序,重点配置日常维护所需的重试、审计、告警和恢复流程。
面向香港服务器上的日常自动化运维,A5数据提供Xeon Gold、AMD EPYC等物理服务器方案,以多核计算、不同容量内存及SSD或NVMe存储,为工作流调度、Ansible批量执行和运行日志留存提供资源基础。香港产品还提供CN2与国际带宽选项,可承载业务后台、接口服务及其自动化任务;香港存储系列则提供大容量企业级硬盘资源,用于配置副本、执行记录和备份文件的集中存放。
先确认当前系统版本、时区、时间同步状态以及已经存在的自动化目录:
cat /etc/os-release
timedatectl show -p Timezone --value
timedatectl status
command -v ansible-playbook
systemctl --version | head -n 1
ls -la /srv/ops-automation
如果计划按照香港本地时间执行,例如每天凌晨 03:15,应确认服务器使用 Asia/Hong_Kong:
timedatectl show -p Timezone --value
systemd-analyze calendar '*-*-* 03:15:00 Asia/Hong_Kong'
如果当前系统使用 UTC,也可以继续使用 UTC 调度,但要把业务人员理解的执行时间换算清楚。不要只看控制台显示的时间,定时任务、应用日志和告警平台必须使用同一套时区约定。
日常自动化任务至少应具备以下条件:
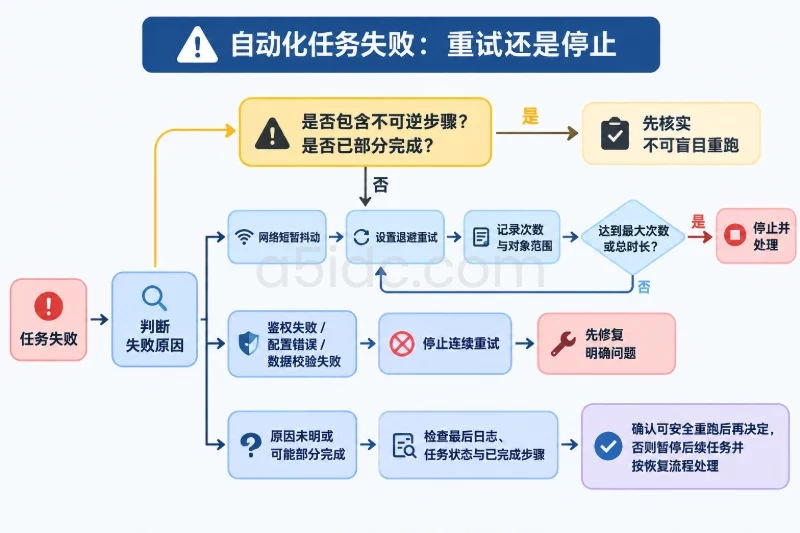
重试不是把所有失败再执行几遍。可以先按下面的方式划分:
| 失败类型 | 典型表现 | 是否自动重试 | 处理方式 |
|---|---|---|---|
| 临时网络异常 | DNS 暂时失败、远端连接超时、依赖接口返回 5xx | 可以 | 使用有限次数和递增等待时间 |
| 执行超时 | 工作流超过设定的 15 分钟或 30 分钟 | 谨慎 | 先确认是否仍有子进程或远端变更 |
| 配置语法错误 | YAML、模板或变量校验失败 | 不建议 | 立即告警,修复配置后重新执行 |
| 权限或认证失败 | SSH 密钥失效、目录不可写、令牌过期 | 不建议 | 修复权限或凭据,不要重复撞击接口 |
| 数据库迁移失败 | 表结构已部分变更或事务状态不明确 | 不建议整流程重试 | 按数据库和迁移工具的恢复流程处理 |
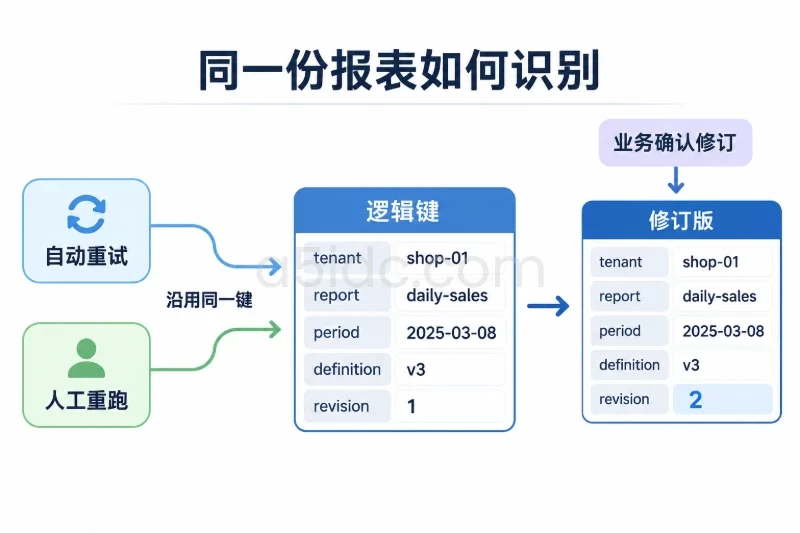
| 已有任务占用锁 | 上一次执行尚未结束 | 不作为失败重试 | 记录跳过,避免两个批次同时修改同一目标 |
示例配置采用“最多 3 次、第一次等待 30 秒、之后逐步延长、单次最长 900 秒”的策略。实际值应按照工作流耗时和依赖服务限流规则调整。
先准备专用目录。以下命令假设服务器上已经存在 ops 执行账号;如果现有账号不同,应将服务文件中的账号、目录属主和家目录一并替换。
sudo install -d -o ops -g ops -m 0750 /etc/ops-workflow
sudo install -d -o ops -g ops -m 0750 /var/lib/ops-workflow
sudo install -d -o ops -g ops -m 0750 /usr/local/libexec/ops-workflow
创建 /etc/ops-workflow/workflow.env:
WORKFLOW_NAME=hk-config-deploy
WORKDIR=/srv/ops-automation
WORKFLOW_CMD=/usr/local/libexec/ops-workflow/apply.sh

MAX_ATTEMPTS=3
RETRY_BASE_SEC=30
RETRY_MAX_SEC=300
TIMEOUT_SEC=900

LOCK_FILE=/var/lib/ops-workflow/run.lock

ALERT_URL=https://alert-gateway.example.invalid/hooks/replace-with-real-url
ALERT_ON_RETRY=1
ALERT_ON_FAILURE=1
ALERT_ON_RECOVERY=1
ALERT_URL 只是示例地址,应替换为企业内部告警网关或已有通知服务的 HTTPS 接口。不要把访问令牌直接写入公开代码仓库,也不要把包含令牌的配置文件设置为普通用户可读:
sudo chown ops:ops /etc/ops-workflow/workflow.env
sudo chmod 0600 /etc/ops-workflow/workflow.env
告警接口可以约定接收以下字段:
workflow:工作流名称。host:执行服务器主机名。status:retrying、failed 或 recovered。run_id:本次执行批次编号。attempt:当前尝试次数。message:简要错误信息。timestamp:UTC 时间。这样,告警平台可以按 workflow 和 run_id 聚合消息,不会因为同一任务的多次重试而生成无法关联的事件。
下面的 apply.sh 仅演示已有 Ansible 工作流的调用方式。目录、清单文件、Playbook 名称和健康检查地址必须替换成当前环境的实际值:
#!/usr/bin/env bash
set -Eeuo pipefail

cd /srv/ops-automation

test -f inventories/hk/hosts.yml
test -f deploy.yml

echo "workflow_step=syntax_check"
ansible-playbook \
  -i inventories/hk/hosts.yml \
  deploy.yml \
  --syntax-check

echo "workflow_step=apply"
ansible-playbook \
  -i inventories/hk/hosts.yml \
  deploy.yml \
  --limit hk_app

echo "workflow_step=health_check"
curl \
  --fail \
  --silent \
  --show-error \
  --max-time 10 \
  http://127.0.0.1/healthz

echo "workflow_result=success"
保存后设置为仅由执行账号和管理员使用:
sudo chown ops:ops /usr/local/libexec/ops-workflow/apply.sh
sudo chmod 0750 /usr/local/libexec/ops-workflow/apply.sh
工作流自身应保持幂等。例如,配置文件由模板管理,软件版本使用明确变量,服务重启只在配置实际变化时发生。不要在每次执行时无条件删除目录、重建数据库或覆盖人工维护文件。
如果工作流包含网络依赖,可以在脚本中将已知的临时网络故障转换为退出码 75,执行超时由 timeout 产生退出码 124。只有明确属于临时故障时才这样处理,不要把所有错误统一改成可重试状态:
if ! curl --fail --silent --show-error --max-time 10 \
  https://config-source.example.invalid/health; then
  echo "temporary dependency failure"
  exit 75
fi
创建 /usr/local/libexec/ops-workflow/run.sh:
#!/usr/bin/env bash
set -Eeuo pipefail

source /etc/ops-workflow/workflow.env

: "${WORKFLOW_NAME:?WORKFLOW_NAME is required}"
: "${WORKDIR:?WORKDIR is required}"
: "${WORKFLOW_CMD:?WORKFLOW_CMD is required}"
: "${MAX_ATTEMPTS:?MAX_ATTEMPTS is required}"
: "${RETRY_BASE_SEC:?RETRY_BASE_SEC is required}"
: "${RETRY_MAX_SEC:?RETRY_MAX_SEC is required}"
: "${TIMEOUT_SEC:?TIMEOUT_SEC is required}"
: "${LOCK_FILE:?LOCK_FILE is required}"

mkdir -p "$(dirname "$LOCK_FILE")"

exec 9>"$LOCK_FILE"
if ! flock -n 9; then
  echo "workflow_skipped=locked workflow=$WORKFLOW_NAME"
  exit 0
fi

run_id="$(date -u +%Y%m%dT%H%M%SZ)-${RANDOM}"
host_name="$(hostname -s)"
attempt=1
last_rc=1

notify() {
  local status="$1"
  local message="$2"
  local current_attempt="$3"

  if [[ -z "${ALERT_URL:-}" ]]; then
    echo "alert_skipped=empty_alert_url status=$status"
    return 0
  fi

  local payload
  if ! payload="$(
    python3 - "$WORKFLOW_NAME" "$host_name" "$status" "$run_id" \
      "$current_attempt" "$message" <<'PY'
import json
import sys
from datetime import datetime, timezone

workflow, host, status, run_id, attempt, message = sys.argv[1:]

print(json.dumps({
    "workflow": workflow,
    "host": host,
    "status": status,
    "run_id": run_id,
    "attempt": int(attempt),
    "message": message,
    "timestamp": datetime.now(timezone.utc).isoformat()
}, ensure_ascii=False))
PY
  )"; then
    echo "alert_build_failed status=$status"
    return 0
  fi

  if ! curl \
    --silent \
    --show-error \
    --fail \
    --connect-timeout 5 \
    --max-time 10 \
    -H 'Content-Type: application/json' \
    --data "$payload" \
    "$ALERT_URL" >/dev/null; then
    echo "alert_delivery_failed status=$status run_id=$run_id"
  fi

  return 0
}

cd "$WORKDIR"
echo "workflow_start name=$WORKFLOW_NAME run_id=$run_id host=$host_name"

while (( attempt <= MAX_ATTEMPTS )); do
  echo "workflow_attempt=$attempt run_id=$run_id"

  if timeout \
    --signal=TERM \
    --kill-after=15s \
    "${TIMEOUT_SEC}s" \
    "$WORKFLOW_CMD"; then

    echo "workflow_success run_id=$run_id attempt=$attempt"

    if (( attempt > 1 )) && [[ "${ALERT_ON_RECOVERY:-1}" == "1" ]]; then
      notify "recovered" "workflow succeeded after retry" "$attempt"
    fi

    exit 0
  else
    last_rc=$?
    echo "workflow_attempt_failed run_id=$run_id attempt=$attempt rc=$last_rc"
  fi

  if [[ "$last_rc" != "75" && "$last_rc" != "124" ]]; then
    echo "workflow_non_retryable_failure run_id=$run_id rc=$last_rc"
    break
  fi

  if (( attempt >= MAX_ATTEMPTS )); then
    break
  fi

  delay=$((RETRY_BASE_SEC * (2 ** (attempt - 1))))
  if (( delay > RETRY_MAX_SEC )); then
    delay="$RETRY_MAX_SEC"
  fi

  if [[ "${ALERT_ON_RETRY:-1}" == "1" ]]; then
    notify \
      "retrying" \
      "temporary failure rc=$last_rc; next retry in ${delay}s" \
      "$attempt"
  fi

  echo "workflow_retry_wait=${delay}s run_id=$run_id"
  sleep "$delay"
  attempt=$((attempt + 1))
done

echo "workflow_failed run_id=$run_id attempts=$attempt rc=$last_rc"

if [[ "${ALERT_ON_FAILURE:-1}" == "1" ]]; then
  notify \
    "failed" \
    "workflow stopped after attempts=$attempt rc=$last_rc" \
    "$attempt"
fi

exit "$last_rc"
设置脚本权限:
sudo chown ops:ops /usr/local/libexec/ops-workflow/run.sh
sudo chmod 0750 /usr/local/libexec/ops-workflow/run.sh
bash -n /usr/local/libexec/ops-workflow/run.sh
这个包装器有三个重要边界:
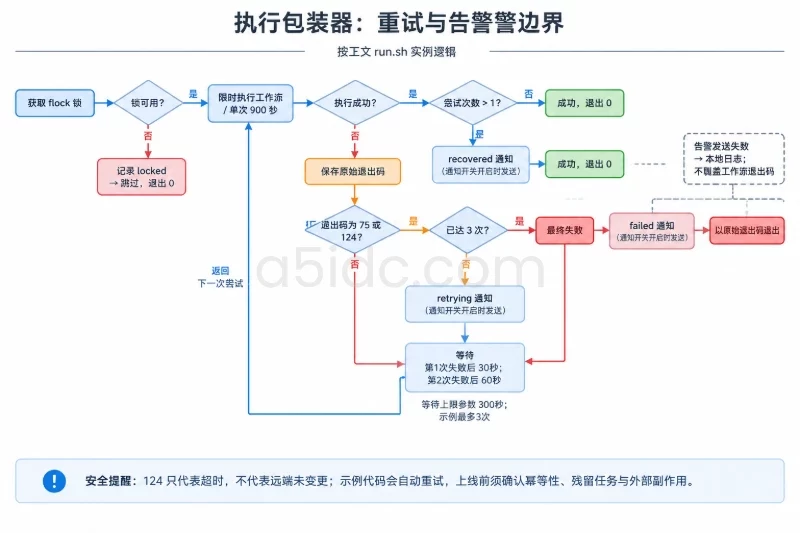
75 和超时退出码 124 重试,语法错误、权限错误等结果直接失败。创建 /etc/systemd/system/ops-workflow.service:
[Unit]
Description=Scheduled operations workflow
Wants=network-online.target
After=network-online.target

[Service]
Type=oneshot
User=ops
Group=ops
WorkingDirectory=/srv/ops-automation
EnvironmentFile=/etc/ops-workflow/workflow.env
ExecStart=/usr/local/libexec/ops-workflow/run.sh
UMask=0077
NoNewPrivileges=true
User=ops 适用于工作流不需要直接写入系统目录的情况。如果 Ansible 通过受控提权修改业务服务器,应为 ops 配置经过审批的提权规则,不要为了省事把整个服务改成 root。若工作流必须使用 root 权限,应先列出它会修改的路径,并同步加强备份、审计和回滚措施。
创建 /etc/systemd/system/ops-workflow.timer:
[Unit]
Description=Run operations workflow on schedule

[Timer]
OnCalendar=*-*-* 03:15:00 Asia/Hong_Kong
Persistent=true
RandomizedDelaySec=60
Unit=ops-workflow.service

[Install]
WantedBy=timers.target
Persistent=true 会在服务器错过计划时间后,于下一次启动时补执行一次。对于配置同步通常可以接受;对于带有时间窗口、账务处理或不可重复副作用的任务,应改为 Persistent=false,或者在工作流内增加业务日期检查。
加载并检查配置:
sudo systemd-analyze verify /etc/systemd/system/ops-workflow.service
sudo systemd-analyze verify /etc/systemd/system/ops-workflow.timer
sudo systemctl daemon-reload
sudo systemctl enable --now ops-workflow.timer
验证定时器是否已经生效:
systemctl list-timers --all ops-workflow.timer
systemctl cat ops-workflow.timer
不要首次启用定时器后直接等待第二天。可以先手工启动服务,观察完整执行链路:
sudo systemctl start ops-workflow.service
sudo systemctl status ops-workflow.service --no-pager
实时查看日志:
sudo journalctl -u ops-workflow.service -f
Type=oneshot 服务执行成功后通常会回到 inactive (dead),这不代表失败,应结合 Result 和 ExecMainStatus 判断:
sudo systemctl show ops-workflow.service \
  -p Result \
  -p ExecMainStatus \
  -p ExecMainStartTimestamp \
  -p ExecMainExitTimestamp
典型验收项如下:
| 验收项 | 检查方式 | 通过标准 |
|---|---|---|
| 定时器时间 | systemctl list-timers | 下一次执行时间符合香港本地时间 |
| 工作流退出状态 | systemctl show | Result=success,退出码为 0 |
| 幂等性 | 连续手动执行两次 | 第二次无非预期变更 |
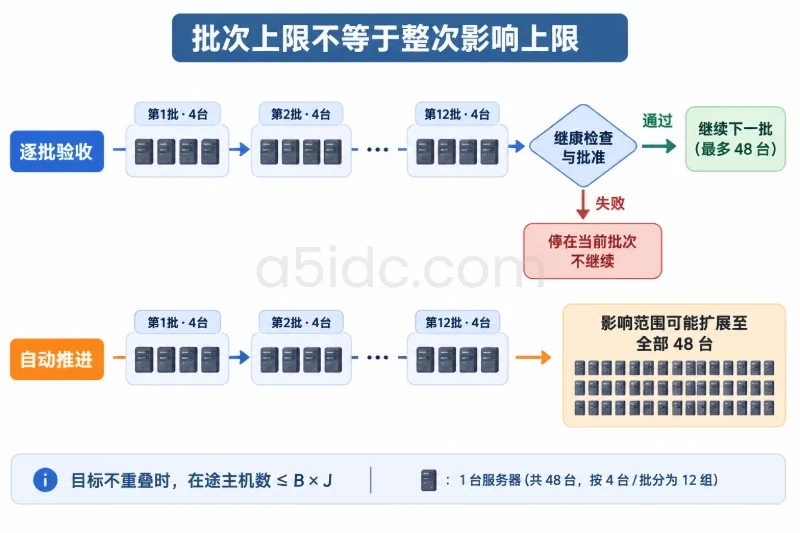
| 并发控制 | 在首个任务运行时再次启动 | 第二次被锁跳过,不产生并行修改 |
| 重试机制 | 使用可控的临时依赖故障测试 | 出现重试日志,次数不超过上限 |
| 最终失败告警 | 使用测试告警地址或测试事件 | 收到 failed,包含 run_id 和退出码 |
| 恢复告警 | 临时故障恢复后重跑 | 收到 recovered,可关联此前 run_id |
| 本地审计 | journalctl -u ops-workflow.service | 能看到开始、尝试、结果和错误信息 |
测试重试时,不要直接让生产数据库或生产配置失败。可以在预发布目标中临时关闭一个无副作用的健康检查,或让测试依赖返回一次 503,再恢复服务。测试完成后要撤销测试配置,并确认工作流回到正常结果。
查询最近一次执行:
sudo journalctl -u ops-workflow.service \
  --since "today" \
  -o short-iso
查询失败事件:
sudo journalctl -u ops-workflow.service \
  --since "24 hours ago" \
  -p warning..alert \
  --no-pager
每次执行至少应能对应出以下信息:
如果日志中会输出配置模板、命令参数或 Ansible 变量,应检查是否包含密码、令牌、私钥和完整连接字符串。必要时关闭敏感变量输出,不要仅依赖日志系统的访问权限来保护秘密。
如果日志显示 DNS、连接超时或远端 5xx,先确认服务器本身可以解析和访问依赖地址:
getent hosts config-source.example.invalid
curl -I --connect-timeout 5 --max-time 10 \
  https://config-source.example.invalid/health
如果依赖恢复后重试成功,告警应标记为 recovered,而不是继续保持未关闭的失败事件。若每次都在同一依赖步骤失败,不要继续增加 MAX_ATTEMPTS,应检查出口策略、DNS、远端限流和证书有效期。
语法错误、SSH 密钥权限错误、Ansible 变量缺失通常不会通过重试解决。应先停止重复执行,查看完整日志:
sudo journalctl -u ops-workflow.service \
  -n 200 \
  --no-pager
然后在不改变生产目标的前提下执行语法检查:
cd /srv/ops-automation
ansible-playbook \
  -i inventories/hk/hosts.yml \
  deploy.yml \
  --syntax-check
如果需要修改 /etc/ops-workflow/workflow.env、systemd 文件或工作流脚本,应先备份当前版本,再做单项修改。修改完成后执行:
sudo systemctl daemon-reload
sudo systemctl reset-failed ops-workflow.service
sudo systemctl start ops-workflow.service
超时退出码 124 只说明包装器等待时间结束,不代表远端没有发生变化。此时不要立即再次执行,先确认本机和目标端是否仍有残留进程:
ps -ef | grep -E 'ansible|deploy|workflow' | grep -v grep
sudo journalctl -u ops-workflow.service --since "30 minutes ago"
如果目标服务已经更新但健康检查没有返回,应分别检查服务状态、监听端口和应用日志。只有确认工作流是幂等的、没有仍在运行的子任务,并且重复执行不会重复提交外部操作后,才适合手工再次启动。
看到下面一类日志时:
alert_delivery_failed status=failed run_id=...
应把它视为“告警链路故障”,不能误认为工作流没有失败。检查告警网关地址、DNS、证书、出口 HTTPS 和接口返回码:
curl \
  --verbose \
  --connect-timeout 5 \
  --max-time 10 \
  -H 'Content-Type: application/json' \
  --data '{"status":"test","source":"hk-server"}' \
  "$ALERT_URL"
测试完成后不要把测试消息留在正式告警频道中。告警接口不可用期间,必须依靠本地 journalctl、监控采集或人工巡检补偿,直到通知链路恢复。
修改定时器、告警地址或重试参数前,先保留配置副本。以下操作会复制敏感配置,备份文件应限制为管理员可读:
backup_dir="/var/backups/ops-workflow"
sudo install -d -m 0700 "$backup_dir"

stamp="$(date -u +%Y%m%dT%H%M%SZ)"

sudo cp -a \
  /etc/ops-workflow/workflow.env \
  "$backup_dir/workflow.env.$stamp"

sudo cp -a \
  /etc/systemd/system/ops-workflow.service \
  "$backup_dir/ops-workflow.service.$stamp"

sudo cp -a \
  /etc/systemd/system/ops-workflow.timer \
  "$backup_dir/ops-workflow.timer.$stamp"
如果工作流会修改业务配置目录,例如 /etc/myapp,应在变更前使用业务允许的备份方式保存。下面的命令会打包该目录并可能包含敏感信息,执行前要确认磁盘空间、文件属主和备份保存位置:
sudo tar \
  --acls \
  --xattrs \
  -czf "/var/backups/ops-workflow/myapp.$stamp.tar.gz" \
  -C /etc \
  myapp

sudo chmod 0600 "/var/backups/ops-workflow/myapp.$stamp.tar.gz"
数据库数据不应仅依赖目录打包恢复。数据库迁移需要使用数据库自身的备份、事务和迁移回退方案;如果迁移已经部分执行,应先确认数据库状态,再决定是否恢复或执行对应的 down migration。
发现部署过程中已经修改部分目标,但最终健康检查失败时,先停止后续定时触发。以下操作会停止未来调度,并终止当前工作流服务,可能中断正在进行的配置变更,只有确认需要冻结自动化时才执行:
sudo systemctl stop ops-workflow.timer
sudo systemctl stop ops-workflow.service
随后检查:
sudo systemctl status ops-workflow.timer --no-pager
sudo systemctl status ops-workflow.service --no-pager
sudo journalctl -u ops-workflow.service --since "1 hour ago"
回滚应优先使用已经审核过的版本或独立的 rollback.yml,而不是直接对工作目录执行破坏性 Git 操作。示例:
cd /srv/ops-automation

ansible-playbook \
  -i inventories/hk/hosts.yml \
  rollback.yml \
  --limit hk_app \
  -e "release_ref=known-good-version"
known-good-version 必须是已经验证过的版本标识。不要在未确认工作区状态时使用 git reset --hard、批量删除目录或直接覆盖生产配置;这些操作可能丢失未提交变更,且无法保证业务状态一并恢复。
恢复配置备份前,先确认目标目录和压缩包来源。解压会覆盖同名文件,影响范围是 /etc/myapp,应在业务服务停止或已进入维护窗口后执行:
sudo systemctl stop myapp.service

sudo tar \
  --extract \
  --acls \
  --xattrs \
  --same-owner \
  --file "/var/backups/ops-workflow/myapp.KNOWN_TIMESTAMP.tar.gz" \
  --directory /etc

sudo systemctl start myapp.service
sudo systemctl is-active --quiet myapp.service
如果服务启动失败,立即停止继续扩大变更范围,恢复备份前的当前目录副本,并根据应用日志判断是文件版本、属主、依赖服务还是数据库状态不一致。
确认手工回滚完成、健康检查通过后,再重新加载并启用定时器:
sudo systemctl daemon-reload
sudo systemctl start ops-workflow.timer
sudo systemctl list-timers --all ops-workflow.timer
恢复后的第一次执行建议手工观察:
sudo systemctl start ops-workflow.service
sudo journalctl -u ops-workflow.service -n 200 --no-pager
不要把“回滚成功”直接等同于“自动化链路恢复”。还应确认下一次计划时间、告警是否能够发送、执行账号权限是否保持不变,以及恢复操作是否留下完整审计记录。
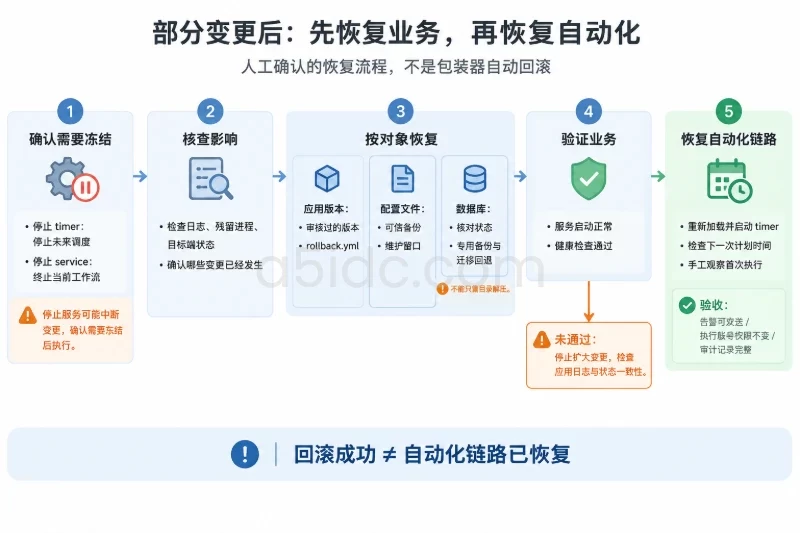
flock,不会让两个批次同时修改同一目标。journalctl 验证本地日志可以追踪完整执行过程。本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/4012.html