香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


256GB内存能否支撑一台香港服务器上的业务,不能只看“同时在线用户数”。真正需要核算的是高峰请求量、单请求处理时间、长连接数量、应用进程占用、数据库工作集、缓存热数据规模,以及操作系统和故障缓冲所需的余量。并发用户很多但请求频率低,内存压力可能不大;用户数不高但每个请求都加载大对象、执行复杂查询或保持长连接,反而可能更快触及瓶颈。
容量规划应先把256GB拆成几个可验证的资源池,再将业务增长映射到这些资源池。一般不建议把全部内存分配给缓存或数据库,至少要为系统、进程波动、连接峰值、内存碎片和异常请求保留安全区。下面的示例以系统可见的256GiB为计算口径;如果服务商标注的256GB采用十进制计量,系统可见容量可能约为238.4GiB,应以交付后 free -h、/proc/meminfo 或服务商资源说明为准重新计算。
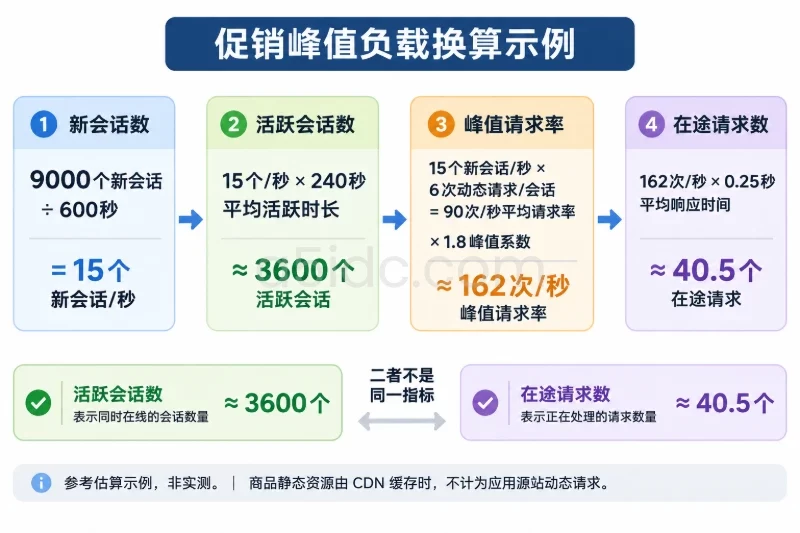
“并发用户”通常表示某一时刻处于登录、浏览或连接状态的用户数量,但这些用户不一定正在同时执行请求。容量评估至少应分开记录以下指标:
并发请求与请求速率之间可以用一个简单关系估算:
活跃请求数 ≈ 请求速率 × 平均请求处理时间(秒)
例如,业务高峰达到300 RPS,平均请求处理时间为0.2秒,则平均同时处理的请求约为60个。即使此时有1000个浏览器保持连接,真正占用应用处理资源的活跃请求仍可能明显少于在线用户数。
但这并不代表1000个连接没有内存成本。每个连接可能占用文件描述符、内核缓冲区、TLS状态、应用对象和连接管理结构。如果连接长期保持,还需要考虑连接空闲时间、心跳、发送队列和异常连接积压。
如果只有在线用户数,可以先根据用户行为估算平均请求量,再叠加峰值系数。
例如,某业务有1000名在线用户,平均每名用户每10秒产生1次请求:
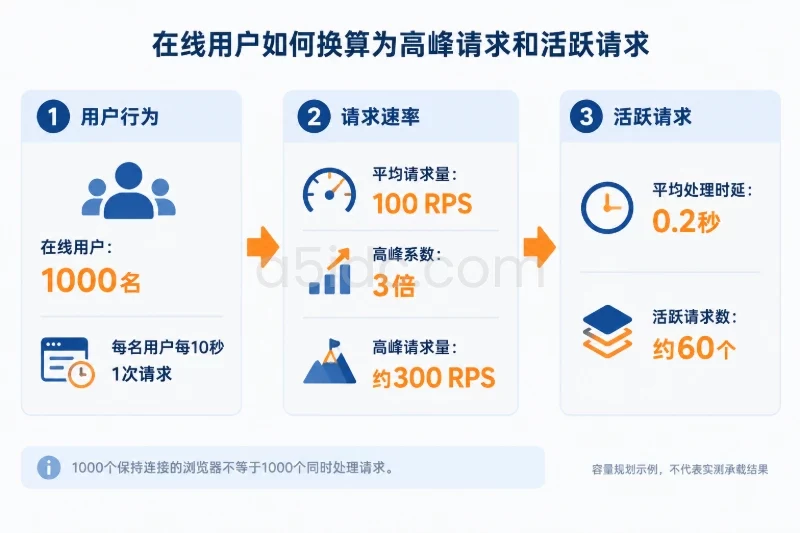
这里的3倍只是容量规划示例,不是通用承诺。促销、开奖、抢购、批量任务、定时刷新和消息推送都会改变峰值系数。应使用业务日志中按1分钟、5分钟和15分钟聚合的峰值,而不是只看全天平均值。
| 请求类型 | 主要内存来源 | 需要同时关注的指标 |
|---|---|---|
| 静态文件或缓存命中 | 页面缓存、文件页缓存、连接缓冲 | 网络带宽、缓存命中率、连接数 |
| 动态API | 应用进程、序列化对象、数据库结果集 | RPS、进程RSS、P95时延、数据库查询 |
| 服务端页面渲染 | worker进程、模板对象、临时数据 | 单进程峰值、进程数量、垃圾回收 |
| 长连接 | 连接状态、心跳、发送与接收缓冲 | 连接数、每连接内存、队列长度 |
| 上传与下载 | 文件缓冲、临时文件、网络发送队列 | 磁盘空间、磁盘吞吐、出口带宽 |
| 批量任务 | 大批量对象、排序区、导入导出缓冲 | 单任务内存峰值、并发任务数、执行时长 |
同样是1000个并发用户,如果大部分请求命中页面缓存,应用层内存压力可能低于1000个用户同时执行复杂报表查询的场景。容量规划不能使用“每个用户固定占用多少内存”的单一系数代替实际请求画像。
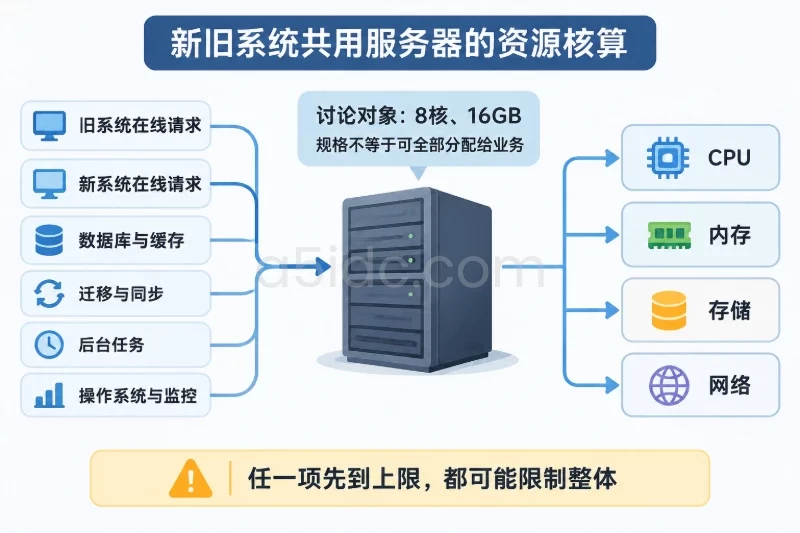
一台标称256GB内存的服务器,实际可用于业务的内存还要扣除:
建议将“计划业务预算”和“物理内存”分开。示例中,以256GiB为系统可见内存,预留20%作为安全区:
这里的安全区不是闲置浪费,而是应对内存短时峰值、回收延迟、进程重启、缓存碎片和监控误差。若服务器同时承载多个不易控制的服务,安全区可以高于20%;如果应用经过严格压测、组件隔离且有独立故障转移,也可以根据实测数据重新确定,但不应直接压缩到零。
应用内存通常由固定基线和随并发增长的部分组成:
应用内存 ≈ 进程数量 × 单进程基线 + 活跃请求数 × 单请求增量 + 队列、临时对象和运行时开销
单进程基线可能包括运行时、代码、模块和连接池。单请求增量则与请求参数、返回数据量、序列化方式、数据库结果集和中间对象有关。
例如,40个应用进程的平均常驻内存为600MiB,仅进程基线就约为:
40 × 0.6GiB = 24GiB
如果高峰时每个活跃请求还会产生20MiB临时对象,60个活跃请求约增加:
60 × 20MiB = 1200MiB,约1.17GiB
实际进程RSS还会受到共享内存、运行时垃圾回收、内存碎片和后台任务影响,因此应以高峰期间的进程RSS或容器内存指标校准,而不是只使用配置文件中的worker数量。
多进程模型还要注意“配置数量”和“实际占用”的差异。worker数量增加可能提升并发处理能力,但也会复制部分运行时和应用对象。如果CPU核心数、数据库连接数或磁盘吞吐没有同步增加,仅增加worker可能把压力转移到其他资源。
缓存并不是“业务总数据量”的同义词。更有价值的是估算一段时间内会反复访问的热数据集:
缓存内存 ≈ 热数据原始大小 × 元数据与分配开销系数 × 副本数量
如果有压缩、序列化或分片,还应把这些因素纳入实测。对于键值缓存,元数据、哈希表、内存分配器和碎片可能使实际占用达到原始数据的1.3至2倍。这个范围只适合作为初步预算,具体值应通过缓存组件的内存统计和一批真实数据验证。
例如,缓存中有1000万条记录,平均序列化后的值大小为2KB:
如果存在同机副本、主从副本或两套不同格式的缓存,还要继续叠加副本占用。缓存的最大容量也不应等同于可用内存,仍需留下应用和数据库所需的预算。
缓存命中率同样重要。增加20GB缓存,如果只能将命中率从96%提升到97%,但因此挤压了数据库缓冲池和应用安全区,未必是合理的内存分配。规划时应同时观察:
-热点数据的访问频率; -缓存过期后对数据库和应用的回源压力; -扩大缓存后的实际时延收益。
下面给出一个便于核算的假设预算。它不是某台香港服务器的实测承载结果,也不代表固定产品配置,只用于说明如何拆分内存。
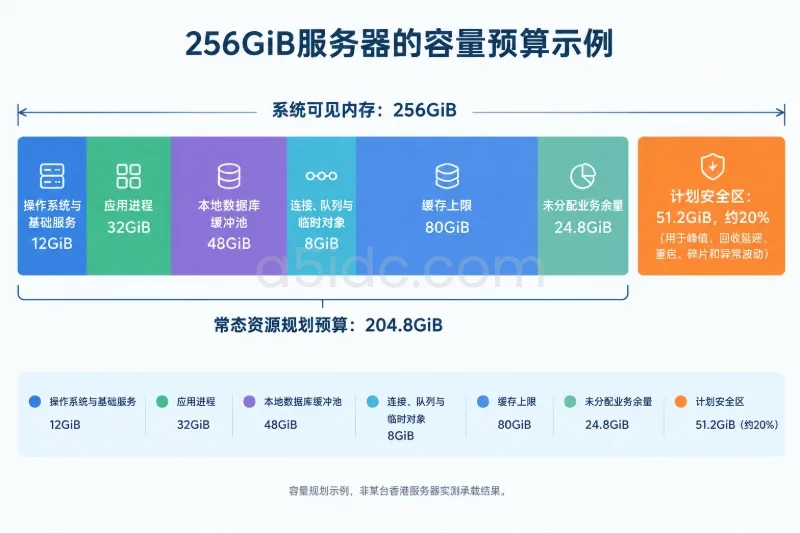
| 资源池 | 示例预算 | 说明 |
|---|---|---|
| 操作系统与基础服务 | 12GiB | 系统、监控、日志和常驻服务 |
| 应用进程 | 32GiB | 多个应用进程及运行时对象 |
| 本地数据库缓冲池 | 48GiB | 仅适用于数据库与业务同机 |
| 连接、队列与临时对象 | 8GiB | 长连接、排队请求和短时峰值 |
| 缓存上限 | 80GiB | 已为缓存元数据和分配开销留出空间 |
| 未分配业务余量 | 24.8GiB | 用于增长和未纳入模型的波动 |
| 计划安全区 | 51.2GiB | 约占256GiB的20% |
| 合计 | 256GiB | 需以系统实际可见内存校准 |
如果数据库在独立服务器上,48GiB可以重新分配给应用、缓存或安全区,但不能因此直接推断业务吞吐会按比例增加;此时网络时延、数据库连接和远端数据库的处理能力会成为新的约束。
数据库有数百GB甚至数TB的数据,并不意味着必须把全部数据放入内存。更重要的是高峰期频繁访问的表、索引和结果集是否能稳定留在数据库缓冲池中。
需要区分以下数据:
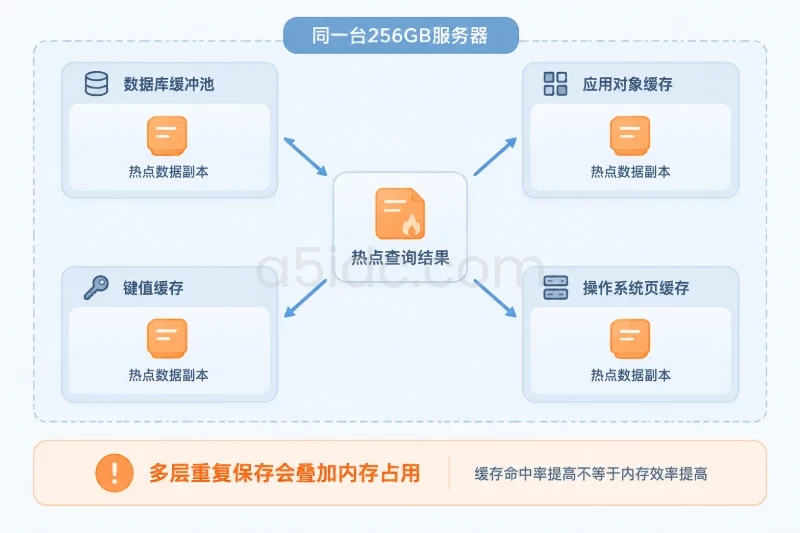
如果将数据库、缓存和应用都放在同一台256GB服务器上,它们可能会重复保存相同数据。例如,某个热点结果同时存在于数据库页缓存、应用对象缓存、键值缓存和操作系统页缓存中。表面上缓存命中率提高了,但内存利用率可能下降。规划时应记录各层的实际数据副本,而不是只统计业务原始数据量。
256GB内存无法替代出口带宽。对于文件下载、图片分发、视频片段、镜像或备份传输业务,应把并发传输量换算为网络速率。
例如,500个用户同时下载,每人下载2MB文件,平均在10秒内完成:
这里使用的是十进制MB和Mb换算:1字节等于8比特。若再叠加协议开销、其他业务请求和峰值波动,所需出口能力会高于800Mb/s。此时即使内存仍有较大余量,也可能先遇到带宽、磁盘读取或网络队列瓶颈。
香港机房位置主要影响访问路径、网络时延、线路质量和跨区域传输成本,不会直接改变256GB内存的容量。选择香港服务器时,还需要核对端口速率、可用带宽、流量计费方向、峰值限制以及访问主要用户区域。对于动态业务,远端数据库或对象存储的往返时延也可能成为P95时延的重要组成部分。
常见的“内存还有很多但业务变慢”场景包括:
因此,256GB内存适合与足够的CPU核心、匹配的磁盘性能和明确的网络规格一起评估。仅提高内存而不解决CPU、磁盘或数据库锁等待,通常不能形成等比例的业务承载提升。
可以先将不同资源池在业务高峰时的占用记录下来,再计算计划余量:
计划余量率 = (业务预算 - 预计高峰占用)÷ 业务预算
如果前文的业务预算为204.8GiB,高峰预计占用160GiB,则:
计划余量率 = (204.8 - 160)÷ 204.8 ≈ 21.9%
这个结果表示在不动用安全区的情况下,仍有约21.9%的业务预算可用于短期波动和增长。计算时应使用高峰P95或P99、连续高峰期间的最大值,而不是一天平均值。对于有明显突发活动的业务,还应将峰值系数单独列出。
应用、缓存、连接数和数据库工作集往往不会以同一速度增长。可以分别计算:
未来占用 = 当前高峰占用 ×(1 + 增长率)^周期数
示例中,当前高峰的资源占用如下:
六个月后的估算为:
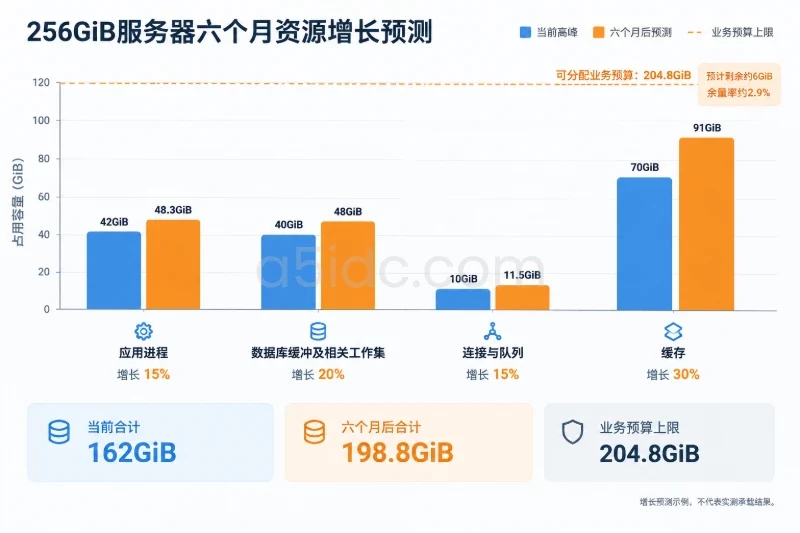
如果可分配业务预算为204.8GiB,六个月后剩余约6GiB,余量率约为:
(204.8 - 198.8)÷ 204.8 ≈ 2.9%
这意味着即便物理内存尚未完全使用,也应提前准备扩容或拆分方案。因为增长预测本身存在误差,缓存碎片、临时任务、发布重启和突发峰值都可能消耗这部分余量。
A5数据面向香港业务提供物理服务器资源,覆盖Xeon Gold、AMD EPYC等平台,并配有SSD或NVMe存储方案,可承载网站、业务后台、数据库、缓存及多任务运行等场景。不同产品在CPU、内存、磁盘、带宽和IP配置上各有组合,香港地区还提供CN2与国际带宽线路,便于按访问区域和混合负载匹配基础资源。
| 场景 | 256GB内存的主要价值 | 仍需重点核对的条件 |
|---|---|---|
| 动态API与数据库同机 | 可容纳较大的数据库缓冲池、应用进程和缓存 | CPU、磁盘IOPS、数据库锁和查询效率 |
| 高缓存命中率的内容业务 | 可保存较大的热点数据集,减少回源 | 缓存淘汰、带宽、缓存副本和命中率 |
| 大量长连接 | 可容纳更多连接状态和连接缓冲 | 单连接实际内存、事件处理能力、文件描述符 |
| 文件分发和下载 | 可用于页缓存和队列缓冲 | 出口带宽、磁盘读取和流量计费 |
| 批量分析或数据处理 | 可减少部分磁盘临时交换 | CPU、并行任务数、单任务峰值和数据读写 |
| 多个服务混部 | 可为多个组件提供共享内存空间 | 服务之间的资源隔离、故障影响范围和NUMA布局 |
如果预测高峰占用长期低于100GiB,256GB可能有较多闲置容量,选择时应同时比较CPU、磁盘和网络规格,而不是单纯为更大内存付费。如果预测高峰接近180至200GiB,并且缓存、数据库和应用混部,则256GB可能只是近期容量,需同步规划拆分或横向扩展。
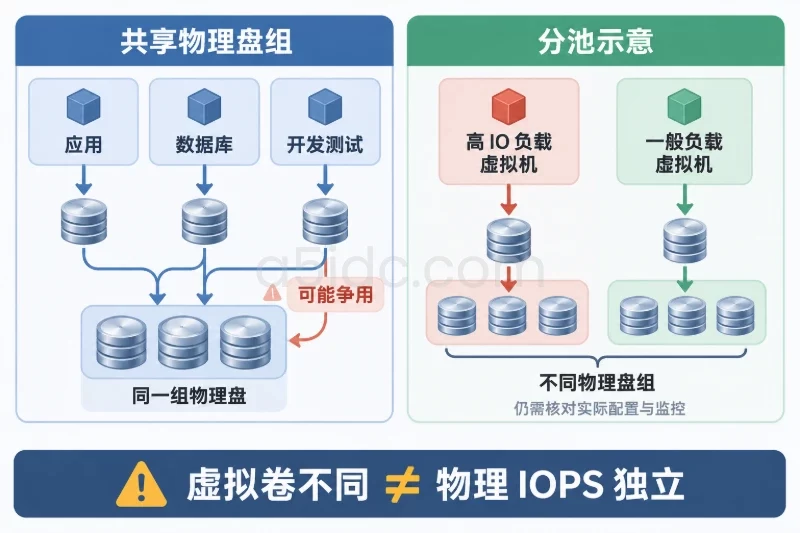
同样标注256GB的服务器,实际可用性可能因资源分配方式不同而产生差异。下单前应逐项确认:
交付验收时可以先查看系统可见内存、内存使用、交换区和连接概况:
free -h
cat /proc/meminfo | head -n 15
vmstat 1 5
ss -s
free -h中应重点关注available,不能只看free字段。Linux会主动利用空闲内存作为文件页缓存,因此free较小不一定表示内存不足;如果available持续下降、交换活动增加,才更接近实际压力。vmstat可用于观察内存回收、交换、运行队列和IO等待,ss -s则可帮助核对连接数量是否与负载画像一致。
阈值应根据基线、业务SLO和压测结果调整,以下可作为初始参考:
| 指标 | 预警参考 | 需要采取的动作 |
|---|---|---|
| 计划业务预算使用率 | 连续高峰超过75%至80% | 检查缓存、进程和数据库增长,开始准备扩容 |
| 高峰余量率 | 低于15% | 暂停无依据的缓存扩张,安排压测和容量评审 |
| 高峰余量率 | 低于10% | 将扩容列为近期任务,避免等待OOM或大规模抖动 |
available内存 | 持续低于系统可见内存的15% | 核对进程RSS、缓存、页缓存和临时任务 |
| Swap换入或重大缺页 | 在业务高峰持续发生 | 优先处理内存压力和异常进程,不把Swap当作额外容量 |
| 缓存淘汰率 | 持续上升且命中率下降 | 增加缓存容量、调整TTL或拆分缓存与应用 |
| 应用P95/P99时延 | 资源未明显增长但连续恶化 | 排查CPU、磁盘、数据库和网络,不要只加内存 |
| 网络出口使用率 | 长时间接近线路上限 | 调整带宽、分发路径或业务传输策略 |
| 预测窗口内内存占用 | 三个月内将超过计划预算的85% | 提前扩容或拆分组件 |
“使用率达到80%”本身不一定意味着马上故障,关键在于它是否持续、是否伴随交换活动、延迟上升、缓存淘汰和进程增长。反过来,短时间达到90%也可能没有立即影响,但如果存在内存泄漏或持续增长趋势,就不能依赖瞬时观察结果。
最终的扩容判断应由三组数据共同决定:高峰负载下的实际资源曲线、未来周期的增长预测,以及业务可接受的时延和错误率。先按请求类型拆分并发,再按进程、数据库、缓存、连接和安全区分配256GB,最后用内存、CPU、磁盘、网络和P95/P99时延交叉验证,才能判断这台香港服务器是有足够余量,还是已经需要升级规格或拆分架构。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/3846.html