香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


单看CPU利用率、numa_miss或数据库响应时间,都不足以判断双路Intel Xeon Gold 6133日本服务器是否出现了跨NUMA访存瓶颈。真正需要确认的是:数据库线程是否频繁运行在一个NUMA节点,却访问另一个节点的内存;远端访问增加后,是否同时带来了内存延迟、CPU停顿、队列长度和查询P95/P99上升;而磁盘、网络、锁等待等替代因素能否被排除。
对双路Gold 6133服务器,应按照“建立观察窗口 → 指标A变化 → 指标B联动 → 排除替代解释 → 形成判断 → 复测”的顺序分析。日本机房的位置主要影响客户端到服务器的网络往返时间,不会直接决定服务器内部的NUMA访存;如果应用和数据库跨地域部署,还必须先把公网或专线RTT与服务器内部内存延迟区分开。
A5数据提供日本地区的物理服务器资源,产品覆盖Xeon Gold与AMD EPYC平台,并有双路Gold 6138、NVMe存储及SSD、大容量HDD等配置,可为数据库缓存、数据读写和多任务运行提供相应的硬件基础。结合日本本地及跨境业务所需的CIA、GIA、CN2、SoftBank等线路选项,也能为双路服务器的NUMA拓扑分析与数据库部署提供匹配的机房和网络资源。
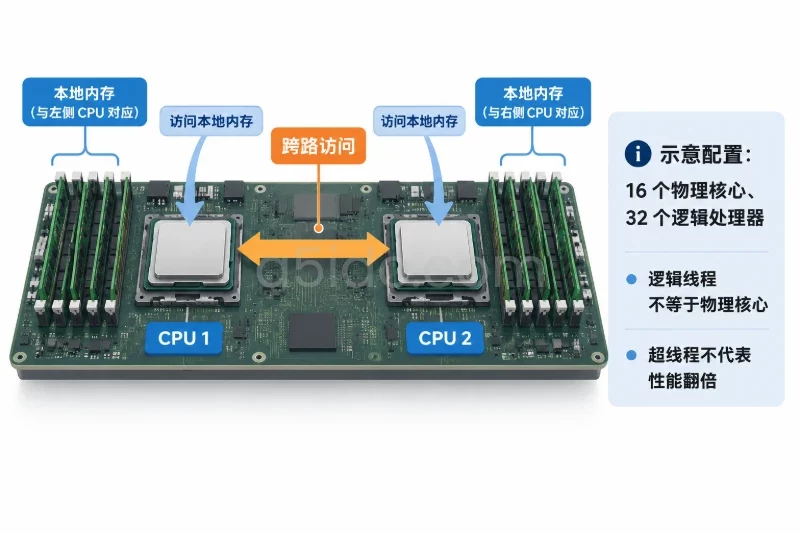
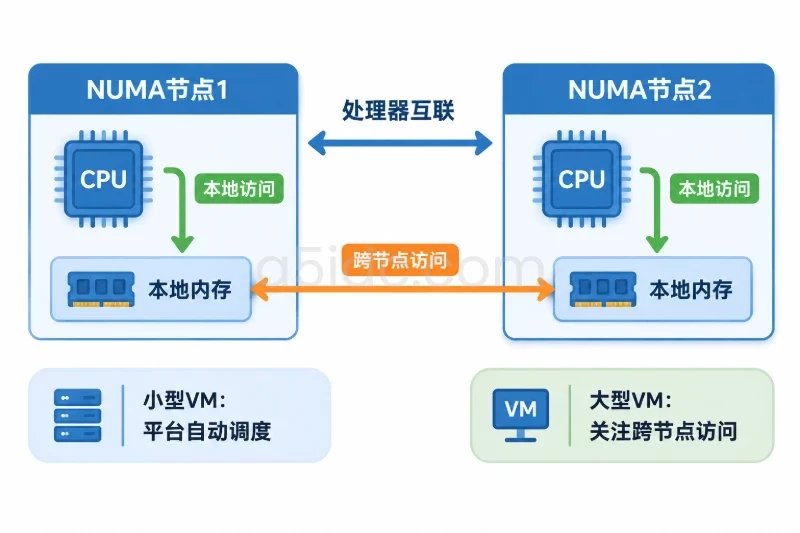
双路Intel Xeon Gold 6133平台通常由两个处理器插槽和各自连接的本地内存组成。某个CPU访问本插槽连接的内存属于本地访问,访问另一颗CPU所连接的内存则属于远端访问。两个插槽之间通过处理器互连链路交换数据,远端访问通常比本地访问具有更高延迟,并会消耗互连链路和内存控制器资源。
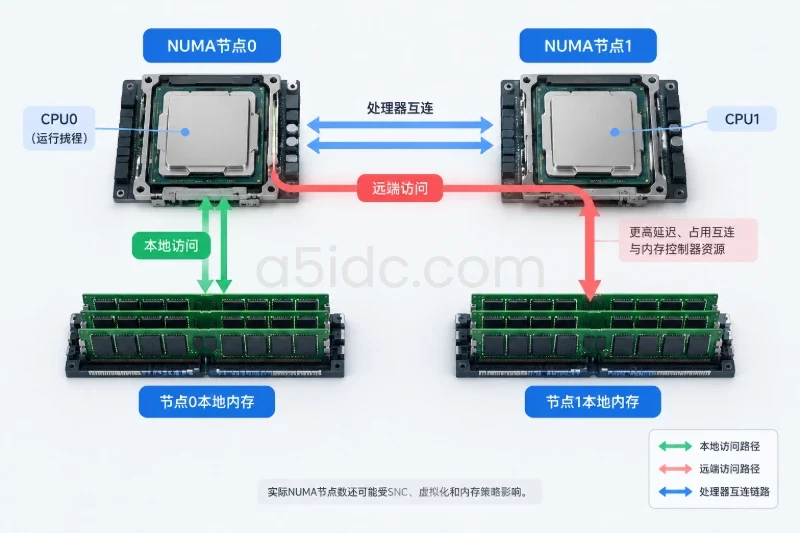
但“两个CPU插槽”等于“系统一定只有两个NUMA节点”并不严谨,原因包括:
先使用只读命令确认操作系统看到的拓扑:
lscpu | grep -E 'Model name|Socket|NUMA|CPU\(s\)'
numactl -H
numastat -m
重点查看以下信息:
| 检查对象 | 需要确认的内容 | 对判断的意义 |
|---|---|---|
| Socket数量 | 是否确实枚举出两个物理插槽 | 确认是否属于双路物理拓扑 |
| NUMA节点数量 | 是2个、4个,还是只有1个 | 决定后续绑定和统计的粒度 |
| 每个节点CPU | 节点对应哪些逻辑CPU | 判断数据库线程是否跑在预期节点 |
| 每个节点内存 | 两个节点的内存容量是否接近 | 发现内存不对称或插槽配置问题 |
| 内存空闲量 | 单节点是否明显比另一节点紧张 | 识别局部内存不足和远端分配 |
| 虚拟化信息 | 是否为虚拟机、是否暴露vNUMA | 判断能否观测到宿主机真实拓扑 |
如果lscpu只显示一个NUMA节点,即使服务器底层是双路物理机,也不能仅凭客户机内的numastat证明宿主机存在跨NUMA瓶颈。此时需要云平台或宿主机层面的NUMA、内存带宽和CPU调度数据。
性能分析不能把某一秒的尖峰直接当作瓶颈。数据库负载应先选择一段业务类型相对稳定的窗口,例如持续运行5到15分钟的读写混合负载,并记录以下事件:
指标的采样周期要尽量统一。操作系统指标可以按1秒或5秒采样,数据库统计可以按10秒或更长周期聚合,但所有图表必须使用同一时间轴。只看平均响应时间容易掩盖排队问题,建议同时保留P50、P95、P99、超时率和错误率。
建议把指标分成以下几组:
| 指标组 | 代表指标 | 主要回答的问题 |
|---|---|---|
| CPU执行 | user、system、iowait、steal、run queue、上下文切换 | CPU是否真正饱和,还是在等待资源 |
| NUMA与内存 | 本地/远端访问、每节点内存带宽、LLC miss、内存压力 | 数据库是否大量访问远端内存 |
| 磁盘I/O | IOPS、吞吐、await、队列长度、util、读写比例 | 查询是否在等待存储 |
| 网络 | RTT、重传、丢包、连接队列、收发带宽 | 请求是否在网络链路或连接层排队 |
| 应用层 | 线程池队列、连接池等待、GC、锁、请求排队 | 服务器资源正常时,应用是否自己限流 |
| 数据库 | 锁等待、Buffer Pool命中率、日志刷盘、临时表、执行计划 | 数据库内部是否存在独立等待原因 |
| 结果层 | QPS、P95/P99、超时率、错误率 | 资源变化是否真正影响业务结果 |
在Linux服务器上,可以用以下命令采集基础信息。命令本身不修改系统配置,但sysstat和numactl需要提前安装,具体包名取决于发行版。
vmstat -w 1 10
iostat -xz 1 10
sar -n DEV,TCP,ETCP 1 10
cat /proc/pressure/cpu
cat /proc/pressure/memory
cat /proc/pressure/io
针对数据库进程,应选择实际执行查询的工作进程,而不是只观察父进程。以PID为12345的进程为例:
PID=12345
pidstat -p "$PID" -u -r -w 1 10
numastat -p "$PID"
grep -E 'Cpus_allowed_list|Mems_allowed_list' "/proc/$PID/status"
taskset -pc "$PID"
对于多进程数据库,还要分别观察主进程、工作进程、后台刷盘进程和日志进程。只查看数据库主进程的CPU占用,可能漏掉真正承担查询执行的进程。
numastat只能说明分配和位置,不能单独代表远端读流量numastat -p PID通常会显示numa_hit、numa_miss、numa_foreign、local_node和other_node等计数。它们对判断页面分配位置和进程运行节点很有价值,但不能简单解释成“远端内存读取次数”。
例如:
numa_miss较高,可能表示进程希望在某个节点分配页面,但该节点没有满足条件的空闲内存,最终从其他节点分配。other_node上升,说明进程的内存分配或运行位置出现了跨节点特征,但不等价于所有数据库线程都在执行远端读取。因此,numastat更适合作为“页面放置和亲和性线索”,还要结合硬件性能计数器或平台监控确认实际远端流量。
常见的异常模式是:
这种模式比“numa_miss高”更接近跨NUMA访存瓶颈。
还要注意数据库的内存并不只有一种来源:
如果一个节点的可用内存长期偏低,Linux可能把新页面分配到另一节点。这样即使CPU亲和性没有变化,远端访问也会逐渐增加。
Intel服务器上的内存控制器、处理器互连和缓存事件名称,会随CPU型号、内核版本、perf版本和厂商监控工具变化。不要直接复制别的平台事件名,先查看当前系统支持的事件:
perf list | grep -Ei 'uncore|upi|imc|node|remote|local|memory'
通用的CPU、指令和缓存指标可以先做基础采样:
perf stat -p 12345 -e cycles,instructions,cache-misses -- sleep 30
如果平台暴露了本地内存、远端内存、内存控制器和UPI相关事件,应使用这些事件计算:
远端访问比例可以按以下方式计算:
远端读取比例 = 远端读取字节数 ÷(本地读取字节数 + 远端读取字节数)× 100%
例如某个30秒窗口内,本地读取为88 GB、远端读取为42 GB,使用十进制GB口径,则远端读取比例为:
42 ÷(88 + 42)× 100% = 32.3%
这里的GB/s是字节速率。如果监控工具使用Gb/s,必须先除以8才能与GB/s比较;反过来,42 GB/s等于336 Gb/s。不同工具还可能使用GiB/s和GB/s,比较前应统一单位。
没有必要为远端比例设定一个脱离负载的固定报警值。一个低并发、缓存命中率高的任务,即使存在一定比例的远端访问,也可能没有明显延迟损失;一个对延迟敏感、并发较高的短事务负载,即使远端比例不高,也可能因为远端访问集中在共享热点数据上而受到影响。
跨NUMA问题经常与CPU、内存、磁盘或数据库锁等待同时出现。判断时应优先寻找“同一时间窗口内共同变化的指标”。
更接近CPU计算瓶颈的表现通常是:
如果CPU利用率只有60%至75%,但P99已经明显变差,也不能因此排除CPU相关问题。两个插槽可能存在局部饱和:节点0的CPU接近满载,节点1仍有空闲,整机平均值因此不高。必须查看每个NUMA节点、每个逻辑CPU和每个CPU集合的利用率。
跨NUMA访存引起的CPU表现也可能不是“CPU 100%”。线程会停在缓存未命中和内存访问上,表现为:
这正是“CPU使用率没有满,但CPU执行效率下降”的典型混淆点。
内存容量不足通常伴随以下信号:
MemAvailable持续下降。/proc/pressure/memory中的等待时间增加。内存带宽瓶颈则不一定伴随内存不足。数据库可能还有大量空闲内存,但顺序扫描、批量聚合、压缩或高并发随机访问已经占满一个或两个内存控制器。此时应比较:
如果一个节点内存带宽接近平台实际上限,另一个节点仍明显空闲,同时远端读取和UPI流量升高,跨NUMA的可能性会明显增加。
磁盘瓶颈通常会在同一时间轴上表现为:
iostat -xz中的await、队列长度或util上升。/proc/pressure/io增加。如果远端访问比例升高,但磁盘await一直保持在较低水平,且数据库缓存命中率没有明显下降,就不能把该次延迟上升直接归因于磁盘。反过来,如果物理读和磁盘队列先上升,远端访问只是随数据库工作量被动增加,主要瓶颈更可能是存储。
网络问题应同时看服务器网卡和请求方观测到的RTT。可关注:
如果应用部署在中国内地、东南亚或其他地区,网络往返时间可能直接占据短SQL请求的主要比例。此时服务器内部的远端内存访问,即使存在,也不一定是端到端P99升高的首要原因。可以分别记录:
只有数据库执行耗时与远端访问、内存停顿同时增加,才能把日本服务器内部NUMA因素与跨地域网络问题区分开。
当服务器资源指标看起来正常,但请求仍排队,应用层可能才是主要限制因素:
这类问题可能间接制造跨NUMA现象。例如应用线程池突然扩大,更多线程同时访问本机数据库客户端缓存,导致CPU迁移和远端内存访问增加。但如果应用队列先于NUMA指标上升,就不能把NUMA当作起点。
数据库层需要至少区分以下几类等待:
MySQL或兼容数据库可以关注活动线程数、Buffer Pool物理读、行锁等待、日志写入和临时磁盘表;PostgreSQL可以关注活动会话、wait_event_type、块读耗时、锁等待、缓存命中和检查点指标。不同数据库的字段名称不同,应以当前版本的监控接口为准。
如果数据库锁等待从1%升到20%,而远端读取比例保持不变,那么P95变差主要应归因于锁竞争。反之,如果锁等待稳定、物理读稳定,只有远端访问、内存停顿和P95同步上升,NUMA证据更充分。
下面是一组用于说明方法的模拟监控数据,不代表某台日本服务器的实测结果。假设数据库缓存已预热,SQL类型和数据集没有变化,逐步增加并发量,并使用硬件计数器计算远端读取比例。
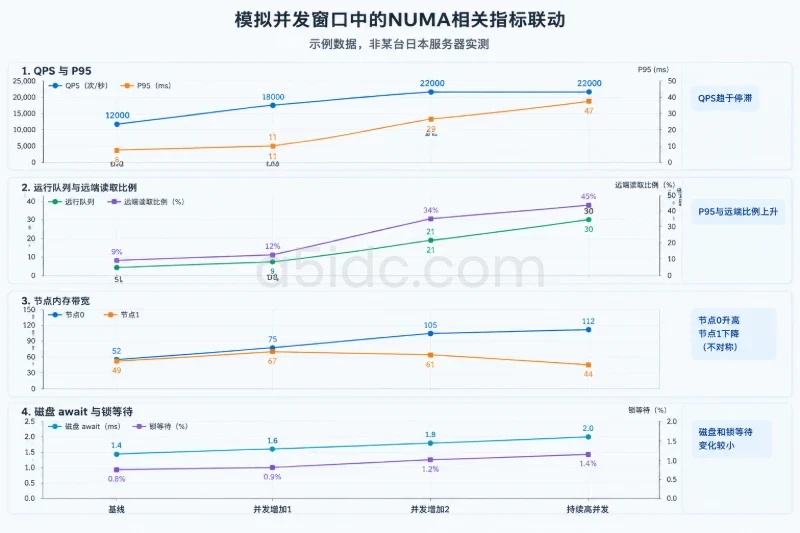
| 阶段 | QPS | P95 | CPU busy | 运行队列 | 远端读取比例 | 节点0/节点1内存带宽 | 磁盘await | 锁等待 |
|---|---|---|---|---|---|---|---|---|
| 基线 | 12000 | 8 ms | 61% | 5 | 9% | 52/49 GB/s | 1.4 ms | 0.8% |
| 并发增加1 | 18000 | 11 ms | 72% | 9 | 12% | 75/67 GB/s | 1.6 ms | 0.9% |
| 并发增加2 | 22000 | 29 ms | 78% | 21 | 34% | 105/61 GB/s | 1.8 ms | 1.2% |
| 持续高并发 | 22000 | 47 ms | 80% | 30 | 45% | 112/44 GB/s | 2.0 ms | 1.4% |
这组数据中,不能只说“CPU从61%升到80%,所以是CPU瓶颈”。更有价值的关联是:
如果这些数据来自同一时间窗口,且远端读取比例由硬件事件而不是numa_miss推导,跨NUMA访存导致性能下降的可能性就较高。此时还需要进行一次受控复测,确认改变内存和线程放置后,P95、远端比例和节点带宽是否一起改善。
相反,如果另一组数据表现为P95从10 ms升到50 ms时,磁盘await从2 ms升到35 ms、iowait从3%升到28%、数据库物理读大幅增加,而远端读取比例只从10%升到12%,就应优先处理存储,而不是调整NUMA绑定。
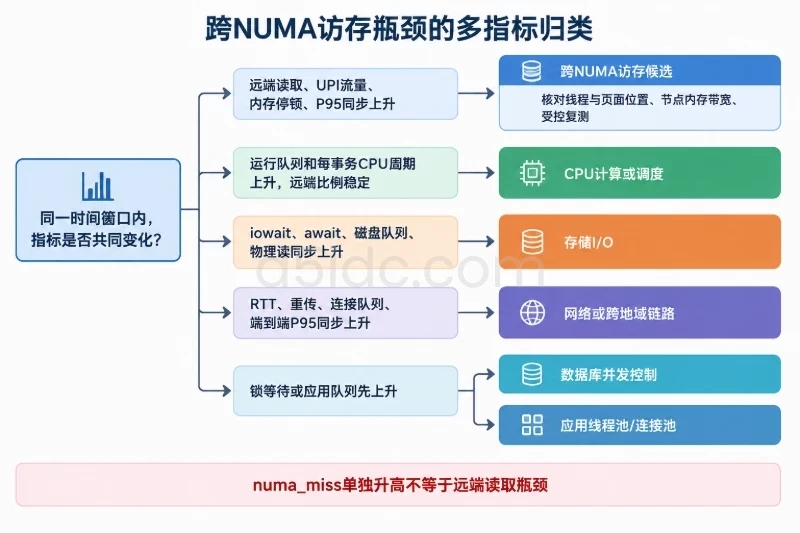
可以用下面的组合快速归类,但这些组合是关联规则,不是孤立阈值。
| 同时出现的现象 | 更可能的判断 | 还需要排查的替代解释 |
|---|---|---|
| 远端读取、UPI流量、内存停顿和P95同步上升 | 跨NUMA访存可能是主要瓶颈 | 每节点内存容量不对称、线程亲和性、热点数据 |
numa_miss上升,但远端硬件流量和P95不变 | 更像页面分配变化,不一定是性能瓶颈 | 后台线程、启动阶段分配、内存回收 |
| CPU运行队列高、CPU周期/事务高,本地远端比例稳定 | CPU计算或调度瓶颈 | 锁竞争、线程池过大 |
| iowait、await、磁盘队列和物理读同步上升 | 存储I/O瓶颈 | 检查点、日志设备、云盘突发额度 |
| 网络RTT、重传、连接队列和端到端P95同步上升 | 网络或跨地域链路问题 | 应用重试、远端服务依赖 |
| 数据库锁等待和活动事务数先上升,NUMA指标变化很小 | 数据库并发控制问题 | 执行计划变化、连接池配置 |
| 应用队列先堆积,数据库执行时间未变化 | 应用线程池或连接池瓶颈 | 客户端网络、服务间调用 |
判断跨NUMA时,至少要满足“位置证据、访问证据、结果证据”三类中的两到三类:
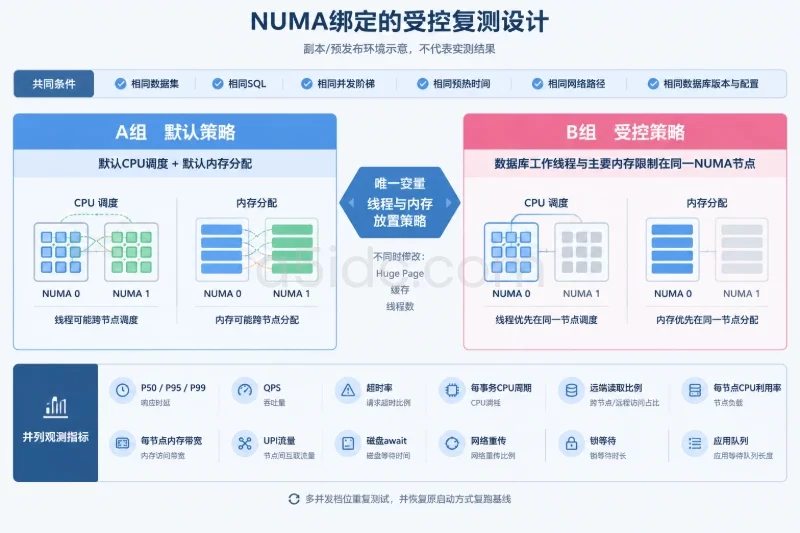
确认NUMA问题最有效的方法不是立即修改数据库启动参数,而是在相同数据、相同SQL和相同并发下做单变量对照。
两次测试至少应保持以下条件一致:
如果一次测试使用冷缓存、另一次使用热缓存,即使NUMA绑定带来了变化,也无法确定结果是否来自缓存状态。
可以在副本或预发布环境中做以下对照:
numactl --show可以查看当前进程的NUMA策略,但不要在不了解服务管理方式的情况下直接对生产数据库执行绑定或重启:
numactl --show
taskset -pc 12345
如果必须在维护窗口测试绑定策略,应先确认以下前提:
如果绑定到单个节点后,远端访问比例下降、节点间互连流量下降、P95和每事务CPU周期同时改善,且在多个并发档位可重复,跨NUMA瓶颈的证据较强。若延迟没有改善,甚至因为单节点内存不足而恶化,则问题可能是内存容量、带宽上限或数据库访问模式,而不是简单的线程与页面错位。
NUMA绑定并不天然有利。绑定后可能出现:
因此,复测不能只看P95是否下降,还要同时比较:
如果只是P95下降,但QPS下降、错误率增加或单节点内存压力变高,这种策略不适合直接用于正式环境。
为了减少单点指标误判,下一次分析这台双路Intel Xeon Gold 6133日本服务器时,至少把以下组合放在同一时间轴:
numastat增量、本地/远端内存字节数、内存带宽、UPI流量、LLC miss和内存停顿。当远端访问、内存停顿、节点间流量、运行队列和数据库P95在相同时间段一起变化,同时磁盘、网络、锁等待和应用队列没有更强的解释时,才可以把跨NUMA访存认定为主要候选瓶颈。经过统一负载下的绑定或交错分配复测,并且结果能够重复,才适合进一步调整数据库线程、内存分配和服务部署策略。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/3551.html