香港100M服务器
采用100M BGP混合带宽,可选15M或25M电信CN2带宽,搭配联通、移动直连线路,兼顾内地访问与国际网络连接,适合企业网站、跨境电商及应用部署等业务。


在美国服务器上部署 Apache Kafka 的 KRaft 集群,核心步骤是:准备三台网络互通的 Linux 服务器,安装兼容的 Java 与 Kafka,为节点配置统一的集群 ID 和不同的节点 ID,初始化存储,再通过 systemd 启动服务。KRaft 使用 Kafka 自身的控制器仲裁管理集群元数据,不需要另外部署 ZooKeeper。
下面以 Ubuntu Server 22.04 LTS、OpenJDK 17、Apache Kafka 3.9.1、三节点静态控制器仲裁为例,完成一套可验证、可排障、可回退的新集群部署。三台服务器同时承担 Broker 和 Controller 角色,适合测试、预发布及资源受限的小规模场景;重要生产环境应优先考虑独立的 Controller 节点,并在接入业务前完成认证、加密、授权和监控配置。本文命令不直接适用于 Kafka 4.x,也不是已有集群的升级操作。
面向这类美国区域的 Kafka 集群部署,A5数据提供美国物理服务器资源,覆盖常规 Xeon、AMD EPYC 及多IP系列,并配备 NVMe 存储与 CN2 GIA 等线路方案。不同硬件档位可承载 Broker、Controller、消息数据与日志等角色,为跨境业务、数据库、容器及持续运行的消息队列应用提供相应的计算、存储和网络资源基础。
示例使用同一美国地域、私网互通的三台服务器。以下地址需要替换成实际私网地址,不要直接填写公网 IP。
| 节点 | 私网地址 | node.id | 角色 | 监听端口 |
|---|---|---|---|---|
| kafka-1 | 10.20.0.11 | 1 | Broker、Controller | 9092、9093 |
| kafka-2 | 10.20.0.12 | 2 | Broker、Controller | 9092、9093 |
| kafka-3 | 10.20.0.13 | 3 | Broker、Controller | 9092、9093 |
每台服务器可先采用 4 vCPU、8 GiB 内存和 SSD 数据盘,作为功能验证的起点,而不是吞吐量承诺。示例给 JVM 分配 2 GiB 堆内存,其余内存供操作系统、页缓存和其他进程使用。
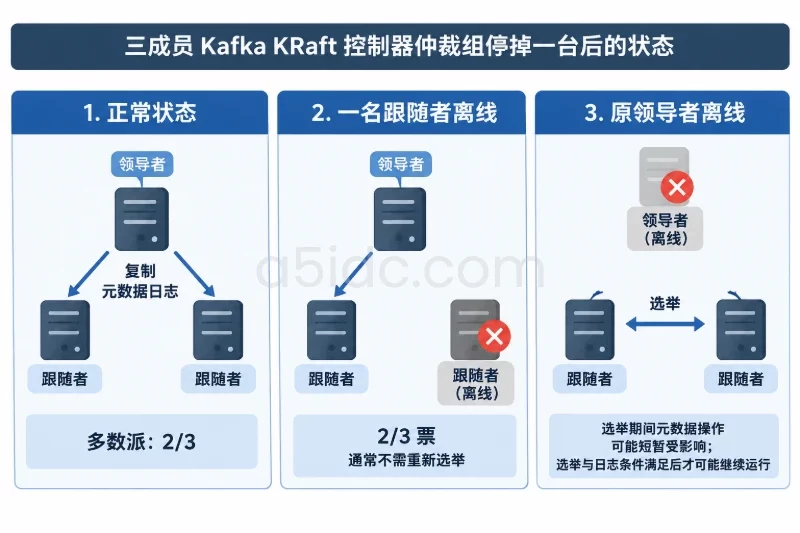
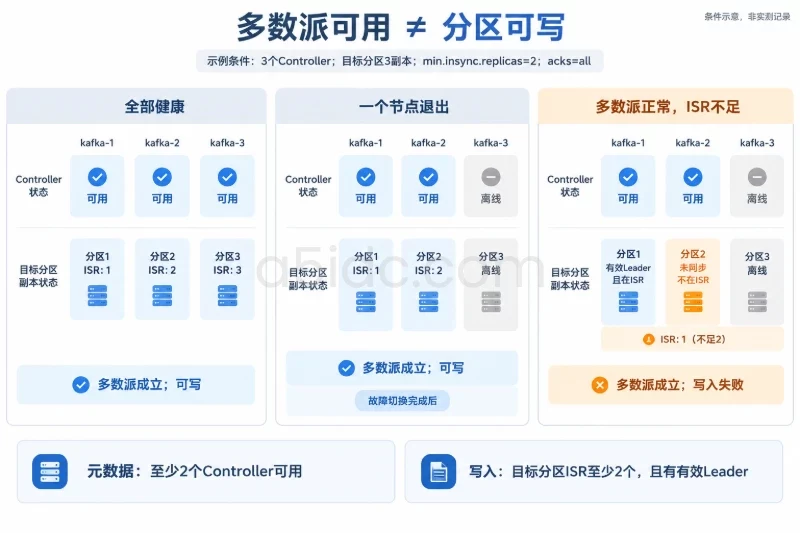
三节点控制器仲裁需要至少两个节点可用才能形成多数派。业务主题采用三个副本、min.insync.replicas=2,生产者采用 acks=all:一个节点退出后,只有在相关分区仍有至少两个同步副本时,写入才能继续。这两个条件分别约束元数据仲裁和消息写入,不能相互替代。
服务器位于美国,并不意味着三台机器天然具备低延迟私网连接。部署前需要确认:
本文使用 PLAINTEXT 简化部署验证,仅限受控私网环境。它不提供传输加密和客户端认证,不能因为端口受限就视为完整的生产安全方案。涉及敏感消息、跨信任边界通信或外部客户端时,应先完成 TLS、SASL 和 ACL 配置,再接入业务。
以下操作使用具备 sudo 权限的账号;进入 root shell 后执行后续系统配置命令:
sudo -i
cat /etc/os-release
uname -m
free -h
lsblk -f
timedatectl status
预期系统为 Ubuntu 22.04,时间同步状态正常。Kafka 不要求各服务器时钟完全一致,但明显的时间偏差会影响日志关联、证书校验和故障分析。
建议提前把数据盘挂载到 /var/lib/kafka。本教程不包含磁盘格式化命令,避免误清空已有数据盘。检查挂载来源和可用空间:
mkdir -p /var/lib/kafka
findmnt -T /var/lib/kafka
df -h /var/lib/kafka
如果输出指向根文件系统,而你的目标是独立数据盘,应先完成挂载和持久化挂载配置,再继续。后续虽然把消息数据与元数据放在不同目录,但如果它们位于同一块磁盘,并不具备磁盘故障隔离效果。
在三台服务器上分别执行:
apt-get update
apt-get install -y openjdk-17-jre-headless curl ca-certificates netcat-openbsd ufw
java -version
预期 Java 主版本为 17。若输出为其他版本,应先检查:
update-alternatives --display java
安装软件包会改变系统环境;已有服务器应先核对其他服务对 Java 版本的要求,不要未经确认就切换全局 Java 默认版本。
本文固定使用 Kafka 3.9.1,便于复现静态仲裁配置,不代表应长期停留在这一版本。部署前仍需结合安全维护要求核对版本选择。
在三台服务器执行:
mkdir -p /opt
cd /opt

FILE=kafka_2.13-3.9.1.tgz
BASE=https://archive.apache.org/dist/kafka/3.9.1

curl -fLO "$BASE/$FILE"
curl -fLO "$BASE/$FILE.sha512"

sha512sum "$FILE"
cat "$FILE.sha512"
将本地计算出的 SHA-512 与下载的校验文件逐位比较;若校验文件采用分组或换行展示,应按完整摘要比较。校验不一致时不要解压或启动,应重新下载并检查下载来源。
确认一致后执行:
tar -xzf "$FILE" -C /opt

test ! -e /opt/kafka && test ! -L /opt/kafka \
  && ln -s /opt/kafka_2.13-3.9.1 /opt/kafka

/opt/kafka/bin/kafka-topics.sh --version
预期版本输出包含 3.9.1。如果 /opt/kafka 已存在,上面的命令不会替换它;应检查它指向的版本,而不是强制覆盖已有安装。
在每台服务器当前 root shell 中设置对应变量。以下是第一台的示例:
export NODE_ID=1
export NODE_IP=10.20.0.11
第二台使用 NODE_ID=2、NODE_IP=10.20.0.12;第三台使用 NODE_ID=3、NODE_IP=10.20.0.13。后续命令依赖这些变量,每次重新登录都需要重新设置并检查:
printf 'NODE_ID=%s NODE_IP=%s\n' "$NODE_ID" "$NODE_IP"
ip -br address
防火墙操作可能中断 SSH。以下命令仅适用于没有既有复杂防火墙策略的新服务器:先保留云控制台访问方式,确认 SSH 端口和管理来源,备份规则,再操作。已有服务器应把放行规则合并到原策略,不要照搬默认策略。
UFW_BACKUP="/root/ufw.before-kafka.$(date +%Y%m%d%H%M%S)"
cp -a /etc/ufw "$UFW_BACKUP"
ufw status verbose

# 替换为实际管理出口地址、SSH 端口和业务客户端网段
MGMT_CIDR="198.51.100.10/32"
SSH_PORT=22
APP_CIDR="10.30.0.0/24"

ufw allow from "$MGMT_CIDR" to any port "$SSH_PORT" proto tcp

for PEER in 10.20.0.11 10.20.0.12 10.20.0.13; do
  ufw allow from "$PEER" to "$NODE_IP" port 9092 proto tcp
  ufw allow from "$PEER" to "$NODE_IP" port 9093 proto tcp
done

ufw allow from "$APP_CIDR" to "$NODE_IP" port 9092 proto tcp
ufw default deny incoming
ufw default allow outgoing
ufw enable
ufw status numbered
198.51.100.10 是文档示例地址,必须替换。启用后保持当前 SSH 会话,再新开一个会话确认管理连接可用。若被阻断,通过云控制台恢复 SSH 放行规则;完整防火墙回退见文末。
三台服务器分别执行。下面的账号和目录用于专用 Kafka 服务,不应与其他应用共用:
id kafka >/dev/null 2>&1 \
  || useradd --system --home-dir /var/lib/kafka --shell /usr/sbin/nologin kafka

install -d -o root -g kafka -m 0750 /etc/kafka
install -d -o kafka -g kafka -m 0750 \
  /var/lib/kafka/data \
  /var/lib/kafka/metadata \
  /var/log/kafka
检查权限:
sudo -u kafka test -w /var/lib/kafka/data && echo "data writable"
sudo -u kafka test -w /var/lib/kafka/metadata && echo "metadata writable"
sudo -u kafka test -x /opt/kafka/bin/kafka-server-start.sh && echo "binary accessible"
三个检查都应成功。不要为解决权限问题给目录设置全员可写,也不要对整个 /var/lib 递归修改属主。
以下写入会创建 /etc/kafka/server.properties。仅用于新部署;如果文件已经存在,先备份并检查用途,不要覆盖正在运行的配置。
test ! -e /etc/kafka/server.properties \
  || { echo "配置已存在,请先备份并核对"; exit 1; }

cat > /etc/kafka/server.properties <<EOF
process.roles=broker,controller
node.id=${NODE_ID}

controller.quorum.voters=1@10.20.0.11:9093,2@10.20.0.12:9093,3@10.20.0.13:9093
controller.listener.names=CONTROLLER

listeners=PLAINTEXT://${NODE_IP}:9092,CONTROLLER://${NODE_IP}:9093
advertised.listeners=PLAINTEXT://${NODE_IP}:9092
listener.security.protocol.map=PLAINTEXT:PLAINTEXT,CONTROLLER:PLAINTEXT
inter.broker.listener.name=PLAINTEXT

log.dirs=/var/lib/kafka/data
metadata.log.dir=/var/lib/kafka/metadata

num.partitions=3
default.replication.factor=3
min.insync.replicas=2
offsets.topic.replication.factor=3
transaction.state.log.replication.factor=3
transaction.state.log.min.isr=2

unclean.leader.election.enable=false
auto.create.topics.enable=false
log.retention.hours=72
log.segment.bytes=1073741824
EOF

chown root:kafka /etc/kafka/server.properties
chmod 0640 /etc/kafka/server.properties
这里有三个容易配置错误的关系:
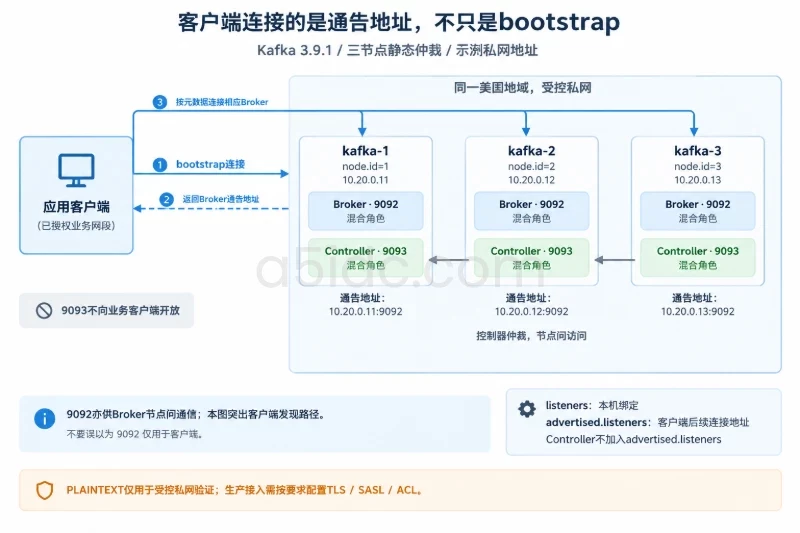
controller.quorum.voters 必须一致,且其中的 ID 与各节点 node.id 对应。listeners 决定本机绑定地址;advertised.listeners 决定客户端取得元数据后连接哪个地址。advertised.listeners,业务客户端连接的是 Broker 监听端口。检查关键项:
grep -E '^(node.id|controller.quorum.voters|listeners|advertised.listeners|log.dirs|metadata.log.dir)=' \
  /etc/kafka/server.properties
三台节点应只有节点 ID 和本机监听、通告地址不同。
只在第一台服务器生成一次集群 ID:
/opt/kafka/bin/kafka-storage.sh random-uuid
把输出保存到部署记录,并安全复制到另外两台服务器。三台机器必须使用同一个集群 ID,不能各自生成。
在每台服务器执行,替换下面的占位内容:
export CLUSTER_ID='替换为第一台生成的集群ID'

sudo -u kafka /opt/kafka/bin/kafka-storage.sh format \
  -t "$CLUSTER_ID" \
  -c /etc/kafka/server.properties
该操作只适用于从未初始化的空数据目录,会写入存储元信息。输出应提示相关目录已完成格式化,随后检查:
cat /var/lib/kafka/data/meta.properties
cat /var/lib/kafka/metadata/meta.properties
核对 cluster.id 在三台机器上相同,node.id 与各自配置一致。
如果提示已经格式化,不要直接加忽略参数,更不要删除 meta.properties。先确认这是重复操作还是旧集群目录。格式化不是日常启动步骤,重启服务不需要再次执行。
三台服务器分别创建服务文件;如果已有同名服务,应先备份并确认不是在用服务。
cat > /etc/systemd/system/kafka.service <<'EOF'
[Unit]
Description=Apache Kafka KRaft Server
Wants=network-online.target
After=network-online.target

[Service]
Type=simple
User=kafka
Group=kafka
WorkingDirectory=/opt/kafka
Environment="KAFKA_HEAP_OPTS=-Xms2G -Xmx2G"
Environment="LOG_DIR=/var/log/kafka"
ExecStart=/opt/kafka/bin/kafka-server-start.sh /etc/kafka/server.properties
KillSignal=SIGTERM
TimeoutStopSec=180
Restart=on-failure
RestartSec=5
LimitNOFILE=100000
UMask=0027

[Install]
WantedBy=multi-user.target
EOF

systemctl daemon-reload
systemctl enable --now kafka
systemctl status kafka --no-pager
逐台启动,但不要仅凭第一台暂时无法形成仲裁就修改配置:静态三节点仲裁至少需要两个 Controller 上线。
三台启动后检查:
ss -lntp | grep -E ':(9092|9093)\b'
journalctl -u kafka -n 100 --no-pager
预期服务为 active (running),两个端口绑定在对应私网地址,日志不持续出现连接失败或注册失败。日志文字会随版本和运行状态变化,应以状态和错误内容判断,而不是匹配某一行固定文本。
从每台节点测试其他节点的端口:
nc -vz -w 3 10.20.0.12 9092
nc -vz -w 3 10.20.0.12 9093
nc -vz -w 3 10.20.0.13 9092
nc -vz -w 3 10.20.0.13 9093
按实际所在节点调整目标。成功只说明 TCP 可连接,不等于 Kafka 协议和仲裁正常。
继续执行:
/opt/kafka/bin/kafka-metadata-quorum.sh \
  --bootstrap-server 10.20.0.11:9092 \
  describe --status
检查输出中的 ClusterId、LeaderId、CurrentVoters 和跟随者滞后情况。应有合法的 Leader,投票成员包含三个节点 ID;无写入且运行稳定时,跟随者滞后应收敛,而不是持续扩大。
在任一节点执行:
/opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server 10.20.0.11:9092 \
  --create \
  --topic kraft-smoke \
  --partitions 3 \
  --replication-factor 3 \
  --config min.insync.replicas=2

/opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server 10.20.0.11:9092 \
  --describe \
  --topic kraft-smoke
三个分区都应有有效 Leader,Replicas 和 Isr 均包含三个节点。节点顺序和 Leader 分配可以不同;下面只是判断格式的示例,不是实际执行记录:
Partition: 0 Leader: 1 Replicas: 1,2,3 Isr: 1,2,3
生产者测试:
printf 'kraft-test-001\nkraft-test-002\nkraft-test-003\n' \
  | /opt/kafka/bin/kafka-console-producer.sh \
      --bootstrap-server 10.20.0.11:9092 \
      --topic kraft-smoke \
      --producer-property acks=all
消费者测试:
/opt/kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server 10.20.0.11:9092 \
  --topic kraft-smoke \
  --from-beginning \
  --max-messages 3 \
  --timeout-ms 15000
预期能读到三条消息。消息可能跨分区排列,不应要求它们按发送行顺序出现;Kafka 保证的是单个分区内的顺序。
还应在实际应用服务器上执行同类测试。节点本机成功、应用侧失败,通常需要检查应用是否能访问所有通告地址。
只在尚未接入生产流量、三个节点均健康时执行,并且一次只停一台。先在 kafka-3 上停止:
systemctl stop kafka
从其他节点重新检查仲裁和主题。完成故障切换后,测试主题的 ISR 应收敛到两个节点,使用其余 Broker 地址进行 acks=all 写入应能继续。
测试结束立即恢复:
systemctl start kafka
systemctl status kafka --no-pager
等待副本追上,并确认每个分区的 ISR 回到三个。若未恢复,不要继续停止第二台。这个测试验证的是节点进程退出场景,不能替代磁盘损坏、机房中断或网络分区演练。
当客户端报连接超时,按以下顺序检查:
ip route get 10.20.0.12
nc -vz -w 3 10.20.0.12 9092
ss -lntp | grep ':9092'
ufw status numbered
advertised.listeners 是否可达。不要通过把所有端口开放到公网来“排除问题”。临时调整访问规则也应限定来源,记录变更并在测试后恢复。
先读取状态和日志:
systemctl status kafka --no-pager
journalctl -u kafka -n 200 --no-pager
df -h /var/lib/kafka
df -i /var/lib/kafka
常见原因与处理方式如下:
| 现象 | 重点检查 | 处理方向 |
|---|---|---|
| 地址绑定失败 | NODE_IP 是否属于本机、端口是否被占用 | 修正配置或处理占用进程,不盲目终止其他服务 |
| 数据目录权限错误 | kafka 用户是否可访问和写入指定目录 | 修正具体目录权限,避免扩大权限范围 |
| 集群 ID 不一致 | 配置与 meta.properties 是否来自同一集群 | 查明目录来源,不重新格式化已有数据 |
| Controller 无 Leader | 9093 连通性、投票成员、节点 ID | 恢复多数派,不随意缩减静态投票成员 |
| 服务被系统杀死 | 内存、内核日志、JVM 堆设置 | 减少不必要负载或增加资源,不能只增大堆 |
| 磁盘空间耗尽 | 消息目录、日志目录、保留策略 | 扩容或按流程调整保留策略,不手删分区文件 |
检查内存相关记录可使用:
journalctl -k --since "-1 hour" | grep -Ei 'oom|out of memory|killed process'
如果需要修改配置,先备份:
cp -a /etc/kafka/server.properties \
  "/etc/kafka/server.properties.bak.$(date +%Y%m%d%H%M%S)"
一次只修改一个节点,重启并验证健康后再处理下一个。混合角色部署中,重启同时影响 Broker 和 Controller,不应同时重启两台。
NotEnoughReplicas 或类似错误,通常意味着相关分区没有达到写入所需的同步副本数量:
/opt/kafka/bin/kafka-topics.sh \
  --bootstrap-server 10.20.0.11:9092 \
  --describe \
  --topic kraft-smoke
如果 ISR 少于两个,应优先恢复离线节点、处理复制延迟、磁盘或网络故障。直接把 min.insync.replicas 改为 1 会降低故障时的消息保护能力,不应作为默认修复办法。
另外,log.retention.hours=72 不是磁盘容量硬上限。Kafka 按日志段执行清理,实际空间还受到写入量、副本数、段滚动和清理时机影响,必须配合磁盘告警。
至少完成以下核对:
业务生产者是否使用幂等、事务和重试,需要按应用语义单独设计。部署成功不等于自动获得业务层面的“消息不重不丢”。
配置变更导致单节点无法启动时,恢复该节点的上一份配置,再启动并检查日志:
systemctl stop kafka

# 替换为确认可用的备份文件
cp -a /etc/kafka/server.properties.bak.时间戳 \
  /etc/kafka/server.properties

systemctl start kafka
systemctl status kafka --no-pager
该操作会覆盖当前配置,只能在确认备份属于同一节点后执行。恢复后重新检查仲裁、主题 ISR 和消息收发;不要因为配置恢复就认为数据状态也已经恢复。
若集群尚未接入业务、确定没有需要保留的消息,可停止三台服务并取消自动启动:
systemctl disable --now kafka
优先保留配置、日志和数据目录用于分析,不执行删除目录或重新格式化。需要重建时,应先明确放弃的是哪一套集群,再处理旧目录;已有业务数据的集群不能按“新部署失败”方式清空。
若本次操作修改了 UFW,可通过管理控制台使用先前记录的备份目录恢复:
# 替换为本次操作前记录的真实备份路径
UFW_BACKUP="/root/ufw.before-kafka.时间戳"

cp -a "$UFW_BACKUP"/. /etc/ufw/
ufw reload
ufw status verbose
恢复前确认备份之后没有其他需要保留的防火墙变更。如果部署前 UFW 未启用、此次才启用,还需在安全组已保护服务器的前提下恢复原启用状态;不要把停用防火墙作为日常排障手段。
最后保留四项回退记录:服务是否停止、配置是否恢复、防火墙是否恢复、数据是否保留。只要集群已承载业务消息,后续升级、迁移或重建都应遵循相应版本的兼容与数据恢复流程,不能通过更换集群 ID 或重新格式化来代替。
本文由A5数据原创发布,转载请注明出处:https://www.a5idc.com/helpcontent/3176.html